容器服务
容器服务


文档指南

请输入


- 文档首页
 容器服务容器服务 VKE用户指南可观测性基础观测集群观测容器服务观测
 复制全文
 下载 pdf
容器服务观测
 文档反馈
 问问助手
容器服务观测允许您监控容器服务集群的基础资源和工作状态。本文为您介绍如何配置容器服务观测功能。
前提条件
操作步骤
步骤一:开启观测
- 登录 容器服务控制台。
- 在左侧导航栏单击 集群,找到目标集群,单击集群名称。
- 在集群管理页面的左侧导航栏中,单击 观测配置。
- 选择 容器服务 卡片,单击 启用,开启容器服务集群观测。
-

- 系统自动检查开启集群观测所需的必要条件。包括:工作区配置、组件状态等。
-

- 单击 开启,开启容器服务集群观测。
步骤二:配置采集规则
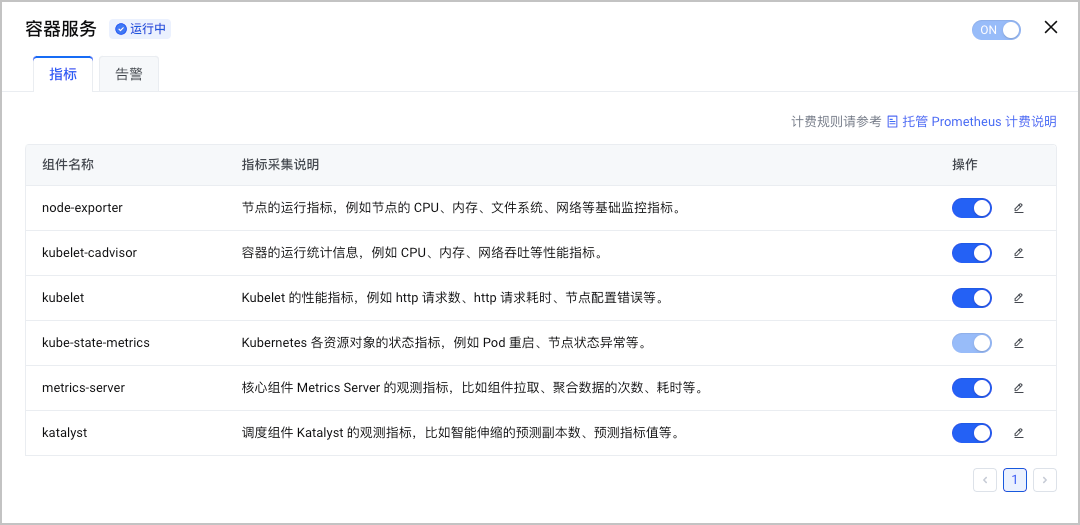
容器服务集群监控开启后,您可以配置采集规则,选择需要采集的目标组件、具体指标项及采集间隔。可以根据实际需求丢弃一些不用的指标。
- 在集群管理页面的左侧导航栏中,单击 观测配置。
- 选择 容器服务 卡片,单击 编辑配置 并选择 指标 页签,配置采集规则,并选择具体的采集指标。
- 在组件列表 操作 列,单击开关,开启或关闭组件的采集规则。当关闭组件的采集规则时,系统不会采该集组件的所有指标。
-
说明
仅支持管理系统默认的采集规则和指标项。不支持管理使用 ServiceMonitor/PodMonitor 等方式配置的自定义采集规则和指标项。
- 单击组件列表 操作 栏中的
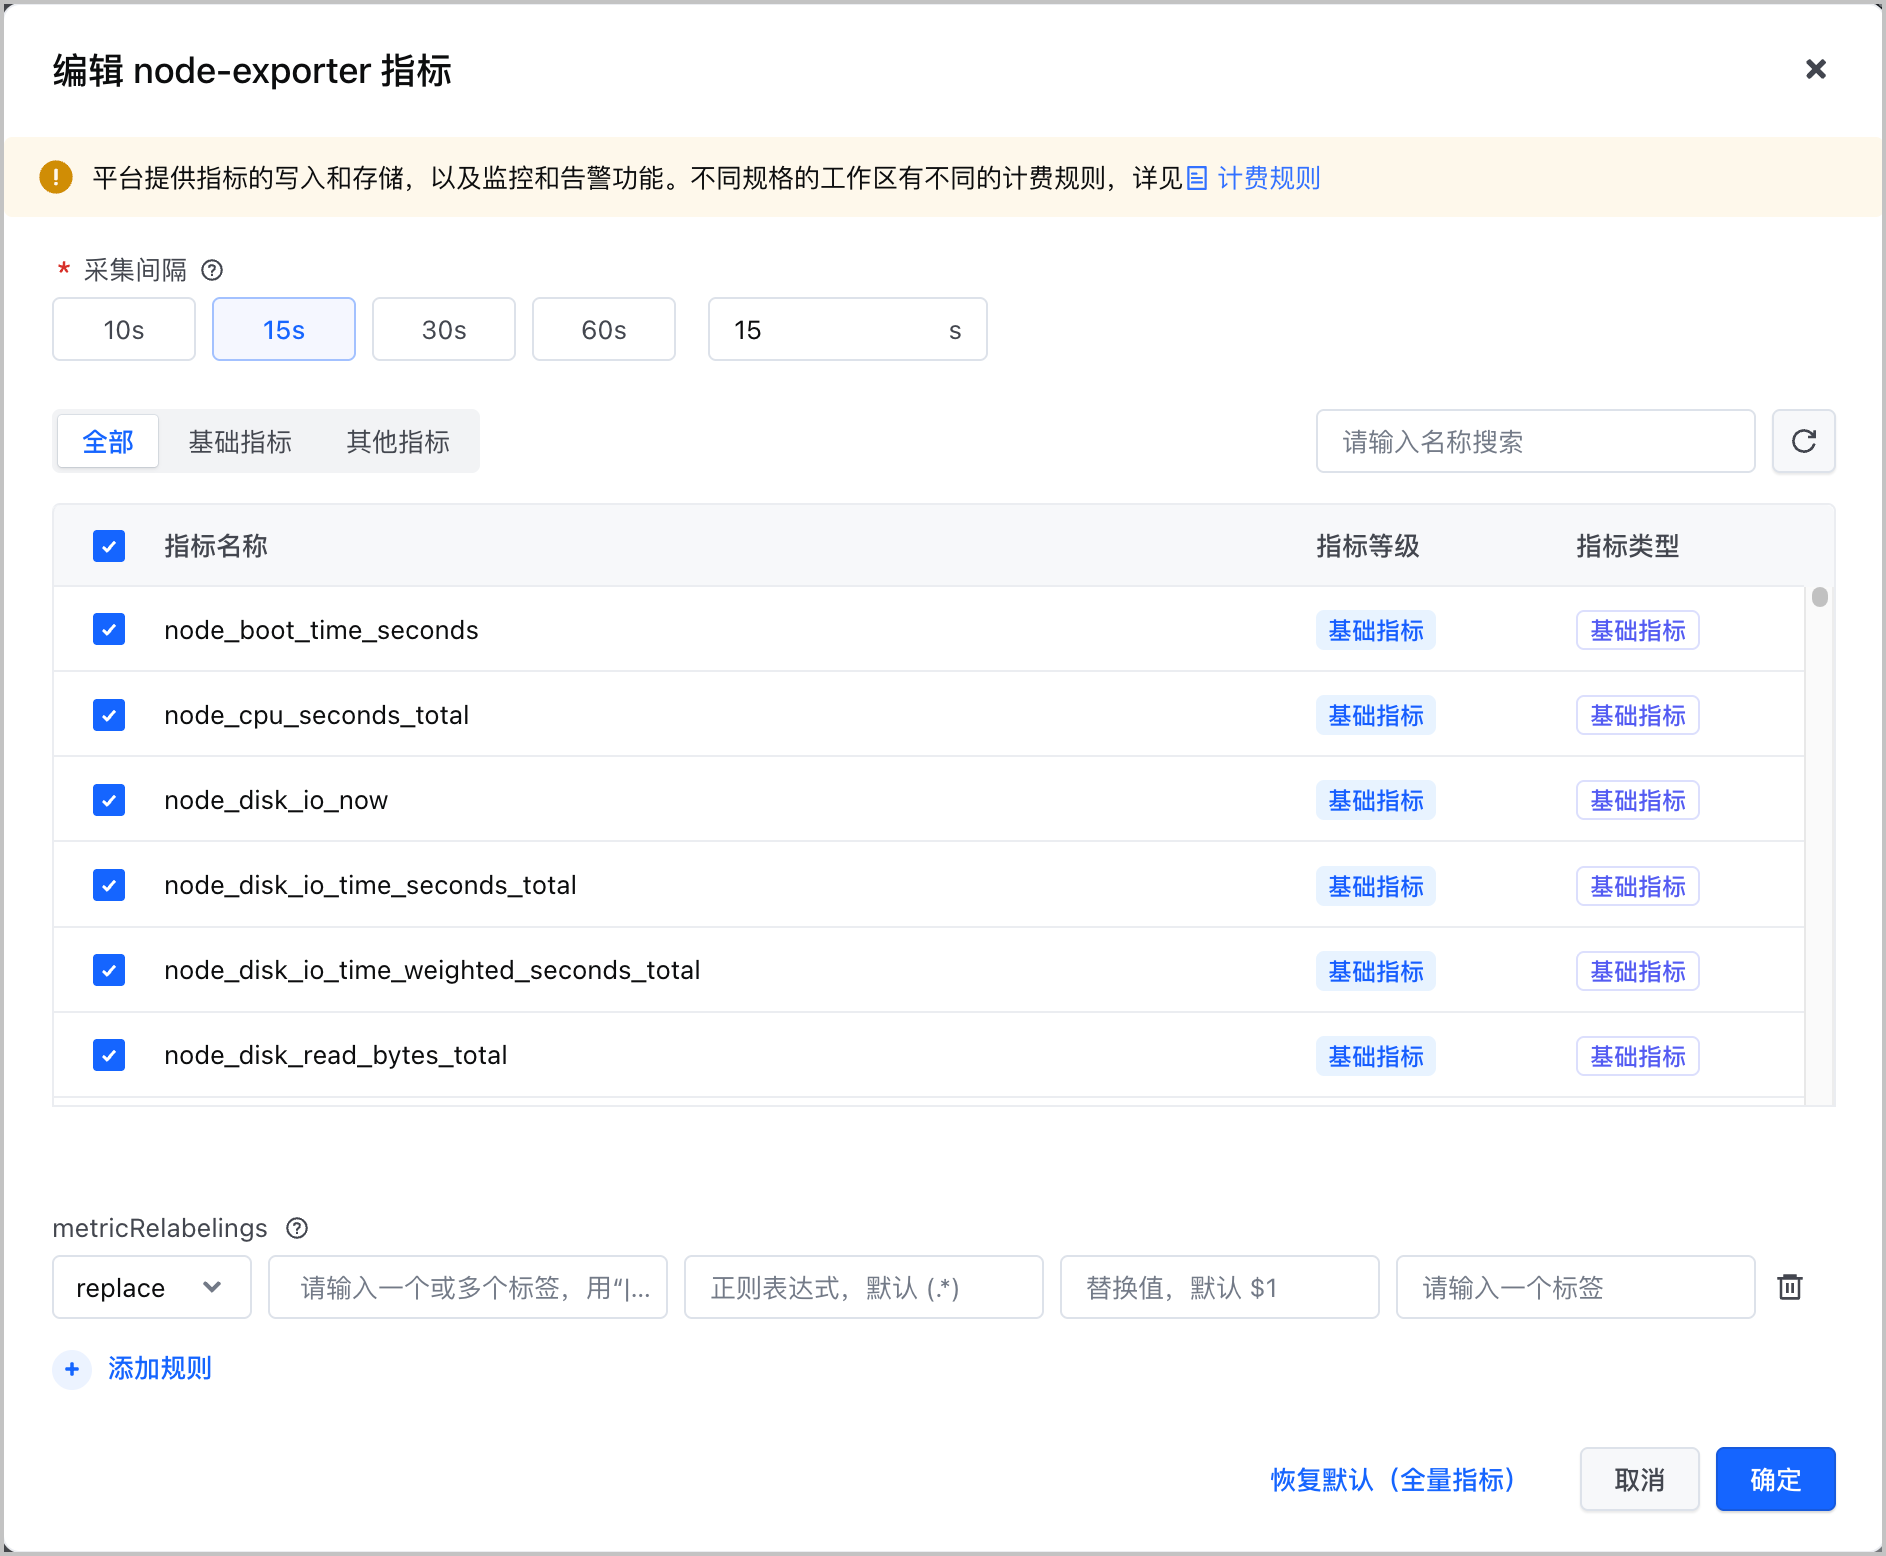
 ,支持选择或丢弃组件的具体指标、面向该组件的采集间隔和指标 Relabel。
- 在 采集间隔 中,选择该组件指标的采集间隔。不同组件支持的采集间隔不同。
- 在 指标列表 中,勾选指标,则采集该指标。取消勾选,则丢弃该指标。单击 全部、基础指标 或 其他指标 页签,允许基于指标类型对指标项进行筛选。
-
说明
- 调整指标采集间隔的影响如下,请按需调整:
- 减小采集间隔:增加单位时间内上报的指标数量,提升监控精度,但 VMP 标准版工作区的费用会增加。
- 增加采集间隔:减少单位时间内上报的指标数量,降低 VMP 标准版工作区的费用,但监控精度会降低。
- 云产品的指标类型分为 基础指标 和 其他指标,不同类型指标的计费方式不同,详情请参见 托管 Prometheus 计费方式。
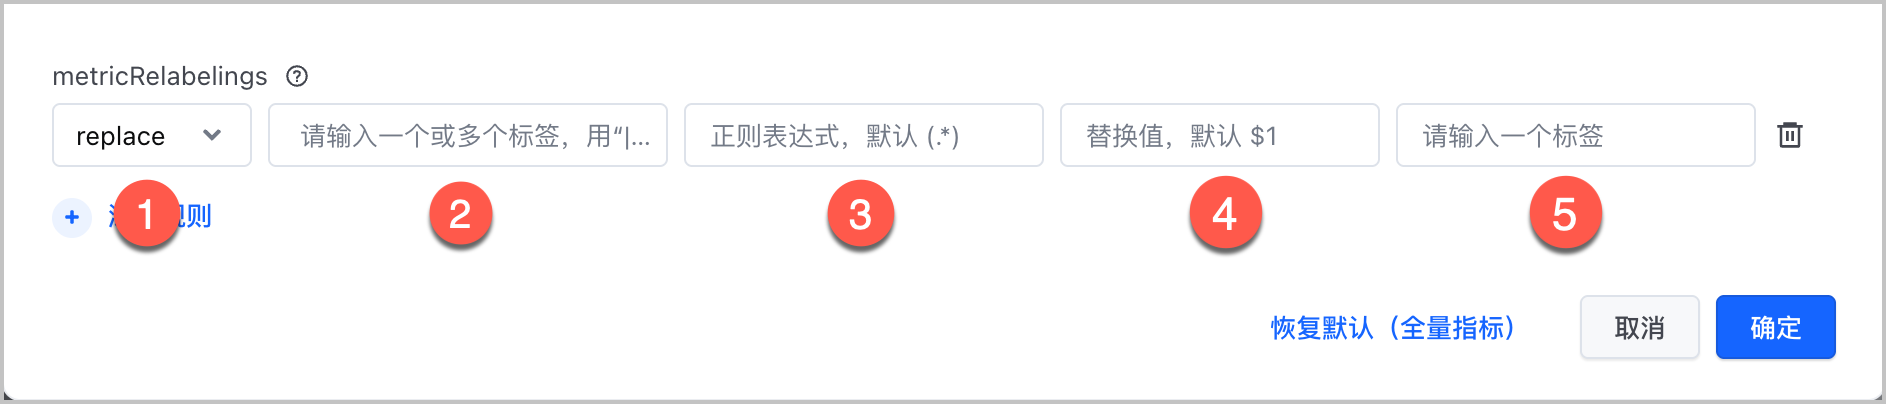
- 在 metricRelabelings 中,单击 添加规则,配置指标 Relabel 规则。允许在指标完成采集后、写入存储前,对每条指标的标签执行改写操作。常见用途包括修改标签值、新增标签或重命名标签,便于在查询时统一标签口径。更多详情介绍,请参见 指标 Relabel。
-
-
- 单击 确定,完成配置。
步骤三:配置告警
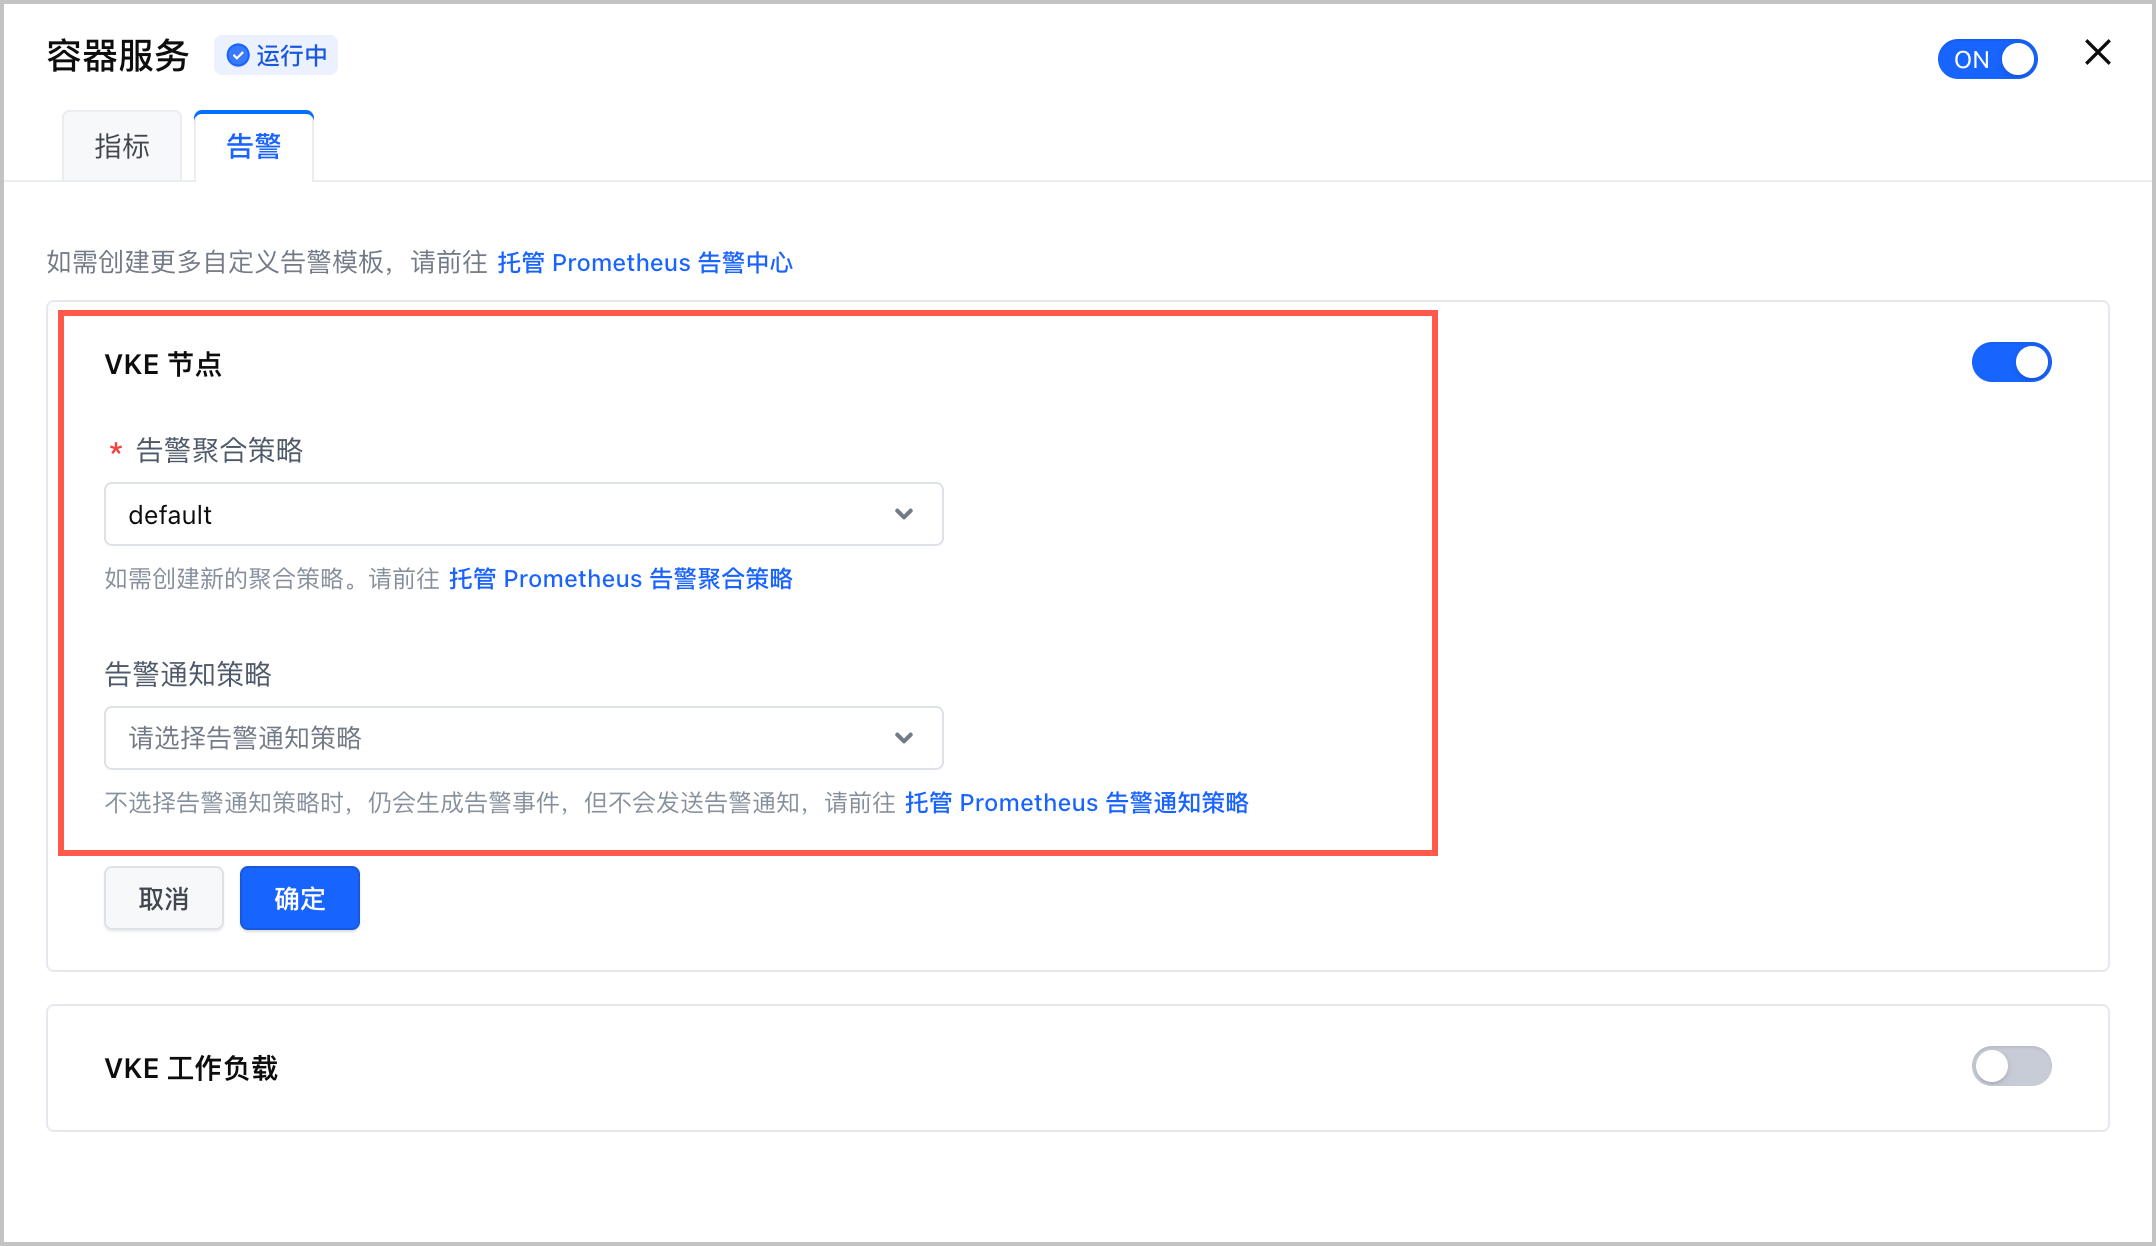
您可以基于预置的告警模板,快速完成容器服务集群观测的告警配置。
- 在集群管理页面的左侧导航栏中,单击 观测配置。
- 选择 容器服务 卡片,单击 编辑配置 并选择 告警 页签,配置告警的相关参数。
-
-
说明
- 除了直接使用预置告警模板配置告警规则,您可以自定义模板中的配置,或直接使用 PromQL 语句配置告警规则。详情请参见 告警配置概述。
- 预置告警规则模板的详情,包括规则说明、PromQL 配置和常见告警处理流程。请参见 预置告警模板。
- 单击 确定,完成配置。
集群观测看板
说明
集群监控
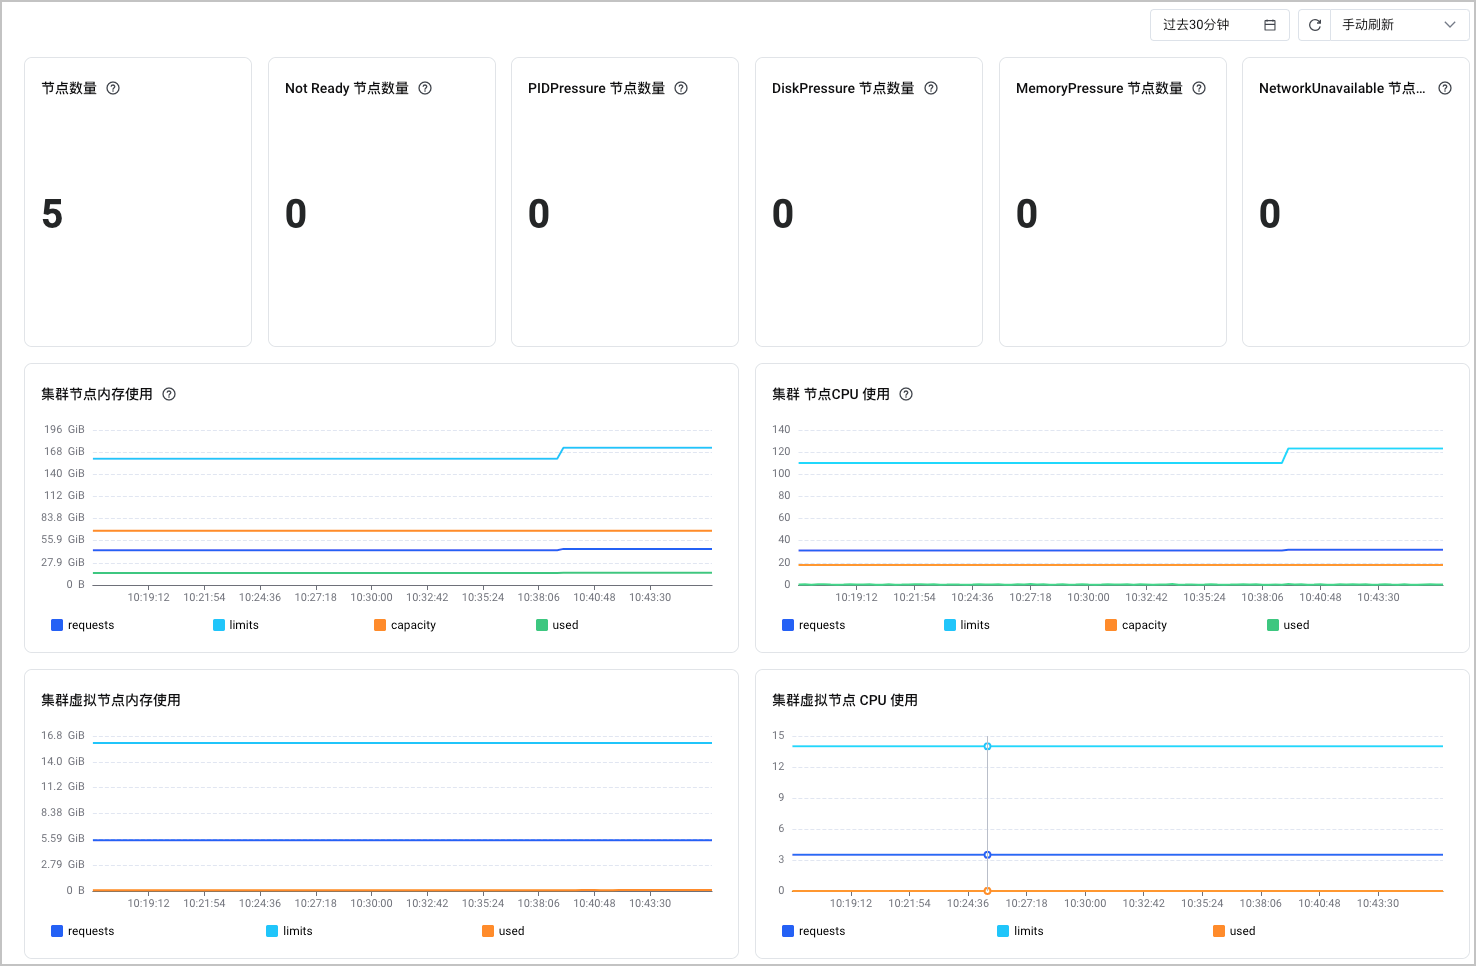
该看板用于查看集群整体的监控信息,包括:集群节点信息(节点数量、未就绪节点数)、集群内存信息(内存使用量、内存使用率)、集群 CPU 信息(CPU 使用量、CPU 使用率)等。支持设置查询的时间段,并指定刷新方式(手动刷新、自动刷新)。
- 在集群管理页面的左侧导航栏中,选择 监控中心 > 监控看板。
- 在左侧看板列表中选择 集群监控 > 集群监控概览,即可查看监控看板。
集群 Namespace 监控
该看板用于查看集群命名空间维度的监控信息,包括:命名空间内 NotReady 状态的 Deploment、Statefulset、DaemonSet 数量,命名空间内的内存使用、CPU 使用和 PVC 使用信息。支持设置查询的时间段,并指定刷新方式(手动刷新、自动刷新)。
- 在集群管理页面的左侧导航栏中,选择 监控中心 > 监控看板。
- 在左侧看板列表中选择 集群监控 > 集群 Namespace 监控,即可查看监控看板。

节点观测看板
节点概览
该看板用于查看节点的概览信息,包括:节点内存使用率、节点 CPU 使用率、节点磁盘使用率等。支持同时选择多个节点,满足节点资源使用情况对比。支持设置查询的时间段,并指定刷新方式(手动刷新、自动刷新)。
- 在集群管理页面的左侧导航栏中,选择 监控中心 > 监控看板。
- 在左侧看板列表中选择 节点监控 > 节点概览,即可查看监控大盘。

节点详情监控
该看板用于查看指定节点的监控信息,包括:节点内存信息(内存使用量、内存使用率)、节点 CPU 信息(CPU 使用量、CPU 使用率、CPU 负载)、磁盘信息(磁盘使用率、磁盘读写 IOPS)等。支持设置查询的时间段,并指定刷新方式(手动刷新、自动刷新)。
- 在集群管理页面的左侧导航栏中,选择 监控中心 > 监控看板。
- 在左侧看板列表中选择 节点监控 > 节点详情监控,即可查看监控看板。

虚拟节点监控
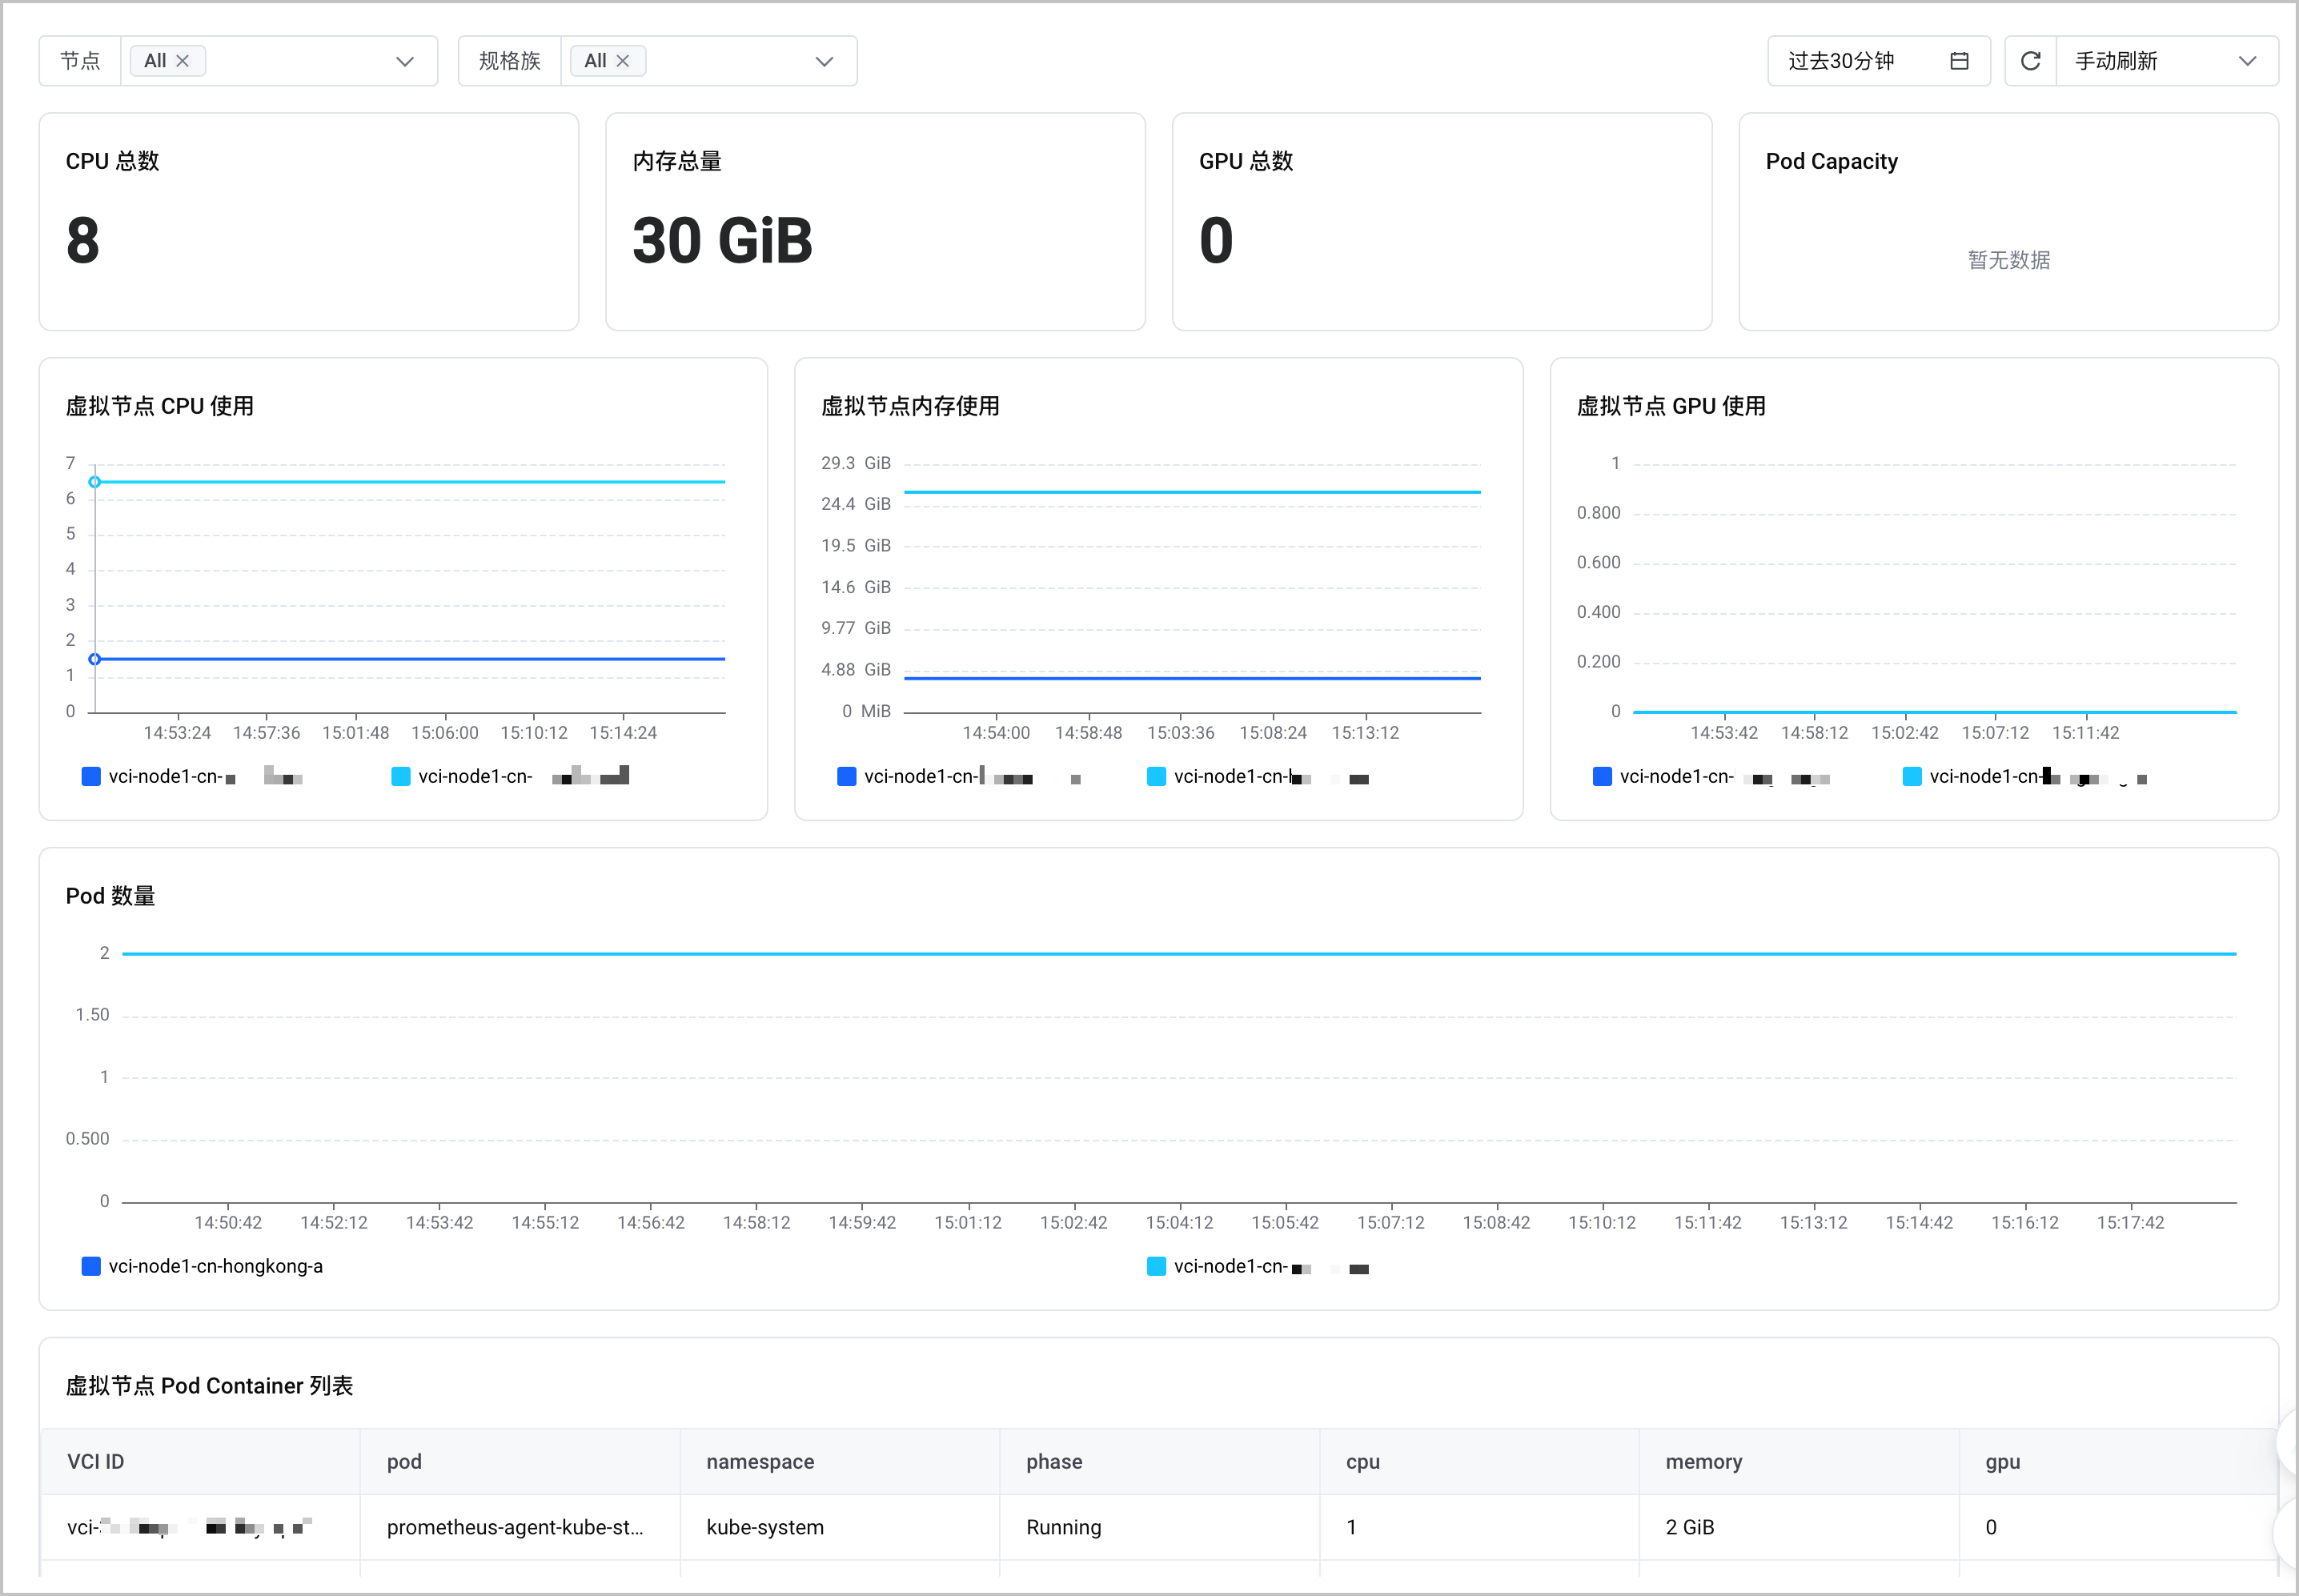
该看板用于查看集群虚拟节点的监控信息,包括:虚拟节点内存信息(内存总量、内存使用率)、虚拟节点 CPU 信息(CPU 总数、CPU 使用率)、虚拟节点 GPU 信息(GPU 总数、GPU 使用率)等。支持设置查询的时间段,并指定刷新方式(手动刷新、自动刷新)。
- 在集群管理页面的左侧导航栏中,选择 监控中心 > 监控看板。
- 在左侧看板列表中选择 节点监控 > 虚拟节点监控,即可查看监控看板。
工作负载观测看板
无状态负载监控
该看板用于查看指定命名空间下无状态负载的监控信息,包括:实例信息(期望实例数、就绪实例数、就绪比例)、CPU 信息(CPU Request、CPU Limits)、内存信息(内存 Request、内存 Limits)、网络信息、磁盘信息等。支持设置查询的时间段,并指定刷新方式(手动刷新、自动刷新)。
- 在集群管理页面的左侧导航栏中,选择 监控中心 > 监控看板。
- 在左侧看板列表中选择 工作负载监控 > 无状态负载监控,即可查看监控大盘。

有状态负载监控
该看板用于查看指定命名空间下有状态负载的监控信息,包括:实例信息(期望实例数、就绪实例数、就绪比例)、CPU 信息(CPU Request、CPU Limits)、内存信息(内存 Request、内存 Limits)、网络信息、磁盘信息等。支持设置查询的时间段,并指定刷新方式(手动刷新、自动刷新)。
- 在集群管理页面的左侧导航栏中,选择 监控中心 > 监控看板。
- 在左侧看板列表中选择 工作负载监控 > 有状态负载监控,即可查看监控大盘。

守护进程监控
该看板用于查看指定命名空间下守护进程的监控信息,包括:CPU 信息(CPU Request、CPU Limits)、内存信息(内存 Request、内存 Limits)、网络信息、磁盘信息等。支持设置查询的时间段,并指定刷新方式(手动刷新、自动刷新)。
- 在集群管理页面的左侧导航栏中,选择 监控中心 > 监控看板。
- 在左侧看板列表中选择 工作负载监控 > 守护进程监控,即可查看监控大盘。

容器组监控
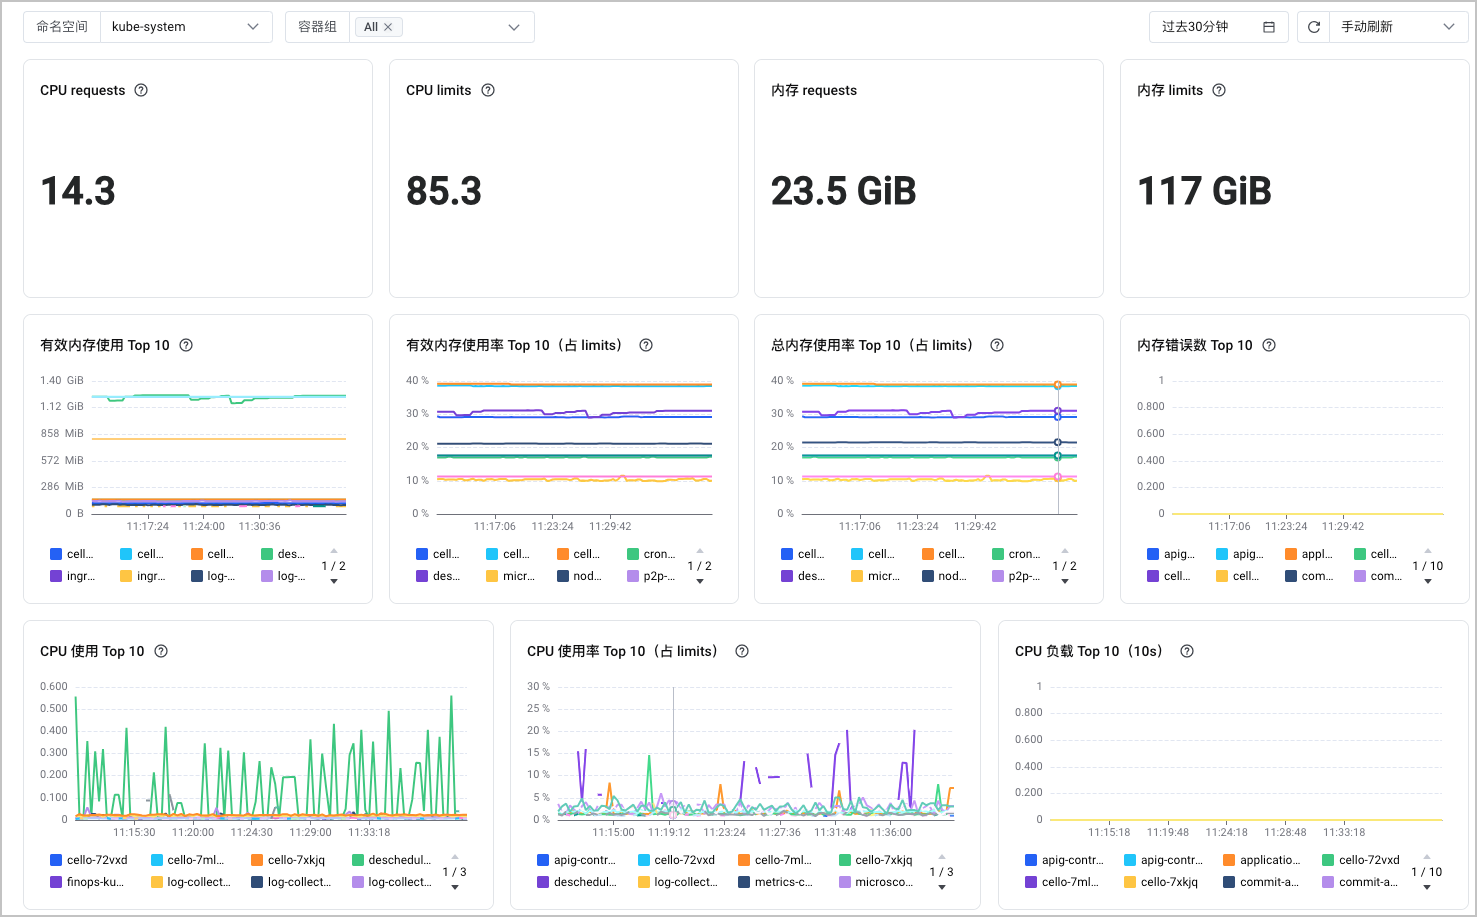
该看板用于查看指定命名空间下容器组(Pod)的监控信息,包括:Pod 内存信息(内存使用量、内存使用率)、Pod CPU 信息(CPU 使用量、CPU 使用率)、Pod 网络信息(流入速率、流出速率)等。支持设置查询的时间段,并指定刷新方式(手动刷新、自动刷新)。
- 在集群管理页面的左侧导航栏中,选择 监控中心 > 监控看板。
- 在左侧看板列表中选择 工作负载监控 > 容器组监控,即可查看监控看板。
说明
您可以查看单个容器组的监控信息,也可以选择 All,查看全部容器组的监控信息。
容器监控
该看板用于查看指定命名空间下容器(Container)的监控信息,包括:Container 内存信息(内存使用量、内存使用率)、Container CPU 信息(CPU 使用量、CPU 使用率)等。支持设置查询的时间段,并指定刷新方式(手动刷新、自动刷新)。
- 在集群管理页面的左侧导航栏中,选择 监控中心 > 监控看板。
- 在左侧看板列表中选择 工作负载监控 > 容器监控,即可查看监控看板。

说明
您可以查看单个 Container 的监控信息,也可以选择 All,查看所有 Container 的监控信息。
弹性伸缩监控
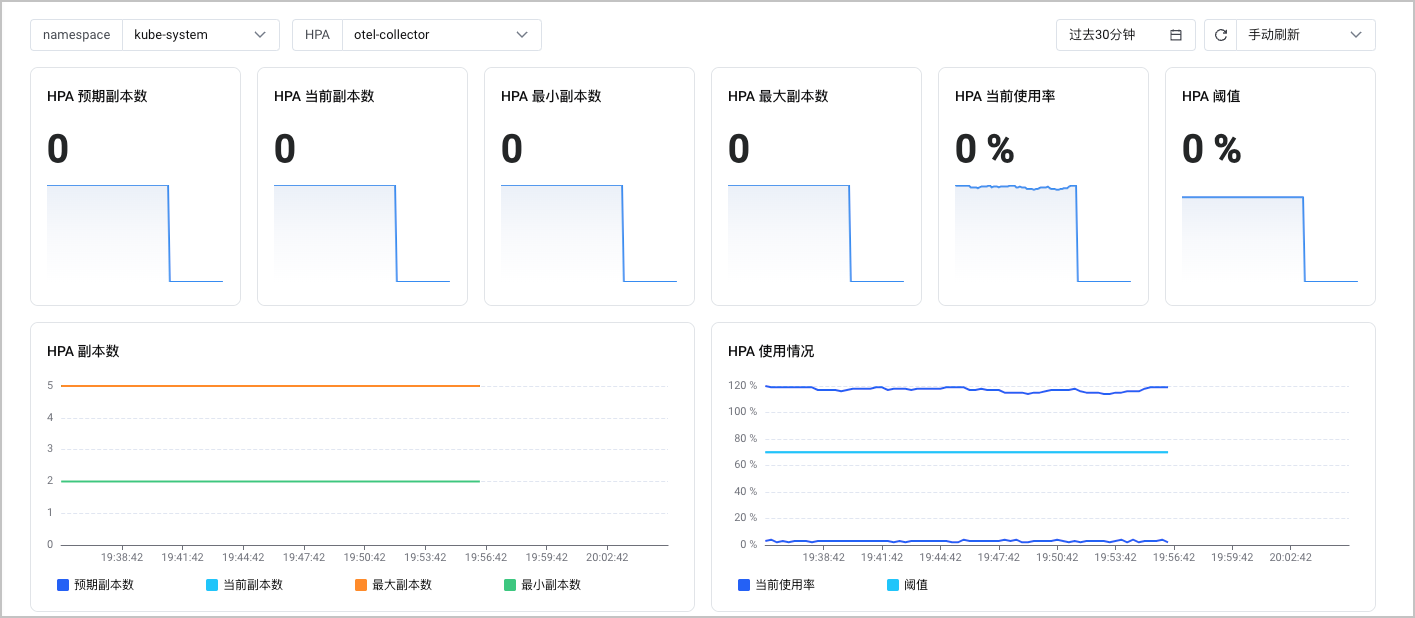
该看板用于查看命名空间下所有或指定 Pod 的 HPA 监控信息,包括:HPA 预期副本数、HPA 当前副本数等。支持设置查询的时间段,并指定刷新方式(手动刷新、自动刷新)。
- 在集群管理页面的左侧导航栏中,选择 监控中心 > 监控看板。
- 在左侧看板列表中选择 工作负载监控 > 弹性伸缩监控,即可查看监控大盘。
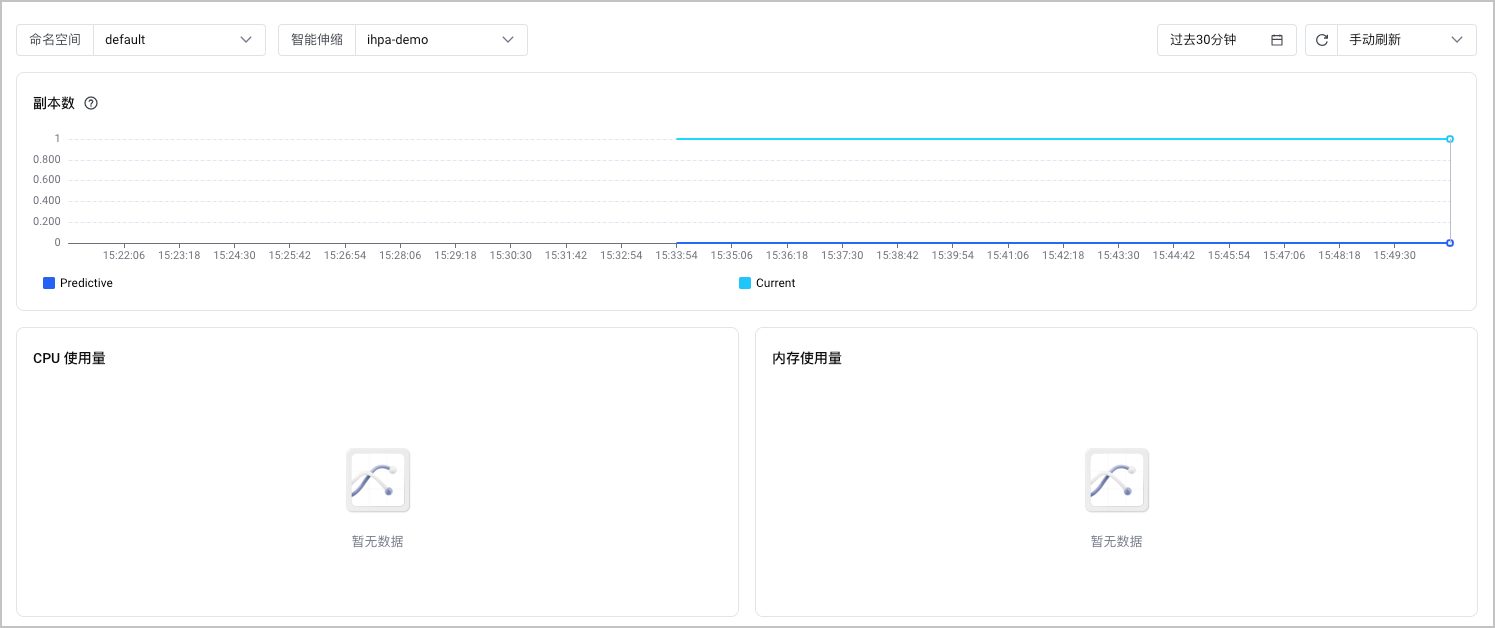
智能伸缩监控
该看板用于查看命名空间下 IHPA 的监控信息,包括:副本数、CPU 使用量、内存使用量等。支持设置查询的时间段,并指定刷新方式(手动刷新、自动刷新)。
- 在集群管理页面的左侧导航栏中,选择 监控中心 > 监控看板。
- 在左侧看板列表中选择 工作负载监控 > 智能伸缩监控,即可查看监控大盘。
存储观测看板
存储卷声明监控
该看板用于查看命名空间下所有或指定 PVC 的监控信息,包括:容量使用率和 inode 使用率。支持设置查询的时间段,并指定刷新方式(手动刷新、自动刷新)。
- 在集群管理页面的左侧导航栏中,选择 监控中心 > 监控看板。
- 在左侧看板列表中选择 存储服务监控 > 存储卷声明监控,即可查看监控大盘。

核心组件观测看板
metrics-server 监控
该看板用于查看核心组件 metrics-server 的观测指标。支持设置查询的时间段,并指定刷新方式(手动刷新、自动刷新)。
- 在集群管理页面的左侧导航栏中,选择 监控中心 > 监控看板。
- 在左侧看板列表中选择 核心组件监控 > metrics-server 监控,即可查看监控看板。
-
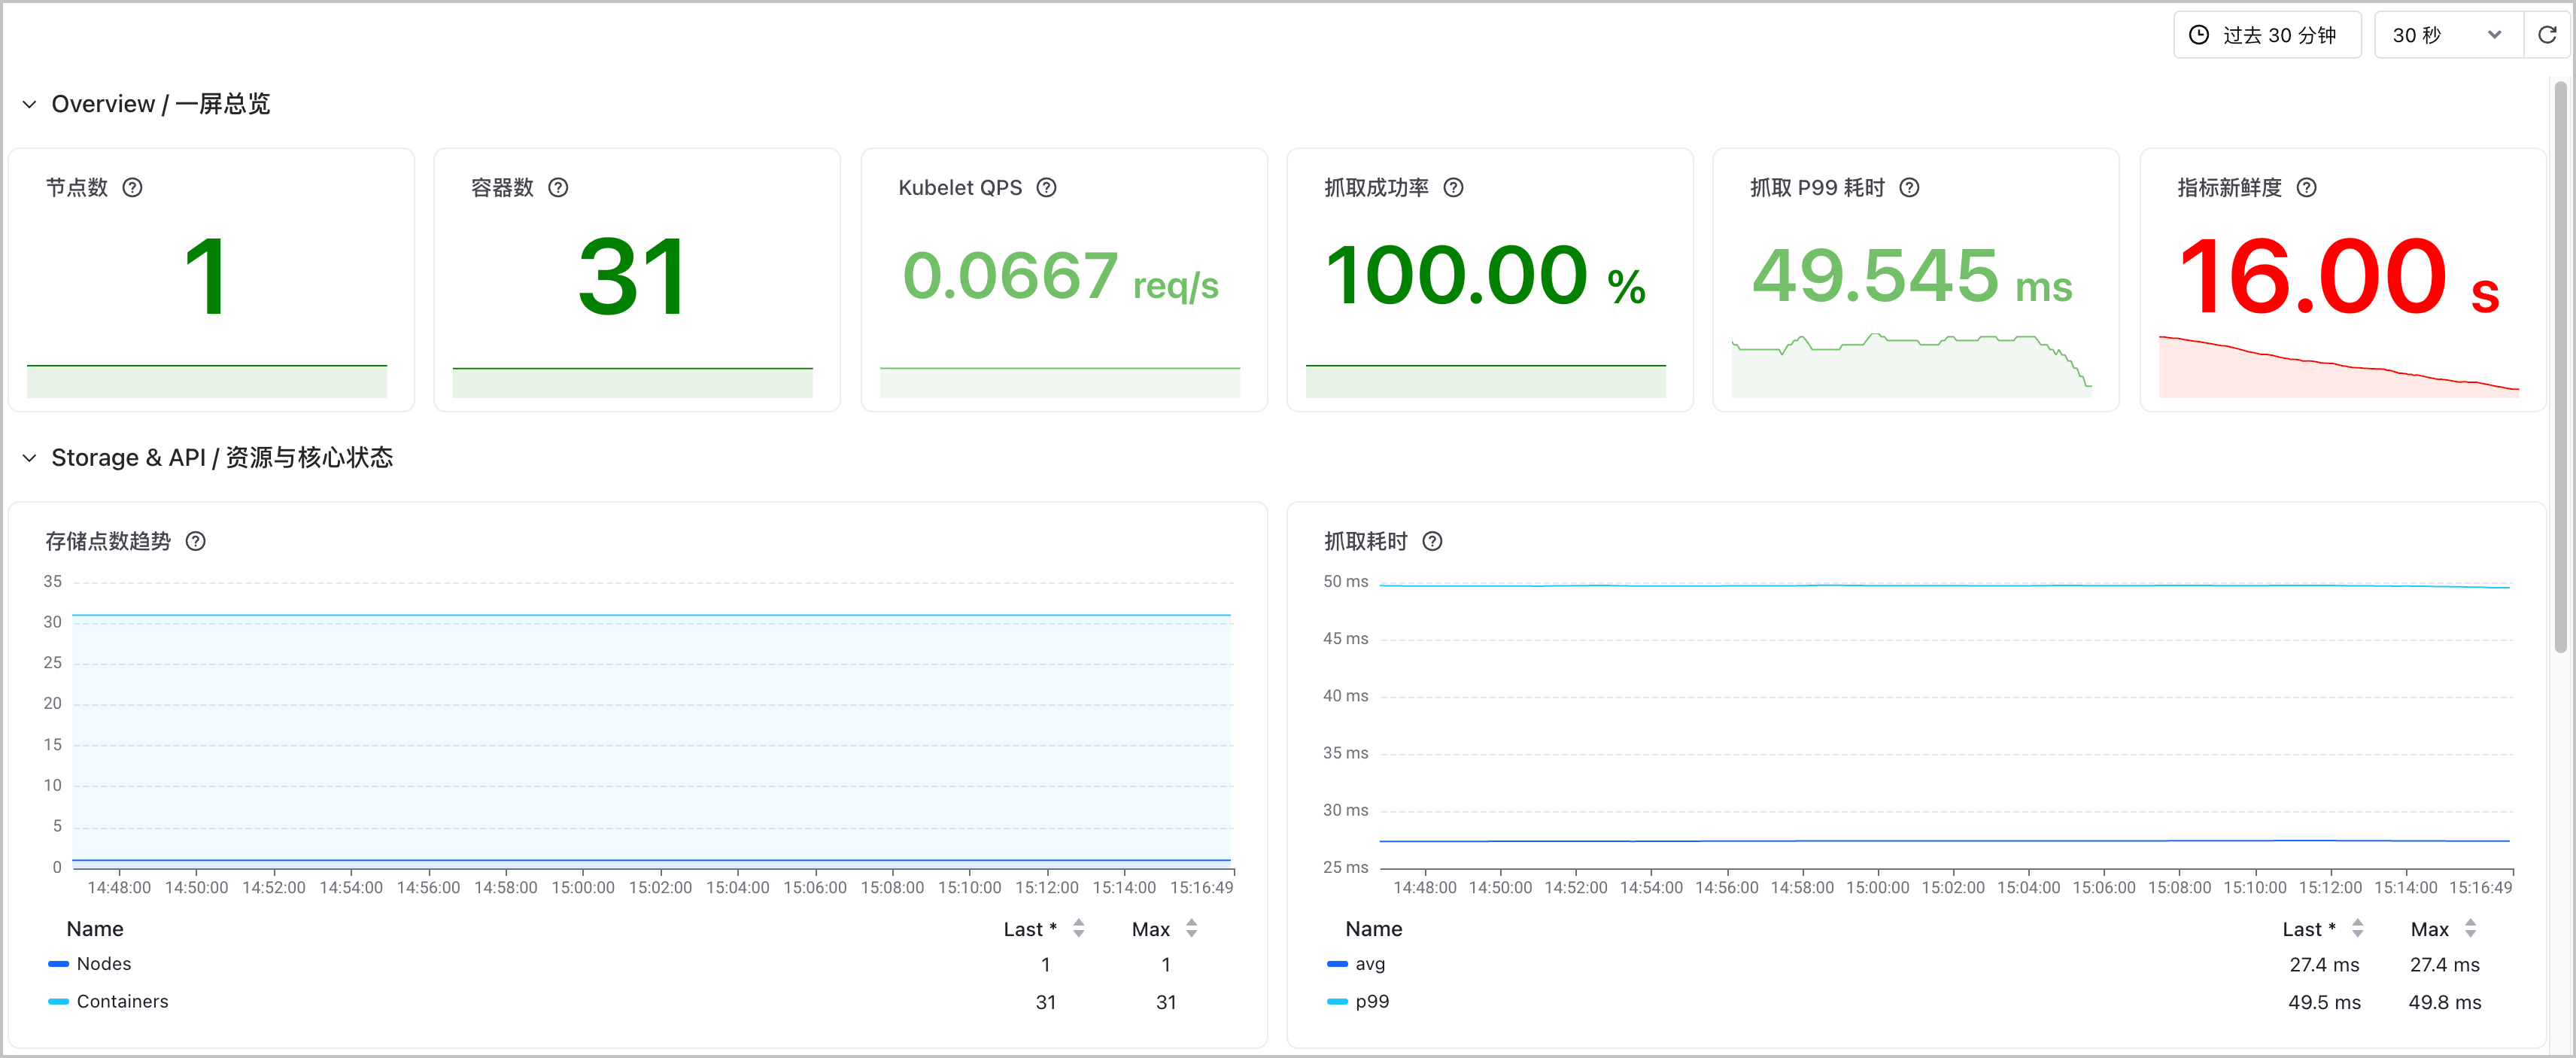
- metrics-server 监控看板详细的图表说明,如下表所示。
说明
-
查看指标
- 如需查询集群中的已接入/未接入指标,或查询指标的具体含义,请参见 指标查询。
- 支持使用托管 Prometheus 的 Explore 功能来快速查询和展示指标数据。详情请参见 指标查询。
最近更新时间:2026.09.09 15:43:57
这个页面对您有帮助吗?
有用
有用
无用
无用