实时音视频
实时音视频


文档指南

请输入


- 文档首页
 实时音视频AI 音视频互动方案开发指南上下文管理(短期记忆)
 复制全文
 下载 pdf
上下文管理(短期记忆)
 文档反馈
 问问助手
AI 可结合上下文识别用户当前表达、生成符合语境的回复,并用合适的语气播报结果。
不同上下文的作用范围如下:
LLM 上下文
LLM 上下文管理可赋予 AI 短期记忆能力,使其在单次会话中回溯并参考最近 N 轮历史对话记录,从而做出更精准、连贯的回复。
说明
设置全局上下文
在发起对话时,通过 StartVoiceChat 接口为 LLM 设定初始的上下文信息,该上下文作用于整个任务。不同的大模型平台,其上下文管理机制有差异。
火山方舟 LLM / 第三方 LLM
上下文机制
使用火山方舟平台或第三方 LLM 时,模型对话上下文主要由系统提示词(SystemMessages)、会话初始上下文(UserPrompts 和 TopUserPrompts)、历史对话轮数(HistoryLength)、工具调用历史(EnableToolCallHistory)以及运行中动态传入的上下文(ExternalPromptsForLLM)共同控制。
说明
UserMessages 是一个为保证向后兼容性而保留的旧版参数,在当前会话中,UserMessages 的内容不会像 UserPrompts 那样被自动逐出,会持续占用上下文空间,直到会话结束。不推荐使用。
敏感上下文自动移除
使用火山方舟 LLM 时,如果模型输出因命中内容审核而停止(finish_reason=content_filter),系统会自动将本轮用户输入和模型输出替换为非敏感占位内容,再生成后续轮次的 LLM 上下文。替换时会保留角色、轮次和工具调用等必要的对话结构,避免敏感文本影响后续对话,同时保证会话可以继续进行。该能力自动生效,无需新增 StartVoiceChat 配置。
系统会通过 VoiceChat 事件回调通知业务侧本轮生成未正常完成:RunStage 为 llmIncomplete,ExtraInfo.FinishReason 为 contentFilter。如果模型因达到输出长度上限而停止,ExtraInfo.FinishReason 为 length,系统仅发送回调,不会移除本轮上下文。详细字段说明参见事件和错误码。
说明
- 自动移除仅作用于后续 LLM 请求使用的短期上下文,不会撤回已经发送的字幕或音频。
- 视频截图不属于文本对话上下文。如果画面持续包含敏感内容,后续截图仍可能再次触发内容审核。
- 方舟服务直接返回的审核类 HTTP 400 错误不属于上述 finish_reason 处理范围。
上下文长度限制
上下文总长度(以 Tokens 计算)不得超过所选大模型的上限(如 8k)。计算方式取决于您使用的参数组合。
- (推荐)使用 UserPrompts / TopUserPrompts 时:
- 计算逻辑:SystemMessages 会话级持续生效,不按 HistoryLength 逐出。UserPrompts 支持自动逐出。TopUserPrompts 会始终保留,但会占用 HistoryLength;一组 user 和 assistant 计为一轮。
- 计算公式:
-
- 示例:若 HistoryLength 为 10,配置了 1 组 TopUserPrompts(一个 user 和一个 assistant),则剩余可保留的普通历史对话为 9 轮。若继续配置 UserPrompts 或产生新的自然语言对话,超过限制时会逐出最早的非置顶上下文。
- (不推荐)使用 UserMessages 时:
- 计算逻辑:UserMessages 会被永久保留,计算总长度时需包含全部内容。
- 计算公式:
-
- 示例:若 HistoryLength 为 3,模型上限 8k。由于 UserMessages 会永久存储,即使对话轮数增加,之前传入的 UserMessages 内容仍会一直占用上下文空间,因此需注意控制传入内容的长度以避免超出模型上限。
Coze 智能体
上下文管理模式
模式 | 配置 | 上下文生成逻辑 |
RTC 管理上下文 | EnableConversation: false | 模型对话上下文生成逻辑由历史问题轮数 HistoryLength 和 Coze 平台编排页人设与回复逻辑、插件、知识库共同控制。 |
Coze 平台管理上下文 | EnableConversation: true | 模型对话上下文生成逻辑完全由 Coze 平台编排页人设与回复逻辑、插件、知识库共同控制。HistoryLength 参数不生效。 |
上下文长度限制
需要确保编排页人设与回复逻辑、插件、知识库与会话内容文本总长度不超过大模型上下文长度。历史问题轮数在 RTC 管理上下文时通过 HistoryLength 参数控制,在 Coze 平台管理上下文时通过模型设置页面操作。
对话过程中传入上下文
ExternalPromptsForLLM 用于在对话过程中传入自定义文本,作为下一轮回答的上下文参考,但不会立即触发回复。该内容不占用 HistoryLength,只是补充下一轮用户提问;是否进入后续历史请以实际接入方式和版本行为为准。适用于需要结合实时变化或用户无法通过语音表达的隐式信息的场景。
使用限制
ExternalPromptsForLLM 在启用端到端实时语音大模型(S2SConfig)时无效。
通过服务端传入
调用 UpdateVoiceChat 接口传入上下文,并将 Command 设置为 ExternalPromptsForLLM,为下一轮对话设置上下文信息。
通过客户端传入
通过客户端 API (以 Android 端为例)构造一个 Command 为 ExternalPromptsForLLM 的控制消息,将自定义文本传入大模型。
- userId:填入 AI 的标识 ID(即 StartVoiceChat 配置的 AgentConfig.UserId)。
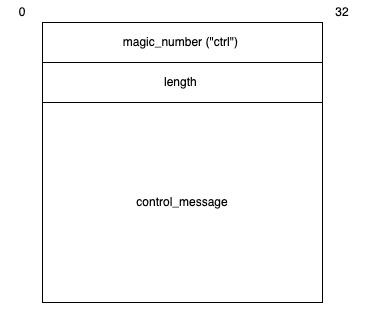
- buffer:需遵循 TLV 二进制格式:
control_message
示例代码:
清空动态传入的上下文
如需在用户提问前主动清除已动态传入的上下文信息,可再次调用服务端或客户端接口并传入空的 Message 字段。
添加固定上下文(图片或文本)
TopUserPrompts 支持预先添加固定文本或图片上下文,为模型补充必须始终保留的背景信息。
TopUserPrompts 会占用 HistoryLength(历史对话轮数)。一组 user 和 assistant 计为一轮。例如 HistoryLength 设为 10,配置 1 组 TopUserPrompts(一个 user 和一个 assistant)后,剩余可保留的普通历史对话为 9 轮。
保留 Function Calling 历史
默认情况下,历史上下文只保留用户和 AI 的自然语言对话内容,不保留 Function Calling 过程中产生的 assistant(tool_calls) 和 tool(response) 结构化消息。如果您的业务需要模型在后续轮次继续参考此前的工具调用结果,可在 StartVoiceChat 请求中将 LLMConfig.EnableToolCallHistory 设置为 true。
开启后,系统会把工具调用指令和工具返回结果作为所属对话轮次的一部分写入后续 LLM 请求。未触发 Function Calling 的轮次仍只包含用户提问和最终回复,不会额外产生工具调用历史。用户提问、工具调用指令、工具返回结果和最终回复计为一轮。例如第 N 轮触发工具调用时,后续上下文可包含如下顺序:
ASR 上下文
通过参数 ContextHistoryLength 设置,用于将最近指定轮数的会话内容送入流式语音识别大模型,使 ASR 模型能够结合对话背景识别当前语音。
该参数只影响语音识别结果,不等同于 LLM 的 HistoryLength,也不会直接决定 LLM 请求中携带多少轮对话历史。建议根据业务需要设置最近 1-2 轮,避免传入过多历史造成识别阶段负担。
TTS 上下文
通过参数 TTSConfig.Context.QuoteUserQuestion 设置,用于将用户问题作为上下文传递给 TTS,让 TTS 模型根据对话语境自动匹配更合适的回复语气。该能力发生在 LLM 已经生成回复之后,用于优化语音合成表现,不参与 LLM 推理,也不改变 LLM 历史上下文。
注意
QuoteUserQuestion 仅在使用豆包语音的语音合成大模型 2.0 时生效,且优先级低于指令标签。
最近更新时间:2026.10.16 17:53:30
这个页面对您有帮助吗?
有用
有用
无用
无用