实时音视频
实时音视频


文档指南

请输入


- 文档首页
 实时音视频AI 音视频互动方案开发指南声纹配置(多人识别或降噪)
 复制全文
 下载 pdf
声纹配置(多人识别或降噪)
 文档反馈
 问问助手
通过声纹技术,可实现声纹降噪与声纹识别,并支持全程监控功能运行状态:
- 声纹降噪:在嘈杂环境中(办公室、商场等),精准提取并放大目标用户的声音,抑制背景干扰。
- 声纹识别:通过辨识说话人身份(如不同家庭成员),提供个性化的回复或获取用户的对话历史与偏好。
- 获取声纹功能状态:支持通过回调实时获取声纹运行状态(如特征提取中、已生效)。
使用限制
- 公测说明:该功能目前为限时免费公测阶段,针对远场人声屏蔽效果较好。
- 用户数限制:
- 声纹降噪:单次通话仅支持指定 1 个目标用户。
- 声纹识别:单次通话最多支持识别 3 个目标用户。
- ASR 限制:仅支持流式 ASR,且 StreamMode 不能为 1(流式输入非流式输出)。
- 功能互斥:同一 AI 对话任务中,声纹降噪和声纹识别二选一,不能同时开启。启用声纹功能时,请勿开启 AI 降噪,以免影响声纹功能效果。
- 效果影响因素:声纹效果受音频采集质量、音频前处理、降噪和回声消除(AEC)算法、用户实际说话方式、注册时机等影响。声纹降噪和声纹识别的效果优化建议,分别参见实践:提升声纹降噪效果和实践:提高声纹识别准确性。
场景一:声纹降噪
从多人交谈的嘈杂环境(如办公室、商场)中提取目标人声,抑制他人背景干扰,让 AI “听得更清”。
方式 1:使用预注册的声纹
- 适用场景:用户身份固定(如个人设备),对精度要求极高。
- 实现方法:
- 上传声纹数据。
- 调用接口 RegisterVoicePrint 上传目标用户的声音样本,获取声纹 ID(VoicePrintId)。如果声纹已注册,可通过 ListVoicePrint 查询并复用已有 VoicePrintId。
注意
- 预注册音频需为 WAV 格式,16kHz 采样率、16bit 位深、单声道;音频总时长需在 15~30 秒之间,有效语音(非静音部分)不少于 12 秒,Base64 编码后的音频数据大小不超过 2MB。
- 建议在安静环境下采集清晰人声,并必须使用与真实通话一致的音频采集设备。声纹算法版本建议使用 Version: 2。
- 启用声纹降噪并传入声纹 ID。
- 调用 StartVoiceChat 接口时,配置 AgentConfig.VoicePrint。
- "VoicePrint": {"Mode": 1, // 开启声纹降噪"IdList": ["vp_id_123"], // 传入 1 个预注册声纹 ID"EnableSV": true, // 开启说话人强校验:仅当声纹分数达到 Score 阈值时,ASR 结果才送入 LLM"Score": 50, // 可选,声纹匹配的置信度阈值,推荐值 30~40"ProcessMode": 2, // 与 RegisterVoicePrint 的 Version 保持一致"SVMode": 2 // 可选,推荐与 ProcessMode 保持一致}
方式 2:实时注册声纹(无需提前上传)
- 适用场景:无需用户提前注册,系统会在通话开始后自动学习用户的声音特征。适用于用户不固定或首次体验的场景。
- 实现方法:
- 调用 StartVoiceChat 接口时,配置 AgentConfig.VoicePrint:
说明
- "VoicePrint": {"Mode": 1, // 必填,开启声纹降噪"EnableSV": true, // 可选,开启说话人强校验:仅当声纹分数达到 Score 阈值时,ASR 结果才送入 LLM"VoiceDuration": 20, // 可选,设置自动注册声纹所需的有效语音时长,取值范围 [2, 33],默认值为 12"Score": 50, // 可选,声纹匹配的置信度阈值,推荐值 30~40"ProcessMode": 2, // 可选,推荐使用 V2 算法"SVMode": 2 // 可选,推荐与 ProcessMode 组合为 2+2// "IdList" 无需传入}
- 当 TargetUserId 对应的用户累计有效说话时长达到 VoiceDuration 后,声纹自动生成并开始生效。若中途注册失败,系统会继续尝试注册;用户后续继续说话仍可能注册成功,但不会累计失败前已丢弃或已判定无效的音频。
- 注意事项
- 注册阶段要求:建议让主讲人占主导说话位置。若存在多人交替或同时说话,可能导致误注册或注册到占主导位置的人声。
- 实时声纹有效时间:实时注册成功后,声纹在当前 AI 对话任务内持续有效。若客户端进程退到后台再回到前台,只要 AI 对话任务未关闭,就无需重新注册。任务关闭后,实时注册声纹不再保留;如需跨任务持续使用,请使用预注册声纹。
动态开启、关闭或更新声纹降噪
- 支持的配置:
- 支持在对话过程中通过 UpdateVoiceChat 接口实现以下功能:
- 关闭或关闭声纹降噪功能。
- 更新实时声纹注册时长。
- 从预注册声纹切换为实时声纹。
- 使用前提和限制:
- 调用 StartVoiceChat 时,AgentConfig.VoicePrint 中的 Mode 必须为 1。
- 不支持在任务中创建或更新预注册声纹,也不适用于多人声纹识别场景。
- 实现方法:在对话过程中调用 UpdateVoiceChat 接口,将 Command 设为 UpdateVoicePrintSV,并通过 Message 传入以下配置项。
说明
- Enable:
- true:开启声纹降噪功能。
- false:关闭声纹降噪功能。
- VoiceDuration:用于设置或调整实时声纹注册所需的有效说话时长。取值范围为 [2, 33],单位为秒。若使用的是预注册声纹,设置该值后会转为实时声纹。
- 请求示例:
- {"AppId": "<YOUR_APP_ID>","RoomId": "<YOUR_ROOM_ID>","TaskId": "<YOUR_TASK_ID>","Command": "UpdateVoicePrintSV","Message": "{\"Enable\": true, \"VoiceDuration\": 30}"}
实践:提升声纹降噪效果
声纹降噪用于让 AI 在嘈杂环境中主要听清目标用户。接入时应围绕“目标用户声音是否稳定、干扰人声是否可被区分”来设计。
- 提高声音注册环境质量:
- 建议在安静环境下采集清晰人声,并使用与真实通话一致的音频采集设备。
- 保障注册人声干净清晰,保持正常讲话的语调语速和音量。
- 实时注册时,保证目标用户声音占主导,让目标用户靠近麦克风并保持稳定说话,避免被其他人声覆盖导致误注册。
- 按场景开启说话人验证并设置匹配阈值:配置 EnableSV: true,并通过 Score 设置声纹匹配的最低分数。开启后,系统会将实时说话人与目标声纹进行比对,只有匹配分数达到 Score 阈值时,才会把 ASR 结果送入 LLM;未达到阈值的语音会被拒识,可减少旁人说话误触发 AI。
- 使用 V2 降噪配置并开启二遍识别:推荐使用声纹降噪 V2(即 ProcessMode: 2 + SVMode: 2);同时建议开启 ASR 二遍识别能力。
- 使用 AI Client 媒体模式:移动端 SDK 接入时,建议使用 AI Client 媒体模式,使降噪和回声消除使用适合 AI 对话的配置,减少对声纹特征的损伤。以 Android 为例,调用 setAudioScenario,将 audioScenario 设置为 AICLIENT;并在通过 createRTCEngine 创建引擎时,通过 parameters 字段传入私有参数 "rtc.fg_config":"aigc_media_360=true"。
场景二:声纹识别(多人识别)
用于区分“谁在说话”,AI 可根据声纹识别用户身份,从而提供个性化的回复(如不同语气回复),或获取用户的对话历史与偏好。该功能适用于多用户共享 AI 设备或服务的场景。
实现方法
- 上传声纹数据。
- 调用接口 RegisterVoicePrint 上传不同成员(如:爸爸、孩子)的声纹样本,获取各自的 VoicePrintId。如果成员声纹已注册,可通过 ListVoicePrint 查询并复用已有 VoicePrintId。
注意
- 预注册音频需为 WAV 格式,16kHz 采样率、16bit 位深、单声道;音频总时长需在 15~30 秒之间,有效语音(非静音部分)不少于 12 秒。建议每个用户分别在安静环境下采集清晰人声,并必须使用与真实通话一致的音频采集设备。声纹算法版本建议使用 Version: 2。
- 建议为每个用户设置稳定、可读的 AudioName,例如 user_father、user_child。开启声纹识别后,字幕中的 voiceprintName 会返回注册声纹时传入的 AudioName,可用于身份展示、提示词判断和长期记忆归因。
- 调用 StartVoiceChat 接口时,需实现以下配置:
- 配置 LLMConfig.SystemMessages 实现个性化回复。提示词示例:
- 请根据对话中系统自动识别的 `(当前说话人是{AudioName})` 标签判断身份。如果是 user_child,请用活泼的语气;如果是 user_father,请用简练的语气;如果没有身份标签,则使用通用、中立的语气。
- 配置 AgentConfig.VoicePrint 开启声纹识别:
- Mode:设置为 2,启用声纹识别模式。
- IdList:传入已注册的声纹 ID,最多支持传入 3 个。
- Score(可选):设置身份识别的最低分数门限,取值范围 [1, 100],推荐值为 30~40。系统会计算实时语音与注册声纹的“相似度分数”。分数达到阈值时,会将对应身份信息携带给 LLM;分数低于阈值时,不携带该身份信息,但语音本身仍会正常送入 LLM。默认为空时不进行置信度过滤。
- EnableSV:声纹识别模式下不生效,无需配置。
配置示例
{
// ... 其他参数 (如 AppId, RoomId 等)
"AgentConfig": {
"VoicePrint": {
"Mode": 2,
"IdList": ["20250826****-****da54", "20250826****-****aa61"],
"Score": 50
}
// ... 其他 Agent 配置
},
"Config": {
"ASRConfig": {
"ProviderParams": {
"StreamMode": 0 // 此处不能设为 1
}
// ... 其他 ASR 配置
},
"LLMConfig": {
"SystemMessages": [
"请根据对话中系统自动识别的 `(当前说话人是{AudioName})` 标签判断身份。如果是 user_child,请用活泼的语气;如果是 user_father,请用简练的语气;如果没有身份标签,则使用通用、中立的语气。"
]
// ... 其他 LLM 配置
}
}
}
实践:提高声纹识别准确性
声纹识别用于区分“谁在说话”。如果业务需要基于身份做个性化回复、长期记忆或多人会话归因,建议优先保证注册声纹质量和实时比对链路稳定。
- 提高声音注册环境质量:
- 建议在安静环境下采集清晰人声,并使用与真实通话一致的音频采集设备。
- 保障注册人声干净清晰,保持正常讲话的语调语速和音量。
- 保持采集链路稳定:声纹采集和编码质量越高,比对越稳定。建议使用高质量麦克风和稳定的音频采集链路,保证采样率不低于 16kHz,并减少业务侧额外音频前处理。
- 使用 V2 声纹注册:调用 RegisterVoicePrint 预注册声纹时,建议将 Version 设置为 2,以使用推荐的声纹算法版本。
- 开启二遍识别:发起对话时,建议开启 ASR 二遍识别能力。
- 设置匹配阈值:配置 Score 控制身份识别的最低分数门限。配置后,系统会计算实时语音与预注册声纹的“相似度分数”:分数达到阈值时,将对应身份信息携带给 LLM;分数低于阈值时,不携带身份信息,但语音本身仍会正常送入 LLM。
获取对话声纹信息或实现长期记忆
- 获取对话声纹信息
- 开启声纹识别后,字幕消息中会返回声纹身份信息。你可以在实时字幕(对话记录)的数据格式中读取以下字段:
-
- 字段说明voiceprintId声纹 ID,对应预注册接口返回的 VoicePrintId。voiceprintName声纹名称,对应注册声纹时传入的 AudioName。voiceprintScore声纹相似度分数。
- 你可以将字幕中的 userId、voiceprintId、voiceprintName、voiceprintScore 与 text 一起存储,用于区分说话人、展示对话身份、构建长期记忆或排查声纹识别效果。
- 基于声纹实现长期记忆
- 让 AI “记住” 与不同用户的对话历史和偏好。可通过以下方式实现:
- 注册声纹并约定身份标识:调用 RegisterVoicePrint 预注册声纹,并为每个声纹设置稳定的 AudioName。
- 获取带身份的字幕:开启声纹识别后,实时字幕(对话记录)的回调信息中会包含 voiceprintId 和 voiceprintName(对应 RegisterVoicePrint 接口中的 AudioName)。
- 按声纹身份写入记忆:将对话记录、用户偏好或画像写入记忆库。写入记忆时,建议使用与声纹注册名称(AudioName,字幕中的 voiceprintName)一致的用户身份标识,以便后续按声纹识别结果召回。
- 开启声纹关联长期记忆召回:调用 StartVoiceChat 时,同时开启 Config.MemoryConfig.Enable 和 Config.MemoryConfig.EnableVoicePrintMemoryRecall,并将 AgentConfig.VoicePrint.Mode 设置为 2。开启后,系统会在每轮长期记忆检索前读取当前声纹识别结果,并优先按识别出的说话人身份召回对应记忆。具体配置参见按声纹实现长期记忆。
- 引导 LLM 使用记忆:在 SystemMessages 中进一步指导 LLM,根据识别到的用户身份和召回的长期记忆生成回复。
获取声纹功能的状态
开启任一声纹功能(降噪或识别)后,您都可以通过客户端或服务端回调,实时获取声纹在算法中的加载与生效状态。
通过客户端获取
- 启用声纹功能后,在客户端监听 RTC SDK 回调 ,并解析收到的二进制消息。
- 解析数据:声纹状态以二进制消息格式 message(magic number 为 stat)回调给客户端,收到消息后需解析 message。
- message 格式:参见声纹回调消息格式。
- message 解析示例:
- /*** @brief 解析并处理声纹状态消息 (stat)*/function handleVoicePrintStatus(message: ArrayBuffer) {if (!message || message.byteLength < 8) return;const dataView = new DataView(message);const magic = new TextDecoder().decode(message.slice(0, 4));if (magic === 'stat') {const length = dataView.getUint32(4, false); // false for big-endianif (message.byteLength < 8 + length) return; // 健壮性:检查包完整性const payload = new TextDecoder().decode(message.slice(8, 8 + length));let data: any;try {data = JSON.parse(payload);} catch {console.error('Failed to parse stat message payload as JSON.');return; // 健壮性:JSON 解析失败则退出}if (data.event === 'VoicePrintStatus') {console.log('当前声纹状态:', data.status); // 'Disabled', 'Registering', or 'Active'}}}import org.json.JSONObject;import org.json.JSONException;import java.nio.ByteBuffer;import java.nio.ByteOrder;import java.nio.charset.StandardCharsets;/*** @brief 解析并处理声纹状态消息 (stat)* @param buffer 从 onRoomBinaryMessageReceived 回调中获取的 ByteBuffer*/public static void handleVoicePrintStatus(ByteBuffer buffer) {if (buffer == null || buffer.remaining() < 8) {return;}// 关键:为保证能重复读取,先记录当前位置int initialPosition = buffer.position();buffer.order(ByteOrder.BIG_ENDIAN);byte[] magicBytes = new byte[4];buffer.get(magicBytes);String magic = new String(magicBytes, StandardCharsets.UTF_8);if ("stat".equals(magic)) {int length = buffer.getInt();if (length < 0 || buffer.remaining() < length) {buffer.position(initialPosition); // 恢复位置return; // 健壮性:检查包完整性}byte[] jsonBytes = new byte[length];buffer.get(jsonBytes);String jsonContent = new String(jsonBytes, StandardCharsets.UTF_8);try {JSONObject jsonObject = new JSONObject(jsonContent);if ("VoicePrintStatus".equals(jsonObject.optString("event"))) {System.out.println("当前声纹状态: " + jsonObject.optString("status"));}} catch (JSONException e) {// 健壮性:JSON 解析失败System.err.println("Failed to parse stat message payload as JSON.");}}// 恢复 buffer 的位置,以防其他代码需要处理此消息buffer.position(initialPosition);}#include <iostream>#include <string>#include <vector>#include <arpa/inet.h> // for ntohl#include "nlohmann/json.hpp"/*** @brief 解析并处理声纹状态消息 (stat)* @param message 从 onRoomBinaryMessageReceived 回调中获取的二进制数据指针* @param size 数据大小*/void handleVoicePrintStatus(const uint8_t* message, int size) {if (message == nullptr || size < 8) {return;}// 1. 校验 magic number "stat" (0x73746174)uint32_t magic = ntohl(*reinterpret_cast<const uint32_t*>(message));if (magic != 0x73746174U) {return;}// 2. 获取长度并检查边界uint32_t length = ntohl(*reinterpret_cast<const uint32_t*>(message + 4));if (static_cast<uint32_t>(size) < 8 + length) {return; // 健壮性:包不完整}// 3. 提取 JSON 字符串并安全解析std::string json_str(reinterpret_cast<const char*>(message + 8), length);nlohmann::json data = nlohmann::json::parse(json_str, nullptr, false);if (data.is_discarded()) {std::cerr << "Failed to parse stat message payload as JSON." << std::endl;return; // 健壮性:JSON 解析失败}if (data.value("event", "") == "VoicePrintStatus") {std::cout << "当前声纹状态: " << data.value("status", "N/A") << std::endl;}}/*** @brief 解析并处理声纹状态消息 (stat)* @param data 从 onRoomBinaryMessageReceived 回调中获取的 NSData 对象*/- (void)handleVoicePrintStatus:(NSData *)data {if (data == nil || data.length < 8) {return;}const uint8_t *bytes = data.bytes;// 1. 检查 Magic Number "stat" (0x73746174)// 使用 C-style 移位操作,注意字节序uint32_t magic = (uint32_t)OSReadBigInt32(bytes, 0);if (magic != 0x73746174) {return;}// 2. 获取长度并检查边界uint32_t length = (uint32_t)OSReadBigInt32(bytes, 4);if (data.length < 8 + length) {return; // 健壮性:包不完整}// 3. 解析 JSON BodyNSData *bodyData = [data subdataWithRange:NSMakeRange(8, length)];NSError *error = nil;id json = [NSJSONSerialization JSONObjectWithData:bodyData options:0 error:&error];if (error || ![json isKindOfClass:[NSDictionary class]]) {NSLog(@"Error: Failed to parse stat message payload as JSON.");return; // 健壮性:JSON 解析失败}if ([json[@"event"] isEqualToString:@"VoicePrintStatus"]) {NSLog(@"当前声纹状态: %@", json[@"status"]);}}
通过服务端获取
适用于需要在服务端进行状态记录、分析或触发业务逻辑的场景。
- 调用 StartVoiceChat 接口时,通过以下参数配置回调服务器:
-
- 参数说明AgentConfig.ServerMessageURLForRTS您的后端服务地址,用于接收回调消息。必须是公网可访问的 URL,且能正确处理无 Content-Type 的 HTTP POST 请求。AgentConfig.ServerMessageSignatureForRTS自定义认证密钥。此字符串会在回调请求中原样返回,用于校验请求合法性。
- 接收、校验并解析回调消息。
- 声纹状态会通过 HTTP(S) POST 请求发送给您指定的 URL 地址。
- 回调内容
-
-
- message 解析示例:
- package mainimport ("encoding/base64""encoding/binary""encoding/json""fmt""github.com/gin-gonic/gin")// --- 1. 需要您修改的配置 ---const (voicePrintStatusHeader = "stat"exampleSignature = "your_custom_secure_signature" // 替换为您在 StartVoiceChat 中配置的真实密钥)// RtsMessage 对应回调请求的整体结构type RtsMessage struct {Message string `json:"message"`Signature string `json:"signature"`}// VoicePrintStatusMsg 对应 "stat" 消息的 JSON 载荷type VoicePrintStatusMsg struct {Event string `json:"event"`Status string `json:"status"`}func HandleVoicePrintStatusMsg(c *gin.Context) {msg := &RtsMessage{}if err := c.BindJSON(&msg); err != nil {fmt.Printf("BindJson failed, err: %v\n", err)c.String(400, "Bad Request")return}// 校验签名if msg.Signature != exampleSignature {fmt.Printf("Signature not match\n")c.String(403, "Forbidden")return}// 解包并解析statusMsg, err := Unpack(msg.Message)if err != nil {fmt.Printf("Unpack failed, err: %v\n", err)c.String(400, "Bad Message Format")return}// 仅处理声纹状态事件if statusMsg.Event == "VoicePrintStatus" {fmt.Printf("Received VoicePrint Status: %s\n", statusMsg.Status)// 在此添加您的业务逻辑}c.String(200, "ok")}// Unpack 解析 Base64 编码的二进制消息func Unpack(msg string) (*VoicePrintStatusMsg, error) {data, err := base64.StdEncoding.DecodeString(msg)if err != nil {return nil, fmt.Errorf("DecodeString failed, err: %v", err)}if len(data) < 8 {return nil, fmt.Errorf("data invalid: length is less than 8")}// 校验 Magic NumberdataHeader := string(data[:4])if dataHeader != voicePrintStatusHeader {return nil, fmt.Errorf("header not match: expected '%s', got '%s'", voicePrintStatusHeader, dataHeader)}// 获取消息体长度dataSize := binary.BigEndian.Uint32(data[4:8])if dataSize+8 != uint32(len(data)) {return nil, fmt.Errorf("size not match: expected %d, got %d", dataSize+8, len(data))}// 解析 JSON 消息体subData := data[8:]status := &VoicePrintStatusMsg{}err = json.Unmarshal(subData, status)if err != nil {return nil, fmt.Errorf("unmarshal JSON failed, err: %v", err)}return status, nil}func main() {r := gin.Default()// --- 2. 需要您修改的配置 ---// 回调路径:这里的路径 ("/example_path/callback") 必须与您在 StartVoiceChat 中配置的 ServerMessageURLForRTS 的路径部分完全一致。r.POST("/example_path/callback", HandleVoicePrintStatusMsg)r.Run() // 默认监听 8080 端口}
声纹回调消息格式
声纹功能的状态通过二进制协议封装,结构如下:
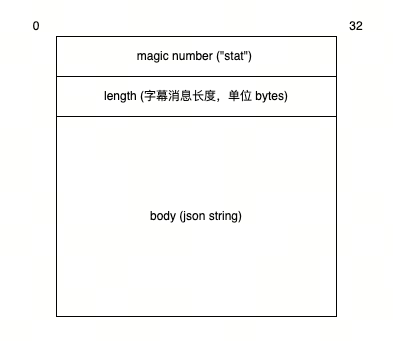
body
FAQ
声纹识别和声纹降噪的区别是什么?
- 声纹降噪用于在嘈杂环境中提取并增强目标用户声音,抑制背景人声和环境干扰,让 AI 更稳定地听到目标用户。
- 声纹识别用于辨识当前说话人的身份,例如区分家庭成员,并据此提供个性化回复或关联该用户的历史对话与偏好。
同一个 AI 对话任务中,声纹降噪和声纹识别二选一,不能同时开启。
声纹处理过程中发生错误,没录入成功的原因有哪些?
常见原因有:有效主讲人声不足、主讲人声音不清晰、注册阶段存在明显干扰人声、音频采集或编码质量较差、额外降噪或音频前处理损伤人声特征。发生错误时,可通过声纹状态回调中的 status=Failed、error_code 和 error 定位原因,具体错误码请参考声纹回调消息格式。
实时注册声纹失败后,用户继续说话还能注册成功吗?
可以。实时注册失败后,系统会继续尝试注册;用户后续继续提供有效主讲人声,仍可能注册成功。
需要注意,失败前的音频不会无限累计到后续注册流程中,后续能否成功取决于失败后继续采集到的有效人声是否满足注册要求。
实时注册声纹的有效期是多久?应用退到后台再回到前台后是否要重新注册?
实时注册声纹在当前 AI 对话任务内持续有效。只要 AI 对话任务没有关闭,即使客户端进程退到后台再回到前台,也不需要重新注册。
任务关闭后,实时注册声纹不再保留。若需要跨任务持续复用同一个用户的声纹,请使用预注册声纹,并在后续任务中通过 IdList 传入对应 VoicePrintId。
如果主讲人说了 3 秒、其他人说了 1 秒,会注册谁的声纹?
实时注册会优先依赖有效主讲人声。当前系统对注册音频有最小时长要求,建议让目标主讲人在注册阶段持续、清晰地说话,并避免其他人声交替插入。
如果注册阶段存在多人交替说话或干扰人声,可能导致误注册或注册质量下降。表现上更倾向于注册占主导位置的人声,但实际结果会受音量、距离、持续时长、ASR 句子形成情况和环境噪声影响。
最近更新时间:2026.09.21 16:24:33
这个页面对您有帮助吗?
有用
有用
无用
无用