实时音视频
实时音视频


文档指南

请输入


- 文档首页
 实时音视频硬件对话智能体用户指南使用 Function Calling
 复制全文
 下载 pdf
使用 Function Calling
 文档反馈
 问问助手
Function Calling 功能允许智能体识别用户话语中的特定意图,并调用外部函数以完成大模型无法独立完成的任务,例如查询实时信息(如天气)、控制设备(如调节音量)等。本教程将以实现一个“调节音量”的功能为例,指导客户端开发者为硬件对话智能体集成 Function Calling 功能。
使用限制
Function Calling 功能适用于以下大模型(LLM):
- 支持的方舟大模型参见模型名称(方舟平台)。
- 支持 Function Calling 功能的第三方大模型/Agent。
- 请确保您的大模型/Agent 已开启 Function Calling 功能。
功能介绍
一次完整的 Function Calling 交互包含以下阶段:
- 准备阶段:
- 您需要在客户端应用程序中,定义好具体的本地函数(例如,一个能够根据指令调节设备音量的 adjust_volume 函数),然后向智能体中添加该函数的描述。
- 交互阶段:
- 用户向智能体提问:“把音量调大一点”。
- 服务端上的 LLM 识别出用户的意图,并判断需要调用 adjust_volume 函数。
- 服务端向客户端发送一条包含函数名和参数({ "action": "increase", "step": 10 })的指令。
- 客户端的 SDK 监听到该指令,执行本地的 adjust_volume("increase", 10) 函数,并获取到返回值,例如 "当前音量已调至 50%"。
- 客户端通过 SDK 将此返回值上报给服务端。
- 服务端在收到客户端上报的函数执行结果后,生成音频回复,由客户端负责接收和播放。
实现概览
在客户端实现 Function Calling,开发者的主要工作是监听并解析服务端下发的函数调用指令,执行本地函数,并将结果返回给服务端。
实现方案
您可以通过低负载(WebSocket)或高质量(RTC)两种方案来实现,这两种方案在消息数据格式上存在如下差异:
- 低负载方案 (WebSocket):标准 JSON 格式。
- 高质量方案 (RTC):自定义二进制格式,头部 8 字节为消息类型(4 字节)和消息长度(4 字节,大端序),JSON Payload 部分为标准 JSON 字符串。
下文将分别介绍两种方案的实现细节。
使用的 API
整个实现过程主要依赖以下客户端 API:
- (接收指令)
- 这是一个回调函数。当服务端下发工具调用指令时,SDK 会通过此回调将指令内容传递给客户端。
-
- (发送消息)
- 这是一个主动调用接口。客户端通过此接口,可以向服务端发送自定义消息,例如返回函数执行结果。
-
- volc_send_text_to_agent(发送文本,仅限高质量方案)
- 这是一个主动调用接口。客户端通过此接口,可以向服务端直接发送文本消息,例如播报安抚语的 TTS 请求。
实现步骤
前提条件
您已经在客户端程序中集成了硬件对话智能体。
准备工作
在开始具体的编码工作前,您需要完成以下通用的准备环节。
1. 定义本地函数
您需要在客户端应用程序中,预先定义好希望智能体调用的本地函数。
在本文的示例中,我们假设您已定义了 adjust_volume(const char* action, int step) 函数,它能根据传入的指令调节设备音量。
2. 在控制台配置函数
无论是创建新智能体还是编辑现有智能体,您都需要在控制台中为设备所关联的智能体开启 Function Calling 功能,并对 adjust_volume 函数进行详细描述。
- 登录硬件对话智能体控制台。
- 在左侧导航栏,单击 智能体管理。
- 找到您的产品或设备当前关联的智能体,单击智能体卡片上的 编辑。
- 在左侧导航栏,单击 高级配置。
- 找到 Function Calling 区域,创建一个工具。
- 单击 创建工具。
- 在 创建 Function calling 工具 对话框,完成以下配置,然后单击 保存。
-
-
低负载方案实现步骤
低负载方案通过 WebSocket 实现。当识别到工具调用意图时,服务端会先发送一条不含参数的“通知”消息,再发送一条包含完整参数的“指令”消息。
步骤 1:接收通知与指令
您需要在 on_volc_message_data 回调中,通过判断消息的 type 字段来区分并处理两种不同的消息。
- 接收工具调用通知消息。
- 当 LLM 识别出工具调用意图后,您会先收到一条 type 为 conversation.item.created 的通知消息,其中 item.type 为 function_call。收到此消息后,您可以选择性地播报安抚语(见步骤 2(可选):播报安抚语)。
- 以下是 on_volc_message_data 回调中 data_ptr 参数的示例数据:
-
- 接收工具调用指令消息。
- 随后,您会收到一条 type 为 response.function_call_arguments.done 的指令消息。收到此消息后,您必须解析其 name 字段获取函数名,解析 arguments 字段获取函数参数,并执行相应的本地函数。
- 以下是 on_volc_message_data 回调中 data_ptr 参数的示例数据:
-
- arguments 字段的值是一个字符串,而不是一个 JSON 对象。您在客户端解析时,需要先获取这个字符串,然后再对这个字符串本身进行一次 JSON 解析,才能得到内部的参数(如 action)。
步骤 2(可选):播报安抚语
由于函数执行可能耗费较长时间,为了避免用户在等待过程中感到焦虑或不舒适,您可以在收到步骤 1 的通知消息后,调用 volc_send_message 接口,发送一个 conversation.item.create 事件来播报安抚语。通过播放安抚语,您可以安抚用户的情绪,提升用户体验。
说明
若在播放安抚语过程中收到返回的 Function Calling 最终答复,会在安抚语播放完毕后,继续播放 Function Calling 最终答复。
以下是 volc_send_message 请求中 data_ptr 参数的示例数据:
其中,interrupt_mode 用于控制文本播报内容的优先级。取值:
- 1:高优先级。智能体会终止当前交互,直接播放传入的文本内容。
- 2:中优先级。智能体会在当前交互结束后,播放传入的文本内容。
- 3:低优先级。如果此时智能体正在交互,智能体会直接丢弃传入的文本内容。如果未在交互,智能体会播放传入的文本内容。
步骤 3:执行函数并返回结果
函数执行完成后,您需要调用 volc_send_message 接口,通过 conversation.item.create 事件将执行结果返回给服务端。
- 方式 1:直接播报(不经 LLM 处理)
- 如果函数返回的结果是一句完整的话(如“音量已调大”),您可以将其包装成 input_tts 类型的消息发送给服务端进行 TTS 处理,处理结果由客户端直接播报。这种方式适用于回复无需润色或其他二次处理、回复的句子较长等场景。
- 以下是 volc_send_message 请求中 data_ptr 参数的示例数据:
-
- 方式 2:经 LLM 处理后播报
- 如果希望通过 LLM 对函数返回的结果进行总结、润色,您可将其包装成 input_text 类型的消息发送回服务端。服务端会先通过 LLM 生成更自然流畅的回复(如“音量已调至 50%”)再进行 TTS 处理,处理结果返回给客户端进行播报。
- 以下是 volc_send_message 请求中 data_ptr 参数的示例数据:
-
完成上述步骤后,用户会收到智能体根据函数执行结果生成的音频回复消息。
高质量方案实现步骤
高质量方案通过 RTC SDK 实现。当识别到工具调用意图时,服务端会先发送一条不含参数的“通知”消息,再发送一条包含完整参数的“指令”消息。
所有 RTC 的自定义消息(data_ptr)都采用的是“8 字节头部 + JSON Payload”的二进制格式。8 字节头部的具体结构为:
- 前 4 字节:消息类型标识符(如工具调用指令的标识符为 "tool",函数调用结果的标识符为 "func" 等)
- 后 4 字节:JSON Payload 的字符串长度(大端序)
头部之后是 JSON 文本内容(即 JSON Payload)。下文将提供 C 语言代码示例,演示如何解析和构造自定义消息。
步骤 1:接收通知与指令
您需要在 on_volc_message_data 回调中,通过判断消息头部的 4 字节标识符来区分并处理工具调用通知与指令。
- 接收工具调用通知消息。
- 当 LLM 识别出工具调用意图后,您会先收到一条类型为 info 的工具调用通知消息。收到此消息后,您可以选择性地播报安抚语(见步骤 2(可选):播报安抚语)。
- JSON Payload 示例(消息头部的 4 字节标识符为 info)
-
- C 语言代码示例 - 解析工具调用通知消息
-
- 接收工具调用指令消息。
- 随后,您会收到一条类型为 tool 的工具调用指令。收到此消息后,您必须解析其 name 字段获取函数名,解析 arguments 字段获取函数参数,并执行相应的本地函数。
说明
建议采用异步方式执行函数,避免阻塞回调线程,影响其他功能的正常运行。
- JSON Payload 示例(消息头部的 4 字节标识符为 tool)
-
- C 语言代码示例 - 解析工具调用指令
-
步骤 2(可选):播报安抚语
由于函数执行可能耗费较长时间,为了避免用户在等待过程中感到焦虑或不舒适,您可以在收到步骤 1 的通知消息后,调用 volc_send_text_to_agent 接口,发送一条 TTS 消息来播报安抚语。通过播放安抚语,您可以安抚用户的情绪,提升用户体验。
说明
若在播放安抚语过程中收到返回的 Function Calling 最终答复,会在安抚语播放完毕后,继续播放 Function Calling 最终答复。
C 语言代码示例 - 发送安抚语
步骤 3:执行函数并返回结果
函数执行完成后,您可以通过两种方式将执行结果返回给服务端,一种是直接播报(不经过 LLM 处理),一种是经 LLM 处理后播报。
- 方式 1:直接播报(不经 LLM 处理)
- 适用于回复无需润色或其他二次处理、回复的句子较长等场景。
- 与播放安抚语类似,您可以主动调用 volc_send_text_to_agent 接口,发送一条 TTS 消息来播报函数返回结果。
- C 语言代码示例 - 直接播报
-
- 方式 2:经 LLM 处理后播报
- 适用于需要通过 LLM 对函数返回的结果进行总结、润色,生成更自然流畅的回复。
- 您需要调用 volc_send_message 接口,将执行结果返回给服务端。
- JSON Payload 示例(消息头部的 4 字节标识符为 func)
-
- C 语言代码示例 - LLM 处理后播报
-
完成上述步骤后,用户会收到智能体根据函数执行结果生成的音频回复消息。
最佳实践
通过系统提示词精准控制调用时机
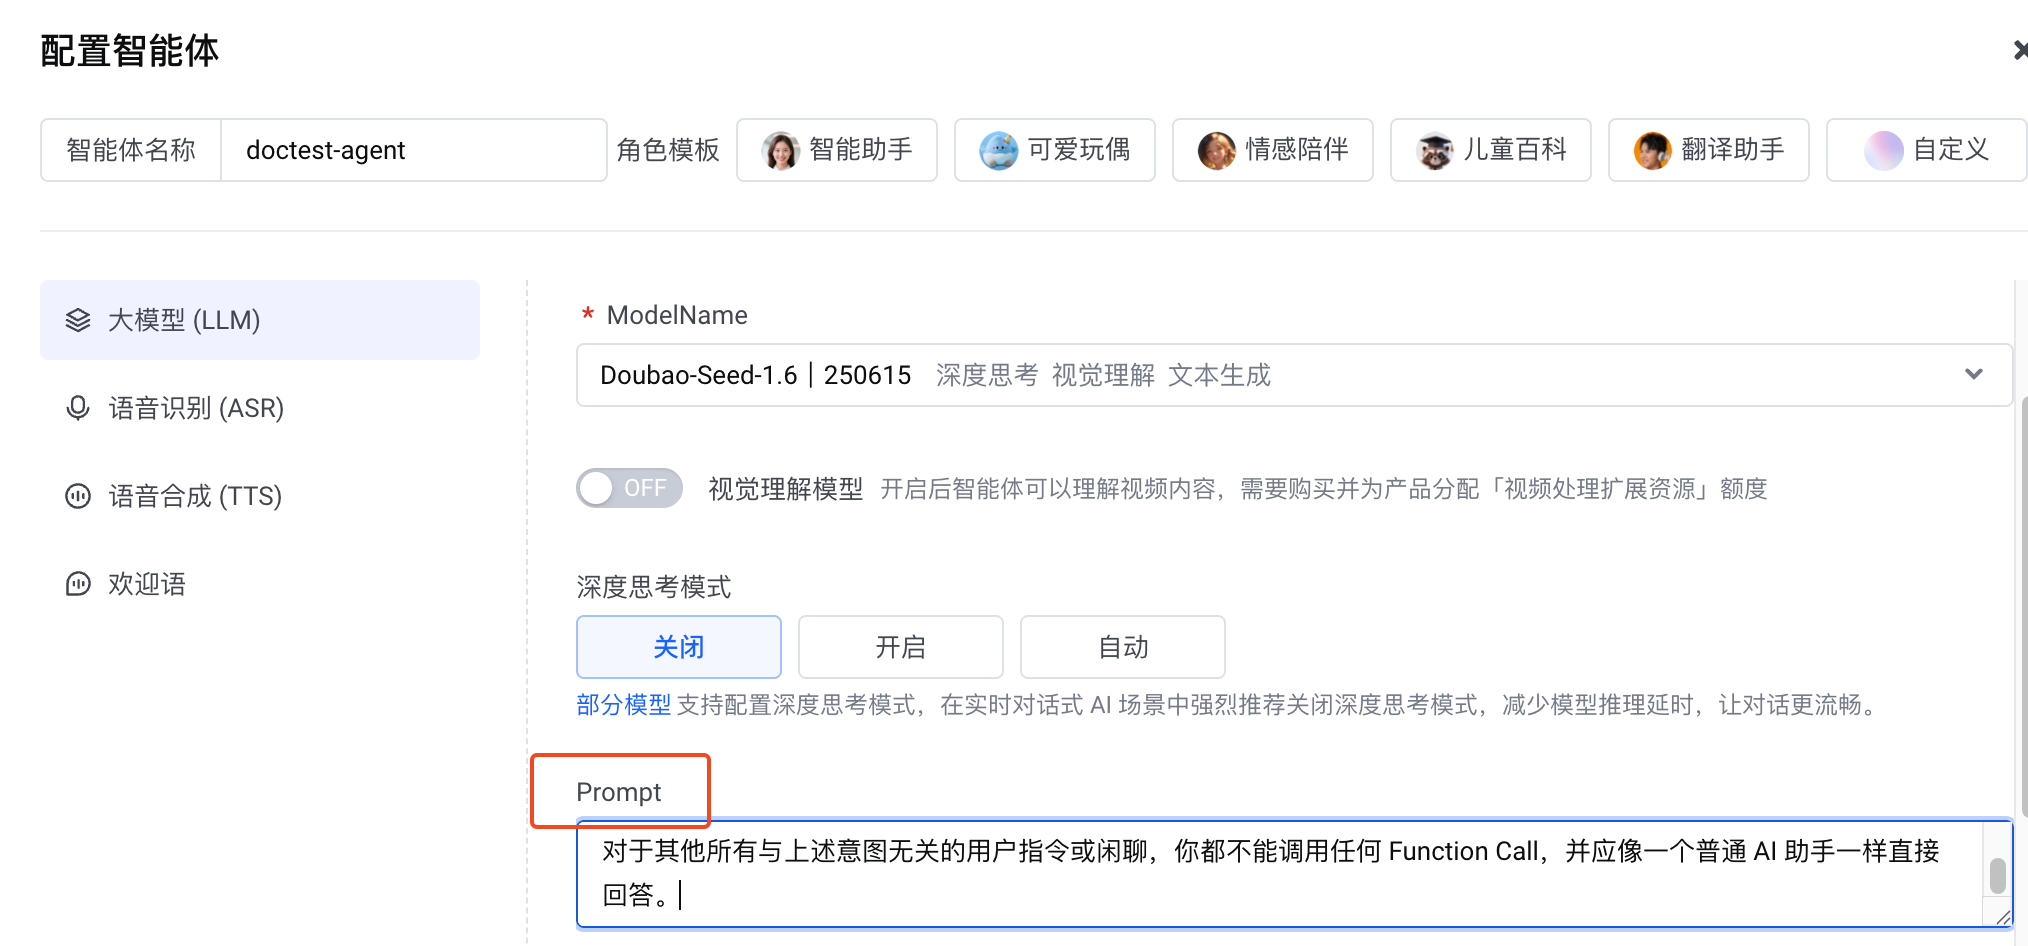
您可以通过设计系统提示词(Prompt),为大模型设定明确的规则,以限制函数调用的触发时机,避免在非必要的情况下执行函数调用,从而节约成本和系统资源。
示例:
为避免 LLM 对用户的日常闲聊(如“你叫什么名字?”)也尝试调用函数,您可以为智能体设置如下 Prompt:
合理使用安抚语提升用户体验
对于执行耗时较长(如网络请求)的函数,等待过程可能会让用户感到焦虑。因此,在调用这类函数前,主动播报一句安抚语(如“请稍等,正在为您查询”)是提升用户体验的关键。
建议使用时机:
- 网络请求类函数:如查询天气、股票、新闻等,网络延迟是不可控因素。
- 耗时 I/O 操作:如读写大文件、查询本地数据库等。
说明
根据经验,对于任何预计执行时间可能超过 2 秒的函数,都建议您在调用前先播报安抚语。
最近更新时间:2026.07.02 17:20:29
这个页面对您有帮助吗?
有用
有用
无用
无用