实时音视频
实时音视频


文档指南

请输入


- 文档首页
 实时音视频AI 音视频互动方案API 参考开启 AI 对话 StartVoiceChat
 复制全文
 下载 pdf
开启 AI 对话 StartVoiceChat
 文档反馈
 问问助手
调用 StartVoiceChat 接口,在你的应用中接入一个具备听说能力的 AI,使其与真人用户进行自然、流畅、真人感的实时对话。
使用说明
- 如何调用接口:
- 调用方法:发送 HTTP(S) 请求时,你需要符合火山引擎规范。调用接口的请求结构、公共参数、签名机制、返回结构,参看如何调用 OpenAPI。
- 请求频率:单账号下 QPS 不得超过 60。
- 请求接入地址:仅支持 rtc.volcengineapi.com。
- 任务状态监控:调用本接口后返回 200,仅代表任务下发成功,不代表 AI 已成功入房或可以正常工作。你可以前往 AI音视频互动方案控制台-功能配置-回调配置开启事件回调,通过监听 VoiceChat 事件来任务状态。具体操作及事件说明,请参见获取 AI 对话任务事件。
- 任务生命周期与成本管理:调用该接口开启 AI 对话后,若 AgentConfig.TargetUserId 用户退出房间,180s 后该任务会自动停止,但该 180s 内仍会计费。你可以通过 AgentConfig.IdleTimeout 参数自定义此等待时长。为避免不必要的费用,建议 AgentConfig.TargetUserId 退出房间后,及时调用 StopVoiceChat 接口关闭对话任务。
请求说明
- 请求方式:POST
- 请求地址:https://rtc.volcengineapi.com?Action=StartVoiceChat&Version=2025-06-01
请求参数
Query
Action String 必选示例值:StartVoiceChat
接口名称。当前 API 的名称为 StartVoiceChat。
Version String 必选示例值:2025-06-01
接口版本。当前 API 的版本为 2025-06-01。
Body
AppId String 必选示例值:661*****3cf
AI 音视频互动方案的应用 AppId。
注意
RoomId String 必选示例值:Room1
RTC 房间的 ID。需与生成 RTC 鉴权 Token 时使用的 RoomId 一致。
TaskId String 必选示例值:task1
任务 ID。由您自行定义,用于唯一标识该对话任务。后续调用 UpdateVoiceChat(更新)或 StopVoiceChat(结束)时必须传入相同的 TaskId。
- 命名规范:请参见参数赋值规范。
- 唯一性规则:在同一个 AppId 和 RoomId 组合下,TaskId 必须唯一。不同房间可以使用相同的 TaskId。
BusinessId String 可选 示例值:chatroom
Config Object 必选示例值:-
AI 对话交互配置,包括语音识别(ASR)、大模型(LLM)、语音合成(TTS)、端到端语音模型、字幕、打断、函数调用、联网问答、记忆库等。
ASRConfig Object 可选 示例值:-
语音识别(ASR)相关配置。
注意
启用端到端语音模型(S2SConfig)后,该配置会失效。
Provider String 必选示例值:volcano
语音识别服务的提供商:
- volcano:火山引擎的豆包语音服务。可使用以下模型:
- 豆包流式语音识别模型2.0(即流式语音识别2.0)
- 流式语音识别大模型(即流式语音识别1.0)
- ai_gateway:自定义语音识别模型(通过火山边缘大模型网关接入的)
ProviderParams 必选示例值:-
服务配置参数。不同服务,ProviderParams 包含的字段不同:
(豆包语音)流式语音识别2.0/1.0(参数透传) Object
此方式支持流式语音识别大模型服务的所有配置参数(如直传不支持的 VAD 顺滑), 相较于直传配置更灵活、功能更全面。
Mode String 必选示例值:bigmodel
模型类型。该参数固定取值:bigmodel,表示豆包语音的流式语音识别模型。
VolcanoASRParameters String 必选示例值:"{"request":{"vad_segment_duration":1000,"end_window_size":500}}"
如何配置该字段:
- 基础用法:若您不需要进行任何自定义配置,接受平台所有默认行为,可将该字段值设为空的 JSON 对象,即 VolcanoASRParameters: "{}"。
- 高级用法:若您需要判停、热词等功能,则需要通过此参数传入对应的参数配置。
- 根据需求,参考文档 大模型流式语音识别API 选取您需要的参数构建一个 JSON 对象,然后将其转为 JSON 字符串。请确保您已充分了解所需透传参数的具体行为和潜在影响。
- 将该 JSON 对象压缩并转义为字符串后,作为 VolcanoASRParameters 的值传入。例如,要将静音判停阈值设为 500 毫秒,则为 "{\"request\":{\"end_window_size\":500}}"。
可透传的参数:
- 支持的参数:大模型流式语音识别API 中的请求参数(即 发送 full client request 表格下的参数)。下方无需透传的参数除外。
- 不可透传的参数:
- 以下参数由平台统一管理,您的 JSON 对象中不可包含这些字段:
- user
- request.show_speech_rate
- request.show_volume
- request.enable_lid
- request.enable_emotion_detection
- request.enable_gender_detection
- request.show_utterances
- request.result_type
- request.model_name
- request.force_to_speech_time
- audio.format
- audio.codec
- audio.rate
- audio.bits
- audio.channel
Credential Object 可选 示例值:-
模型凭证配置。
注意
- 若需使用自定义开通的豆包语音 ASR 服务,则必须填写该字段,并传入 AppId 和 AccessToken。
- 若不填写 AppId 和 AccessToken,则使用的是公共 ASR 资源。公共资源默认支持 50 并发。如需超过 50 并发,请提交工单申请扩容。
ApiResourceId String 可选 示例值:volc.bigasr.sauc.duration
指定要使用的流式语音识别大模型版本:
- volc.bigasr.sauc.duration(默认值):语音识别大模型(即语音识别1.0)。
- volc.seedasr.sauc.duration:豆包语音识别模型2.0(即语音识别2.0)。
注意
使用流式语音识别大模型 2.0 版本时,StreamMode 取值只能为 1 或 2(推荐)。
AppId String 可选 示例值:93****21
注意
- 仅在若需使用自定义开通的豆包语音 ASR 服务时必填且生效。
- 使用自定义开通的流式语音识别大模型服务时,产生的 ASR 费用独立计费,不会折算为 Tokens,不可通过 Tokens 资源包抵扣,计费由豆包语音收取。具体计费规则,请参见 豆包语音_计费说明。
AccessToken String 可选 示例值:MOaOaa_VQ6****1B34UHA4h5B
注意
- 仅在需使用自定义开通的豆包语音 ASR 服务时必填且生效。
- 使用自定义开通的流式语音识别大模型服务时,产生的 ASR 费用独立计费,不会折算为 Tokens,不可通过 Tokens 资源包抵扣,计费由豆包语音收取。具体计费规则,请参见 豆包语音_计费说明。
StreamMode Integer 可选 示例值:2
语音识别结果返回模式:
- 0(默认值):流式输入流式输出。识别结果会分段、实时地返回。该模式下识别速度更快,适用于对实时性要求高的场景,如实时字幕。
- 1:流式输入非流式输出。即在完整接收并处理完整个语音片段后,一次性返回最终的识别结果。该模式下识别准确率更高,适用于对实时性要求不高的场景,如会议录音转写。
- 2(推荐):双向流式优化版。在流式输入和流式输出的基础上,支持对检测到的完整语句片段进行二次非流式识别,兼顾实时性与准确性。
- 要启用二次识别,您必须在 VolcanoASRParameters 参数中透传 "enable_nonstream": true。
注意
使用流式语音识别大模型 2.0 版本时,StreamMode 取值只能为 1 或 2,推荐用 2。
ContextHistoryLength Integer 可选 示例值:0
上下文轮次。将最近指定轮数会话内容送入流式语音识别大模型,有助于模型理解当前对话的背景,从而提升大模型识别准确性。
取值范围为 [0, 20],默认为 0 表示不开启该功能。
(豆包语音)流式语音识别2.0/1.0(参数直传) Object
此方式封装了流式语音识别大模型的部分配置参数,接入简单,但无法使用该服务的全部功能。
Mode String 必选示例值:bigmodel
模型类型。该参数固定取值:bigmodel,表示豆包语音的流式语音识别大模型。
ApiResourceId String 可选 示例值:volc.bigasr.sauc.duration
指定要使用的流式语音识别大模型版本:
- volc.bigasr.sauc.duration(默认值):流式语音识别大模型(即语音识别1.0)。
- volc.seedasr.sauc.duration:豆包语音识别模型2.0(即语音识别2.0)。
注意
使用豆包语音识别模型2.0 时,StreamMode 取值只能为 1 或 2(推荐)。
AppId String 可选 示例值:93****21
注意
- 仅在需使用自定义开通的流式语音识别大模型时必填且生效。
- 使用自定义开通的流式语音识别大模型服务时,产生的 ASR 费用独立计费,不会折算为 Tokens,不可通过 Tokens 资源包抵扣,计费由豆包语音收取。具体计费规则,请参见 豆包语音_计费说明。
- 若不填写 AppId 和 AccessToken,则使用的是公共 ASR 资源。公共资源默认支持 50 并发。如需超过 50 并发,请提交工单申请扩容。
AccessToken String 可选 示例值:MOaOaa_VQ****h5B
注意
仅在需使用自定义开通的流式语音识别大模型时必填且生效。
StreamMode Integer 可选 示例值:2
语音识别结果返回模式:
- 0(默认值):流式输入流式输出。识别结果会分段、实时地返回。该模式下识别速度更快,适用于对实时性要求高的场景,如实时字幕。
- 1:流式输入非流式输出。即在完整接收并处理完整个语音片段后,一次性返回最终的识别结果。该模式下识别准确率更高,适用于对实时性要求不高的场景,如会议录音转写。
- 2(推荐):双向流式优化版。在流式输入和流式输出的基础上,支持对检测到的完整语句片段进行二次非流式识别,兼顾实时性与准确性。
要启用二次识别,您必须将 enable_nonstream 参数设置为 true。
注意
使用流式语音识别大模型 2.0 版本时,StreamMode 取值只能为 1 或 2,推荐用 2。
enable_nonstream Boolean 可选 示例值:true
是否在双向流式优化版(StreamMode: 2)的基础上开启二遍识别。
- false(默认值):不开启。
- true:开启二遍识别。开启后,当用户的说话停顿时间超过 ASRConfig.VADConfig.SilenceTime 时,系统会对该分句音频再进行一次识别(此次识别为流式输入非流式输出)。
context String 可选 示例值:"{\"hotwords\": [{\"word\": \"CO2\"},{\"word\": \"雨伞\"},{\"word\": \"鱼\"}]}"
热词直传(通过 JSON 字符串直接传入)。默认为空。
如果某些词汇(比如人名、产品名等)的识别准确率较低,可以将其作为热词传入 ASR 模型,提高输入词汇的识别准确率。例如传入"雨伞"热词,发音相似的词会优先识别为“雨伞”。
- 大小限制:热词传入最大值为 200 tokens,超出会自动截断。
- 格式要求:JSON 字符串。
context_history_length Integer 可选 示例值:0
上下文轮次。将最近指定轮数会话内容送入流式语音识别大模型,有助于模型理解当前对话的背景,从而提升大模型识别准确性。
取值范围为 [0, 20]。0(默认值)表示不开启该功能。
自定义语音识别 Object
URL String 必选示例值:wss://ai-gateway.vei.volces.com/v1/realtime?model=customasr
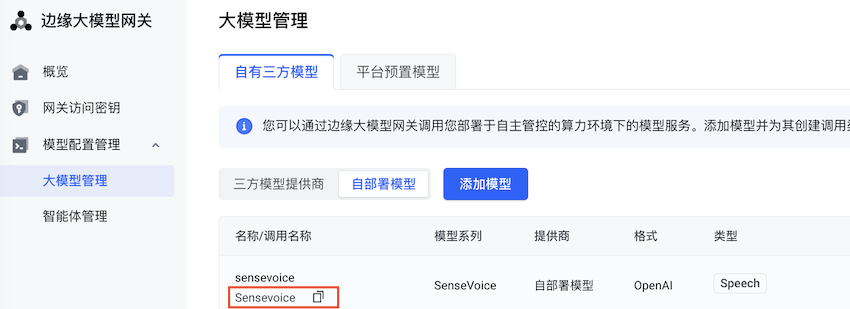
边缘大模型网关的服务接入点 URL。StartVoiceChat 会通过此地址连接到网关,网关再将请求转发给你的自定义 ASR 服务。
- URL 格式:wss://ai-gateway.vei.volces.com/v1/realtime?model=<ASR 调用名称>。
- <ASR 调用名称>:需替换为您在边缘大模型网关控制台中自定义的模型调用名称。获取路径:边缘大模型网关_大模型管理。
APIKey String 必选示例值:sk-xxxxxx
ExtraData JSONMap 可选 示例值:{"custom_param": "value1"}
自定义参数,将以 JSON 格式透传给你的自定义 ASR 服务。默认为空。
ExtraHeader JSONMap 可选 示例值:{"custom_header": "value"}
自定义透传 Header。一个 JSON 对象,其键值对将作为额外的 HTTP Header 字段,透传到您的自定义 ASR 服务请求中,可用于鉴权或其他自定义逻辑。
VADConfig Object 可选 示例值:-
VAD(语音检测) 配置。
SilenceTime Integer 可选 示例值:600
判停静音时长。当 AgentConfig.TargetUserId 静音时长超过该设定值时,系统判定用户本轮说话结束。
取值范围为 [500,3000),单位为 ms,默认值为 600。
AIVAD Boolean 可选 示例值:false
是否开启智能语义判停。
启用后,系统会在用户说话过程中实时引入 AI 模型来分析用户语义是否完整,并根据分析结果决定何时判定用户发言结束:
- 如果判定语义完整,且用户静音时长达到 SilenceTime 时,系统会判定用户本轮发言结束。
- 如果判定语义不完整,用户静音时长只要超过 2 秒,系统就判定用户本轮发言结束。
该功能有效提升在复杂对话场景下(如长句、思考停顿)判停的准确性,避免将一句完整的话错误地拆分为多轮对话。
- true:开启。为了达到最佳的断句效果,建议组合使用 SilenceTime 和 LLMConfig.Prefill。具体配置建议,请参见进阶配置:语义判停与预填充。
- false(默认值):关闭。
注意
AIVAD 功能目前在限时免费公测阶段。
ForceBeginThreshold Integer 可选 示例值:0
首帧打断阈值。
当 AI 正在播报时,若系统(基于 VAD)检测到用户语音持续时长达到该设定值,AI 立即停止播报。此过程不完全依赖 ASR 识别具体文字。
- 取值范围: [0, 1000],单位毫秒。
- 默认值:0,即禁用此功能。
说明
在嘈杂环境下,设置过小的阈值可能导致 AI 被环境噪音误打断(如突然的关门声、咳嗽声)。
ForceEnd Boolean 可选 示例值:false
是否开启辅助 VAD 强制判停。
开启后,一旦用户静音时长达到 SilenceTime,系统会立即判定用户发言结束,并终止本轮 ASR 识别。适用于对响应速度要求极高,且用户说话节奏较快的场景。此过程基于 VAD 实现,不依赖 ASR 判停。
- false(默认值):关闭。
- true:开启。
VolumeGain Float 可选 示例值:0.3
音量增益值。增益值越低,采集音量越低。适当低增益值可减少噪音引起的 ASR 错误识别。
默认值为 1.0,推荐值 0.3。
InterruptConfig Object 可选 示例值:-
语音打断配置,支持基于说话时长打断、关键词打断。
注意
该功能仅在 InterruptMode 为 0时生效。
InterruptSpeechDuration Integer 可选 示例值:500
自动打断的触发阈值,即 AgentConfig.TargetUserId 持续说话时长达到设定值,AI 才自动停止输出。
- 取值范围:0 或 [200,3000],单位为 ms。值越大,AI 越不容易被打断。
- 默认值:0,表示用户发出声音且包含真实语义时,AI 就停止输出。
InterruptKeywords String[] 可选 示例值:["停止", "停下"]
触发打断的关键词列表。
当用户语音中识别到列表中的任意关键词时,AI 将立即停止输出,以降低背景环境人声误打断的干扰。默认为空,表示不触发关键词打断。
注意
使用该参数时,建议 InterruptSpeechDuration 设置为 0,避免自动打断触发阈值过高,导致关键词打断不生效。
TurnDetectionMode Integer 可选 示例值:0
新一轮对话的触发方式。
- 0(默认值):自动触发。服务端检测到完整的一句话后,自动触发新一轮对话。
- 1:不自动触发。您可以在业务逻辑中自行实现手动触发新一轮会话,如通过 API 指令(比如按键),精确控制交互流程。
FarfieldConfig Object 可选 示例值:-
远场人声抑制配置。
通过抑制距离麦克风 3-5 米以外的背景人声,解决远场场景下的 AI 误触发、误识别及判停延迟等问题。该功能适用于耳机、手机等收音效果较好的设备。
注意
- 该功能仅在使用豆包语音的流式语音识别大模型时生效。
- 由于不同硬件设备的收音特性差异较大,必须根据实际设备类型和应用场景选择合适的 Level 或 Threshold。若参数设置不当(如抑制过强),可能会导致正常用户的声音也被抑制,影响收音质量。建议根据实际业务场景进行细致调试。
Enable Boolean 可选 示例值:true
是否开启远场人声抑制功能。
- true:开启。
- false(默认值):关闭。
FixedSource Boolean 可选 示例值:true
音源位置是否固定:
- true:若音源与麦克风位置相对固定(如使用耳机、听筒模式),请设为该值。
- false(默认值):若音源与麦克风位置不固定(如使用扬声器),请设为该值。
Level String 可选 示例值:Medium
噪声抑制强度,系统将根据环境底噪自动动态调整过滤门槛。可取值如下:
- High:强抑制,过滤效果最强,适用于极其嘈杂或远场人声干扰严重的场景。
- Medium(默认值):中抑制,在抑制干扰与保留微弱人声之间取得平衡。
- Low:弱抑制,过滤效果最弱,保留更多音频细节,适用于相对安静的环境。
若 Threshold > 0 ,本配置失效。
Threshold Integer 可选 示例值:0
自定义噪声抑制阈值。
- 取值范围:[0, 127],数值越小抑制越强,127 接近静音。
- 默认值: 0,表示不启用自定义噪声抑制,由 Level 抑制噪声。
若此值 > 0,则 Level 配置失效。不同硬件设备的阈值可能存在差异,建议优先使用 Level 参数。
InterruptThreshold Integer 可选 示例值:5
打断能量阈值。将 VAD 打断时所需的人声音量下限抬高指定的分贝(dB)值,减少因背景杂音导致的误打断。
与 Threshold / Level 互补。Threshold / Level 控制远场噪声抑制强度,InterruptThreshold 仅在打断路径生效。
- 取值范围:[0, 30),单位 dB。数值越大,越难被环境噪声误打断;数值越小,越容易被人声打断。
- 默认值:0。
ExpireTime Integer 可选 示例值:1000
强制判停时长。单位:ms。默认为空。
从 ASR 识别到最后一段文字起,若经过 ExpireTime 时长仍未触发静音判停(即 SilenceTime),则强制判定用户本轮说话已结束。适用于背景噪声大、环境干扰严重(导致 VAD/ASR 无法准确判断静音)时,进行兜底强制判停。
建议设置为 SilenceTime 的 1.5 倍。
LLMConfig 可选 示例值:-
大模型相关配置。不同的模型类型,LLMConfig 包含的配置不同:
火山方舟模型 Object
使用火山方舟模型时,LLMConfig 包含以下配置:
AutoActive Boolean 可选 示例值:true
是否启用 LLMConfig 配置。
- true(默认值):启用。
- false:禁用。禁用后,LLMConfig 和 TTSConfig 失效。通过 UpdateVoiceChat 接口发送文本给 TTS 仍然生效。
Mode String 必选示例值:ArkV3
大模型平台标识。使用火山方舟平台时,该参数固定取值:ArkV3。
支持通过以下两种方式接入方舟模型:
- 方式一:接入公共模型资源(通过传入 ModelName),产生的 LLM 费用独立计费,会折算为 Tokens 计费,可通过 Tokens 资源包抵扣。
- 方式二:接入自定义开通的方舟模型(通过传入 ModelName 和 APIKey),产生的 LLM 费用独立计费,不会折算为 Tokens,不可通过 Tokens 资源包抵扣,计费由火山方舟收取。
ModelName String 必选示例值:doubao-seed-2-0-lite-260428
- 若需使用公共方舟模型资源:支持的取值,参见支持的方舟模型。
- 若需使用自己在方舟平台开通的模型:填入模型的 Model ID 或接入点 ID。 此外,还需传入 APIKey。
SystemMessages String[] 可选 示例值:["你是小宁,性格幽默又善解人意。你在表达时需简明扼要,有自己的观点。"]
系统提示词。用于输入控制大模型行为方式的指令,定义了模型的角色、行为准则,特定的输出格式等。
UserPrompts Object[] 可选 示例值:-
用户提示词。可用于增强模型的回复质量,模型回复时会优先参考此处内容,引导模型生成特定的输出或执行特定的任务。
示例:会话前可注入的一组 user/assistant 对话(例如上几轮会话),可用于实现跨会话短期记忆。
注意
UserPrompts 设有自动逐出机制:当上下文轮数超过 HistoryLength 限制时,最早的 UserPrompts 会被自动逐出,为新的对话历史腾出空间。一组 user 和 assistant 计为一轮。
示例:若 HistoryLength 设置为 3 且已预存 了 2 轮 UserPrompts。在用户与 AI 完成第 1 轮真实对话后,上下文总轮数为 3,此时无需逐出;当用户发起第 2 轮对话时,总轮数变为 4 超过限制,系统会自动移除最早的一轮 UserPrompts,使上下文始终只保留最近的 3 轮记录。
Role String 可选 示例值:user
发送消息的角色。支持取值 system、user 和 assistant。其中 user 和 assistant 必须成对出现(一问一答),否则大模型可能会出现未定义行为。
Content String 可选 示例值:你是谁?
消息内容。
HistoryLength Integer 可选 示例值:3
对话上下文保留轮数。默认值为 3。
AI 在回复时会参考最近 N 轮的历史对话,以保证多轮对话的连贯性。
取值范围:需确保发送给大模型的总 Token 数不超过模型的上下文上限(如 8k)。即 SystemMessages + 当前生效的 UserPrompts + HistoryLength 轮对话 < 模型最大上下文长度。
例如:历史问题轮数为 3,LLM 上下文限制为 8k,UserPrompts 预先存储了两轮对话,用户输入了第一轮会话的问题,此时 SystemMessages + UserPrompts + 第一轮会话问题 总长度不超过 8k。
TopUserPrompts Object[] 可选 示例值:-
必须始终保留的用户提示词,用于向大模型注入需持续参考的上下文;支持设置文本与图片。
注意
TopUserPrompts 会占用 HistoryLength(历史对话轮数)。一组 user 和 assistant 计为一轮。例如 HistoryLength 为 10,配置 1 组 TopUserPrompts(一个 user 和一个 assistant)后,剩余可保留的普通历史对话为 9 轮。请根据实际需求合理控制注入的 TopUserPrompts。
Role String 必选示例值:user
消息角色。支持取值:user、assistant。
user 和 assistant 必须成对出现(一问一答),否则大模型可能会出现未定义行为。
Content String 必选示例值:第一张照片是李雷,喜欢踢足球;第二张照片是韩梅梅,喜欢学英语,爱吃雪糕。
文本上下文。用自然语言描述需要模型持续记住的信息。
注意
当该条消息同时携带 MultiModalContent 时,Content需与图片一一对应说明,避免图片与文案错配。
MultiModalContent Object[] 可选 示例值:-
多模态内容,用于添加图片信息。
注意
- 仅当 role 为 user 时生效,role=assistant 时不允许携带 MultiModalContent。
- 需确保 LLM 模型支持视觉理解能力,且已开启视觉理解(即 VisionConfig.Enable 为 true)。
- 此功能是基于 LLM 多模态能力的语义识别,而非传统的生物特征比对,不建议用于支付验证等高安全性场景。
示例:
Type String 必选示例值:image
多模态数据类型。当前仅支持取值 image。
ImageUrl String 必选示例值:https://example.com/image.jpg
图片 URL。需确保该 URL 可以在公网环境下直接访问。
注意
Temperature Float 可选 示例值:0.1
采样温度,用于控制生成文本的随机性和创造性,值越大随机性越高。
取值范围为 (0, 1],默认值为 0.1。
TopP Float 可选 示例值:0.95
核采样概率阈值。模型会考虑概率质量在 top_P内的 token 结果。
当取值为0时模型仅考虑对数概率最大的一个 token。0.1 意味着只考虑概率质量最高的前 10%的 token,取值越大生成的随机性越高,取值越低生成的确定性越高。
通常建议仅调整 Temperature 或 TopP 其中之一,不建议两者都修改。
取值范围为 [0, 1],默认值为 0.3。
注意
调用下列模型时字段取值固定为 0.95,手动指定的参数值将被忽略:
- doubao-seed-2-0-pro-260215
- doubao-seed-2-0-Lite-260215
- doubao-seed-1-8-251228
Tools Object[] 可选 示例值:-
注意
- 模型需支持 Function Calling。支持的方舟模型,请参见模型列表-工具调用。
- 请确保您已在业务代码中实现了具体的函数逻辑。Function Calling 的作用是让模型 “决策” 调用哪个函数并传入什么参数,而函数的执行则由您的代码负责。例如,想实现天气查询,您需要自己实现一个能查询并返回天气信息的函数。
type String 必选示例值:function
工具类型。目前固定取值 function,表示函数调用。
function Object 必选示例值:-
模型可以调用的函数列表。
name String 必选示例值:get_current_weather
函数的名称。
建议使用清晰、能体现函数作用的英文名。如 get_current_weather,而不是 tool_1 或 my_func。
description String 可选 示例值:获取指定城市的天气信息
函数用途的描述。
大模型会参考该字段来选择是否使用该函数。建议用一句话清晰概述参数的用途、格式要求,并提供示例。
parameters JSONMap 可选 示例值:-
函数的请求参数。大模型会参考该字段来提取函数的入参;如果函数不需要输入参数,则无需指定 parameters 参数。
- type:必须是 "object"。
- properties:列出支持的所有参数名及其类型。
- 参数名:须为英文字符串,且不能重复。
- type:需遵循 JSON 规范,支持类型包括 string、number、boolean、integer、object、array。
- description:对参数的清晰描述。引导模型正确提取值,建议包含用途和格式示例。
- required:指定函数中必填的参数名,未在此列出的参数则被视为可选。
示例:
EnableParallelToolCalls Boolean 可选 示例值:true
单次请求,是否允许模型的返回包含多个待调用的工具。
- true(默认值):允许返回多个待调用的工具。
- false:模型最多返回一个待调用的工具。
注意
该功能仅 doubao-seed-1.6系列模型支持。
EnableToolCallHistory Boolean 可选 示例值:false
是否在后续 LLM 请求的历史上下文中保留 Function Calling 过程中产生的工具调用指令和工具返回结果。
- false(默认值):不保留。
- true:保留。若某轮触发 Function Calling,该轮历史除用户提问和最终回复外,还会包含中间产生的工具调用指令和工具返回结果;若该轮未触发 Function Calling,则仍仅保留用户提问和最终回复。
注意
- 该参数仅在已配置 Tools 并实际触发 Function Calling 时生效。
- HistoryLength仍按对话轮次计数;工具调用指令和工具返回结果不会额外计为一轮,而是归属于触发它们的那一轮,并随该轮一起保留和逐出。
MCP Object[] 可选 示例值:-
注意
- 模型要求:
- 火山方舟模型需支持 Function calling。具体支持的模型,请参见 模型列表-工具调用。
- 不建议使用 doubao-seed-1.6-thinking,该模型会强制开启思考模式,且不可关闭,可能造成较高时延。
- MCP Server 返回必须必须支持流式 SSE 协议。
URL String 必选示例值:https://knowledge-mcp-server.com/test/123
远端 MCP Server 的访问地址。
ComfortWords String 可选 示例值:正在处理中...
当调用 MCP 工具时,向用户播放的安抚语内容。
InterestedTools String[] 可选 示例值:["search_knowledge"]
指定要添加到 LLM 上下文中的工具列表,以供 LLM 决策和调用。
- 若为空或不传:MCP Server 提供的所有工具都将被添加到 LLM 上下文中。
- 若指定了工具:则仅将指定的工具添加到 LLM 上下文中。
Name String 必选示例值:knowledge
自定义一个唯一的名称,用于标识该 MCP 服务。
该名称供 LLM 区分工具来源,且系统会根据该名称将工具调用请求路由至对应的 MCP Server。
注意
该名称不能与联网问答 Agent(WebSearchAgentConfig.FunctionName)和 Function Calling(Tools.function.name)里定义的工具重名。
VisionConfig Object 可选 示例值:-
注意
- 该功能仅在使用视觉理解模型时生效。
- 启用端到端语音模型时(S2SConfig)后,该配置不生效。
Enable Boolean 可选 示例值:true
是否开启视觉理解功能。
- false(默认值):不开启。
- true:开启。启用后,VisionConfig 下的其他配置才生效。
SnapshotConfig Object 可选 示例值:-
抽帧截图配置。系统会按照配置策略在后台自动抽帧截图送入大模型以供理解。
StreamType Integer 可选 示例值:0
截图流类型。
- 0:主流。指来自摄像头的实时视频画面。
- 1:屏幕共享流。指用户共享的设备屏幕内容(如桌面、应用窗口、PPT 等)。
默认值为 0。
ImageDetail String 可选 示例值:auto
图片处理模式。取值及含义如下:
- high:高细节模式。适用于需要理解图像细节信息的场景,如对图像的多个局部信息/特征提取、复杂/丰富细节的图像理解等场景,理解更全面。
- low:低细节模式。适用于简单的图像分类/识别、整体内容理解/描述等场景,理解更快速。
- auto:自动模式。根据图片分辨率,自动选择适合的模式。
默认值为 auto。
Height Integer 可选 示例值:640
送入大模型的截图视频帧高度,取值范围为 [0, 1792],单位为像素。该参数同时控制截图的分辨率模式:
- 当 Height > 14 时,系统将以此高度为基准,根据视频流的宽高比计算出固定宽度,后续所有截图都将缩放至此分辨率。
- 当 Height ≤ 14 时,截图分辨率将完全跟随 RTC 原始视频帧的实时分辨率。此模式适用于需要保留原始画面细节,或视频源分辨率可能在会话中动态变化的场景。
不填则默认为视频帧原始分辨率。
Interval Integer 可选 示例值:1000
相邻截图之间的间隔时间,取值范围为 [100, 5000],单位为毫秒。默认值为 1000。
注意
若 AutoSelect 设置为 true,则此参数失效,系统强制使用 166ms 的采样间隔。
ImagesLimit Integer 可选 示例值:2
单次送大模型截图数。取值范围为 [0, 50]。
不传或传 0 时自动修改为 2。
AutoSelect Boolean 可选 示例值:true
是否启用自动选帧。
启用后,系统会自动输入的视频中选取质量较高的帧送入 LLM,解决因移动抖动或失焦导致的识别不准问题。
- true:启用。
- false(默认值):关闭。
注意
启用后,截图间隔 Interval 固定为 166ms(每秒采样 6 张图片),用户自定义的 Interval会失效。
StorageConfig Object 可选 示例值:-
截图存储相关配置。
Type Integer 可选 示例值:0
存储位置。
- 0(默认值):按照 Base 64 编码存入服务端缓存,会话结束后自动删除。
- 1:存储至 TOS 平台。
TosConfig Object 可选 示例值:-
TOS 存储配置。
AccountId String 必选示例值:account_id
注意
- 此账号 ID 为火山引擎主账号 ID。
- 若你调用 OpenAPI 鉴权过程中使用的 AK、SK 为子用户 AK、SK,账号 ID 也必须为火山引擎主账号 ID,不能使用子用户账号 ID。
Region Integer 必选示例值:0
Bucket String 必选示例值:bucket
VisualContext Object 可选 示例值:-
短期视觉记忆和视觉观察任务配置。
PollIntervalMs Long 可选 示例值:1000
视频帧上传视觉记忆库的间隔。服务端按该间隔从上行视频流中抽取图像并写入视觉记忆库,用于后续的记忆召回和视觉观察任务。
最小取值为 1000,单位为 ms,默认值为 1000。
Memory Object 可选 示例值:-
视觉记忆配置。
开启后,服务端会在指定的时间窗口内保存视觉记忆,并注册内部工具 visual_memory_recall,供 LLM 在合适时机主动调用以回忆此前画面,用于回答“刚才出现过什么”“刚才把物品放在哪里”等与近期画面相关的问题。
注意
- 在 LLMConfig 中自行配置 Function Call 时,须避免与 visual_memory_recall 重名。
- 视觉记忆仅在当前任务内生效,不是跨任务长期记忆。
Enable Boolean 可选 示例值:true
是否启用视觉记忆。
- false(默认值):关闭。
- true:开启。开启后必须同时设置 Provider。
Provider String 可选 示例值:volc
视觉记忆提供方。
当 Memory.Enable 为 true 时必填。当前仅支持取值 volc(火山引擎视觉记忆服务)。
WindowSeconds Long 可选 示例值:60
单张图片在视觉记忆库中的 TTL(Time To Live)。超过该时长的图片会被服务端清理,不再参与召回。
单位为秒,默认值为 60,请按业务实际需要设置。
Recall Object 可选 示例值:-
视觉记忆召回配置。
TopK Integer 可选 示例值:3
单次召回最多返回的图片数量。服务端会按相关度从高到低返回,最多返回 TopK 张图片。
Watch Object 可选 示例值:-
视觉观察任务配置。开启后,服务端会按 CheckIntervalMs 对最新画面做匹配检查,并注册内部工具 visual_watch_task,允许 LLM 根据用户指令创建和管理观察任务。
注意
在 LLMConfig 中自行配置 Function Call 时,须避免与 visual_watch_task重名。
Enable Boolean 可选 示例值:true
是否启用视觉观察任务。
- false(默认值):关闭。
- true:开启。开启后可通过配置 StartupTasks 预设观察任务;也支持通过 AdvanceConfig 在对话中由用户语音指令自动创建观察任务(默认开启)。
CheckIntervalMs Long 可选 示例值:1000
观察任务的检查间隔,即服务端触发一次画面匹配检查的时间间隔。
单位为 ms,默认值为 1000,请按业务实际需要设置。
ImagesLimit Integer 可选 示例值:1
单次观察任务检查所使用的图片数量。服务端每次检查会取最近的 ImagesLimit 张图片送入模型进行匹配判断。
默认值为 1,请按业务实际需要设置。
NotifyMode String 可选 示例值:voice_and_callback
观察任务命中触发后的通知方式,决定 visual_task_status 事件是否外发以及是否语音播报。
- voice(默认值):仅语音提示。
- callback:仅发送回调事件。
- voice_and_callback:语音提示 + 发送回调事件。
注意
StartupTasks Object[] 可选 示例值:-
预创建观察任务列表。
数组中的每一项表示一个预置任务,服务端在会话建立后立即注册这些任务并开始检查。
TaskId String 必选示例值:find_phone_1
观察任务 ID。由你自定义,用于唯一标识一个观察任务。
Type Integer 必选示例值:1
任务类型。
- 1:单次目标型任务。画面满足条件后触发一次反馈,任务随即结束;若在超时时间内未命中,则任务超时结束。
- 2:持续型任务。画面满足条件后触发反馈,但任务不会因单次命中而结束,会持续观察直到超时或取消。
Description String 必选示例值:如果画面中出现我的手机,请提醒我它在哪里
任务描述。需清晰描述需要观察的画面条件、命中后的反馈方式或反馈内容。
TimeoutSeconds Long 可选 示例值:60
该预设任务的超时时间。任务超过该时长未命中则自动结束。
- 单位为秒,取值需不小于 0。
- 默认值:未设置时,根据任务类型不同默认值不同
- 单次目标型任务:默认值为 AdvanceConfig.GoalTaskTimeoutSeconds
- 持续型任务:默认值为 AdvanceConfig.ContinuousTaskTimeoutSeconds
AdvanceConfig Object 可选 示例值:-
视觉观察任务的高级配置,包含语音触发策略、超时时间、送图模式、匹配后回复风格、播报抑制等能力。
DisableGoalTaskTrigger Boolean 可选 示例值:false
是否禁止语音创建目标型任务。
- false(默认值):开启语音创建目标型任务。
- true:关闭。
DisableContinuousTaskTrigger Boolean 可选 示例值:false
是否禁止语音创建持续型任务。
- false(默认值):开启语音创建持续型任务。
- true:关闭。
GoalTaskTimeoutSeconds Integer 可选 示例值:120
通过语音指令创建的目标型任务的默认超时时间。单位为秒,默认值为 120。
ContinuousTaskTimeoutSeconds Integer 可选 示例值:300
通过语音指令创建的持续型任务的默认超时时间。单位为秒,默认值为 300。
DetectSystemMessages String[] 可选 示例值:-
观察任务命中后 LLM 的回复风格和人设的系统提示词。若不填,默认复用 LLMConfig.SystemMessages。
TaskInterruptMode Integer 可选 示例值:2
观察任务命中后的打断优先级。
- 1:高优先级,命中后立即打断当前对话进行播报。
- 2(默认值):中优先级,不打断当前对话,加入等待队列,在合适时机播报。
DetectSuppression Object 可选 示例值:-
抑制播报配置,用于在同一持续型任务频繁命中、或短时间内出现相似播报文本时降低重复反馈,降低成本并提升体验。
注意
该功能仅作用于持续型任务(包括预设或通过语音指令创建的持续型任务)。
EnableHistory Boolean 可选 示例值:true
是否开启检测历史记录能力,开启后将根据历史检测结果抑制重复播报。
默认值为 false(不开启)。
MatchSkipCount Integer 可选 示例值:3
持续型任务命中后,跳过的后续检测轮数。用于降低持续命中场景下的重复反馈和检测成本。
默认值为 0,表示不跳过。
TextHistory Object 可选 示例值:-
文本历史相关配置,用于基于历史播报文本进行相似度抑制。
DetectHistoryLimit Integer 可选 示例值:5
播报历史记录数量上限。当历史数量超过该值时,会用新历史替换最旧的记录。
默认值为 5。
SimilarityThreshold Integer 可选 示例值:60
基于文本相似度的播报抑制阈值。当新播报文本与历史记录的相似度超过该阈值时,将被抑制。
取值范围为 [0, 100] 的整数,默认值为 0,即不开启该功能。
Prefill Boolean 可选 示例值:false
是否将 ASR 中间结果提前送入 LLM 进行文本推理, 以降低延时。
- true:开启。
- false(默认值):关闭。等待 ASR 判断用户发言结束后,才将用户完整发言文本提交给 LLM 进行推理。
注意
- 开启后会产生额外模型消耗。
- LLM 生成的文本,其是否实时送入 TTS 由 TTSConfig.Prefill参数控制,默认送入。
ServiceTier String 可选 示例值:auto
控制模型的在线推理方式(不可与视觉理解能力同时使用):
- fast:速度优先。本次请求优先使用在线推理(低延迟)模式,可提供更优的输出 token 生成速率(TPOT),降低延迟。
- 若模型有低延迟限流配额,则本次请求优先使用在线推理(低延迟)模式;否则会自动降级为 default 模式。
- 使用该模式会增加成本消耗。
- 如果要获取低延迟推理额度,请提交工单申请。
- auto(默认值):并发保障优先。本次请求优先使用 在线推理(TPM保障包),保障模型请求吞吐量达到指定TPM。
- 若模型有 TPM 保障包额度,则本次请求优先使用在线推理(TPM保障包)额度。若无 TPM 保障包额度或用超额度则降级至 default 模式。
- 如需获取在线推理(TPM保障包)额度,请提交工单申请。
- default:通用优先。请求只使用 在线推理(常规)模式,使用公共资源池资源,即使有TPM保障包额度 / 低延迟限流额度也不会调用。适用于对延迟和并发要求相对较低的场景。
ThinkingType String 可选 示例值:disabled
关闭或开启大模型的深度思考能力。若你使用的是具备深度思考能力的模型,强烈建议通过该字段关闭模型的深度思考能力(disabled),以避免 AI 回复耗时过长,影响对话的流畅性。
可取值及含义如下:
- disabled(推荐):关闭深度思考能力。
- enabled:开启深度思考能力。开启后,会增加推理时延迟,且思考内容会丢失,也不会被输出。
- auto:模型自行判断是否需要开启深度思考能力(比如根据对话复杂度判断)。
- null(默认值):采用模型自身的默认行为。null 是一个关键字,在构建 JSON 请求传入时无需引号。示例:{"ThinkingType": null}。
注意
第三方大模型/Agent Object 示例值:-
使用第三方大模型/Agent 时,LLMConfig 包含以下配置:
AutoActive Boolean 可选 示例值:true
是否启用 LLMConfig 配置。
- true(默认值):启用。
- false:禁用。禁用后,LLMConfig 和 TTSConfig 失效。通过 UpdateVoiceChat 接口发送文本给 TTS 仍然生效。
Mode String 必选示例值:CustomLLM
大模型平台名称。使用第三方大模型/Agent 时,该参数固定取值:CustomLLM。
Url String 必选示例值:https://test.com/path/to/app
系统请求该 URL 的超时时间为 10 秒,请确保您的服务能在此时间内响应。
- 快速验证 URL 是否符合标准:
- 前往 实时对话式 AI 体验馆 ,开始通话。
- 点击右侧的 修改 AI 人设,然后切换至第三方模型,并填入 URL 进行快速验证。
- 若验证失败可前往文档接入第三方大模型/Agent,查看接口标准并通过验证工具查看详细报错。
- 拼接参数:如果需要在每次请求时传递一些简单的、非敏感的参数(如 session_id),可以直接将它们作为查询参数拼接到此 URL 中。
- 如需使用 HTTP 域名进行测试:可在下方 Feature 参数中填入 {"Http":true},但无法保证服务质量。
ModelName String 可选 示例值:name1
第三方大模型/Agent 的名称。
APIKey String 可选 示例值:pat*****123231
Bearer Token 认证方式的大模型鉴权 Token。
SystemMessages String[] 可选 示例值:["你是小宁,性格幽默又善解人意。你在表达时需简明扼要,有自己的观点。"]
系统提示词。用于输入控制大模型行为方式的指令,定义了模型的角色、行为准则,特定的输出格式等。
UserPrompts Object[] 可选 示例值:-
用户提示词。可用于增强模型的回复质量,模型回复时会优先参考此处内容,引导模型生成特定的输出或执行特定的任务。
注意
UserPrompts 设有自动逐出机制:当对话总数超过 HistoryLength 限制时,最早的 UserPrompts 会被自动逐出,为新的对话历史腾出空间。
示例:若 HistoryLength设置为 3 且已预存 2 轮对话。在用户与 AI 完成第 1 轮真实对话后,上下文总轮数为 3(2 预存 + 1 用户),此时无需逐出;当用户发起第 2 轮对话时,总轮数变为 4 超过限制,系统会自动移除最早的一轮预存内容,使上下文始终只保留最近的 3 轮记录。
Role String 可选 示例值:user
发送消息的角色。支持取值 system、user 和 assistant。其中 user 和 assistant 必须成对出现(一问一答),否则大模型可能会出现未定义行为。
Content String 可选 示例值:你是谁?
消息内容。
HistoryLength Integer 可选 示例值:3
对话上下文保留轮数。默认值为 3。AI 在回复时会参考最近 N 轮的历史对话,以保证多轮对话的连贯性。
注意
需确保发送给大模型的总 Token 数不超过模型的上下文上限(如 8k)。即 SystemMessages + 当前生效的 UserPrompts + HistoryLength 轮对话 < 模型最大上下文长度。
例如:历史问题轮数为 3,LLM 上下文限制为 8k,UserPrompts 预先存储了两轮对话,用户输入了第一轮会话的问题,此时 SystemMessages + UserPrompts + 第一轮会话问题总长度不超过 8k。
MaxTokens Integer 可选 示例值:1024
输出文本的最大 token 限制。默认值为 1024。
Temperature Float 可选 示例值:0.1
采样温度,用于控制生成文本的随机性和创造性,值越大随机性越高。取值范围为 (0, 1],默认值为 0.1。
TopP Float 可选 示例值:0.3
采样的选择范围,控制输出 token 的多样性。模型将从概率分布中累计概率超过该取值的标记中进行采样,以确保采样的选择范围不会过宽,值越大输出的 token 类型越丰富。
取值范围为 [0, 1],默认值为 0.3。
Tools Object[] 可选 示例值:-
注意
- 请确保您的第三方模型支持 Function Calling 功能。
- 请确保您已在业务代码中实现了具体的函数逻辑。Function Calling 的作用是让模型 “决策” 调用哪个函数并传入什么参数,而函数的执行则由您的代码负责。例如,想实现天气查询,您需要自己实现一个能查询并返回天气信息的函数。
type String 必选示例值:function
工具类型。目前固定取值 function,表示函数调用。
function Object 必选示例值:-
模型可以调用的函数列表。
name String 必选示例值:get_current_weather
函数的名称。
建议使用清晰、能体现函数作用的英文名。如 get_current_weather,而不是 tool_1 或 my_func。
description String 可选 示例值:获取指定城市的天气信息
函数用途的描述。
大模型会参考该字段来选择是否使用该函数。建议用一句话清晰概述参数的用途、格式要求,并提供示例。
parameters JSONMap 可选 示例值:-
函数的请求参数。大模型会参考该字段来提取函数的入参;如果函数不需要输入参数,则无需指定 parameters 参数。
- type:必须是 "object"。
- properties:列出支持的所有参数名及其类型。
- 参数名:须为英文字符串,且不能重复。
- type:需遵循 JSON 规范,支持类型包括 string、number、boolean、integer、object、array。
- description:对参数的清晰描述。引导模型正确提取值,建议包含用途和格式示例。
- required:指定函数中必填的参数名,未在此列出的参数则被视为可选。
示例:
EnableParallelToolCalls Boolean 可选 示例值:true
单次请求,是否允许模型的返回包含多个待调用的工具。
- true(默认值):允许返回多个待调用的工具。
- false:模型最多返回一个待调用的工具。
EnableToolCallHistory Boolean 可选 示例值:false
是否在后续 LLM 请求的历史上下文中保留 Function Calling 过程中产生的工具调用指令和工具返回结果。
- false(默认值):不保留。
- true:保留。若某轮触发 Function Calling,该轮历史除用户提问和最终回复外,还会包含中间产生的工具调用指令和工具返回结果;若该轮未触发 Function Calling,则仍仅保留用户提问和最终回复。
注意
- 该参数仅在已配置 Tools 并实际触发 Function Calling 时生效。
- HistoryLength仍按对话轮次计数;工具调用指令和工具返回结果不会额外计为一轮,而是归属于触发它们的那一轮,并随该轮一起保留和逐出。
MCP Object[] 可选 示例值:-
注意
MCP Server 返回必须支持流式 SSE 协议。
URL String 必选示例值:https://knowledge-mcp-server.com/test/123
远端 MCP Server 的访问地址。
ComfortWords String 可选 示例值:正在处理中...
当调用 MCP 工具时,向用户播放的安抚语内容。默认为空。
InterestedTools String[] 可选 示例值:["search_knowledge"]
指定要添加到 LLM 上下文中的工具列表,以供 LLM 决策和调用。
- 若为空或不传:MCP Server 提供的所有工具都将被添加到 LLM 上下文中。
- 若指定了工具:则仅将指定的工具添加到 LLM 上下文中。
Name String 必选示例值:knowledge
自定义一个唯一的名称,用于标识该 MCP 服务。
该名称供 LLM 区分工具来源,且系统会根据该名称将工具调用请求路由至对应的 MCP Server。
注意
该名称不能与联网问答 Agent(WebSearchAgentConfig.FunctionName)和 Function Calling(Tools.function.name)里定义的工具重名。
Feature String 可选 示例值:{\"Http\":true}
使用 HTTP 域名进行测试,该参数固定取值:{\"Http\":true}。
Prefill Boolean 可选 示例值:false
将 ASR 中间结果提前送入大模型进行处理:
- true:开启。将 ASR 识别中间结果提前送入大模型进行处理,以降低延时。
- false:关闭。需等待 ASR 模块识别出完整的一句话后,再将其整体送入大模型处理。
默认值为 false。
注意
开启后会产生额外模型消耗。
ServiceTier String 可选 示例值:auto
控制模型的在线推理方式:
注意
- 请确保模型支持该能力。系统会将该值以 service_tier 字段透传到您配置的第三方大模型请求 body 中,由第三方服务自行识别并路由。
- 该功能不可与视觉理解能力同时使用。
- 不同的方式决定了算力资源的分配、并发保障以及模型响应速度。详细说明,可参考方舟模型的推理方式概述。
- fast:速度优先。以方舟模型为例,即若模型有低延迟限流配额,则本次请求优先使用在线推理(低延迟)模式,提供更优的输出 token 生成速率(TPOT),降低延迟;否则会自动降级为 default 模式。
- auto(默认值):并发保障优先。以方舟模型为例,若模型有 TPM 保障包额度,则本次请求优先使用在线推理(TPM保障包)额度,保障模型请求吞吐量达到指定TPM。若无 TPM 保障包额度或用超额度则降级至 default 模式。
- default:通用模式。以方舟模型为例,本次请求只使用 在线推理(常规)模式,即使有TPM保障包额度 / 低延迟限流额度也不会调用。
VisionConfig Object 可选 示例值:-
Enable Boolean 可选 示例值:true
是否开启视觉理解功能。
- false:不开启。
- true:开启。
默认值为 false。
SnapshotConfig Object 可选 示例值:-
抽帧截图配置。系统会按照配置策略在后台自动抽帧截图送入大模型以供理解。
StreamType Integer 可选 示例值:0
截图流类型。
- 0:主流。指来自摄像头的实时视频画面。
- 1:屏幕共享流。指用户共享的设备屏幕内容(如桌面、应用窗口、PPT 等)。
默认值为 0。
ImageDetail String 可选 示例值:auto
图片处理模式。取值及含义如下:
- high:高细节模式。适用于需要理解图像细节信息的场景,如对图像的多个局部信息/特征提取、复杂/丰富细节的图像理解等场景,理解更全面。
- low:低细节模式。适用于简单的图像分类/识别、整体内容理解/描述等场景,理解更快速。
- auto:自动模式。根据图片分辨率,自动选择适合的模式。
默认值为 auto。
Height Integer 可选 示例值:640
送入大模型的截图视频帧高度,取值范围为 [0, 1792],单位为像素。该参数同时控制截图的分辨率模式:
- 当 Height > 14 时,系统将以此高度为基准,根据视频流的宽高比计算出固定宽度,后续所有截图都将缩放至此分辨率。
- 当 Height ≤ 14 时,截图分辨率将完全跟随 RTC 原始视频帧的实时分辨率。此模式适用于需要保留原始画面细节,或视频源分辨率可能在会话中动态变化的场景。
不填则默认为视频帧原始分辨率。
Interval Integer 可选 示例值:1000
相邻截图之间的间隔时间,取值范围为 [100, 5000],单位为毫秒。默认值为 1000。
注意
若 AutoSelect 设置为 true,则此参数失效,系统强制使用 166ms 的采样间隔。
ImagesLimit Integer 可选 示例值:2
单次送大模型截图数。取值范围为 [0, 50]。
不传或传 0 时自动修改为 2。
AutoSelect Boolean 可选 示例值:true
是否启用自动选帧。
启用后,系统会自动输入的视频中选取质量较高的帧送入 LLM,解决因移动抖动或失焦导致的识别不准问题。
- true:启用。
- false(默认值):关闭。
注意
启用后,截图间隔 Interval 固定为 166ms(每秒采样 6 张图片),用户自定义的 Interval会失效。
StorageConfig Object 可选 示例值:-
截图存储相关配置。
TosConfig Object 可选 示例值:-
TOS 存储配置。
AccountId String 必选示例值:account_id
火山引擎平台账号 ID,例如:200000000。
- 火山引擎平台账号 ID 查看路径参看查看和管理账号信息。
- 此账号 ID 为火山引擎主账号 ID。
- 若你调用 OpenAPI 鉴权过程中使用的 AK、SK 为子用户 AK、SK,账号 ID 也必须为火山引擎主账号 ID,不能使用子用户账号 ID。
Region Integer 必选示例值:0
Bucket String 必选示例值:bucket
EnableRoundId Boolean 可选 示例值:false
请求第三方模型/Agent 接口时,是否在请求体中携带字段 round_id(对话轮次 ID):
- false(默认值):不携带。
- true:携带。系统会在发送给你自研接口的 Request Body 中,自动添加一个 round_id 字段。你可以解析该字段,用于日志追踪、问题排查和数据审计等。
round_id 是系统为每一轮“用户-AI”的交互生成的唯一标识。
Custom String 可选 示例值:-
自定义 JSON 字符串,可传入业务自定义参数。默认为空。
Coze智能体 Object 示例值:-
使用 Coze 智能体时,LLMConfig 包含以下配置:
AutoActive Boolean 可选 示例值:true
是否启用 LLMConfig 配置。
- true(默认值):启用。
- false:禁用。禁用后,LLMConfig 和 TTSConfig 失效。通过 UpdateVoiceChat 接口发送文本给 TTS 仍然生效。
Mode String 必选示例值:CozeBot
大模型平台名称。该参数固定取值:CozeBot。
TTSConfig Object 可选 示例值:-
语音合成(TTS)相关配置。
注意
启用端到端语音模型(S2SConfig)后,该配置会失效。
AutoActive Boolean 可选 示例值:true
是否启用 TTSConfig 配置。
- true(默认值):启用。
- false:禁用。禁用后,TTSConfig 配置会失效,同时 SubtitleMode: 0(对齐时间戳字幕)和SubtitleMode: 1(快速字幕)也不可用。不影响 ASRConfig 和 LLMConfig。
Provider String 必选示例值:volcano_bidirection
语音合成服务提供商,使用不同语音合成服务时,取值不同。支持使用的语音合成服务及对应取值如下:
- volcano_bidirection:豆包语音 TTS 模型(流式输入流式输出),支持如下模型:
- (豆包语音)语音合成大模型(流式输入流式输出)
- (豆包语音)声音复刻大模型(流式输入流式输出)
- minimax_bidirection:MiniMax 语音合成 WebSocket(双向流式)
- minimax:MiniMax 语音合成 HTTP
- ai_gateway:自定义语音合成(通过火山边缘大模型网关接入的)
ProviderParams 必选示例值:-
配置所选的语音合成服务。不同服务下,该结构包含字段不同:
- (豆包语音)语音合成大模型(流式输入流式输出)
- (豆包语音)声音复刻大模型(流式输入流式输出)
(豆包语音)语音合成大模型(流式输入流式输出_参数透传) Object
此方式支持语音合成大模型服务(流式输入流式输出)的所有配置参数, 相较于直传配置更灵活、功能更全面。
Credential Object 可选 示例值:-
模型凭证配置。
ResourceId String 可选 示例值:volc.service_type.10029
指定要使用的语音合成大模型的版本:
- seed-tts-1.0 或 volc.service_type.10029(默认值):语音合成大模型(即语音合成1.0)。
- seed-tts-2.0:豆包语音合成模型2.0(即语音合成2.0)。
AppId String 可选 示例值:94****11
注意
- 仅在需要使用自定义开通的豆包语音 TTS 服务时必填且生效。
- 使用自定义开通的语音合成大模型服务时,产生的 TTS 费用独立计费,不会折算为 Tokens,不可通过 Tokens 资源包抵扣,计费由豆包语音收取。具体计费规则,请参见 豆包语音_计费说明。
- 若不填写 AppId 和 Token,则使用的是公共 TTS 资源。公共资源默认支持 50 并发。如需超过 50 并发,请提交工单申请扩容。
Token String 可选 示例值:OaO****ws1
注意
仅在需要使用自定义开通的豆包语音 TTS 服务时必填且生效。
VolcanoTTSParameters String 必选示例值:"{\"req_params\":{\"speaker\":\"zh_female_linjianvhai_moon_bigtts\"}}"
- 必填参数:必须包含参数 req_params.speaker(音色)。音色需与在 Credential.ResourceId 指定的模型版本匹配 ,即使用语音合成大模型 1.0 服务仅支持 1.0 支持的音色;使用语音合成大模型 2.0 服务只能使用 2.0 支持的音色。详情可参见音色列表。
- 不可传入的参数:不可以包含以下由平台管理的参数:
- user
- event
- namespace
- req_params.text
- req_params.audio_params.format
- req_params.audio_params.enable_timestamp
- req_params.additions.max_length_to_filter_parenthesis
- req_params.additions.cache_config、req_params.additions.enable_latex_tn:仅当使用语音合成大模型 2.0(ResourceId 为 seed-tts-2.0)时,若启用了对齐时间戳的字幕(SubtitleMode: 0),不可传入。
- 其他参数:根据业务需求按需选择(例如 req_params.audio_params.speech_rate)。
示例:以设置指定的音色(必填)并调整语速(可选)为例
- 先构建如下 JSON:
-
- 然后将其转换为 JSON 字符串再传入:"{\"req_params\":{\"speaker\":\"zh_female_linjianvhai_moon_bigtts\",\"audio_params\":{\"speech_rate\":100}}}"
(豆包语音)语音合成大模型(流式输入流式输出_参数直传) Object
此方式封装了语音合成大模型(流式输入流式输出)的部分配置参数,接入简单,但无法使用该服务的全部功能。
ResourceId String 可选 示例值:volc.service_type.10029
指定要使用的语音合成大模型的版本:
- seed-tts-1.0 或 volc.service_type.10029(默认值):语音合成大模型(即语音合成1.0)。
- seed-tts-2.0:豆包语音合成模型2.0(即语音合成2.0)。
audio Object 必选示例值:-
语音合成大模型服务音频配置。
voice_type String 必选示例值:zh_female_linjianvhai_moon_bigtts
音色。填入音色对应的标识 voice_type,需与在 ResourceId 中指定的模型版本匹配:
- 使用语音合成大模型(即语音合成 1.0) 仅支持 1.0 支持的音色。
- 使用豆包语音合成模型2.0(即语音合成2.0)仅支持 2.0 支持的音色。
speech_rate Integer 可选 示例值:0
语速。取值范围 [-50, 100],取值越大,语速越快。
- 100:2.0 倍速。
- -50:0.5 倍速。
- 0(默认值):原语速。
app Object 可选 示例值:-
豆包语音的语音合成大模型服务应用配置。
注意
- 仅在需要使用自定义开通的豆包语音 TTS 服务时必填且生效。
- 使用自定义开通的语音合成大模型服务时,产生的 TTS 费用独立计费,不会折算为 Tokens,不可通过 Tokens 资源包抵扣,计费由豆包语音收取。具体计费规则,请参见 豆包语音_计费说明。
- 若不填写,则使用的是公共 TTS 资源。公共资源默认支持 50 并发。如需超过 50 并发,请提交工单申请扩容。
appid String 必选示例值:94****11
token String 必选示例值:OaO****ws1
additions Object 可选 示例值:-
豆包语音的语音合成大模型服务高级配置。
enable_latex_tn Boolean 可选 示例值:true
播报 LaTeX 公式。启用后,AI 能够以自然语言朗读文本中的 LaTeX 格式的数学公式。
- false(默认值):不播报。
- true:播报。 为 true 时,disable_markdown_filter 也需为 true 才生效。
效果示例:
- LLM 返回:根据公式 a^2 + b^2 = c^2 可知...
- AI 播报:根据公式 a 的平方加上 b 的平方等于 c 的平方 可知...
- 字幕显示:根据公式 a^2 + b^2 = c^2 可知...
注意
使用语音合成大模型 2.0 时,该功能与对齐时间戳的字幕功能(SubtitleMode: 0)不可同时开启。
disable_markdown_filter Boolean 可选 示例值:true
过滤 Markdown 格式。启用后,语音合成时会自动过滤 LLM 返回文本中的 Markdown 格式符号(如加粗、标题等),确保语音播报的连贯性。
- false(默认值):不过滤。
- true:过滤。
效果示例:
- LLM 返回:请执行 **grep** 命令查看日志。
- AI 播报:请执行 grep 命令查看日志。
- 字幕显示:请执行 **grep** 命令查看日志。
(豆包语音)声音复刻大模型(流式输入流式输出_参数透传) Object
此方式支持声音复刻大模型(流式输入流式输出)所有配置参数,相较于直传配置更灵活、功能更全面。
VolcanoTTSParameters String 必选示例值:"{\"req_params\":{\"speaker\":\"S_N****T7k1\",\"audio_params\":{\"speech_rate\":0}}}"
- 必填参数:必须包含参数 req_params.speaker。即经过训练后的复刻声音 ID。根据使用的模型来源不同,获取方式不同。具体请参见复刻声音。
- 不可传入的参数:不可以包含以下由平台管理的参数:
- user
- event
- namespace
- req_params.text
- req_params.audio_params.format
- req_params.audio_params.enable_timestamp
- req_params.additions.max_length_to_filter_parenthesis
- req_params.additions.cache_config、req_params.additions.enable_latex_tn:仅当使用声音复刻大模型 2.0(ResourceId 为 seed-icl-2.0)时,若启用了对齐时间戳的字幕(SubtitleMode: 0),不可传入。
- 其他参数:根据业务需求按需选择(例如 req_params.audio_params.speech_rate)。
示例:以设置指定的音色(必填)并调整语速(可选)为例
- 先构建 JSON 对象:
-
- 将其转换为 JSON 字符串再传入:
- "{\"req_params\":{\"speaker\":\"S_The****K1\",\"audio_params\":{\"speech_rate\":100}}}"
Credential Object 必选示例值:-
指定要使用的声音复刻大模型服务版本或鉴权信息。
ResourceId String 必选示例值:seed-icl-2.0
声音复刻大模型服务版本,需要与您在 voice_type 中指定的音色版本一致:
- seed-icl-1.0 :声音复刻大模型(即声音复刻1.0)。
- seed-icl-2.0:声音复刻大模型 2.0(即声音复刻1.0)。
AppId String 可选 示例值:94****11
注意
- 仅在需要使用自定义开通的豆包语音声音复刻大模型服务时必填且生效。
- 使用自定义开通的声音复刻大模型服务时,产生的 TTS 费用独立计费,不会折算为 Tokens,不可通过 Tokens 资源包抵扣,计费由豆包语音收取。具体计费规则,请参见 豆包语音_计费说明。
- 若不填写 AppId 和 Token,则使用的是公共 TTS 资源。公共资源默认支持 50 并发。如需超过 50 并发,请提交工单申请扩容。
Token String 可选 示例值:OaO****ws1
注意
仅在需要使用自定义开通的声音复刻大模型服务时必填且生效。
(豆包语音)声音复刻大模型(流式输入流式输出_参数直传) Object
此方式封装了声音复刻大模型(流式输入流式输出)部分通用参数,接入简单,但无法使用该服务的全部功能。
audio Object 必选示例值:-
豆包语音的声音复刻大模型服务音频配置。
speech_rate Integer 可选 示例值:0
语速。取值范围 [-50, 100],取值越大,语速越快。
- 100:2.0 倍速。
- -50:0.5 倍速。
- 0(默认值):原语速。
ResourceId String 必选示例值:seed-icl-2.0
指定要使用的声音复刻大模型服务版本。需要与您在 voice_type 中指定的音色版本一致:
- seed-icl-1.0 :声音复刻大模型(即声音复刻1.0)。
- seed-icl-2.0:豆包声音复刻模型2.0(即声音复刻2.0)。
app Object 可选 示例值:-
豆包语音的声音复刻大模型服务应用配置。
注意
- 仅在需要使用自定义开通的声音复刻大模型服务时必填且生效。
- 使用自定义开通的声音复刻大模型服务时,产生的 TTS 费用独立计费,不会折算为 Tokens,不可通过 Tokens 资源包抵扣,计费由豆包语音收取。具体计费规则,请参见 豆包语音_计费说明。
- 若不填写,则使用的是公共 TTS 资源。公共资源默认支持 50 并发。如需超过 50 并发,请提交工单申请扩容。
appid String 必选示例值:94****11
token String 必选示例值:OaO****ws1
additions Object 可选 示例值:-
声音复刻大模型服务高级配置。
enable_latex_tn Boolean 可选 示例值:true
播报 LaTeX 公式。启用后,AI 能够以自然语言朗读文本中的 LaTeX 格式的数学公式。
- false(默认值):不播报。
- true:播报。 为 true 时,disable_markdown_filter 也需为 true 才生效。
效果示例:
- LLM 返回:根据公式 a^2 + b^2 = c^2 可知...
- AI 播报:根据公式 a 的平方加上 b 的平方等于 c 的平方 可知...
- 字幕显示:根据公式 a^2 + b^2 = c^2 可知...
注意
使用声音复刻大模型 2.0 时,该功能与对齐时间戳的字幕功能(SubtitleMode: 0)不可同时开启。
disable_markdown_filter Boolean 可选 示例值:true
过滤 Markdown 格式。启用后,语音合成时会自动过滤 LLM 返回文本中的 Markdown 格式符号(如加粗、标题等),确保语音播报的连贯性。
- false(默认值):不过滤。
- true:过滤。
效果示例:
- LLM 返回:请执行 **grep** 命令查看日志。
- AI 播报:请执行 grep 命令查看日志。
- 字幕显示:请执行 **grep** 命令查看日志。
MiniMax 语音合成 WebSocket(双向流式) Object 示例值:-
APIKey String 必选示例值:eyJhbG****SUzI1N
Model String 必选示例值:speech-2.8-turbo
VoiceID String 必选示例值:female-tianmei
URL String 可选 示例值:wss://api.minimax.cn/ws/v1/t2a_v2_bidi
请求语音合成 URL,默认且固定取值:wss://api.minimax.cn/ws/v1/t2a_v2_bidi。
Speed Float 可选 示例值:1.0
合成音频的语速,取值越大,语速越快。取值范围 [0.5, 2],默认值为1.0。
Language String 可选 示例值:auto
MiniMax 语音合成 HTTP Object 示例值:-
使用 MiniMax 语音合成 HTTP 时,TTSConfig.ProviderParams 包含以下字段:
Authorization String 必选示例值:eyJhbG****SUzI1N
Groupid String 必选示例值:983*****669
model String 必选示例值:speech-01-turbo
发起请求的模型版本:
- speech-01-turbo:最新模型,拥有出色的效果与时延表现。
- speech-01-240228:稳定版本模型,效果出色。
- speech-01-turbo-240228:稳定版本模型,时延更低。
URL String 必选示例值:https://api.minimax.chat/v1/t2a_v2
请求语音合成 URL,该参数固定取值:https://api.minimax.chat/v1/t2a_v2。
voice_setting Object 可选 示例值:-
音频配置。
speed Float 可选 示例值:1.0
语速。取值越大,语速越快。
取值范围为 [0.5, 2],默认值为 1.0。
vol Float 可选 示例值:1.0
音量。取值越大,音量越大。
取值范围为 (0, 10],默认值为 1.0。
pitch Float 可选 示例值:0
语调。取值越大,语调越高。
取值范围为 [-12, 12],且必须为整数。
默认值为 0,表示原音色输出。
voice_id String 可选 示例值:male-qn-jingying
系统音色编号/复刻音色编号。
- 系统音色可前往 voice_setting.voice_id 查询。
- 克隆音色参看 FAQ。
注意
voice_id 与 timber_weights必须设置其中一个。
pronunciation_dict Object 可选 示例值:-
特殊标注配置。可对特殊文字、符号指定发音。
tone String[] 可选 示例值:["燕少飞/(yan4)(shao3)(fei1)","达菲/(da2)(fei1)","omg/oh my god"]
用于替换需要特殊标注的文字、符号及对应的发音,可用于调整声调或指定其他字符的发音。格式为 "原文字/注音",注音部分根据语言类型采用不同方式标注:
- 英文注音:使用对应发音的英文单词,例如:"omg/oh my god"。
- 中文注音:使用拼音,并在每个音节后以括号标注声调,音调用数字表示:
- 一声(阴平):1
- 二声(阳平):2
- 三声(上声):3
- 四声(去声):4
- 轻声:5
- 例如,"燕少飞/(yan4)(shao3)(fei1)"、"达菲/(da2)(fei1)"。
默认为空。
timber_weights Object[] 可选 示例值:-
合成音色权重设置。可通过该参数设置多种音色混合,并调整每个具体音色权重。最多支持 4 种音色混合。
注意
timber_weights 与 VoiceSetting.voice_id必须设置其中一个。
voice_id String 可选 示例值:male-qn-jingying
weight Integer 可选 示例值:1
权重。取值为整数,单一音色取值占比越高,合成音色越像。取值范围为 [1, 100]。
stream Boolean 可选 示例值:false
是否开启流式输出
- false:不开启流式输出。
- true:开启流式输出。
默认值为 false。
language_boost String 可选 示例值:auto
增强指定小语种/方言场景下的语音表现。不同场景下取值及含义如下:
- 不明确小语种类型:auto。取值为 auto 时,模型将自主判断小语种类型。
- 小语种:
- Spanish:西班牙语
- French:法语
- Portuguese:葡萄牙语
- Korean:韩语
- Indonesian:印度尼西亚语
- German:德语
- Japanese:日语
- Italian:意大利语
- auto:自动模式
- 方言:
- Chinese,Yue:粤语。Chinese,Yue 仅当 MiniMaxTTSConfig.model=speech-01-turbo 时生效。
默认值为空。
自定义语音合成 Object
URL String 必选示例值:wss://ai-gateway.vei.volces.com/v1/realtime?model=ttsname
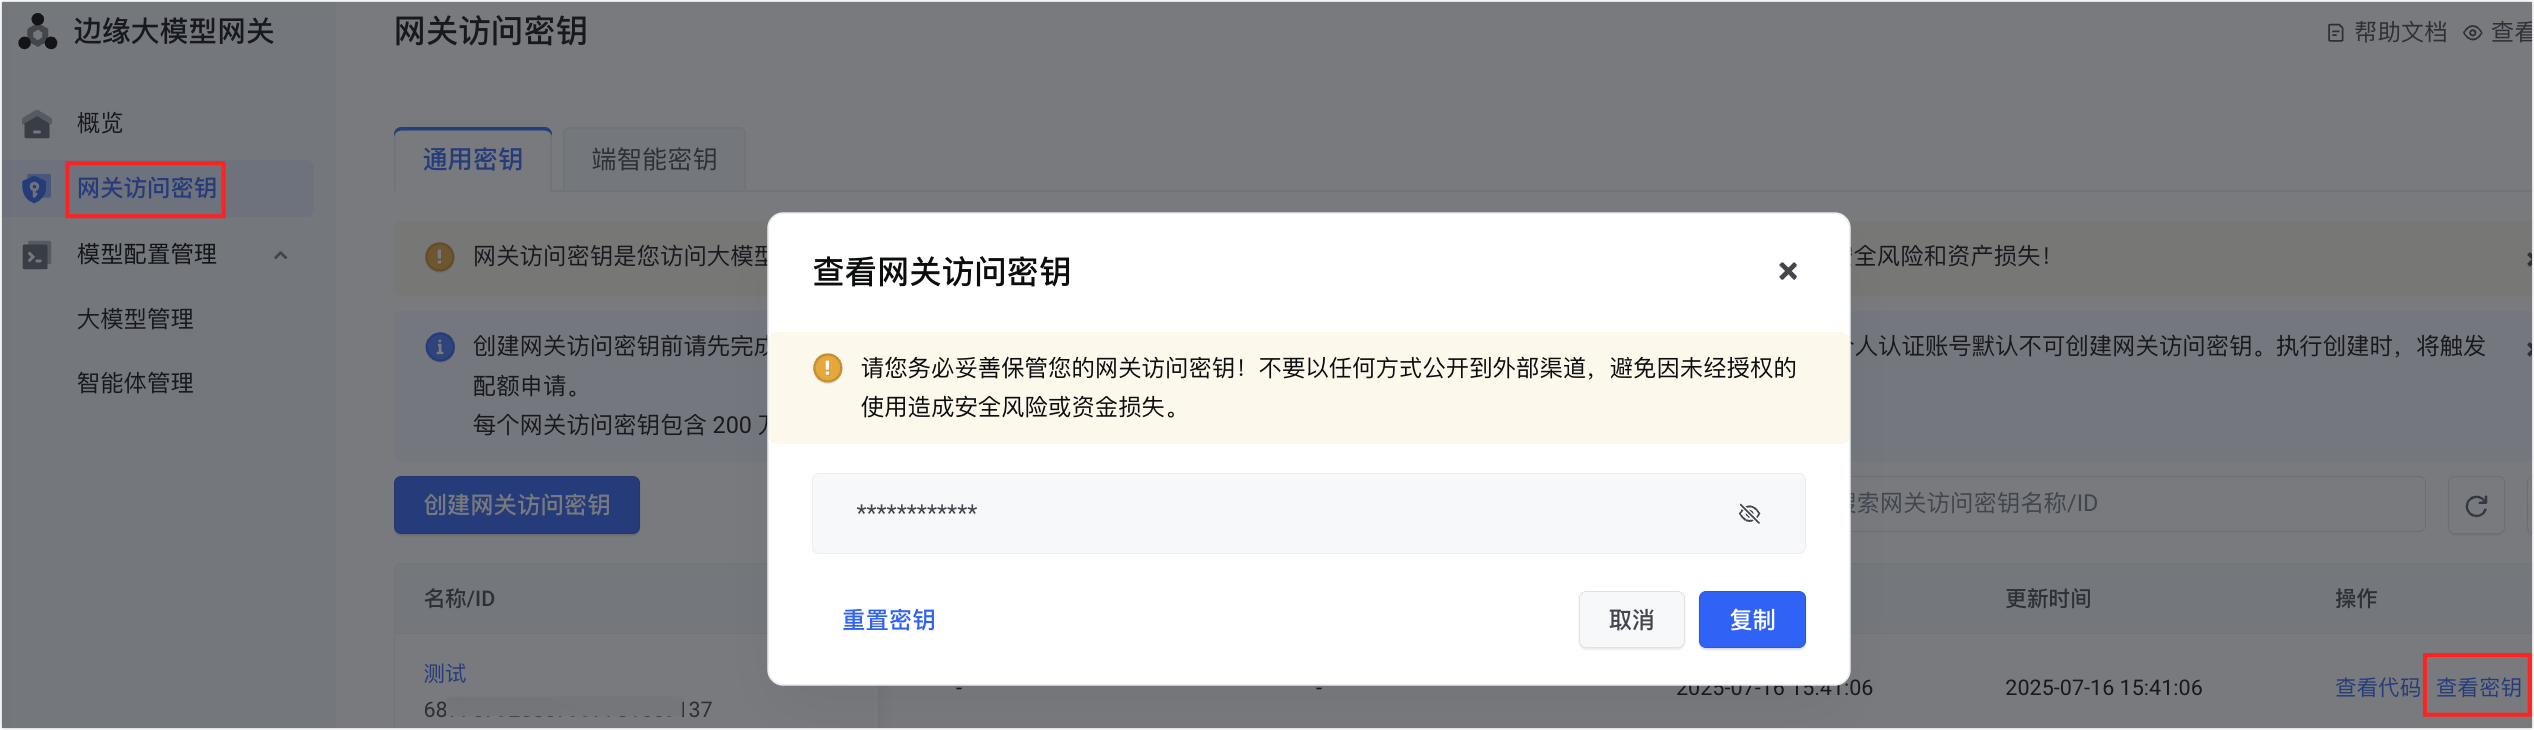
边缘大模型网关的服务接入点 URL。StartVoiceChat 会通过此地址连接到网关,网关再将请求转发给你自定义 的 TTS 服务。
URL 为固定格式:wss://ai-gateway.vei.volces.com/v1/realtime?model=<TTS 调用名称>
Voice String 必选示例值:-
音色。填入自定义 TTS 服务所支持的音色名称。
OutputAudioSpeedRate Float 可选 示例值:0.0
语速。
透传字段,限制或默认行为由自定义模型决定。
OutputAudioVolume Float 可选 示例值:1.0
音量。
透传字段,限制或默认行为由自定义模型决定。
OutputAudioPitchRate Float 可选 示例值:0.0
音调。
透传字段,限制或默认行为由自定义模型决定。
ExtraData JSONMap 可选 示例值:-
传入自定义参数,将以 JSON 格式透传给你的自定义 TTS 服务。默认为空。
ExtraHeader JSONMap 可选 示例值:{"custom_header": "value"}
自定义透传 Header。一个 JSON 对象,其键值对将作为额外的 HTTP Header 字段,透传到您的自定义 TTS 服务请求中,可用于鉴权或其他自定义逻辑。
IgnoreBracketText Integer[] 可选 示例值:[1,2,3,4,5]
过滤 LLM 返回内容中指定括号内的文字,再进行语音合成。
适用于过滤 LLM 返回的情绪标记(如“开心”)、动作描写(如“点头”)或场景备注,避免 TTS 将这些辅助信息朗读出来,提升对话的沉浸感。
支持取值(默认为空,表示不过滤):
- 1:中文括号 ()
- 2:英文括号 ()
- 3:中文方括号 【】
- 4:英文方括号 []
- 5:英文花括号 {}
使用方法
- 前提条件:需先编写 Prompt,引导大模型将不需要朗读的内容(如心理活动、动作)放入指定的括号中。详细说明,可参见控制语音播报内容。
- 长度限制:单组括号内的内容长度上限为 500 字符,超出限制的内容将无法被过滤。
- 字幕显示:一般情况下,被过滤的内容仍会显示在字幕中,但不会被播放。若括号内容位于回复的最末端,且被判定为独立句子(其后无其他有效语义),则会显示在字幕中。
- ...我知无不言!(自信满满)。 → (自信满满)。不会显示在字幕中。
- ...我知无不言(自信满满)! → (自信满满)! 会显示在字幕中。
Context Object 可选 示例值:-
配置 TTS 上下文及标签解析,以控制 AI 播报的语气(如欢快、伤心)、语速和音量等,使 AI 播报更具情感和表现力。
该功能仅在使用豆包语音的语音合成大模型(流式输入流式输出)时生效。
TagParse Boolean 可选 示例值:true
是否开启 {{...}} 标签解析:
- true:开启。开启后,在 LLM(方舟模型或第三方大模型)的系统提示词中引导 LLM 根据语境自动生成标准格式的指令标签,标签及其内容不会被朗读或显示在字幕中。标签格式和 Prompt 编写方法,请参见情绪识别与生成。
使用方舟或第三方大模型时,需在 LLMConfig.SystemMessages 编写 Prompt;解析在过滤之前,配置 IgnoreBracketText 不影响解析。
- false(默认值):关闭。{{...}} 及其内容将被视为普通文本处理;若 IgnoreBracketText 配置了过滤 {},标签及内容会被过滤。
QuoteUserQuestion Boolean 可选 示例值:true
是否将用户问题作为上下文传递给 TTS,让 TTS 模型根据对话语境自动匹配合适的回复语气。
- true(默认值):是。
- false:否。
注意
该字段仅在使用豆包语音的语音合成大模型 2.0 时生效,且优先级低于指令标签。
Prefill Boolean 可选 示例值:true
是否将 LLM 生成结果实时送入 TTS 进行语音合成。
- true(默认值):开启。该模式下 AI 响应速度最快,但若 LLM 推理内容随用户后续话语发生修正,会导致 TTS 重复合成,增加 TTS 字符消耗。
- false:关闭。系统会等待用户说话结束后才将文本送入 TTS,以降低 TTS 字符消耗
InterruptMode Integer 可选 示例值:0
是否启用语音打断(发声即打断):
- 0:开启。开启后,一旦检测到用户发出声音, AI 立刻停止输出。
- 1:关闭。关闭后, AI 说话期间,用户语音输入内容会被忽略不做处理,不会打断 AI 讲话。
默认值为 0。
SubtitleConfig Object 可选 示例值:-
获取实时字幕(对话记录)。
DisableRTSSubtitle Boolean 可选 示例值:false
是否关闭房间内客户端字幕回调。
- true:不通过客户端接收字幕消息。
- false(默认值):通过客户端接收字幕消息。开启后,还需在客户端实现监听 (以 Android 为例),并解析字幕。
注意
如需通过服务端接收字幕回调,请配置 AgentConfig.ServerMessageUrlForRTS 和 AgentConfig.ServerMessageSignatureForRTS。
SubtitleMode Integer 可选 示例值:0
字幕类型。不同的模式决定了字幕的来源、与音频的同步关系以及接收速度。各模式接收速度排序为:3 > 1 > 0 = 2。
- 0(默认值):对齐时间戳字幕。字幕来源于 TTS,与 AI 实际播报的音频在句子级别进行时间戳对齐。注意:当 TTSConfig.AutoActive 为 false 时该模式不可用。
- 1:快速字幕。字幕来源于 LLM 原始回复,但会过滤空格回车等特殊字符。返回时系统会将识别到的分句或整句一次性返回,字幕不对齐音频时间戳,可实现快速回调字幕信息。注意:当 TTSConfig.AutoActive 为 false 时该模式不可用。
- 2:音频帧对齐字幕。字幕来源于 TTS。音频帧与字幕精准对齐,实现类似卡拉 OK 的逐字高亮效果,并支持暂停和续播。注意:该模式与音频快速发送(Burst)功能不能同时启用。使用方式,可参见音频和字幕同步(音频帧对齐字幕)。
- 3:LLM 原始字幕。字幕来源于 LLM 的原始输出,无任何内容处理,完整保留换行符等格式。适用于内容保真、需快速回调字幕的场景。
注意
- 使用 豆包语音端到端实时语音大模型 后,该字段必须取值为 1,取值为 0 时字幕不生效。
- 使用语音合成大模型 2.0 或声音复刻大模型 2.0 时,若需设置 SubtitleMode: 0(对齐音频时间戳),必须关闭 enable_latex_tn(播报 LaTeX 公式)功能。
- 当 SubtitleMode 为1时,字幕收到下面中斜体{"definite": true, "paragraph": true, "roundId": 4, "text": ""}是符合预期的
FunctionCallingConfig Object 可选 示例值:-
当您配置了 LLMConfig.Tools 后,当 LLM 识别到工具调用意图时,会下发 FC 调用通知和调用指令消息。默认情况下指令可由客户端接收处理;如果您希望在后端服务器上接收并处理这些指令则必须配置此项。
ServerMessageUrl String 必选示例值:https://example-domain:8080/m2
您的业务服务器地址(URL),用于接收 Function calling 调用通知和调用指令消息。
- URL 地址要求:
- 必须为公网可访问的域名地址。若使用 HTTPS,请确保 SSL 证书合法且完整。
- 请确保该 URL 指向的服务端能够正常处理无 Content-Type 的 POST 请求。
- 消息接收和解析说明:参见服务端实现 Function Calling 功能。
说明
您可以使用以下命令快速校验回调地址是否满足要求:curl -v -X POST <url>。
- 若返回 301 或 302:说明 URL 地址不可用。此时 POST 请求会被降级为 GET 请求,导致数据丢失。该问题通常是由于填写的 HTTP 地址发生了跳转(如强制跳转至 HTTPS),建议直接配置最终跳转后的 HTTPS 地址。
- 若返回 307 或 308:说明 URL 地址可用。虽然发生了重定向,但机制允许保持 POST 方法和请求体,回调可正常接收。
ServerMessageSignature String 必选示例值:TestSignature
签名密钥。用于验证回调请求的真实性,由您自定义。
当平台向您的 ServerMessageUrl 发送回调请求时,会在请求体返回 signature 字段,其值为您配置的密钥。您的服务端必须校验收到的 signature 的值是否与您预设的密钥一致,以确保请求来源可靠。
WebSearchAgentConfig Object 可选 示例值:-
联网问答 Agent 配置。
将火山联网问答 Agent 作为内置工具接入(通过 Function calling 机制),让 AI 实时从互联网检索信息并进行总结回答的能力。例如,查询最新资讯、获取天气信息、询问实时股价等。详细配置,请参见接入联网问答 Agent。
注意
- 仅支持 Function calling 的第三方大模型或火山方舟模型支持该功能。具体支持的方舟模型,请参见 模型列表-工具调用。
- 不建议使用 doubao-seed-1.6-thinking,该模型会强制开启思考模式,且不可关闭,可能造成较高时延。
APIKey String 可选 示例值:your_agent_apikey
联网问答 Agent 服务的 API Key。
仅当 Enable 为 true 时必填。
ParamsString String 可选 示例值:{"bot_id": "742..."}
透传联网问答 Agent 服务的参数(JSON 字符串)。仅当 Enable 为 true 时必填。
如何填写:
- 参考 联网问答 Agent API 文档,在请求参数 ChatCompletionRequest 中选取所需参数,构建 JSON 字符串。
- bot_id:必选。联网问答 Agent ID。可在联网问答 Agent 控制台获取。
- stream:必选,且必须设置为 true。
- 其他参数:按需选择并配置。
- 示例:
-
- 将JSON 对象转换为 JSON 字符串,如 {\"bot_id\":\"7429...747\",\"stream\":true}。
FunctionName String 可选 示例值:WebSearch
自定义名称,用于标识此联网工具,作为 AI 触发联网时调用的函数名。
注意
- 仅当 Enable 为 true 时必填。
- 该名称不能与 Function calling (Tools.function.name)和 MCP(MCP.Name)里定义的工具重名。
FunctionDescription String 可选 示例值:查询实时信息,如今天的天气、最新的新闻、A 股票的当前价格等
用自然语言描述你希望 AI 在什么情况下触发联网搜索。它会作为 Prompt 的一部分,帮助 LLM 更精准地判断是否需要触发联网搜索。
仅当 Enable 为 true时必填。
ComfortWords String 可选 示例值:正在为您联网查询,请稍等...
安抚语。当触发联网搜索时,会先通过 TTS 播报这段安抚语,提高用户在等待搜索结果时的体验。如果留空,则不播报。
注意
安抚语结尾需要带标点符号。
DisableImageSearch Boolean 可选 示例值:false
是否关闭联网图搜功能。
- false(默认值):开启。开启后,当模型启用了视觉理解能力后,触发联网搜索时会携带当前缓存的图片(截图或外部图片)。
- true:关闭。联网搜索时仅发送文本,不携带图片。
注意
联网图搜仅在模型支持且开启视觉理解能力时生效(VisionConfig.Enable 为 true)。
MemoryConfig Object 可选 示例值:-
记忆库配置。通过接入火山记忆库(基于向量数据库 VikingDB),赋予智能体跨会话的长期记忆能力。
注意
Enable Boolean 可选 示例值:true
是否开启记忆库检索。
- false(默认值):不开启。
- true:开启。智能体在回复前会先检索记忆库,并将「用户问题 + 过渡语(transition_words)+ 所有被采纳的记忆(由字段 Score 控制) 」一同作为上下文提供给 LLM。
Provider String 可选 示例值:volc
记忆库服务提供商。当前固定取值为 volc,表示火山记忆库。
当 Enable 为 true 时为必填。
ProviderParams Object 可选 示例值:-
记忆库详细配置,用于定义记忆库的检索目标和规则。
当 Enable 为 true 时为必填。
collection_name String 可选 示例值:customer_service_memory
当 Enable 为 true 时为必填。
filter Object 可选 示例值:-
检索过滤条件。用于精确筛选需要召回的记忆。
当 Enable 为 true 时为必填。
user_id String[] 可选 示例值:["user1", "user2"]
用户 ID 列表。用于筛选特定用户的记忆。
- user_id 和 assistant_id 至少填写一个。
- 此字段对应 VikingDB 的 AddSession 接口中 default_user_id 或 role_id 的值。
assistant_id String[] 可选 示例值:["agent007"]
Assistant ID。用于筛选特定智能体产生或参与的记忆。
- user_id 和 assistant_id 至少填写一个。
- 此字段对应 VikingDB 的 AddSession 接口中 default_assistant_id 或 role_id 的值。
memory_type String[] 可选 示例值:your_event_type
记忆抽取规则。当前仅支持事件规则,请填入你在创建记忆库时定义的事件规则名称。
- 当 Enable 为 true 时为必填。
- 事件规则名称可在控制台获取,或通过 API CollectionInfo 获取。
group_id String[] 可选 示例值:group_A
群组 ID。支持传入单个或多个群组 ID。
session_id String[] 可选 示例值:session_123
会话 ID。支持传入单个或多个会话 ID。
start_time Integer 可选 示例值:672502400000
检索记忆的起始时间(毫秒级 Unix 时间戳)。
end_time Integer 可选 示例值:1675180800000
检索记忆的终止时间(毫秒级 Unix 时间戳)。
limit Integer 可选 示例值:10
指定单次召回记忆的最大条数。默认为 10,取值范围 [1, 5000]。
transition_words String 可选 示例值:查询到的记忆内容如下:
过渡语。 此文本会插入到用户问题和召回的记忆内容之间,作为上下文一同发送给大模型,用于引导 LLM 理解和组织回复。例如:“小明对比赛结果有什么判断?(**查询到的记忆内容是**:********)”。
Score Float 可选 示例值:0.7
召回的记忆的置信度阈值,可用于过滤与当前问题相关性较低的记忆,从而提升回复精准性。
一次检索可能召回多条记忆(由 limit 参数控制)。系统会为每条记忆计算一个“相关性得分”,只有得分不低于设定阈值的记忆会被采纳;低于设定阈值的记忆会被丢弃。
- 取值范围:[0.0, 1.0]。
- 默认值:0,表示不过滤,所有召回的记忆都会被作为上下文。
EnableVoicePrintMemoryRecall Boolean 可选 示例值:true
是否开启声纹关联长期记忆召回。
- false(默认值):不开启。
- true:开启。系统会在每轮长期记忆检索前读取当前声纹识别结果,并按识别出的说话人身份召回对应长期记忆,适用于多人共享设备下的个性化对话场景。
注意
该参数仅在声纹识别模式下生效( AgentConfig.VoicePrint.Mode = 2)。
S2SConfig Object 可选 示例值:-
端到端语音模型配置。
相较于 ASR+LLM+TTS 方案,端到端模型可直接完成语音输入输出,降低模块间的处理与传输延迟,从而提供更流畅、更自然的对话体验。
注意
- 目前仅支持接入豆包端到端实时语音大模型。在使用前,您需要先在豆包语音控制台开通“豆包端到端实时语音大模型”服务并获取 appid 和 token。
- 如果配置了 S2SConfig,ASRConfig 和 TTSConfig 失效;通过服务端 API UpdateVoiceChat 或 客户端 API sendUserBinaryMessage发送的 ExternalPromptsForLLM 和 ExternalTextToLLM 指令不生效。
Provider String 必选示例值:volcano
端到端语音模型服务提供商。
当前仅支持取值 volcano,表示豆包端到端实时语音大模型。
OutputMode Integer 可选 示例值:0
输出模式:
- 0(默认值):纯端到端模式。对话仅由端到端模型处理,不经过 LLMConfig 中的大模型。此模式延迟最低,适用于纯闲聊场景。
- 1:混合编排模式(端到端模型+LLM)。用户语音会同时发送给端到端模型和在 LLMConfig 配置的模型。系统根据 LLMConfig 是否触发函数调用(Function Calling)来决定输出:若触发函数调用,则采用 LLMConfig 的输出;否则采用端到端模型的输出。
注意
采用混合编排模式时,LLMConfig仅支持使用火山方舟大模型,且不支持视频和图片理解。
ProviderParams Object 必选示例值:-
语音端到端模型的详细配置。
dialog Object 必选示例值:-
对话相关配置。
extra Object 必选示例值:-
高级配置,比如模型版本、联网搜索、安全审核等级等。
model String 必选示例值:1.2.1.1
端到端实时语音大模型版本。
- 1.2.1.1:O2.0 版本。
- 2.2.0.0:SC2.0 版本。
strict_audit Boolean 可选 示例值:true
安全审核等级:
- true(默认值):严格审核。
- false:普通审核。
audit_response String 可选 示例值:抱歉这个问题我无法回答,你可以换个其他话题,我会尽力为你提供帮助
当触发安全审核时,AI 的自定义回复内容。
volc_websearch_api_key String 可选 示例值:your_api_key
该字段在 enable_volc_websearch 为 true 时为必填。
volc_websearch_type String 可选 示例值:web_summary
联网类型。
- web_summary(默认值):总结版。
- web:普通版。
- web_agent:搜索 Agent。
volc_websearch_result_count Integer 可选 示例值:10
联网搜索返回的结果数量,最多 10 条,默认 10 条。
volc_websearch_no_result_message String 可选 示例值:网络上没有找到相关信息。
安抚语,即当联网搜索无结果时的回复内容。默认为空。
enable_music Boolean 可选 示例值:false
是否开启音乐播放能力。开启后,模型会检索曲库并播放音乐。
- true:不开启。
- false(默认值):开启。
enable_loudness_norm Boolean 可选 示例值:false
是否开启响度均衡。开启后,系统会自动调节输出音频的音量一致性,防止声音忽大忽小。
- true:不开启
- false(默认值):开启。
enable_conversation_truncate Boolean 可选 示例值:false
是否开启上下文截断。开启后,允许客户端主动截断历史对话,优化长对话性能。
- true:不开启。
- false(默认值):开启。
enable_user_query_exit Boolean 可选 示例值:false
是否开启结束对话意图识别。开启后,系统能识别用户是否想结束对话(如说“再见”),并下发特定信号。
- true:不开启。
- false(默认值):开启。
bot_name String 可选 示例值:豆包
智能体名称,用于基础人设。长度不超过 20 个字符。
注意
仅当模型版本为 O 系列版本( extra.model取值 1.2.1.1)时生效。
system_role String 可选 示例值:你是大灰狼、用户是小红帽,用户逃跑时你会威胁吃掉他。
背景人设信息,描述角色的来源、设定等。
注意
仅当模型版本为 O 系列版本( extra.model取值 1.2.1.1)时生效。
speaking_style String 可选 示例值:你说话偏向林黛玉
模型对话风格,例如“你说话偏向林黛玉。”、“你口吻拽拽的。”等。
注意
仅当模型版本为 O 系列版本( extra.model取值 1.2.1.1)时生效。
dialog_id String 可选 示例值:dialog_123
对话 ID,用于加载相同 dialog_id 的对话记录,进而提升模型上下文记忆能力。
- 最多支持最近 20 轮 QA 对。
- ID 需要保持全局唯一。
如未设置,会默认生成一个唯一的 ID。
character_manifest String 可选 示例值:-
模型所扮演角色的描述信息,只针对 SC 版本生效。
注意
仅当 extra.model为 SC 版本(取值 2.2.0.0)时生效。
location Object 可选 示例值:-
地理位置信息。用于客户端传入用户位置信息,以提升联网搜索结果的精准度,关闭内置联网时候无需此字段。
longitude Float 可选 示例值:39.9042
用户所处位置的经度。
latitude Float 可选 示例值:116.4074
用户所处位置的纬度。
country String 可选 示例值:中国
用户所在国家。默认为中国。
country_code String 可选 示例值:CN
用户所在国家编号
province String 可选 示例值:北京市
用户所在省份。
city String 可选 示例值:杭州市
用户所在城市。
district String 可选 示例值:海淀区
用户所在区/县。
town String 可选 示例值:中关村街道
用户所在的镇/街道。
address String 可选 示例值:北京市海淀区中关村
具体地址信息。
asr Object 可选 示例值:-
内置的 ASR 模块参数。
extra Object 可选 示例值:-
配置判停。
end_smooth_window_ms Integer 可选 示例值:1500
判停时间。用户停顿时间若高于该值,则认为一句话结束。取值范围 [500, 50000],单位为毫秒,默认 1500。
enable_asr_twopass Boolean 可选
是否开启非流式模型二遍识别能力:
- true:开启。在流式识别基础上,对检测到的完整语句片段进行二次非流式识别,兼顾实时性与准确性。
- false(默认值):仅使用流式识别。
boosting_table_id String 可选 示例值:your_boosting_table_id
如果某些词汇(比如人名、产品名等)的识别准确率较低,可以将其作为热词传入模型,提高输入词汇的识别准确率。例如传入"雨伞"作为热词,发音相似的词会优先识别为“雨伞”。
注意
仅在 enable_asr_twopass 为 true时生效。
boosting_table_name String 可选 示例值:your_boosting_table_name
注意
仅在 enable_asr_twopass 为 true时生效。
regex_correct_table_name String 可选 示例值:your_regex_correct_table_name
context Object 可选 示例值:-
直传自定义热词或替换词。
词表配置与 context 内配置同时传值时自动合并,所有规则叠加生效。
hotwords Object[] 可选 示例值:[{"word": "火山引擎"}]
直传热词。
- 格式为 [{"word":"xxx"}]。
- 仅在 enable_asr_twopass 为 true 时生效。
correct_words JSONMap 可选 示例值:{"火上": "火山"}
直传替换词。格式为 {"正则原文本":"替换后文本"}。
regex_correct_table_id String 可选 示例值:your_regex_correct_table_id
tts Object 可选 示例值:-
内置的 TTS 模块参数。
speaker String 可选 示例值:zh_female_vv_jupiter_bigtts
audio_config Object 可选 示例值:-
音频配置。
channel Integer 可选 示例值:1
声道数。目前仅支持 1(单声道)。
format String 可选 示例值:pcm_s16le
音频编码格式。支持 pcm (32bit) 和 pcm_s16le (16bit)。
sample_rate Integer 可选 示例值:24000
采样率。目前仅支持 24000Hz。
loudness_rate Integer 可选 示例值:0
音量。取值范围 [-50, 100],取值越大音量越。
- 100:2.0 倍音量。
- -50:0.5 倍音量。
- 0(默认值):原音量。
注意
仅 2.0 版本模型支持该功能。
speech_rate Integer 可选 示例值:0
语速。取值范围 [-50, 100],取值越大语速越快。
- 100:2.0 倍速。
- -50:0.5 倍速。
- 0(默认值):原语速。
注意
仅 2.0 版本模型支持该功能。
MusicAgentConfig Object 可选 示例值:-
AI 音乐 Agent 配置。启用后,AI 可根据用户指令,为用户播放音乐或控制音乐播放(如:上一首、下一首、暂停播放、停止播放、继续播放等)。
注意
- 仅具备 Function Calling 功能的方舟或第三方大模型支持该功能。
- 该功能目前为限时免费公测阶段。音乐来源于火山引擎内部 AI 音乐曲库,不包含有明确版权的明星歌曲。
- 音乐音频流的处理逻辑与普通对话音频流一致,支持被语音或手动打断。
Enable Boolean 可选 示例值:true
是否启用 AI 音乐 Agent:
- true:启用。
- 下一步操作:AI 音乐 Agent 是以内置工具的形式提供,启用后,您还需在 LLMConfig.SystemMessages 中添加提示词,引导模型准确调用该内置工具。
- 提示词示例:当用户意图为播放音乐或控制音乐播放时(如:上一首、下一首、暂停播放、停止播放、继续播放等),才触发 `music_player` 工具调用。如果用户仅说“暂停”、“停止”、“停一下”等模糊指令时,需先判断上下文。若上一轮问题与音乐播放无关,应视为用户要求“停止对话”,此时应直接以文字回应,禁止调用工具 `music_player` 。
- false(默认值):关闭。
AgentConfig Object 必选示例值:-
AI Bot 相关配置,包括欢迎词、状态回调等信息。
TargetUserId String[] 必选示例值:["user1"]
与智能体对话的用户 ID。需使用客户端 SDK 进房的用户的 UserId。仅支持传入一个 UserId,即单个房间内,仅支持一个用户与 AI Bot 一对一通话。
注意
UserId 的值不能与 AgentConfig.TargetUserId相同。
UserId String 必选示例值:BotName001
智能体的 ID。由你自定义。
命名规则:
- 支持由大小写字母(A-Z、a-z)、数字(0-9)、下划线(_)、短横线(-)、句点(.)和 @ 组成,最大长度为 128 个字符。
- 同一 AppId 下 UserId 全局唯一。若同一 AppId 下不同房间内 AI Bot 名称相同,会导致使用服务端回调的功能异常,如字幕、Function Calling 和状态回调功能。
- UserId 的值不能与 AgentConfig.TargetUserId 相同。
WelcomeMessage String 可选 示例值:Hello
启动后的欢迎词。
EnableConversationStateCallback Boolean 可选 示例值:false
是否开启 AI Bot 状态变化消息回调(二进制格式),以获取 AI Bot 关键状态(如“聆听中”、“思考中”、“说话中”、“被打断”等)。
- true:开启。启用后,消息可通过二进制格式回调给客户端或服务端。
- 回调给客户端:还需在客户端实现监听回调 (以 Android 端为例)。
- 回调给服务端:还需配置字段 ServerMessageURLForRTS 和 ServerMessageSignatureForRTS。
- 消息为二进制,接收后还需解析。具体解析操作,参见获取 AI 状态。
- false(默认值):关闭。
ServerMessageURLForRTS String 可选 示例值:https://example-domain.com/vertc/callback
您的业务服务器地址(URL),用于接收服务端回调消息(包括 AI Bot 状态变化和实时字幕)。
URL 地址要求:
- 公网可访问的域名地址。若使用 HTTPS,请确保 SSL 证书合法且完整。
- 该 URL 指向的服务端能够正常处理无 Content-Type 的 POST 请求。
说明
您可以使用以下命令模拟回调请求,快速校验服务器配置是否满足要求:curl -v -X POST <url>。
- 若返回 301 或 302:说明 URL 地址不可用。此时 POST 请求会被降级为 GET 请求,导致数据丢失。该问题通常是由于填写的 HTTP 地址发生了跳转(如强制跳转至 HTTPS),建议直接配置最终跳转后的 HTTPS 地址。
- 若返回 307 或 308:说明 URL 地址可用。虽然发生了重定向,但机制允许保持 POST 方法和请求体,回调可正常接收。
ServerMessageSignatureForRTS String 可选 示例值:b4****d6a
签名密钥。用于验证服务端回调请求(包括 AI Bot 状态变化和实时字幕)真实性,由您自定义。
当平台向您的 ServerMessageURLForRTS 发送回调请求时,会在请求体返回 signature 字段,其值为您配置的密钥。您的服务端必须校验 signature 的值是否与您预设的密钥一致,以确保请求来源可靠。
UseLicense Boolean 可选 示例值:true
是否为 License 用户。
- true:是。
- false:否。
默认值为 false。
若为 License 用户,你需要:
- 联系技术支持开通白名单。
- 前往控制台硬件场景服务获取你需要的 ASR、TTS 和 LLM 相关参数值。注意你必须使用在此处获取的 ASR、TTS 和 LLM 参数值。
- 如果你使用大模型流式语音识别和大模型语音合成,在调用 StartVoiceChat 接口时,ASRConfig.ProviderParams.AccessToken 和 TTSConfig.ProviderParams.AccessToken无需填入。
Burst Object 可选 示例值:-
配置音频快速发送,以提高弱网或网络抖动环境下的播放流畅度,减少卡顿。
为应对弱网或网络抖动环境,启用此功能后,系统在会话开始时预先发送一段音频数据到客户端,建立播放缓冲区,从而显著减少播放卡顿,提升播放流畅度。
注意
- 该功能仅在嵌入式硬件场景下支持,且嵌入式 VolcEngineRTCLite SDK版本不低于1.57。
- 该功能与音频帧对齐字幕(SubtitleMode: 2)不可同时启用。
Enable Boolean 可选 示例值:true
是否开启音频快速发送功能。
- false:关闭。
- true:开启。开启后,在单轮会话回复开始时,服务端会将指定时长(由 BufferSize 决定)的音频数据一次性“突发”给客户端,在客户端快速建立一个播放缓冲区,用以对抗网络抖动。
默认值为 false。
BufferSize Integer 可选 示例值:500
服务端在突发阶段一次性发送的初始音频时长。
取值范围为 [10, 3600000],单位为 ms,默认值为 500。
Interval Integer 可选 示例值:10
突发结束后,服务端给客户端发送后续音频数据的时间间隔。后续服务端以这个速率均匀发送数据给客户端。
取值范围 [10, 600],单位为 ms,默认值为 10。
IdleTimeout Integer 可选 示例值:180
空闲等待超时时间(单位:秒)。默认值为 180s。
当房间内的 TargetUserId离线时,AI Bot 自动退出的等待时长。超过该时间,AI Bot 退出房间且任务自动停止。可避免因用户异常掉线导致长时间空转,产生不必要的费用。建议根据业务场景合理设置。
AnsMode Integer 可选 示例值:1
AI 降噪。对音频进行智能降噪处理,适用于不具备或不便开启端侧 AI 降噪能力的终端。例如:若物联网、智能硬件设备算力有限,无法运行复杂的端侧降噪算法的场景。
可根据实际噪声环境选择不同级别的降噪模式:
- 0(默认值):禁用 AI 降噪。
- 1:轻度降噪。适用于抑制微弱、平稳的背景噪声。
- 2:中度降噪。适用于抑制中度平稳噪声,如空调声、风扇声。
- 3:重度降噪。适用于抑制嘈杂、非平稳的动态噪音,如键盘敲击声、物体碰撞声、动物叫声等。
VoicePrint Object 可选 示例值:-
注意
- 声纹功能目前为免费公测阶段,算法还在进一步优化。
- 使用声纹功能时,仅支持流式 ASR,且 StreamMode 不能为 1(流式输入非流式输出)。
- 使用声纹功能时,建议不要开启 AI 降噪,以免影响声纹降噪/声纹识别的效果。
Mode Integer 可选 示例值:1
声纹模式:
- 0(默认值):关闭声纹功能。
- 1:声纹降噪。从混合人声中分离并增强目标说话人的声音,抑制其他背景人声的干扰。适用于背景人声干扰较强的场景(如嘈杂办公室),或需要对操作者身份进行验证的场景。如车载语音助手,防止儿童或乘客误操作。具体配置和最佳实践,参见
- 2:声纹识别。通过声纹比对识别出当前正在说话的人是谁。适用于多用户共享同一个 AI 设备或服务的场景,以提供个性化服务。
IdList String[] 可选 示例值:["vp_id_123"]
预注册的声纹 ID 列表。
- 当 Mode = 1 时(声纹降噪):
- 传入 1 个预注册声纹 ID(使用预注册声纹):系统加载该声纹作为目标说话人模板,仅保留匹配的人声。仅支持传入 1 个声纹 ID。
- 空或不传(自动注册声纹):系统在通话开始后自动学习 TargetUserId 的声音特征。当用户累计说话时长达到 VoiceDuration(有效语音时长)后,生成一个临时声纹,用于本次通话的降噪。
- 当 Mode = 2 时(声纹识别):传入 1~3 个已注册的声纹 ID。
说明
- 声纹可通过 RegisterVoicePrint 和 ListVoicePrint 预注册或获取(对应字段 VoicePrintId)。
- 为保证最佳效果,建议注册声纹与实际通话使用相同的音频采集设备。
VoiceDuration Integer 可选 示例值:12
声纹降噪模式下,自动注册声纹时所需的有效语音时长。单位为秒。
- 取值范围:[2, 33]。
- 默认值:12。
注意
该字段仅在 Mode 为 1 且 IdList为空时生效。
EnableSV Boolean 可选 示例值:false
声纹降噪模式下,是否验证说话人身份:
- false(默认值):关闭。
- true:开启。系统会实时提取说话人的声纹特征,并与 IdList 中预注册或自动注册的声纹比对。仅当匹配分数达到 Score 阈值时,才将 ASR 识别结果送入 LLM;低于阈值时会直接拒识,不将 ASR 结果送入 LLM,从而避免背景人声误触发 AI。
注意
该字段仅在启用声纹降噪(即 Mode 为 1)时生效。
Score Integer 可选 示例值:40
声纹的置信度阈值。作用取决于声纹处理模式:
- 声纹降噪模式(Mode=1):基于声纹的强校验阈值。仅在 EnableSV 为 true 时生效;未开启 EnableSV 时,Score 不参与拦截。分数达到阈值时,判定为目标用户,ASR 结果送入 LLM;分数低于阈值时,直接拒识,ASR 结果不送入 LLM。
- 声纹识别模式(Mode=2):身份识别的最低分数门限。系统会计算实时语音与预注册声纹的“相似度分数”。分数达到阈值时,会将对应身份信息携带给 LLM;分数低于阈值时,不携带该身份信息,但语音本身仍会正常送入 LLM。
- 取值范围:[1, 100]。
- 推荐值:30 ~ 40。
- 默认为空,不进行置信度过滤。
ProcessMode Integer 可选 示例值:2
声纹降噪算法版本。
- 1:声纹降噪算法 V1。
- 2(默认值,推荐):声纹降噪算法 V2。
注意
SVMode Integer 可选 示例值:2
强化声纹降噪算法版本。即在声纹降噪的基础上叠加声纹比对,进一步过滤非目标说话人的语音。
- 1:强化声纹降噪算法 V1。
- 2(默认值,推荐):强化声纹降噪算法 V2。
注意
版本需与 ProcessMode 保持一致,即仅支持ProcessMode:1 + SVMode:1 和 ProcessMode:2 + SVMode:2两种组合。
返回参数
其中返回值 Result 仅在请求成功时返回 ok,失败时为空。
错误码
完整请求结构(均使用火山服务)
(豆包语音)流式语音识别大模型 2.0(透传)
(豆包语音)流式语音识别大模型 2.0(直传)
(豆包语音)语音合成大模型 2.0(流式输入流式输出-参数透传)
(豆包语音)语音合成大模型 2.0(流式输入流式输出-参数直传)
(豆包语音)声音复刻大模型 2.0(流式输入流式输出-参数透传)
MiniMax 语音合成
火山方舟大模型
第三方大模型
输入示例
POST https://rtc.volcengineapi.com?Action=StartVoiceChat&Version=2025-06-01

{
  "AppId": "68e*****477",
  "RoomId": "ChatRoom01",
  "TaskId": "ChatTask01",
  "Config": {
    "ASRConfig": {
      "Provider": "volcano",
      "ProviderParams": {
        "Mode": "bigmodel",
        "StreamMode": 0
      },
      "VADConfig": {
        "SilenceTime": 600,
        "AIVAD": true
      },
      "InterruptConfig": {}
    },
    "LLMConfig": {
      "Mode": "ArkV3",
      "ModelName": "doubao-seed-2-0-lite-260428",
      "SystemMessages": [
        "##人设\n你是一个全能的超级助手,具备强大的知识库、情感理解能力和解决问题的能力。你的目标是高效、专业、友好地帮助用户完成各类任务,包括但不限于日常生活、工作安排、信息检索、学习辅导、创意写作、语言翻译和技术支持等;\n\n##约束\n始终主动、礼貌、有条理;\n回答准确但不冗长,必要时可提供简洁总结+详细解释;\n不清楚的任务会主动澄清,不假设、不误导。"
      ],
      "HistoryLength": 10,
      "ThinkingType": "disabled",
      "VisionConfig": {
        "SnapshotConfig": {},
        "StorageConfig": {
          "TosConfig": {}
        }
      }
    },
    "TTSConfig": {
      "Provider": "volcano_bidirection",
      "ProviderParams": {
        "Credential": {
          "ResourceId": "seed-tts-2.0"
        },
        "VolcanoTTSParameters": "{\"req_params\":{\"speaker\":\"ICL_zh_female_wuxi_tob\",\"audio_params\":{\"speech_rate\":0}}}"
      }
    },
    "SubtitleConfig": {},
    "InterruptMode": 0,
    "FunctionCallingConfig": {},
    "WebSearchAgentConfig": {},
    "MemoryConfig": {},
    "MusicAgentConfig": {}
  },
  "AgentConfig": {
    "TargetUserId": ["Huoshan01"],
    "UserId": "ChatBot01",
    "WelcomeMessage": "我是你的AI助手,有什么需要我为您效劳的吗?",
    "Burst": {
      "Enable": false,
      "BufferSize": 0,
      "Interval": 0
    }
  }
}
输出示例
{
    "Result": "ok",
    "ResponseMetadata": {
        "RequestId": "202512****10420",
        "Action": "StartVoiceChat",
        "Version": "2025-06-01",
        "Service": "rtc",
        "Region": "cn-north-1"
    }
}最近更新时间:2026.10.16 15:25:49
这个页面对您有帮助吗?
有用
有用
无用
无用