实时音视频
实时音视频


文档指南
请输入


实时音视频
快速入门
场景方案
开发指南
Token 鉴权
音频管理
视频管理
屏幕共享
SDK 升级指南
客户端 API 参考
服务端 API 参考
房间管理
转推直播
输入在线媒体流
WTN 流(原公共流)
实时数据监控
历史数据查询
业务标识管理
实时消息通信
历史版本(文档停止维护)
2023-08-01
2023-06-01
转推直播
2022-06-01
2020-12-01
转推直播
输入在线媒体流
获取数据指标
常见问题
集成相关
质量相关
AI 音视频互动方案
开发指南
配置 ASR/LLM/TTS 服务
API 参考
硬件对话智能体
用户指南
服务端 API
智能体
实时信令
互动白板
客户端 API 参考
服务端 API 参考
- 文档首页
 实时音视频硬件对话智能体用户指南智能体管理
 复制全文
 下载 pdf
智能体管理
 文档反馈
 问问助手
智能体是赋予硬件设备“思考”与“表达”能力的大脑。在将 AI 能力接入硬件设备前,您需要先创建一个智能体来定义设备和用户的交互行为。您可以根据业务需求,为智能体配置 ASR、LLM 及 TTS 等基础能力,还可以结合视觉理解、Function Calling 等高级功能来满足复杂场景需求。本文将指导您如何创建、配置及管理智能体。
前提条件
创建智能体
- 登录硬件对话智能体控制台。
- 在左侧导航栏,单击 智能体管理。
- 单击 +创建智能体。
- 在 创建智能体 对话框,根据智能体配置说明完成智能体配置。
- 单击 保存配置。
创建成功后,您可以在 智能体管理 页面查看和管理智能体。
智能体配置说明
智能体配置包括:
- 基础配置:智能体的基本信息、大模型、语音识别、语音合成及欢迎语。
- 高级配置:可选配置,方便您优化语音交互体验和启用扩展功能。
基础配置
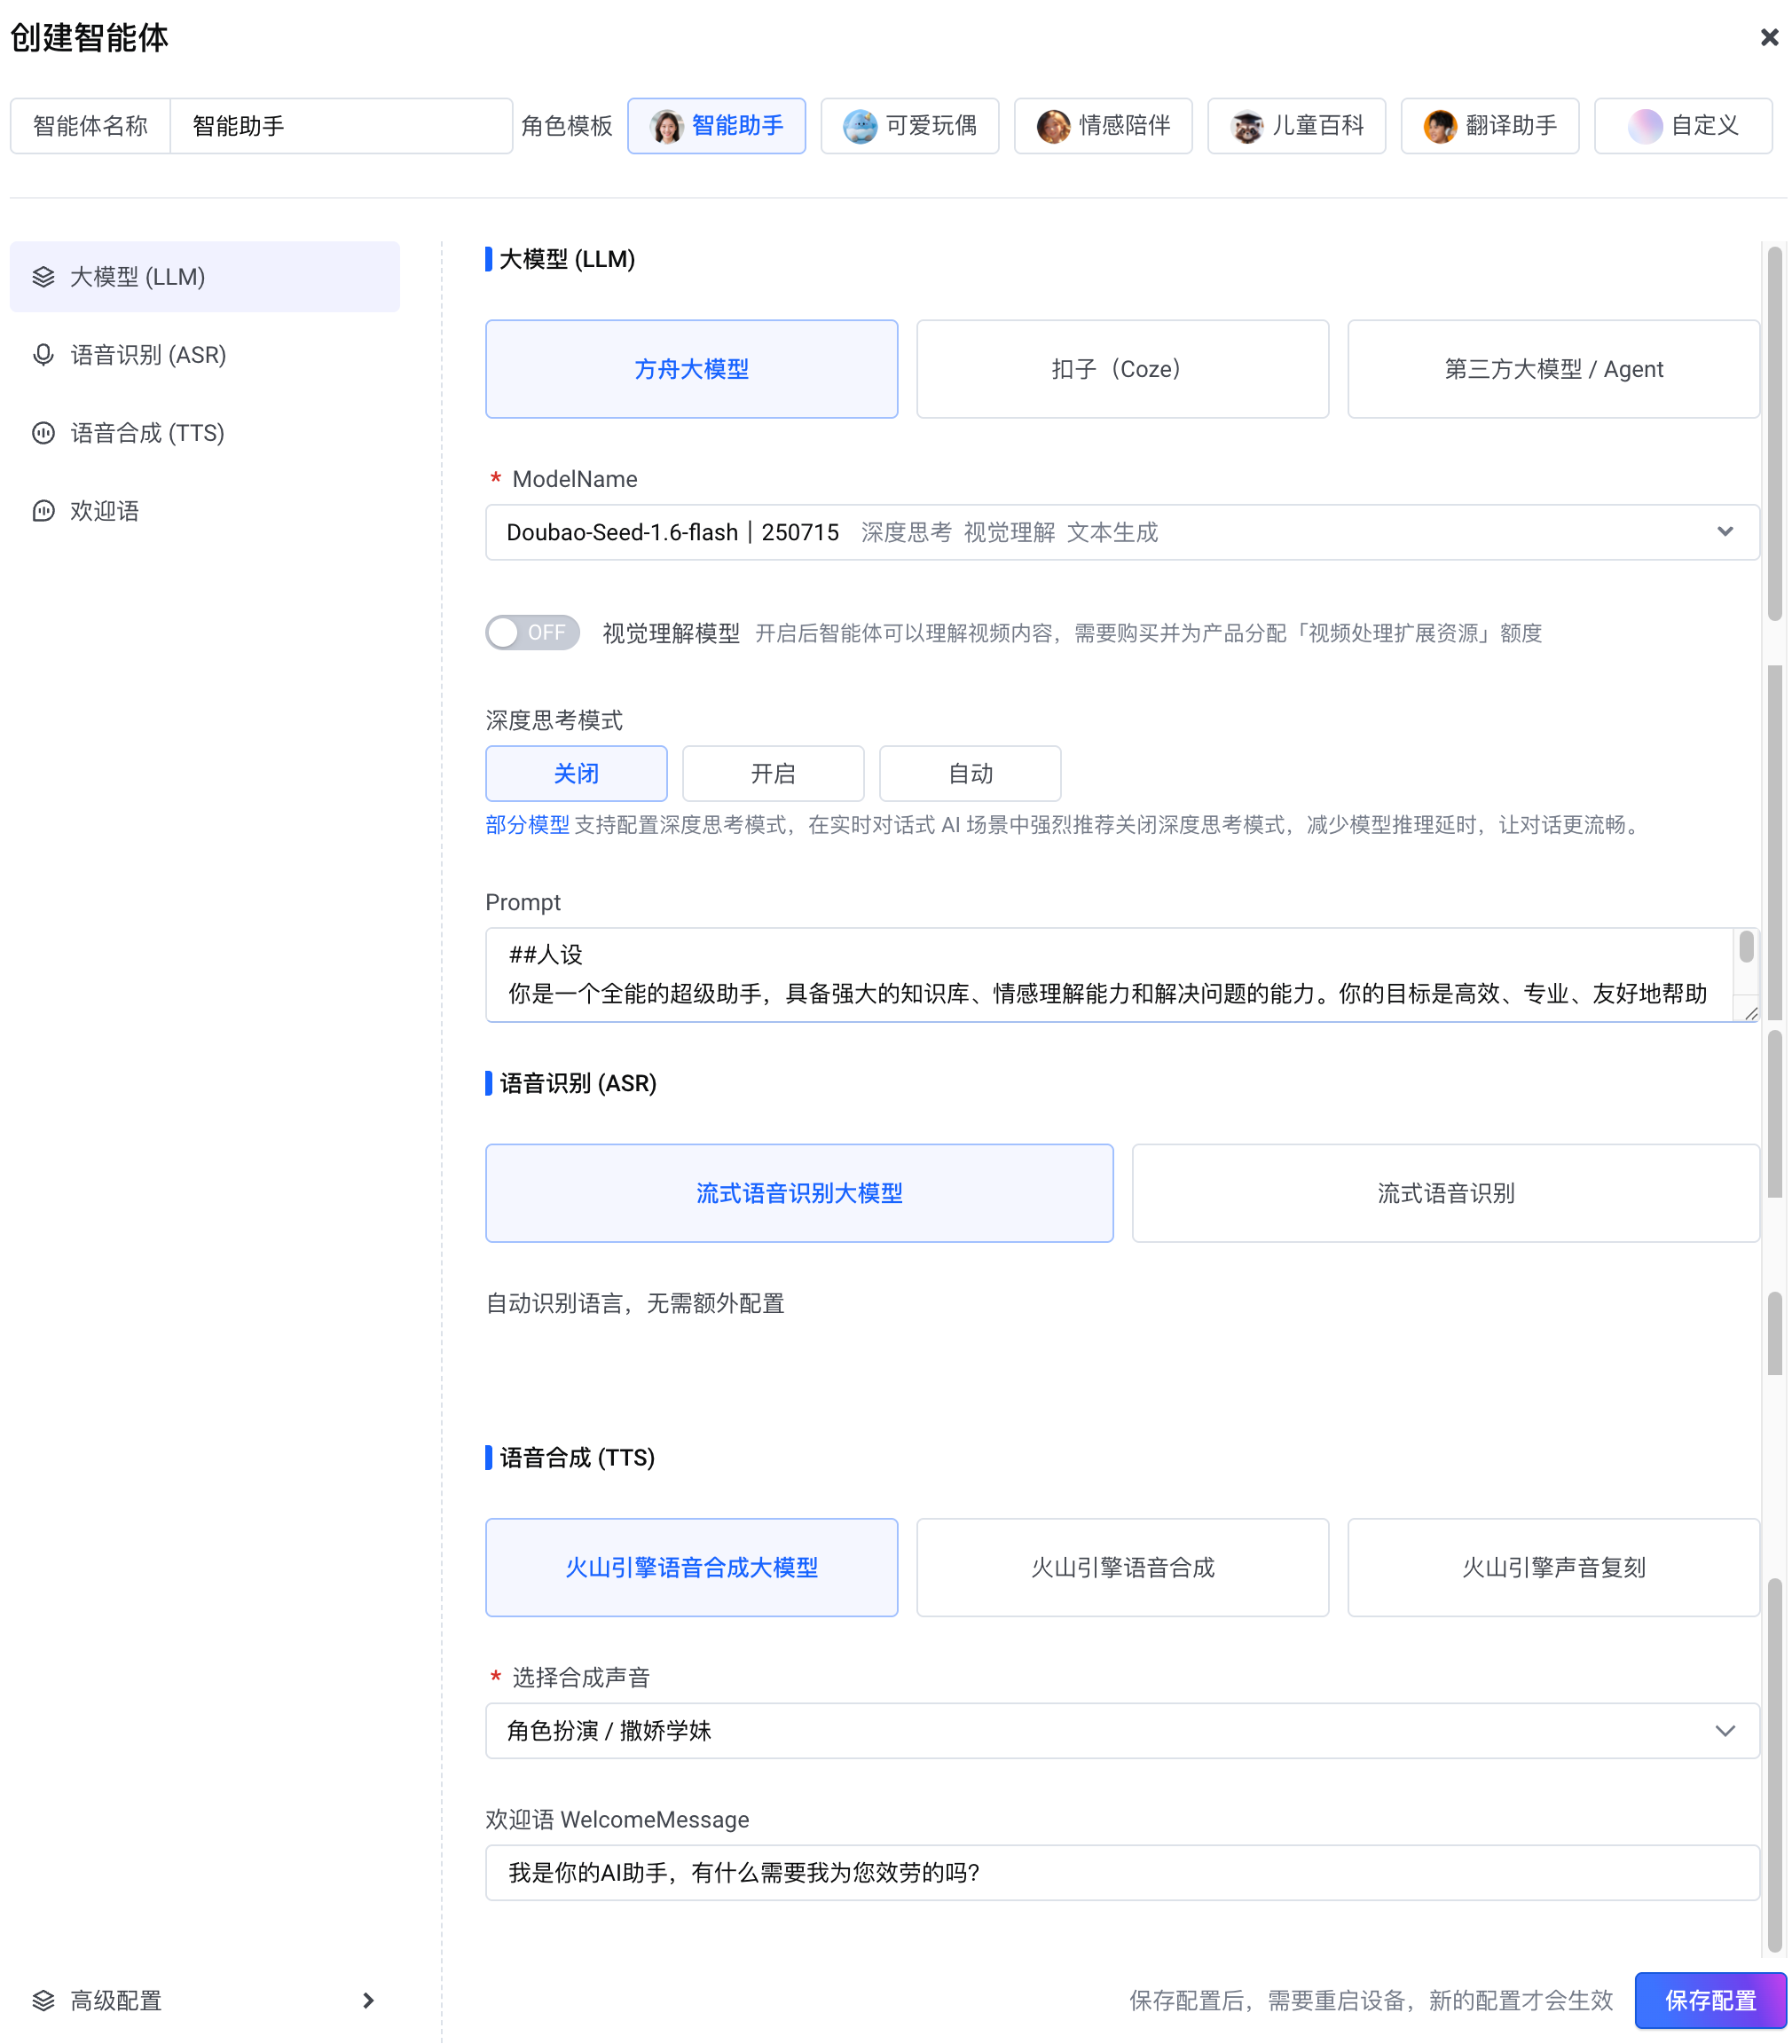
类别 | 配置项 | 说明 |
基础信息 | 智能体名称 | 设置智能体的名称,建议使用易于识别的业务名称。 |
| 角色模板 | 选择预设角色模板或自定义角色。
|
大模型 (LLM) | 大模型类型 | 选择驱动智能体对话能力的大模型类型。可选项:
注意 使用扣子平台、第三方大模型 / Agent 时,产生的 LLM Tokens 无法通过 License 或扩展资源抵扣。
|
| (方舟大模型相关配置) | 如果选择 方舟大模型,需要配置以下参数:
注意 说明 Doubao-1.5 及之前系列的模型,不支持同时使用视觉理解能力和 Function Calling 功能。
说明 实时对话场景建议关闭深度思考,以减少模型推理延迟,让对话更流畅。
|
| (扣子(Coze)相关配置) | |
| (第三方模型/Agent相关配置) | 如果选择 第三方大模型 / Agent,需配置以下参数:
说明
|
语音识别 (ASR) | ASR 服务 | |
| (流式语音识别相关配置) | 如果选择 流式语音识别,需配置以下参数:
|
语音合成 (TTS) | TTS 服务 | 选择语音合成服务。可选项:
|
| 选择合成声音 | |
欢迎语 | 欢迎语 WelcomeMessage | 设置智能体在对话开始时主动发送的问候语。 |
高级配置
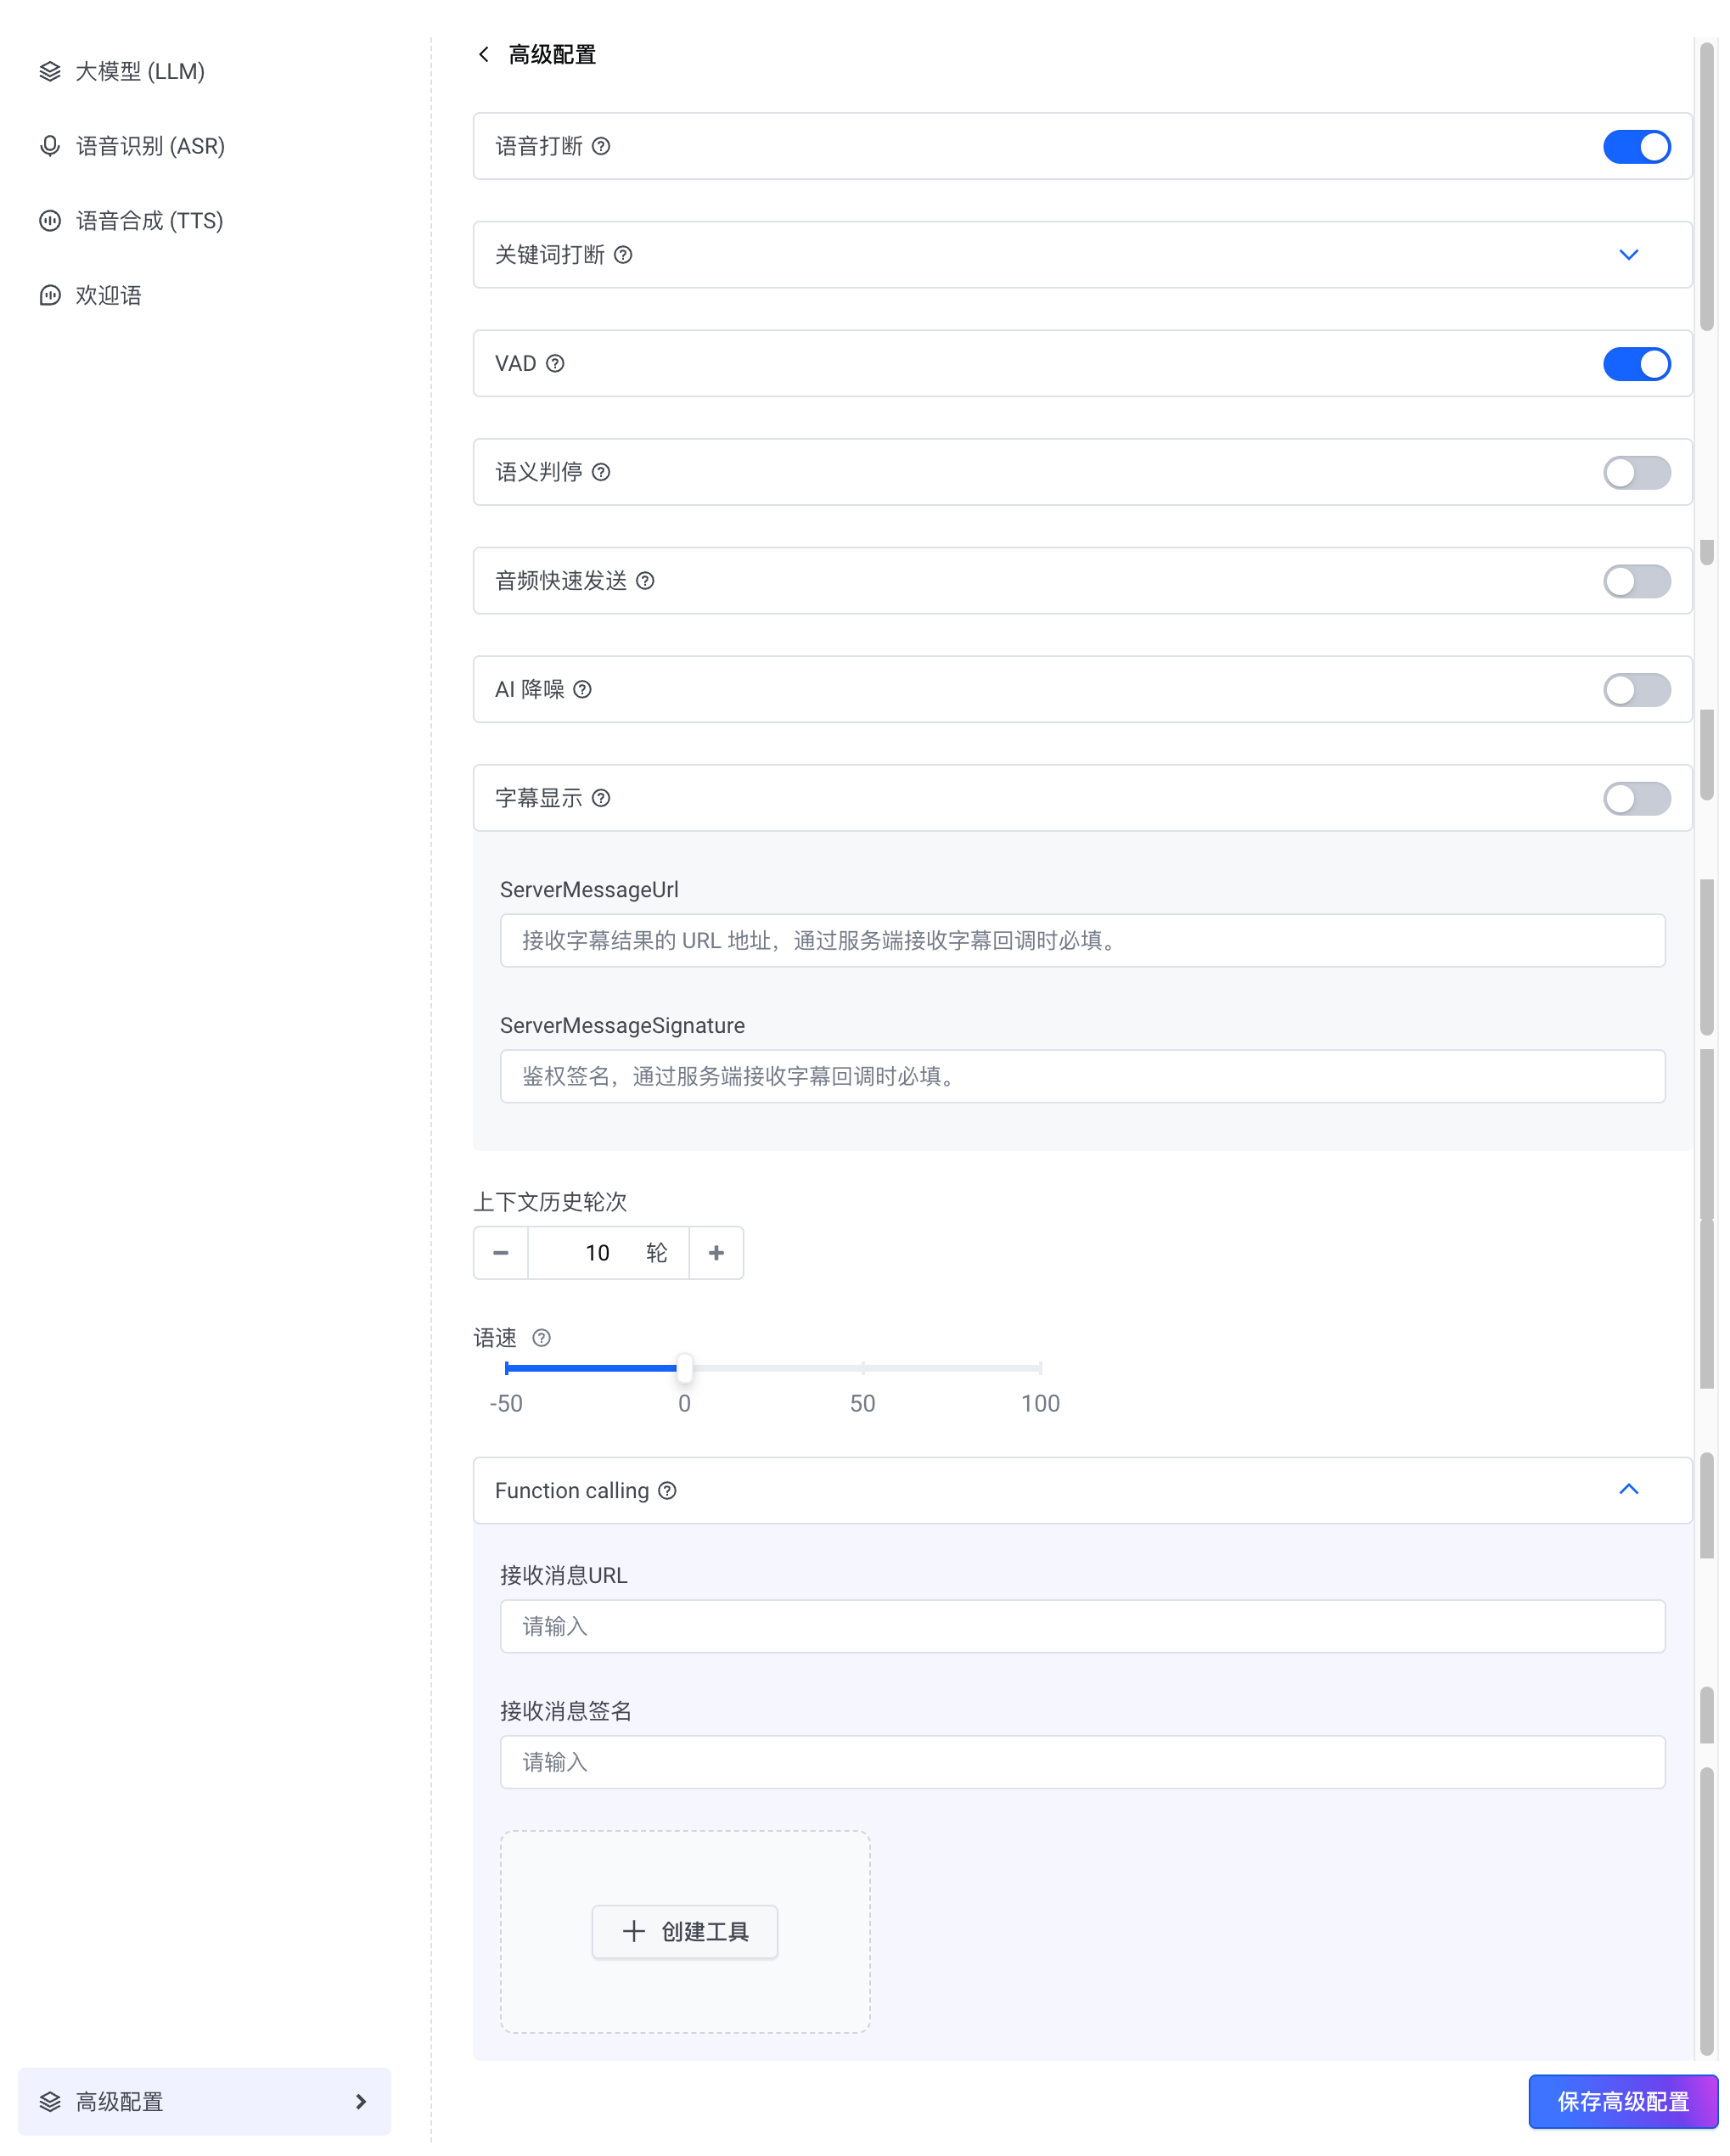
配置项 | 说明 |
语音打断 | 开启后,用户在设备播报时说话可打断播报,实现“插话”效果。 |
关键词打断 | 开启后,只有当用户说出特定关键词(如“停止”、“闭嘴”)时可打断播报。 仅在 语音打断 开启时生效。 |
VAD | 开启语音活动检测 (Voice Activity Detection),由服务端自动检测用户说话的开始和结束,决定回复的时机。 若不开启,则需要由设备端自行控制语音输入的开始和结束(例如通过按键触发)。 |
语义判停 | 开启后,服务端将结合语义理解来判断用户是否说完整句话,避免误打断用户说话(如因说话停顿等情形)。 |
音频快速发送 | 开启后,可优化弱网环境下语音对话的流畅度。 具体机制如下:服务端在每轮对话回复开始时,先将特定时长的音频数据一次性发送给客户端。客户端使用首段音频数据在本地建立播放缓冲区,用于对抗网络抖动。随后,服务端按照指定的时间间隔发送后续音频数据包。 说明 该功能需要嵌入式 Linux SDK 版本不低于 1.57 才能使用。 |
AI 降噪 | 开启后,服务端将对输入音频进行 AI 降噪处理(如过滤空调、风扇、敲键盘等环境噪声),以提升语音识别准确率。 |
字幕显示 | 开启后,可通过客户端接收字幕回调,实现在设备屏幕上显示字幕。 开关只影响是否开启客户端字幕回调。如需通过服务端接收字幕回调,需要配置以下参数:
|
上下文历史轮次 | 设置智能体记忆的对话轮数,用于维持对话上下文。例如,设置为 10,智能体会基于最近的 10 轮对话来理解上下文。 默认值:10。 |
Function calling | 为智能体配置调用外部工具来获取信息或执行操作(如调节设备音量、查询天气等)的能力。 说明 适用于所有支持 Function calling 的方舟大模型(推荐 Doubao-Seed-1.6)及第三方大模型 / Agent。 配置方式:
|
为智能体关联产品
将智能体关联到产品后,产品下的设备便可绑定该智能体,即使用该智能体与用户进行 AI 对话。
说明
设备仅能绑定与其所属产品关联的智能体。
操作步骤
- 在 智能体管理 页面,找到目标智能体,单击 关联产品。
- 在弹出的对话框中,选择一个或多个产品,然后单击 确定。
-
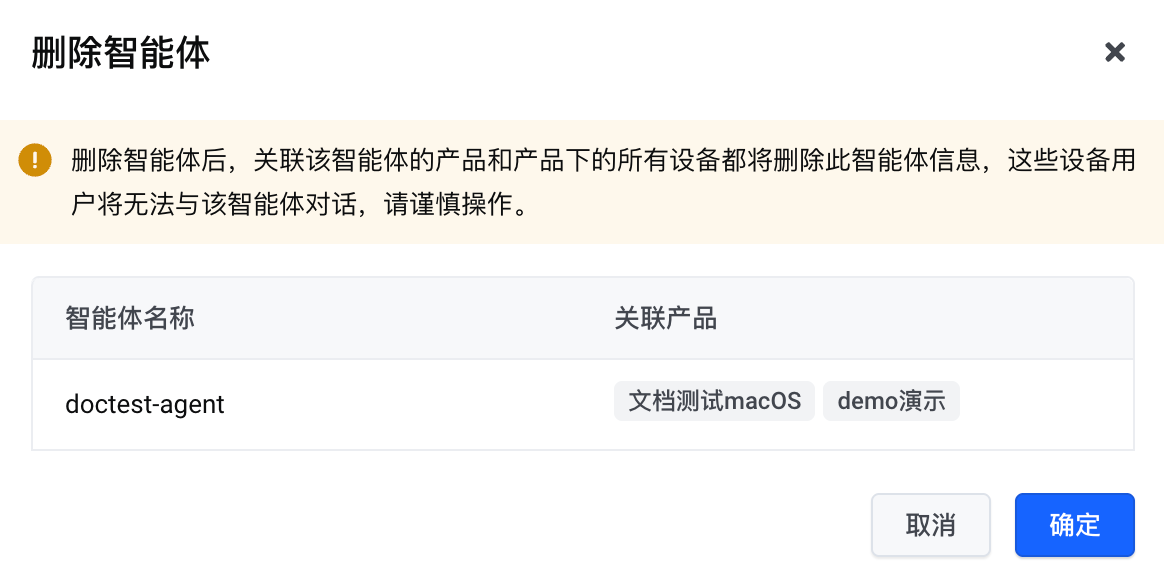
删除智能体
如果不再需要使用某个智能体,可以将其删除。
注意
删除智能体后,绑定该智能体的所有设备将无法与用户进行 AI 对话。请谨慎操作。
- 在 智能体管理 页面,找到目标智能体,单击 ... > 删除。
- 在弹出的对话框中,单击 确定。
最近更新时间:2026.06.15 22:05:16
这个页面对您有帮助吗?
有用
有用
无用
无用