云服务器
云服务器
云服务器


文档指南
请输入


云服务器ECS
产品动态
产品公告
实例停售相关
OpenAPI相关
价格和配额相关
功能下线相关
产品计费
快速入门
用户指南
实例
实例规格清单
选择实例计费方式
登录实例
镜像
公共镜像
自定义镜像
镜像维护周期与EOL应对方案
弹性块存储
快照
网络
监控
运维
云助手
运维编排
管理常用运维任务
补丁管理
最佳实践
AI应用
ArkClaw
OpenClaw
通过应用模板快速部署OpenClaw
通过市场镜像快速部署OpenClaw
手动部署OpenClaw
自助建站
搭建环境
搭建应用
搭建网站
管理Linux实例软件源
性能测试
实例配置
搭建Windows操作系统AD域服务
Windows多用户登录
实例数据
监控
镜像
Linux内核调优
故障处理
远程登录问题
Linux操作系统问题
Windows操作系统问题
操作系统问题
veLinux操作系统问题
Linux操作系统问题
Windows操作系统问题
制作自定义镜像问题
实例无法启动问题
实例负载高问题
网络连接问题
存储类问题
云盘问题
第三方软件问题
API参考
实例
镜像
高性能计算集群
密钥对
标签
云盘
预留存储容量包
快照
自动快照策略
监控
部署集
启动模版
云助手
补丁管理
专有宿主机DDH
产品动态
图说专有宿主机
用户指南
API参考
专有宿主机
相关视频
- 文档首页
 云服务器云服务器ECS最佳实践自助建站AIGC实践搭建SDXL-Turbo模型文生图推理
 复制全文
 下载 pdf
搭建SDXL-Turbo模型文生图推理
 文档反馈
 问问助手
本文主要介绍如何在云服务器实例中部署Stable Diffusion XL Turbo模型,并使用CPU加速文生图推理。
功能特色
本实践使用了火山引擎第3代云服务器通用型g3i,该规格实例采用火山引擎自研最新DPU架构并搭载了第5代英特尔®至强®可扩展处理器(Emerald Rapids,EMR),结合新一代硬件AI加速指令AMX-BF16(Intel Advanced Matrix Extensions)以及基于其上的IPEX框架优化,实现了系统级优化方案来加速SDXL-Turbo模型的文生图推理速度。
背景信息
IPEX
Intel® Extension for PyTorch(IPEX)是由Intel开源并维护的一个PyTorch扩展库,大幅度提升了使用PyTorch在Intel处理器上运行AI应用,尤其是深度学习应用的性能。Intel正不断为PyTorch贡献IPEX的优化性能,为PyTorch社区提供最新的Intel硬件和软件改进。更多信息,请参见IPEX。
SDXL-Turbo模型
本实践使用的推理模型为SDXL-Turbo(Stable Diffusion XL Turbo),该模型是Stability AI在Stable Diffusion基于SDXL 1.0的蒸馏(Distillation)版本,专为实时合成的文生图场景服务。该模型能够确保即使在一到两个采样步骤,也能保持高的图片质量。
操作步骤
步骤一:环境准备
- 创建搭载了第5代英特尔®至强®可扩展处理器(Emerald Rapids,EMR)实例,详细操作请参见购买云服务器。
- 创建实例时,请注意以下配置:
- 实例规格:本文选择通用型g3i(ecs.g3i.8xlarge)规格。
- 云盘:推荐云盘容量不低于60GiB。
- 镜像:本文选择Ubuntu 22.04 LTS 64位。
- 网络:需要绑定公网IP,操作详情可查看绑定公网IP。
- 为目标实例安装Docker。
说明
请确保Docker版本不低于19.03,且DOCKER_BUILDKIT=1。
步骤二:部署SDXL-Turbo模型
- 登录目标实例。
- 下载SDXL-Turbo模型。
- 执行如下命令,创建存放模型的目录。
- mkdir models
- 执行如下命令,进入该目录。
- cd models/
- 下载所需工具与模型。
说明
- pip install -U huggingface_hub hf_transfer HF_ENDPOINT=https://hf-mirror.com HF_HUB_ENABLE_HF_TRANSFER=1 huggingface-cli download --resume-download stabilityai/sdxl-turbo --local-dir sdxl-turbo --local-dir-use-symlinks=False
- 将如下文件上传至在SDXL-Turbo模型同级目录下。操作详情可查看本地数据上传。
- Dockerfile
- run_local.sh
- sd_pipe_sdxl_turbo.py
说明
- pipeline_stable_diffusion_xl_ipex.py
说明
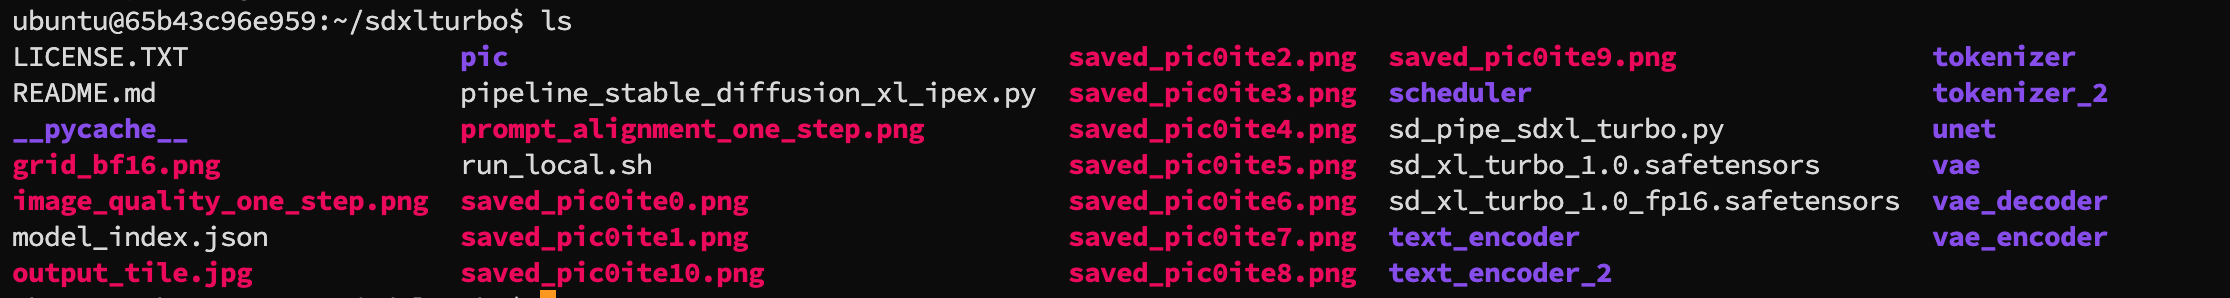
- 完成上传后,文件结构如下如图所示。
-

- 在Dockerfile文件同级目录下,执行如下命令,制作Docker镜像。
- docker build -t sdxl:v1 .
- 执行如下命令,运行Docker。
- docker run --name sdxl --privileged=true -v /root/models:/models -it sdxl:v1 bash
步骤三:运行SDXL-Turbo模型
- 登录目标实例。
- 在容器sdxl的交互模式中,执行如下命令,进入模型目录。
- cd sdxlturbo
- 执行如下命令,通过脚本进行文生图推理测试。
- sh run_local.sh
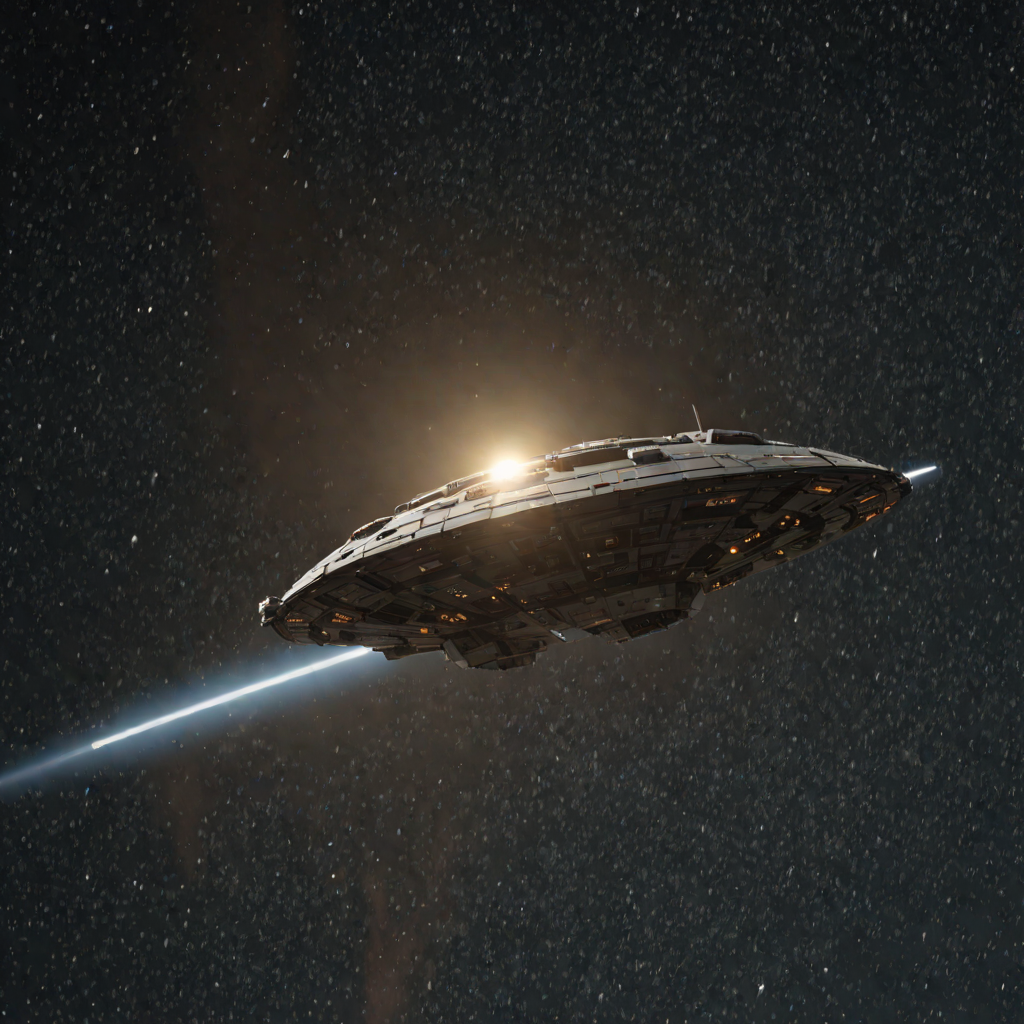
- 生成图片示例:
- 在Docker容器中,推理生成的图片将以saved_pic0ite$Nubmer$.png格式命名。
-
-
- 后续您可以使用如下命令,继续文生图推理。
- numactl --localalloc --physcpubind=48-71 python sd_pipe_sdxl_turbo.py --height 512 --width 512 --repeat 11 --step 4 --bf16 --prompt "A spaceship traveling through the stars. highly detailed, 8k"
- 参数说明
- numactl命令参数
- 参数名说明取值样例--localalloc指定使用本地内存分配器,而不是默认的系统内存分配器。---physcpubind指定物理CPU的绑定范围,以提高程序的运行效率。48-71
- 模型运行参数
- 参数名说明取值样例--bf16表示是否启用BF16精度模式。说明
- 推荐您启用BF16精度模式。启用后,可使用AMX指令集加速文生图推理,否则不会使用AMX指令集进行推理加速。
- 传递本参数表示启用BF16精度模式,不传递表示不启用。
--bf16--batchint,表示批处理大小,默认值为1。1--heightint,表示图像高度,单位像素,默认值为512。说明512--widthint,表示图像宽度,单位像素,默认值为512。说明512--stepint,表示旋转循环的步长,默认值为4。4--repeatint,表示推断的重复次数,默认值为3。11--promptString,表示生成图片的内容,默认值为beautiful beach with white sands, trophical island, coconat tree, a beautiful boat on the beach, moon night, 8k。A spaceship traveling through the stars. highly detailed, 8k
性能说明
测试数据
本节展示了使用ecs.g3i.8xlarge规格实例,通过Stable Diffusion XL Turbo模型生成不同分辨率与数据精度图片的耗时信息。
说明
下表测试数据仅做参考,实际数据可能会因您的操作环境而发生变化,请以实际情况为准。
实例规格 | 数据精度 | 参数 | 单次平均耗时 (512x512) | 单次平均耗时 (1024x1024) |
ecs.g3i.8xlarge (32 vCPU 128 GiB) | BF16 | batch: 1 step: 4 | 1.36s | 5.05s |
| FP32 | batch: 1 step: 4 | 4.86s | 17.37s |
测试结论
在搭载英特尔EMR处理器的ecs.g3i.8xlarge规格实例中,根据本实践调整后的文生图模型,可通过使能高级矩阵扩展加速引擎(AMX指令集)有效加速推理速度,最快可达 0.735 images/s,实现秒级生图性能。与未使用或不支持AMX指令集加速的实例相比,其文生成图性能可提升293% ~ 388%。
最近更新时间:2025.07.01 16:22:56
这个页面对您有帮助吗?
有用
有用
无用
无用