容器服务
容器服务
容器服务


文档指南
请输入


容器服务 VKE
产品动态
Kubernetes 版本发布记录
组件发布记录
监控组件
DNS 组件
GPU 组件
Sandbox 组件
安全公告
产品公告
历史公告
用户指南
集群
节点池
授权
网络
容器网络
服务(Service)
路由(Ingress)
APIG Ingress
ALB Ingress
自定义转发规则配置示例
CLB Ingress
Nginx Ingress
Gateway API
工作负载
存储
数据管理中心(DMC)
对象存储(TOS)
FSX 访问方式
文件存储(NAS)
FSX 访问方式
弹性文件存储(EFS)
文件存储(vePFS)
FSX 访问方式
vePFS Client 访问方式
NFS 访问方式
大数据文件存储(CloudFS)
弹性伸缩
工作负载弹性伸缩
事件驱动伸缩(KEDA)
组件管理
网络组件
监控组件
DNS 组件
GPU 组件
Sandbox 组件
异构计算
调度管理
可观测性
基础观测
诊断与巡检
最佳实践
网络
可观测性
安全合规
API 参考
集群管理
节点池管理
组件管理
机型镜像管理
云原生观测
巡检诊断
弹性容器实例
附录
开发指南
常见问题
通用 FAQ
集群 FAQ
集群管理
集群升级
节点与节点池 FAQ
授权 FAQ
工作负载 FAQ
服务与路由 FAQ
存储 FAQ
弹性伸缩 FAQ
可观测性 FAQ
配额 FAQ
组件 FAQ
容器镜像 FAQ
AI 云原生
推理套件
Helm 模板 AI 应用
Deepseek 实践
Qwen 实践
最佳实践
MiniMax 模型部署
Qwen 模型部署
弹性容器实例 VCI
最新动态
用户指南
虚拟节点
VKE 集群使用虚拟节点
自建/跨云集群使用虚拟节点
创建 VCI 实例
VCI Agent Sandbox
安全合规
- 文档首页
 容器服务容器服务 VKE用户指南可观测性基础观测存储观测CSI 存储观测
 复制全文
 下载 pdf
CSI 存储观测
 文档反馈
 问问助手
容器服务支持采集和展示集群中 CSI 存储组件的运行状态、请求性能及异常数据,帮助您及时发现存储服务问题。本文介绍 CSI 存储观测的启用与配置方法,以及监控指标的含义和异常判断方式。
前提条件
- 已开启云原生观测功能,详情请参见 开启观测。
- 已开启容器服务观测功能,详情请参见 容器服务观测。
- 已安装待观测的组件,详情请参见 csi-ebs、csi-fsx、csi-nas、csi-vepfs 和 snapshot-controller。
开启观测
步骤一:配置观测项
- 登录 容器服务控制台。
- 在左侧导航栏单击 集群,找到目标集群,单击集群名称。
- 在集群管理页面的左侧导航栏中,单击 观测配置,并选择 基础观测 页签。
- 选择 CSI 存储 卡片,单击 启用观测,进入观测项配置页面。
- 系统自动检查开启观测所需的必要条件,包括工作区配置、组件状态等。
-
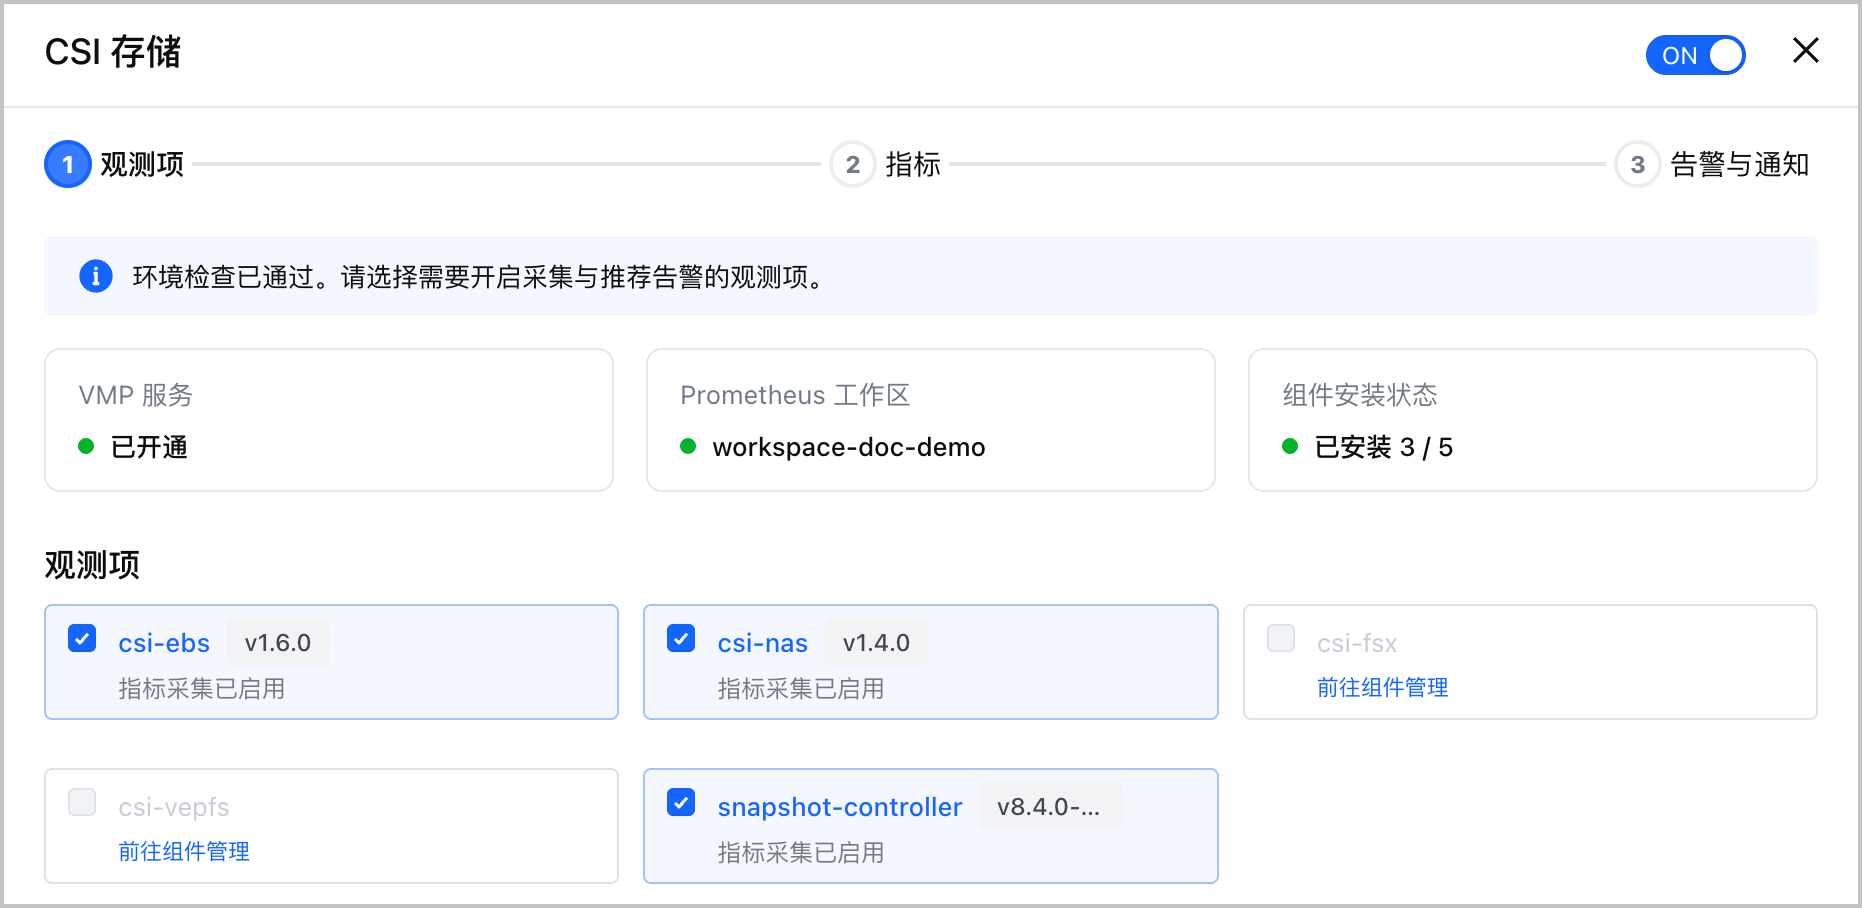
- 在 观测项 配置中,勾选启用需要采集指标的观测项。对于未启用的配置项,系统不会采集对应的指标,同时系统会提示组件安装,您可根据自身情况决定是否安装相关组件并启用对应的观测项。
- 配置完成后,单击 下一步,进入指标配置页面。
步骤二:配置指标采集
- 在指标配置页面中,查看已开启观测项对应的采集间隔和指标数量。
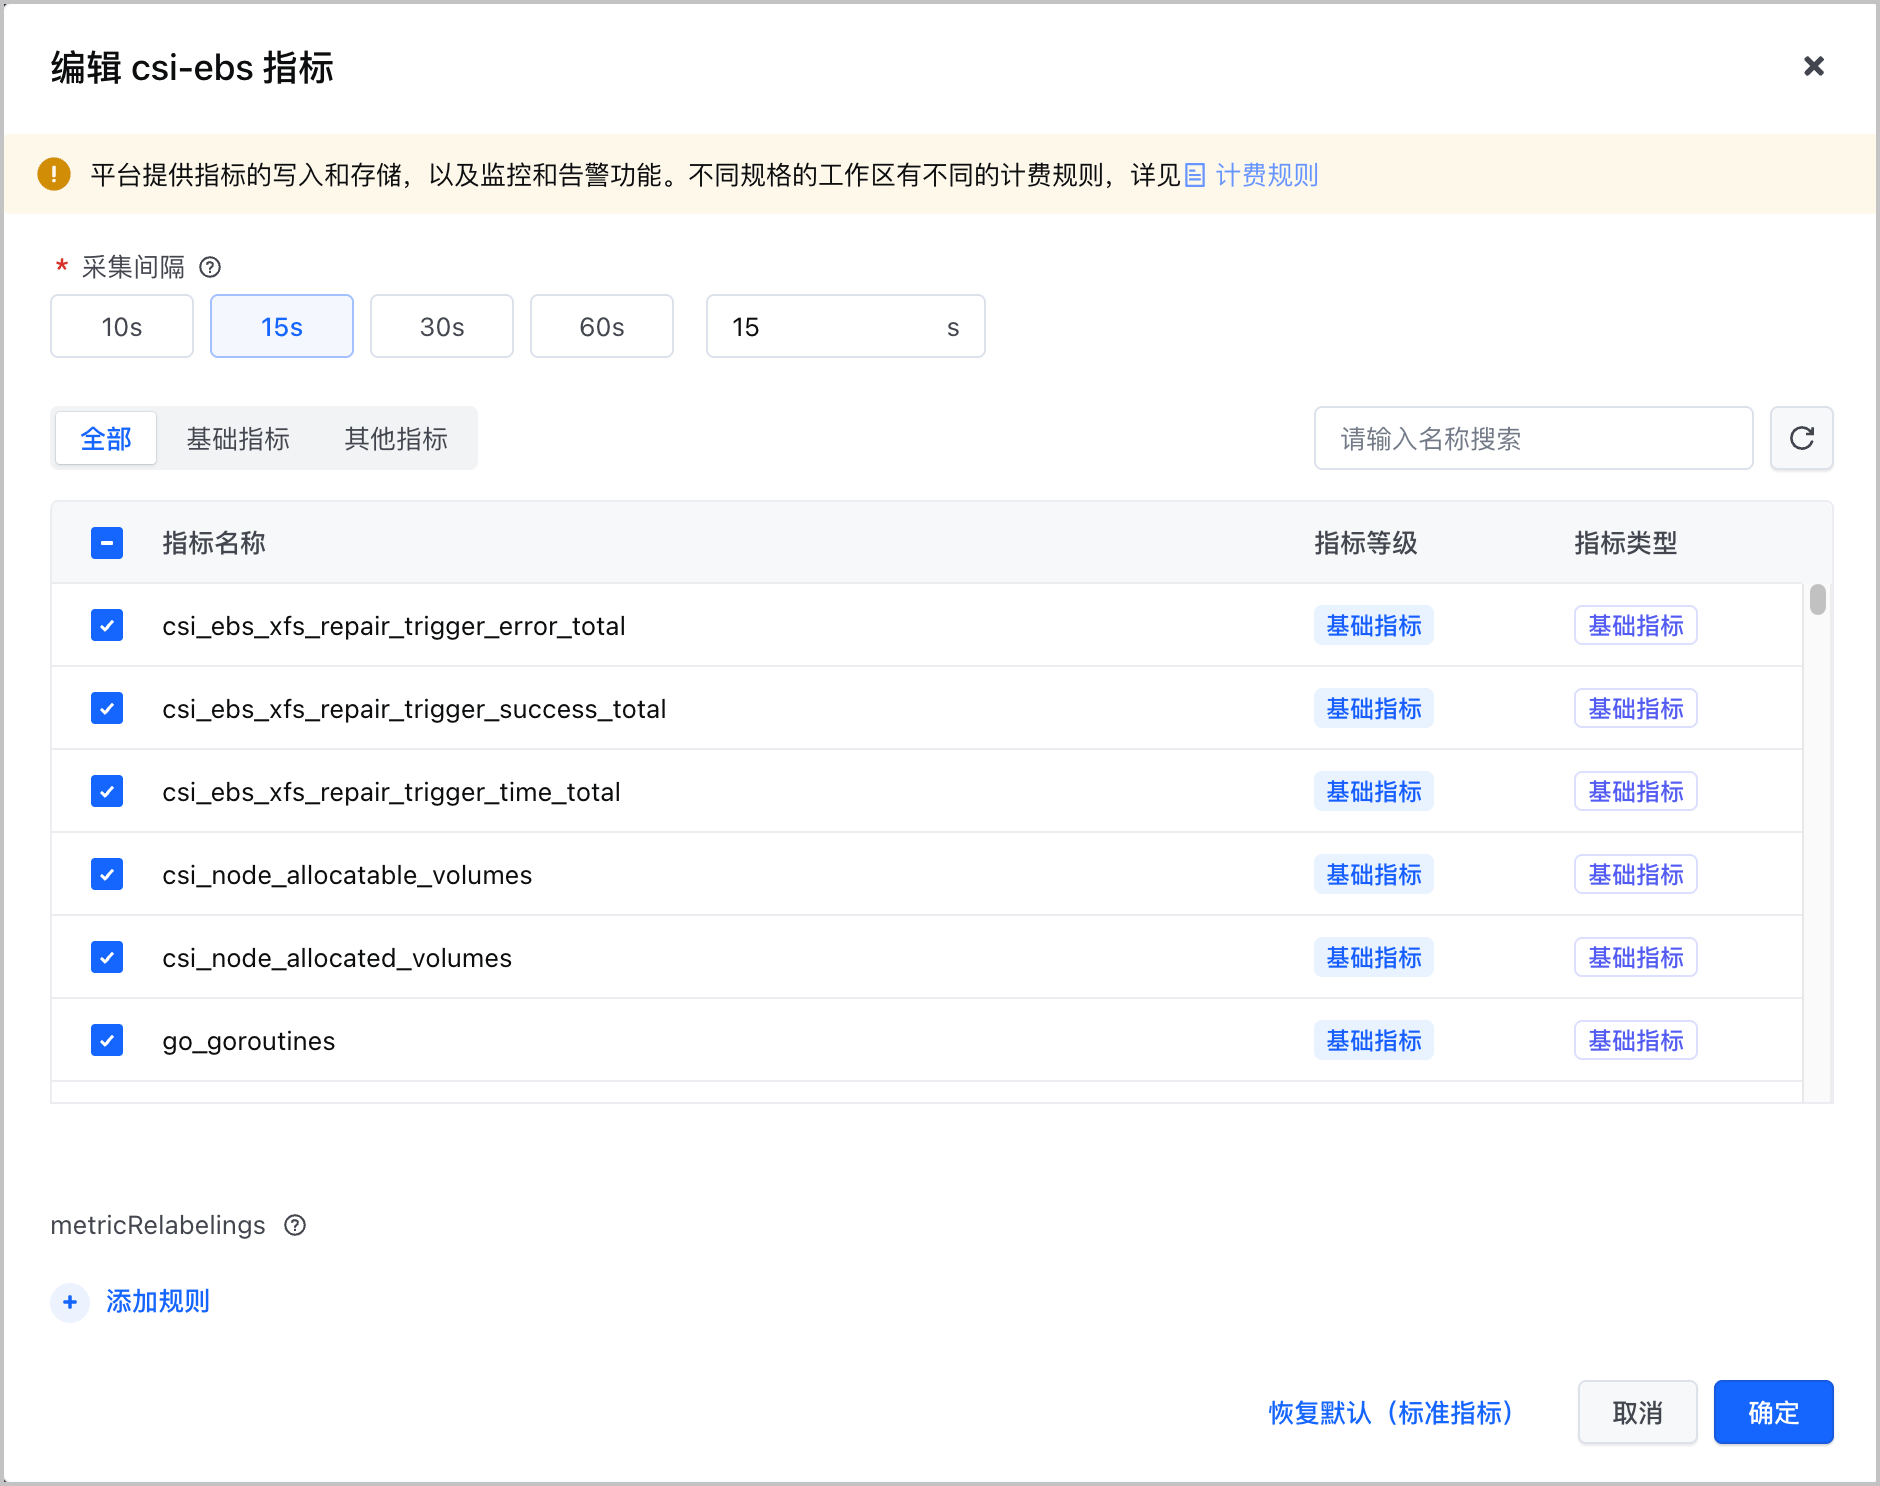
- 单击 编辑指标,支持选择或丢弃组件的具体指标、修改采集间隔和指标 Relabel。
- 在 采集间隔 中,选择该组件指标的采集间隔。不同组件支持的采集间隔不同。
- 在 指标列表 中,勾选指标,则采集该指标。取消勾选,则丢弃该指标。单击 全部、基础指标 或 其他指标 页签,允许基于指标类型对指标项进行筛选。
-
说明
- 调整指标采集间隔的影响如下,请按需调整:
- 减小采集间隔:增加单位时间内上报的指标数量,提升监控精度,但 VMP 标准版工作区的费用会增加。
- 增加采集间隔:减少单位时间内上报的指标数量,降低 VMP 标准版工作区的费用,但监控精度会降低。
- 云产品的指标类型分为 基础指标 和 其他指标,不同类型指标的计费方式不同,详情请参见 托管 Prometheus 计费方式。
- 在 metricRelabelings 中,单击 添加规则,配置指标 Relabel 规则。允许在指标完成采集后、写入存储前,对每条指标的标签执行改写操作。常见用途包括修改标签值、新增标签或重命名标签,便于在查询时统一标签口径。更多详情介绍,请参见 指标 Relabel。
-
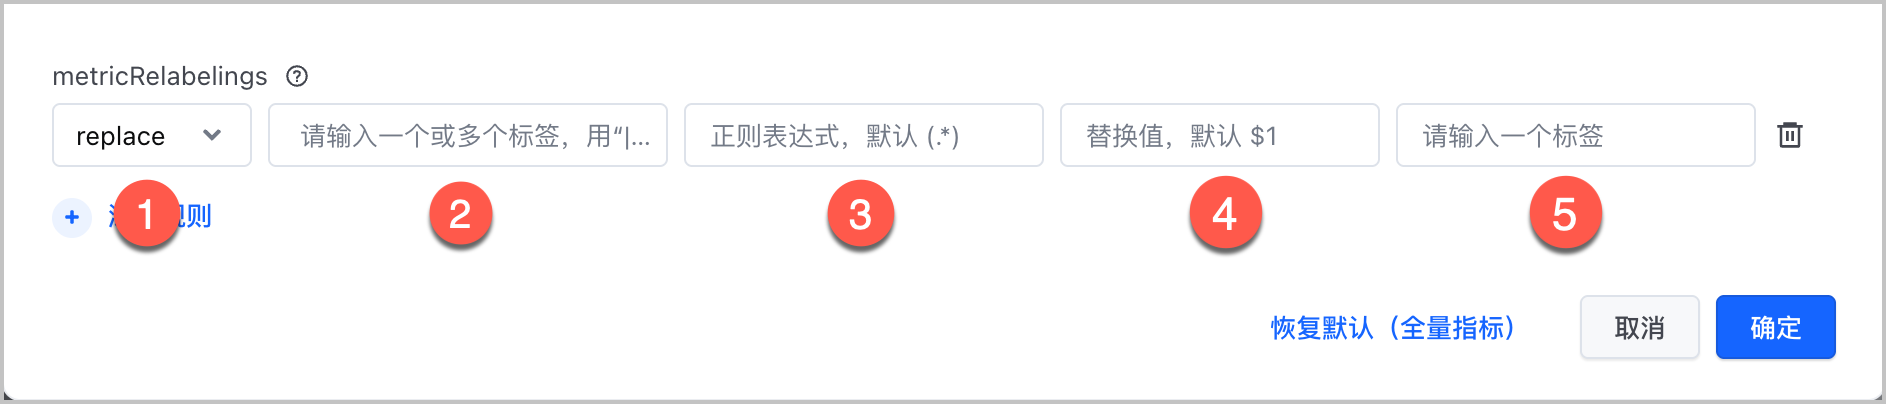
- 序号功能对应 YAML 字段说明序号功能对应 YAML 字段说明①操作类型action对指标执行的操作类型,当前仅支持 replace,生效逻辑如下:
- 如果targetLabel和sourceLabels的值一致,则表示覆盖sourceLabels。
- 如果targetLabel定义的 key 不存在,则会默认创建新的 label。
②源标签sourceLabels指定一个或多个来源标签,多个标签之间用|分隔。系统将读取这些标签的值进行匹配或提取。③正则表达式regex用于匹配源标签值的正则表达式。- 默认为(.*),表示匹配任意值。
- 支持使用捕获组,如(.+)提取部分内容。
④替换值replacement匹配成功后写入目标标签的值。- 默认为$1,表示取正则第一个捕获组的内容。
- 支持填入固定字符串。
⑤目标标签targetLabel将处理结果写入的目标标签名称。- 若目标标签已存在,则覆盖其原有值。
- 若目标标签不存在,则新增该标签。
- 配置完成后,单击 下一步,进入告警与通知配置页面。
步骤三:配置告警与通知
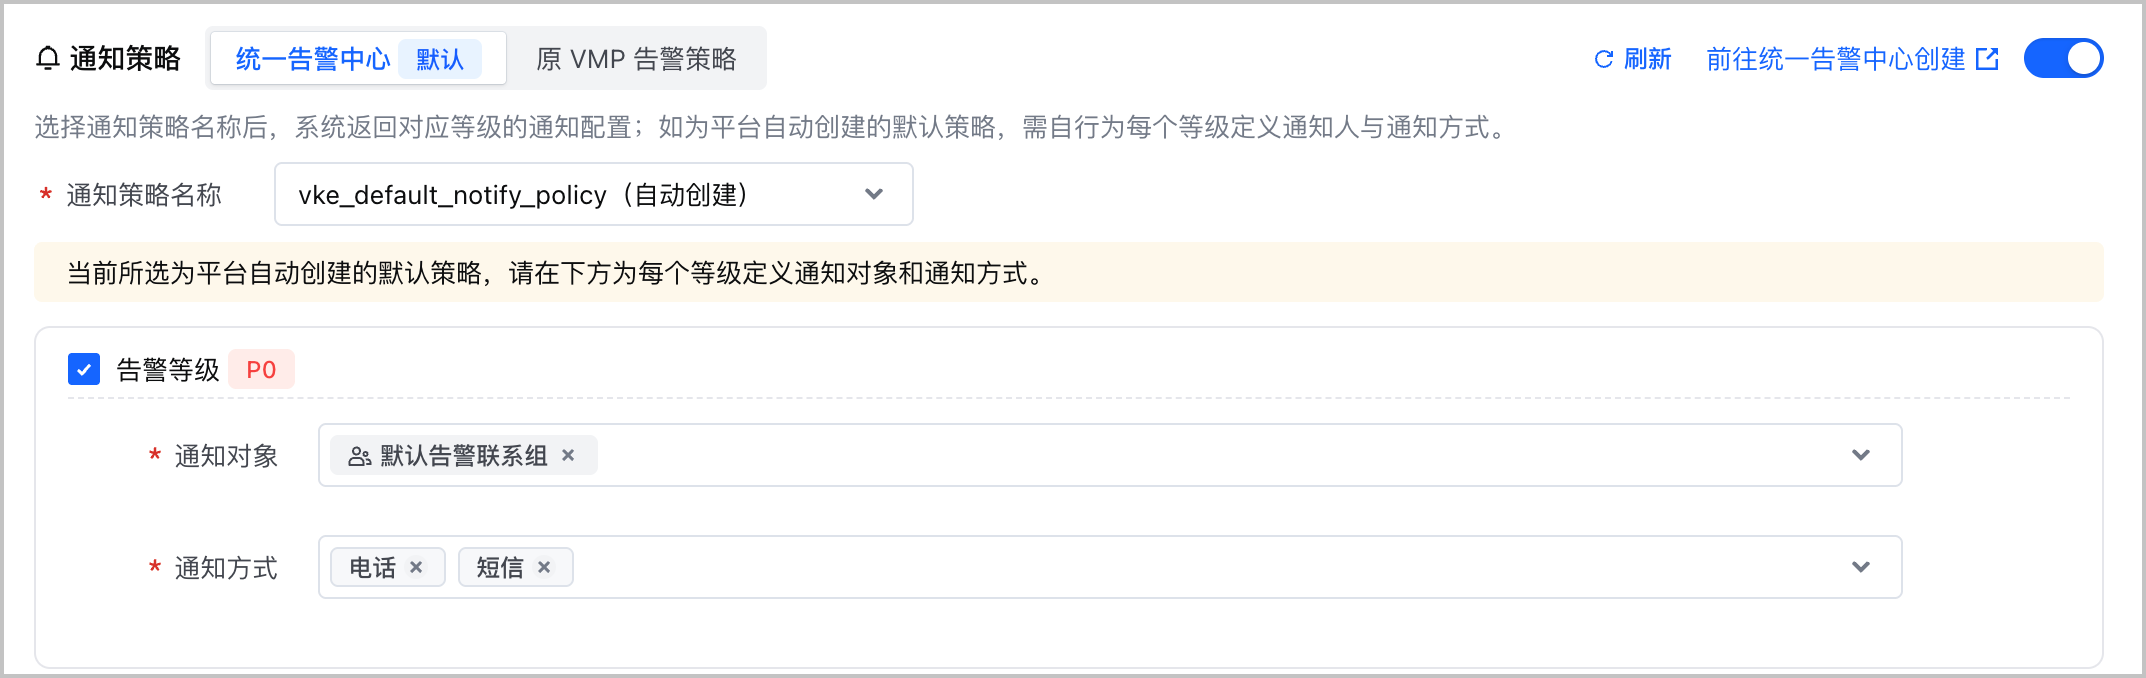
- 在 告警通知 选项中,选择接收告警的平台,当前支持 统一告警中心 和 原 VMP 告警策略。
- 在 通知策略名称 选项中,选择已创建的告警通知策略,并分别基于告警等级,配置不同级别告警的 通知对象 和 通知方式。
-
说明
- 若无需配置某个级别的告警,可以取消勾选对应的告警等级。
- 若当前已有的通知策略不满足需求,可以在 通知策略名称 中选择 vke_default_notify_policy(自动创建),并在下方为所需告警等级配置 通知对象 和 通知方式。保存后,系统将在统一告警中心或托管 Prometheus 中自动创建一条名称为 vke_default_notify_policy 的自定义通知策略。
- 在 告警聚合策略 选项中,选择已创建的告警聚合策略。
- 配置预置告警规则。
- 开启或关闭预置告警规则右侧的开关。开启后,系统按照配置的触发条件检测指标并产生告警;关闭后,该规则不再触发新的告警。
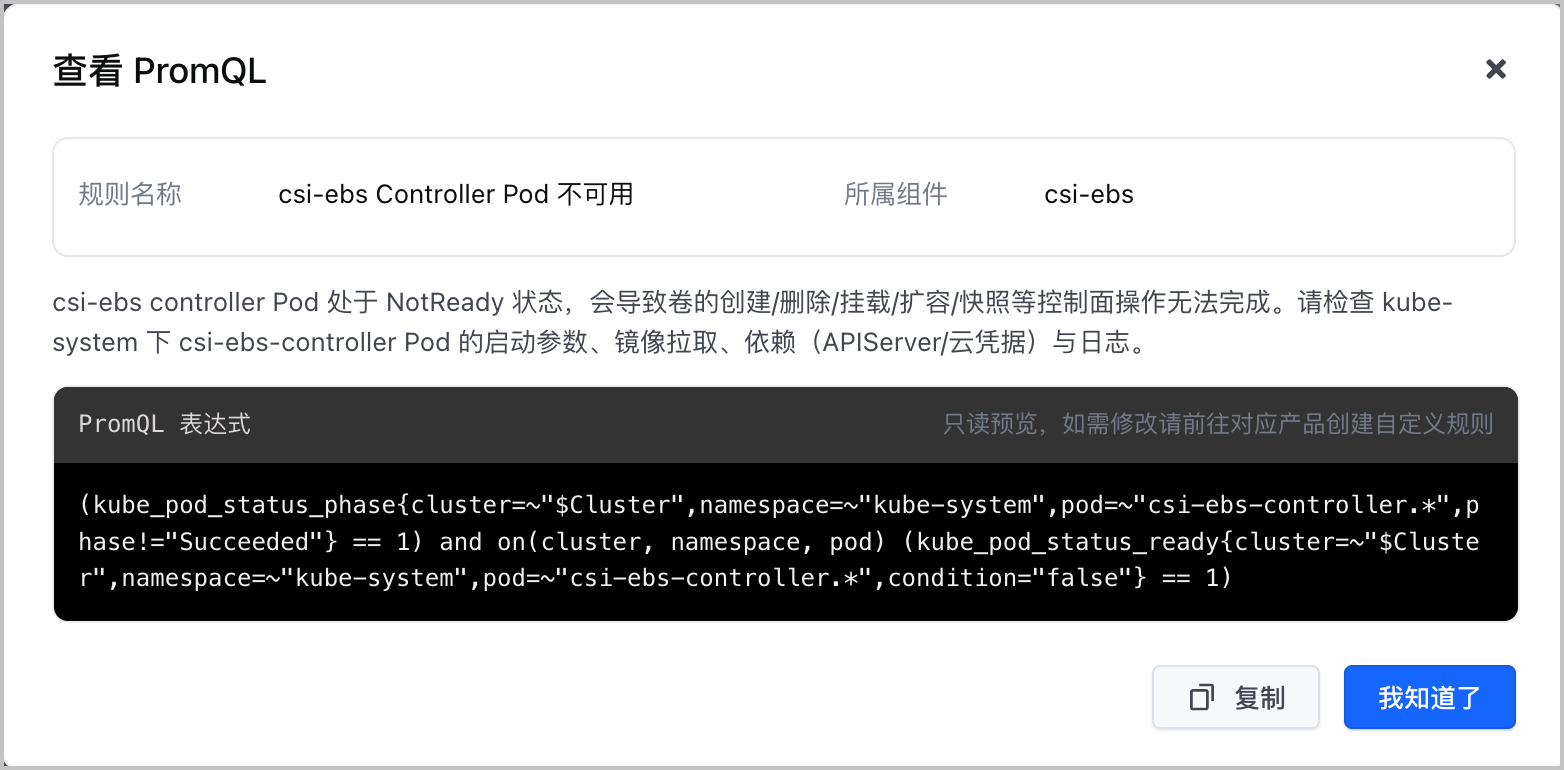
- 单击 查看 PromQL,支持查看当前预置告警规则的说明和对应的 PromQL 语句。
-
- 单击需要配置的预置规则名称,展开预置告警规则配置页面,在 触发条件 区域配置不同级别(P0、P1 或 P2)告警的触发条件。
-
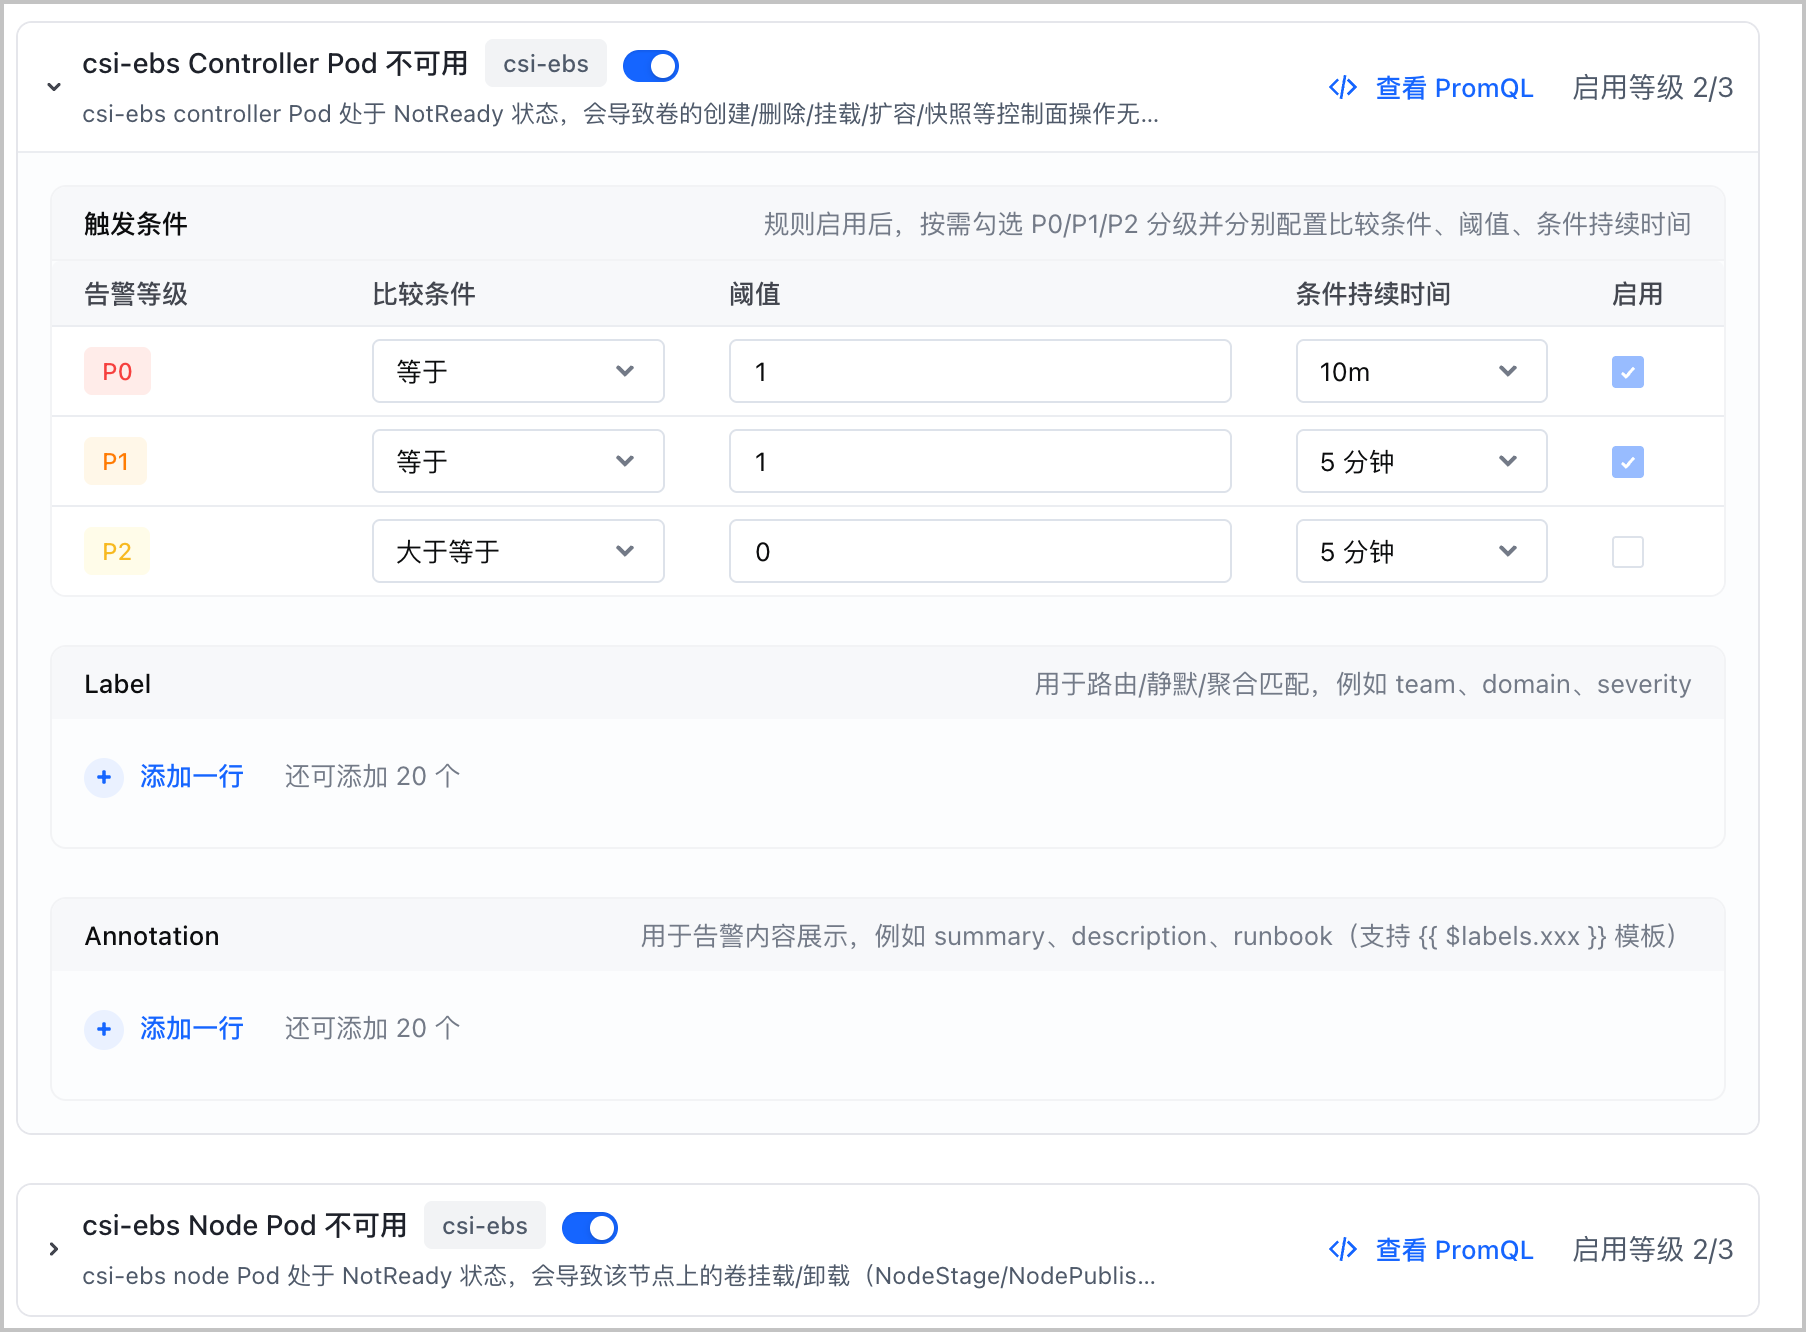
- 配置项说明配置项说明告警等级勾选不同告警等级(P0、P1 或 P2)后的 启用,使对应等级的触发条件生效。取消勾选,则表示不设定该等级的告警。比较条件指定 PromQL 语句和阈值之间的比较条件。支持配置多个比较条件,包括: 大于、大于等于、小于、小于等于、等于 和 不等于。阈值配置指标的阈值。条件持续时间配置指标持续满足触发条件的时长。只有指标在该时长内持续满足比较条件,系统才会触发对应等级的告警。Label配置告警规则的 Label,主要用于告警身份识别、分组、去重、路由匹配等。Label 由 Key 和 Value 组成。其中:
- Key:字符串形式,支持以字母或_开头,但不能以__开头。支持字母、数字和_,取值范围为 1~256。
- Value:字符串形式,支持中英文、数字和特殊字符,取值范围为 1~512。
常见配置示例:labels:severity: critical # 告警级别business: pay # 业务线alert_type: resource # 告警类型Annotation配置告警规则的 Annotation,主要用于关键信息展示。Annotation 由 Key 和 Value 组成。其中:- Key:字符串形式,支持以字母或_开头,但不能以__开头。支持字母、数字和_,取值范围为 1~256。
- Value:字符串形式,支持中英文、数字和特殊字符,取值范围为 1~512。
常见配置示例:annotations:summary: "High CPU usage on instance {{ $labels.instance }}"description: "Current CPU usage is {{ $value | humanizePercentage }}, threshold is 80%"runbook_url: "https://xxx/docs/cpu-alert"dashboard_url: "https://grafana/xxx"
- 单击 完成配置。
说明
- 除了直接使用预置告警模板配置告警规则,您可以自定义模板中的配置,或直接使用 PromQL 语句配置告警规则。详情请参见 告警配置概述。
- 预置告警规则模板的详情,包括规则说明、PromQL 配置和常见告警处理流程。请参见 预置告警模板。
观测看板
FSX 监控
开启 csi-fsx 组件监控后,您可以查看该组件的指标看板。支持设置查询的时间段,并指定刷新方式(手动刷新、自动刷新)。
- 在集群管理页面的左侧导航栏中,选择 监控中心 > 监控看板。
- 在左侧看板列表中选择 存储服务监控 > FSX 监控,即可查看监控看板。
-
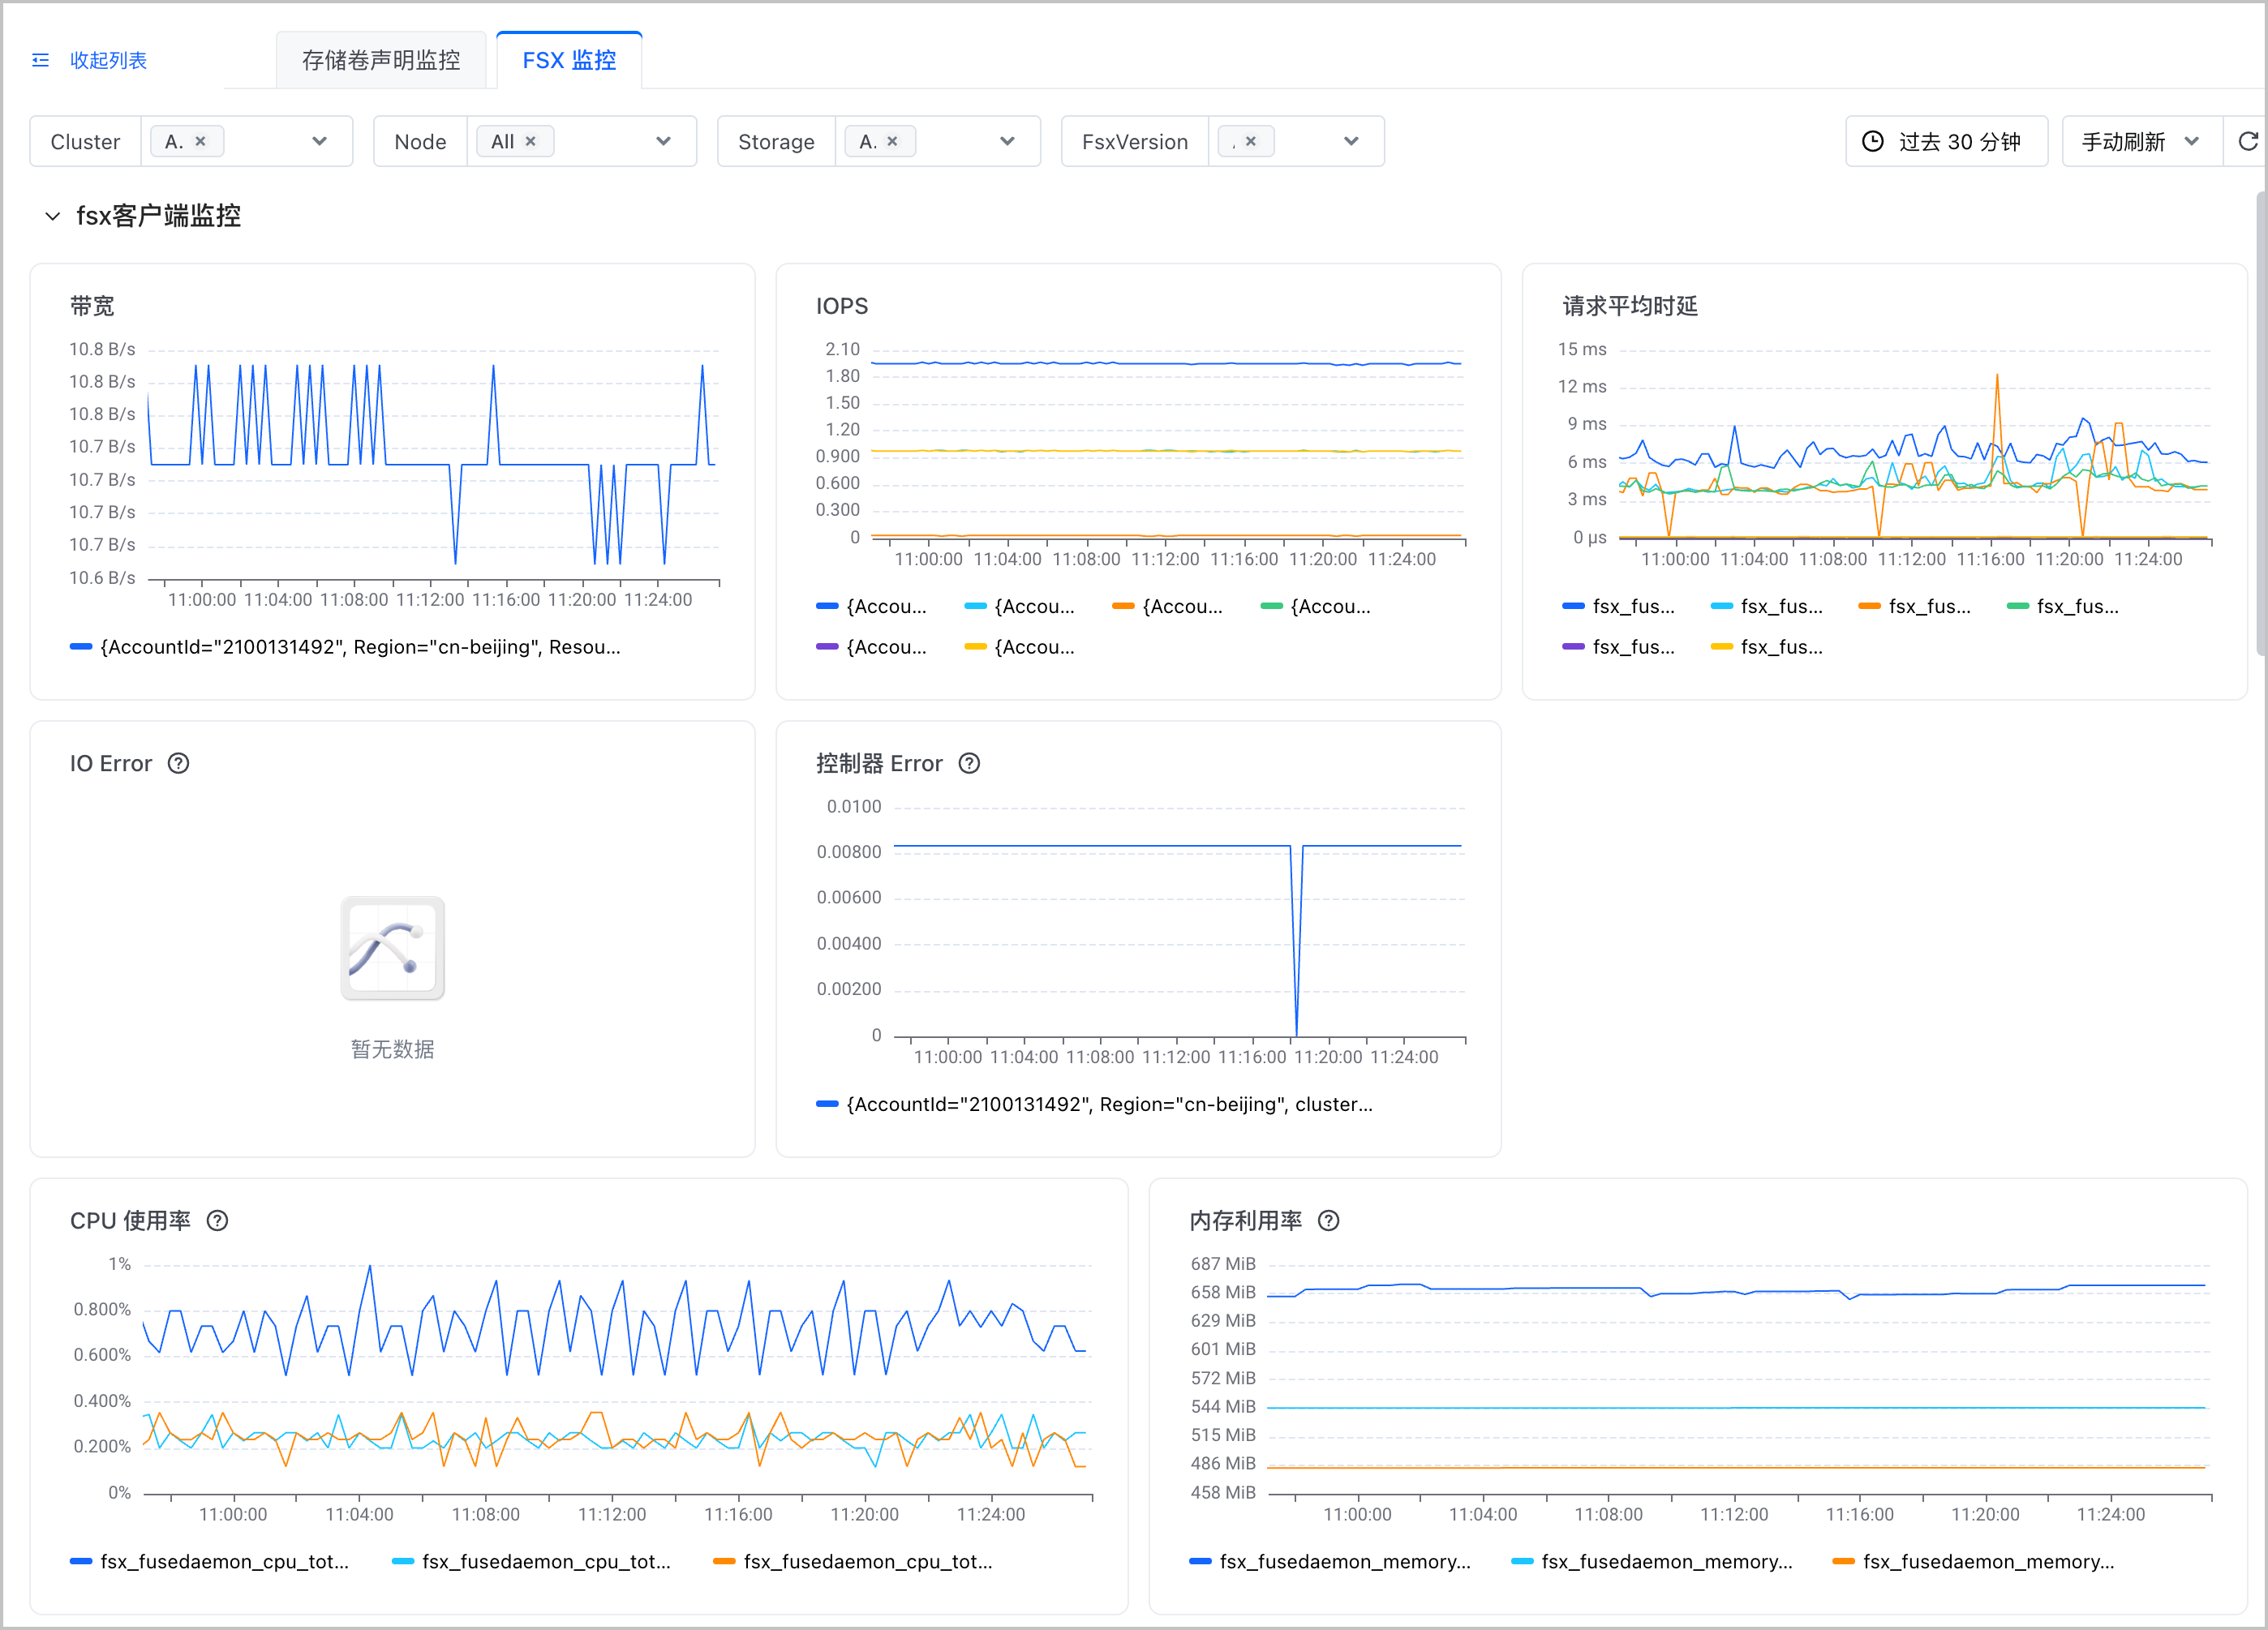
- csi-fsx 监控看板主要分为 3 个部分,分别面向 FSX 客户端监控、CSI 监控和 FSX 客户端升级监控。详细的图表说明,如下表所示。
说明
- 图表名称单位图表说明图表名称单位图表说明fsx 客户端监控带宽字节/秒FSX 客户端在各节点上的读写吞吐变化,帮助您识别整体负载趋势以及高吞吐热点节点。相关指标为fsx_fusedaemon_volume_throughput。
- 正常情况下,该指标应围绕业务基线波动;在批量读写、数据预热或集中任务执行时可短时上升,任务结束后回落。
- 如果带宽长期维持高位、突发尖峰频繁出现,或在业务持续存在时吞吐异常偏低,通常说明客户端负载或访问路径存在异常。例如:热点数据集中访问、单节点负载倾斜、下游存储性能抖动、网络链路波动、客户端处理能力不足等。
IOPS次/秒FSX 客户端的 IO 操作频次,帮助您判断请求是否集中、访问是否密集,以及不同节点的 IO 活跃度差异。相关指标为fsx_fusedaemon_op_ops。- 正常情况下,该指标应与业务访问节奏一致,整体围绕基线波动;业务高峰期可短时升高。
- 如果该指标持续高于历史基线、短时间内反复剧烈抖动,或在业务未下降时明显偏低,说明客户端侧可能存在读写压力异常或请求堆积。例如:业务突发放量、热点文件或卷集中访问、重试增多、客户端卡顿、存储端响应变慢等。
请求平均时延微秒FSX 客户端 IO 请求的平均时延,帮助您判断读写操作是否变慢。相关指标为fsx_fusedaemon_op_latency_us_avg。- 正常情况下,该指标应保持在较低水平,并围绕稳定基线小幅波动;高峰期可短时上升,但应能够回落。
- 如果时延持续上升、长时间维持高位,或在无明显流量变化时出现尖峰,说明客户端 IO 路径可能存在性能瓶颈。例如:存储端响应变慢、网络抖动、客户端资源争用、请求排队、异常重试增多等。
IO Error次/秒FSX 客户端在 IO 读写、挂载等场景中的错误速率,帮助您识别实际读写链路是否发生异常。相关指标为fsx_fusedaemon_op_failed_ops。- 正常情况下,该指标应不存在、接近 0 或偶发抖动后应快速恢复。
- 如果错误速率持续大于 0、周期性抬升或在多个实例上同时增加,说明客户端侧已出现可感知的 IO 异常。例如:挂载失败、读写超时、网络异常、后端存储不可达、权限或鉴权问题等。
控制器 Error次/秒FSX 客户端控制器侧的错误速率,帮助您识别 OOM、鉴权失败、异常重启等控制面问题。相关指标为fsx_fusedaemon_ctl_op_failed_ops。- 正常情况下,该指标应不存在或接近 0,不应持续出现错误。
- 如果错误速率持续上升,或在实例重启、鉴权刷新等时段集中爆发,说明控制器流程存在异常。例如:进程 OOM、鉴权失败、配置错误、异常重启、依赖服务不可用等。
CPU 使用率%FSX 客户端的 CPU 使用率,帮助您判断客户端是否存在资源压力。相关指标为fsx_fusedaemon_cpu_total_usage_percent。- 正常情况下,该值仅会围绕一个 “基线值” 小幅波动,无持续上涨或突发峰值。仅在读写高峰或集中任务执行时可短时升高,随后回落。
- 如果 CPU 持续高占用且不回落,或频繁出现明显尖峰,说明客户端存在持续计算压力或异常循环处理。例如:请求量骤增、异常重试、客户端线程忙等、数据处理放大、资源配置不足等。
内存利用率MiBFSX 客户端的内存使用量,帮助您判断客户端是否存在内存压力或泄漏风险。相关指标为fsx_fusedaemon_memory_usage_bytes。- 正常情况下,该值仅会围绕一个 “基线值” 小幅波动,无持续上涨或突发峰值。仅在业务高峰期短时上升,随后逐步回落。
- 如果内存持续上涨、长期不回落,或突然出现大幅峰值,说明客户端存在内存异常风险。例如:请求堆积、缓存膨胀、异常重试、进程泄漏、节点可用内存不足等。
客户端数量个统计当前筛选条件下的客户端实例数量,帮助您判断受影响节点规模和覆盖范围。- 一般情况下, FSX 客户端按需在节点上部署,因此每个节点上最多只有一个实例。
- 如果实例数量突然下降、持续低于预期,或短时间内异常波动,说明部分节点上的客户端可能未正常运行。例如:节点异常下线、客户端 Pod 未就绪、组件部署失败、版本升级中断等。
客户端版本-使用表格形式展示各实例上的客户端版本分布,帮助您定位 FSX 客户端的版本不一致、灰度范围和问题实例。表格中包括如下关键字段cluster(集群 ID)、instance(节点名称)、instance_id(ECS 实例 ID)、version(FSX 客户端版本),便于排查版本差异。- 正常情况下,版本分布应符合当前发布策略;非灰度、差异化配置场景下,所有节点上的版本应保持一致。
- 如果出现大量版本分支、少量旧版本长期滞留,或问题节点集中在特定版本,说明版本治理存在问题。例如:升级未完成、灰度残留、节点升级失败、回滚未收敛、实例长期未重建等。请考虑将版本尽快收敛至稳定版本。
CSI 监控csi-fsx 每分钟收到请求频率每秒请求数csi-fsx 服务端接收请求的速率,帮助您判断服务端负载变化和请求分布。支持按照 method、instance 维度分类展示。相关指标为fsx_server_rpc_total。- 正常情况下,该指标应与挂载、卸载 FSX 存储卷的次数成正比,并围绕历史基线波动。
- 如果请求频率持续高于基线、多个实例同时抬升,或某个实例显著高于其他实例,说明短期内有大量使用 FSX 的业务 Pod 创建或删除。
csi-fsx RPC 层错误频率每秒请求数csi-fsx 服务端 RPC 层的错误速率,支持按照 method、code、instance 维度分类展示。相关指标为fsx_server_rpc_error_total。- 正常情况下,该指标应不存在或接近 0,不应持续出现错误码。
- 如果某类错误码持续出现,或多个方法同时出现错误速率上升,说明服务端处理链路存在异常。例如:挂载参数不符合预期、挂载使用 AKSK 权限不足,STS 过期等。
csi-fsx 处理请求时延 [P90]秒csi-fsx 服务端处理请求的 P90 时延,帮助您判断服务端是否出现普遍变慢。支持按照 method、instance 维度分类展示。相关指标为fsx_server_rpc_time_bucket。- 正常情况下,该指标应保持在稳定水平;业务高峰期可短时上升,但应随负载回落。
- 如果时延持续升高、长时间高于基线,或与请求频率同时抬升,说明服务端处理能力、依赖链路存在瓶颈,或挂载后端存在异常持续重试。
fsx-agent 每分钟收到请求频率次/时间段节点侧 FSX 客户端的 RPC 调用活跃度,帮助您判断节点侧请求是否集中或异常放量。支持按照 method、instance 维度分类展示,默认排除 Status 接口。相关指标为fsx_agent_pod_rpc_total。- 正常情况下,该指标应随节点业务活跃度变化而波动,并与实际操作量基本一致。
- 如果请求频率在多个节点持续升高,或单节点明显高于同类节点,说明节点侧可能存在异常请求放大。
fsx-agent 响应失败频率每秒请求数节点侧 FSX 客户端 RPC 调用失败情况,帮助您快速定位失败节点和失败方法。支持按照 method、code、instance 维度分类展示。相关指标为fsx_agent_pod_rpc_error_total。- 正常情况下,该指标应不存在或接近 0。
- 如果某个节点或某类方法的失败频率持续增加,说明节点侧处理流程存在异常。
fsx-agent 处理请求时延 [P90]秒节点侧 FSX 客户端处理请求的 P90 时延,帮助您判断节点侧是否出现慢请求。支持按照 method、instance 维度分类展示。相关指标为fsx_agent_pod_rpc_time_bucket。- 正常情况下,该指标应维持在较低且稳定的水平,偶发抖动后可恢复。
- 如果时延持续升高、在多个节点同时抬升,或长期无法回落,说明节点侧处理链路存在性能问题。
fsx-agent 生命周期接口请求频率每秒请求数FSX 客户端生命周期动作(安装、挂载、卸载等)的调用速率,帮助您识别生命周期操作是否集中发生。支持按照 method、instance 维度分类展示。相关指标为fsx_agent_pod_lifecycle_total。- 正常情况下,该指标应与集群内卷挂载、卸载、重建等操作节奏一致,业务平稳时通常较低。
- 如果请求频率持续偏高,或短时间内大幅增加,说明生命周期动作正在密集发生。
fsx-agent 生命周期接口请求次数次/时间段FSX 客户端在查询时间窗内,生命周期动作(安装、挂载、卸载等)的累计次数,帮助您评估某一时间段内节点侧变更规模。支持按照 method、instance 维度分类展示,默认排除 Status 接口。相关指标为fsx_agent_pod_lifecycle_total。- 正常情况下,该指标应与预期的运维操作或业务变更规模相匹配。
- 如果在短时间窗内请求次数明显放大,或长期高于历史同类时段,说明生命周期动作可能过于频繁。
fsx-agent 生命周期接口时延 [P90]秒FSX 客户端生命周期动作(安装、挂载、卸载等)执行的 P90 时延,帮助您判断安装、挂载、卸载等流程是否变慢。支持按照 method、instance 维度分类展示。相关指标为fsx_agent_pod_lifecycle_time_bucket。- 正常情况下,该指标应保持稳定;在批量操作期间可短时升高,但应在操作完成后恢复。
- 如果时延持续升高,或与生命周期请求量增加同时出现,说明相关动作处理流程存在瓶颈。
fsx-agent 生命周期接口异常频率每秒请求数FSX 客户端生命周期动作(安装、挂载、卸载等)失败的错误速率,帮助您判断安装、挂载、卸载等关键动作是否执行失败。并按 method、instance 维度分类展示。相关指标为fsx_agent_pod_lifecycle_error_total。- 正常情况下,该指标应不存在或接近 0。
- 如果错误速率持续大于 0,或在批量生命周期操作期间显著抬升,说明节点侧生命周期流程已出现异常。
fsx鉴权 secret 总数个鉴权 Secret 当前存量,帮助您判断凭证对象数量是否与实际使用规模匹配。相关指标为fsx_credential_secret_total。- 正常情况下,该指标应与节点侧实际挂载规模、客户端数量相匹配,并保持相对稳定。
- 如果 Secret 总数持续增长且不回落,或显著高于预期规模,说明节点侧可能存在凭证堆积。例如: 旧凭证未清理、生命周期回收异常、重复创建、刷新流程异常、节点长期残留对象等。
已过期的 secret 总数个已过期鉴权 Secret 的存量,帮助您识别凭证过期后是否存在积压风险。相关指标为fsx_credential_secret_expired_total。- 正常情况下,该指标应保持在较低水平,理想情况下接近 0。
- 如果过期 Secret 数量持续增加或长时间不下降,说明过期凭证未被及时替换或清理。
fsx secret 刷新频率次/时间段各刷新阶段 Secret 的执行次数,帮助您判断刷新流程是否按预期运行。相关指标为fsx_credential_secret_refresh_total。- 正常情况下,该指标应与凭证有效期和实例规模相匹配,在固定周期内平稳出现。
- 如果刷新频率异常升高、集中在某一阶段,或长期低于预期,说明刷新流程可能存在异常。
fsx secret 刷新耗时秒各刷新阶段的 P90 耗时,帮助您定位哪个刷新阶段出现性能瓶颈。相关指标为fsx_credential_secret_refresh_time_bucket。- 正常情况下,该指标应在稳定区间内波动,不同阶段之间可存在固定差异,但整体应可预测。
- 如果某一阶段耗时持续升高,或多个阶段同时变慢,说明 Secret 刷新链路存在处理延迟。
fsx secret 刷新失败频率每秒请求数Secret 刷新失败的错误速率,帮助您判断凭证续期链路是否稳定。相关指标为fsx_credential_secret_refresh_error_total。- 正常情况下,该指标应不存在或接近 0。
- 如果错误速率持续增加,或集中出现在特定 stage、特定节点,说明 Secret 刷新流程存在明确故障点。
fsx-agent 升级监控节点 fsx-agent 升级次数次/时间段FSX 客户端升级次数,帮助您判断升级动作的覆盖范围和活跃度。支持按照 type、instance 维度分类展示,默认排除 Status 接口。相关指标为fsx_syncer_upgrade_total。- 正常情况下,该指标应与计划中的升级批次相匹配,非升级窗口通常较低或为 0。
- 如果非升级窗口内仍频繁出现升级次数,或同一节点重复出现升级动作,说明升级流程可能未收敛。例如:升级反复重试、节点反复重建、版本回滚后再次拉起、升级控制逻辑异常等。
节点 fsx-agent 升级时延 [P90]秒FSX 客户端升级流程的 P90 时延,帮助您判断升级执行是否变慢,以及是否存在长尾节点。支持按照 type、instance 维度分类展示。相关指标为fsx_syncer_upgrade_time_bucket。- 正常情况下,该指标应保持在稳定范围内,并与历史升级窗口表现基本一致。
- 如果时延持续升高、长尾节点明显增多,或升级窗口显著拉长,说明升级流程存在阻塞或性能问题。例如:节点负载高、镜像拉取慢、网络抖动、节点侧资源不足、升级步骤等待时间变长等。
节点 fsx-agent 升级失败次数次/时间段FSX 客户端升级失败的节点数量和失败次数,帮助您快速定位升级异常节点。支持按照 type、instance 维度分类展示。相关指标为fsx_syncer_upgrade_error_total。- 正常情况下,该指标应不存在或接近 0;批量升级期间可有少量瞬时失败,但应在重试后恢复。
- 如果失败次数持续增加、集中在同类节点,或升级窗口结束后仍未恢复,说明升级流程存在实际故障。例如:节点状态异常、资源不足、镜像拉取失败、升级脚本执行失败、依赖服务不可达等。
vePFS 监控
开启 csi-vepfs 组件监控后,您可以查看该组件的指标看板。支持设置查询的时间段,并指定刷新方式(手动刷新、自动刷新)。
- 在集群管理页面的左侧导航栏中,选择 监控中心 > 监控看板。
- 在左侧看板列表中选择 存储服务监控 > vePFS 监控,即可查看监控看板。
-
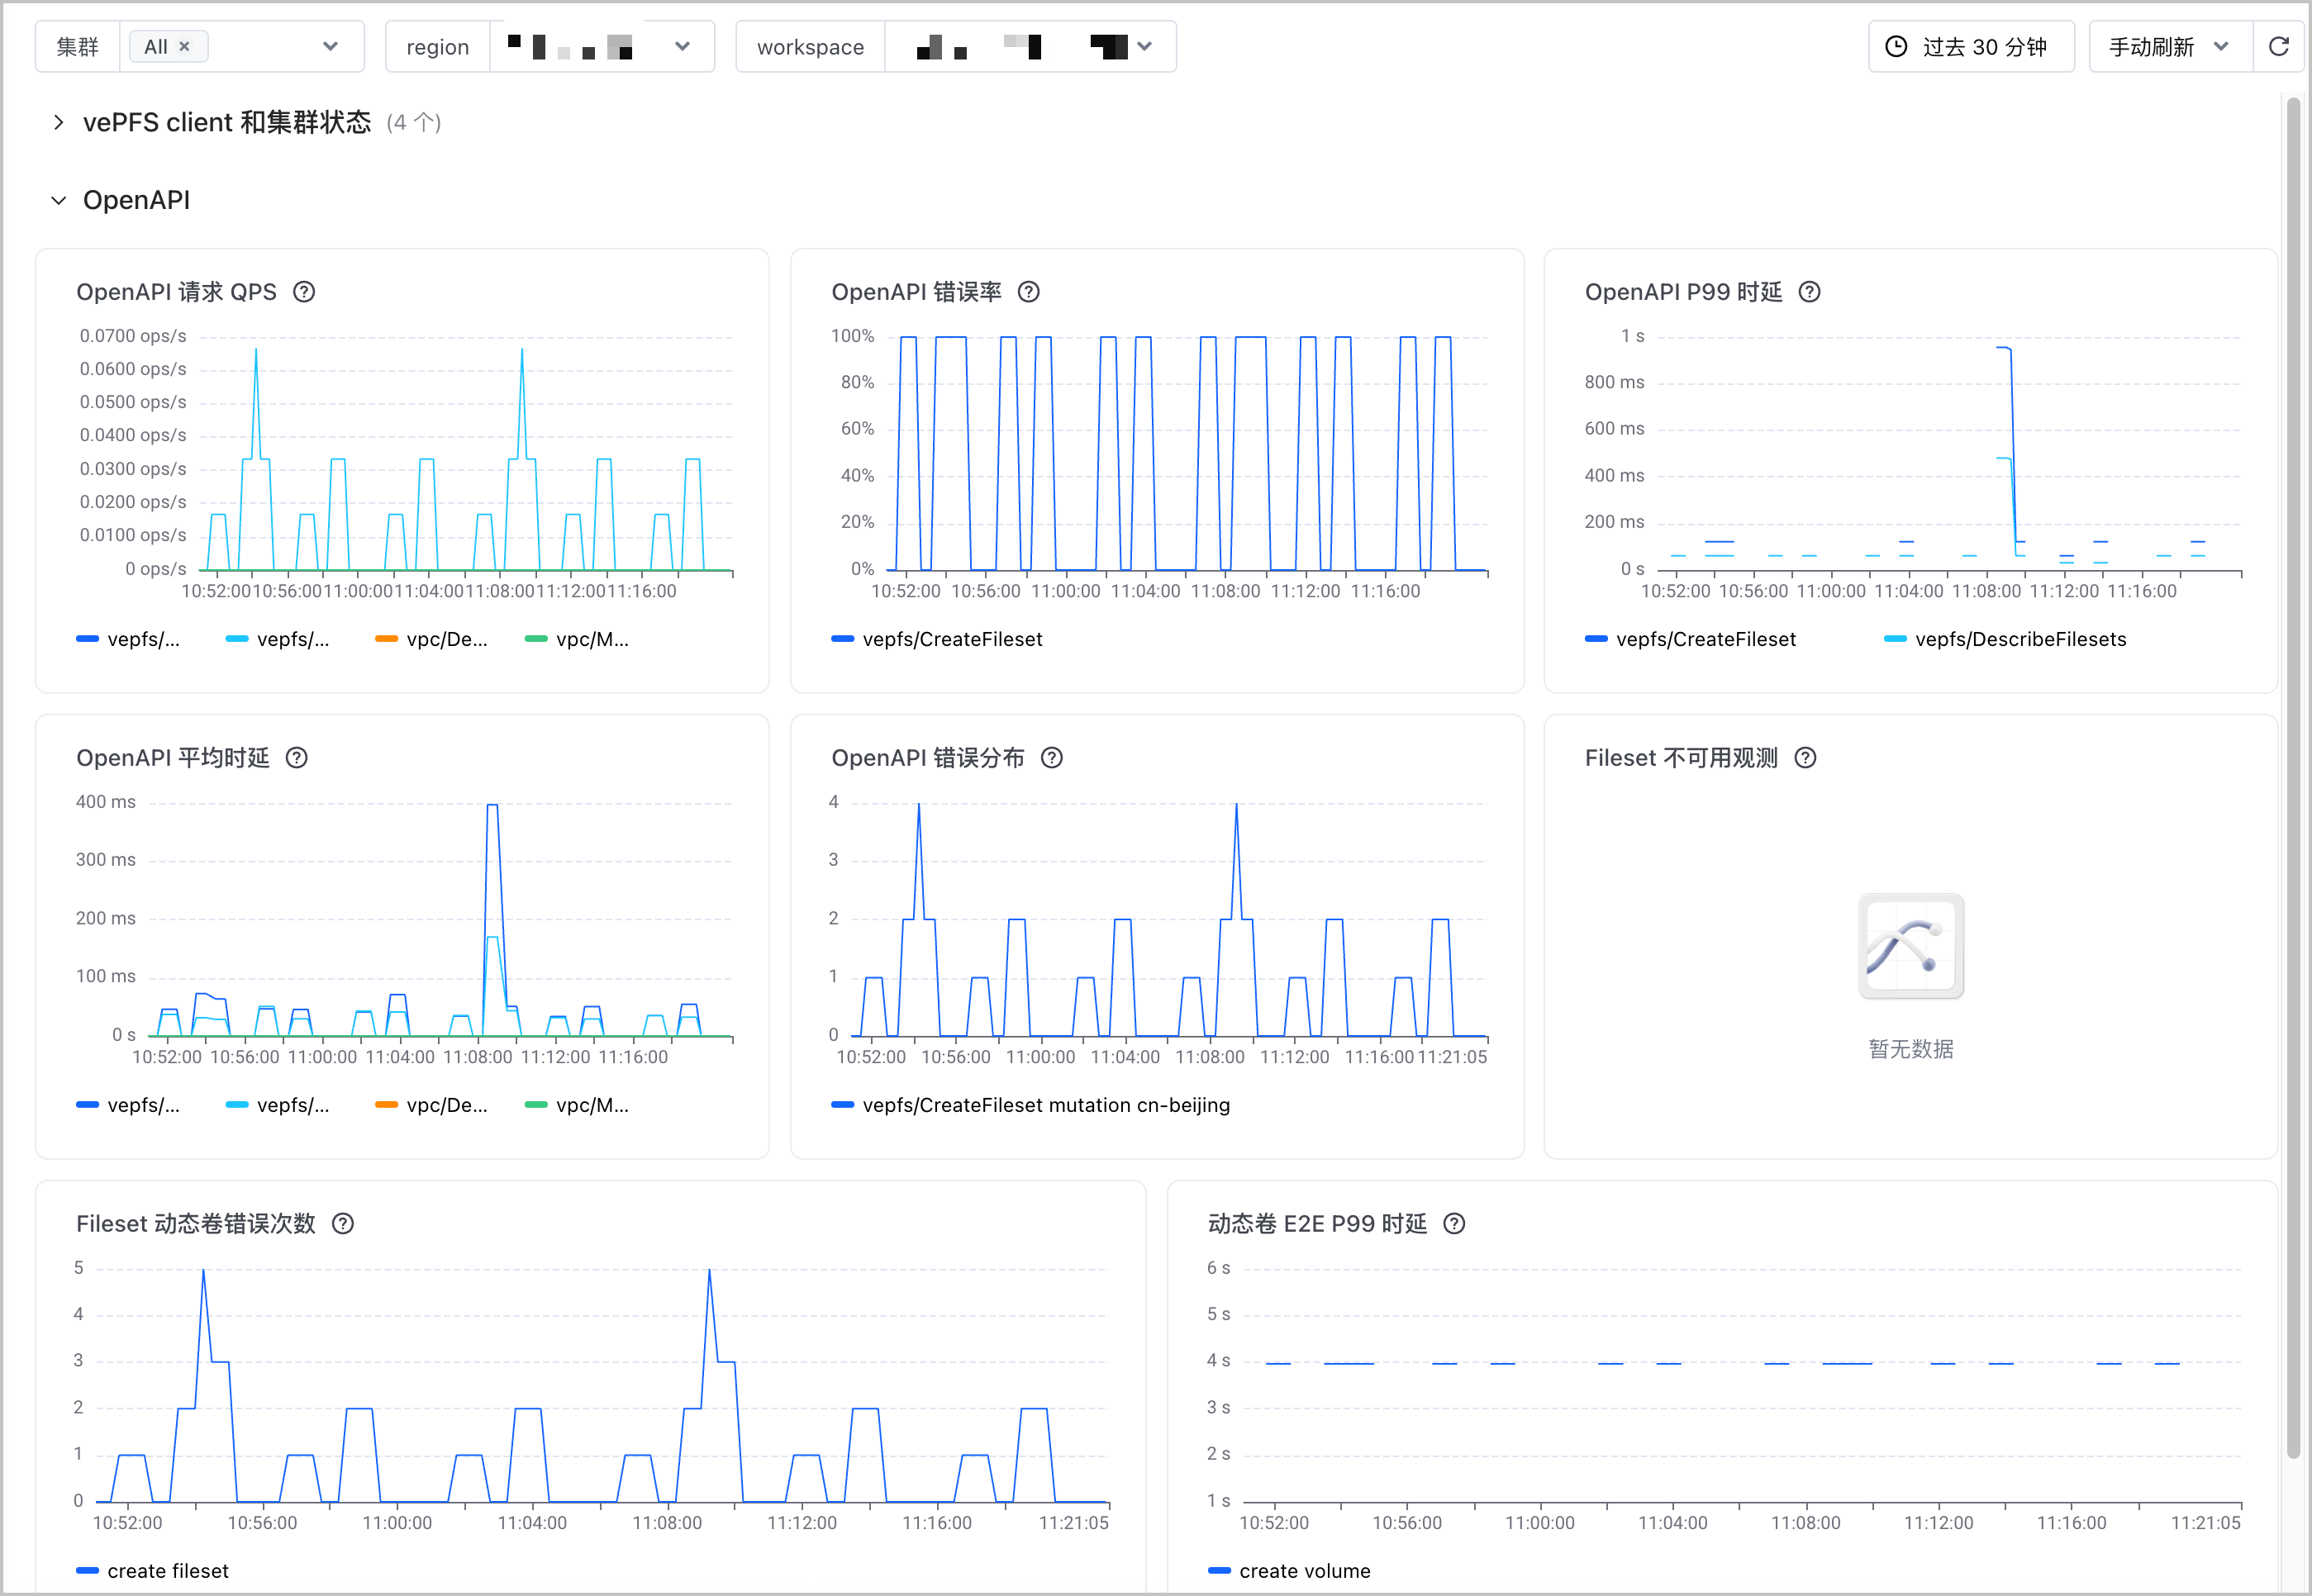
- csi-vepfs 监控看板主要分为 4 个部分,分别面向 vePFS client 和集群状态、OpenAPI、CSI 调用和原生命令监控。详细的图表说明,如下表所示。
说明
- 图表名称单位图表说明图表名称单位图表说明vePFS client 和集群状态成员节点数个统计当前筛选条件下各挂载服务的成员节点数量,帮助您判断 vePFS 集群的节点规模是否符合预期。
- 正常情况下,该值与挂载服务的预期节点规模一致,仅在节点扩缩容或业务调整时发生变化。
- 如果节点数突然下降、持续低于预期或变为 0,说明部分节点可能未正常加入挂载服务。例如:节点下线、网络异常、客户端服务异常或挂载服务配置变更等。
client pod 数个统计当前筛选条件下各挂载服务中正在运行的 vePFS client Pod 数量,帮助您判断客户端是否已覆盖需要访问 vePFS 的节点。- 正常情况下,该值与需要部署 vePFS 客户端的节点数量基本一致,仅随节点扩缩容或客户端部署范围调整而变化。
- 如果 client Pod 数突然下降、持续低于预期或变为 0,说明部分节点上的客户端可能未正常运行。例如:Pod 调度失败、镜像拉取失败、资源不足、节点异常或组件升级中断等。
异常节点数个统计当前筛选条件下 GPFS 集群中状态不是 active/down 的异常节点数量,帮助您判断集群节点是否存在异常状态。- 正常情况下,该值应为 0;节点状态切换期间可能短暂出现非 0 值,完成切换后应恢复为 0。
- 如果该值持续大于 0 或不断增加,说明部分节点状态未正常收敛。例如:节点故障、网络不通、客户端服务异常、挂载服务异常或状态同步失败等。
client pod 部署 P99 时延秒统计 Controller 创建 vePFS client Pod 到 Pod 进入 Running 状态所需时间的 P99 值,帮助您判断客户端部署链路是否变慢。- 正常情况下,该值围绕历史基线小幅波动;基于过去 60 秒采样,约 99% 的 client Pod 部署耗时不超过该值。
- 如果该值持续升高或频繁出现明显尖峰,说明客户端 Pod 部署可能受阻。例如:节点资源不足、调度等待、镜像拉取缓慢、网络异常或容器启动失败等。
OpenAPIOpenAPI 请求 QPS次/秒统计 Controller 发起外部 OpenAPI 或 SDK 请求的每秒平均次数,帮助您判断外部接口调用负载和变化趋势。- 正常情况下,该值与业务操作频率和控制器调谐节奏一致;基于过去 60 秒采样,通常围绕历史基线波动。
- 如果 QPS 突然升高、持续高于基线或异常降为 0,说明调用链路可能出现异常。例如:业务请求突增、控制器频繁重试、资源状态反复变化或 Controller 未正常工作等。
OpenAPI 错误率%统计 Controller 发起外部 OpenAPI 请求时错误请求数占全部请求数的比例,帮助您判断外部接口调用是否稳定。- 正常情况下,该值应接近 0%,仅在网络短暂抖动或服务瞬时异常时出现小幅波动;该值基于过去 60 秒采样计算。
- 如果错误率持续升高或频繁出现尖峰,说明 OpenAPI 调用存在持续失败。例如:鉴权失败、请求参数异常、接口限流、网络异常或后端服务不可用等。
OpenAPI P99 时延秒统计 Controller 发起外部 OpenAPI 请求耗时的 P99 值,帮助您判断绝大多数外部接口请求的尾部时延。- 正常情况下,该值围绕历史基线小幅波动;基于过去 60 秒采样,约 99% 的请求耗时不超过该值。
- 如果该值持续升高或频繁出现明显尖峰,说明外部接口调用链路可能变慢。例如:网络延迟升高、接口限流、后端服务负载过高或请求重试等。
OpenAPI 平均时延秒统计 Controller 发起外部 OpenAPI 请求的平均耗时,帮助您判断外部接口调用的整体响应速度。- 正常情况下,该值围绕历史基线小幅波动;基于过去 60 秒采样,使用请求累计耗时增速除以请求次数增速计算。
- 如果平均时延持续升高或明显偏离历史基线,说明 OpenAPI 整体响应变慢。例如:网络拥塞、后端服务负载升高、接口限流或请求处理异常等。
OpenAPI 错误分布次统计 Controller 发起外部 OpenAPI 请求时新增的错误次数,并按服务、操作、QPS 分类和地域展示,帮助您定位错误集中的调用类型。- 正常情况下,各维度的错误次数应为 0 或仅偶发出现;该值统计过去 60 秒内新增的错误次数。
- 如果某个服务、操作、QPS 分类或地域的错误次数持续增加,说明故障可能集中在对应调用链路。例如:特定接口异常、地域网络故障、接口限流、鉴权失败或请求参数错误等。
Fileset 不可用观测次统计通过 DescribeFilesets 接口观测到 Fileset 状态不是 Running 的新增次数,帮助您判断 Fileset 是否持续处于不可用状态。- 正常情况下,该值应为 0;Fileset 创建、删除或状态切换期间可能短暂出现非 0 值,状态稳定后应恢复为 0。
- 如果该值持续大于 0 或不断增加,说明 Fileset 可能长时间未进入 Running 状态。例如:后端存储服务异常、状态变更未完成、接口返回异常或资源操作失败等。该值统计过去 30 分钟内新增的观测次数。
Fileset 动态卷错误次数次统计创建和删除 Fileset 动态卷时的错误次数,帮助您判断动态卷生命周期操作是否正常。- 正常情况下,创建和删除操作的错误次数应为 0;该值统计过去 60 秒内新增的错误次数。
- 如果错误次数持续增加,说明动态卷对应的 Fileset 操作失败。例如:权限不足、配额不足、资源状态异常、请求参数错误、网络异常或后端服务不可用等。
动态卷 E2E P99 时延秒统计创建动态卷和删除 Fileset 的端到端(End-to-End,E2E)耗时 P99 值,帮助您判断动态卷生命周期操作是否变慢。- 正常情况下,该值围绕历史基线小幅波动;基于过去 60 秒采样,约 99% 的创建或删除操作耗时不超过该值。
- 如果该值持续升高或频繁出现明显尖峰,说明动态卷操作链路可能存在延迟。例如:OpenAPI 响应变慢、后端资源处理缓慢、网络异常或控制器重试等。
CSI 调用控制面 RPC 错误次数次统计 vePFS CSI 控制面 Sidecar 调用 CSI Driver 时 gRPC 状态码非 OK 的新增次数,帮助您判断控制面 RPC 链路是否正常。- 正常情况下,各 Prometheus 采集任务(job)和方法的错误次数应为 0;该值统计过去 60 秒内新增的错误次数。
- 如果某个采集任务或方法的错误次数持续增加,说明 Sidecar 与 CSI Driver 的调用可能失败。例如:Driver 未就绪、接口超时、参数异常、组件重启或网络通信异常等。
节点 RPC 错误次数次统计 kubelet 调用 vePFS CSI Node Driver 时 gRPC 状态码非 OK 的新增次数,帮助您判断节点侧 RPC 链路是否正常。- 正常情况下,各节点和方法的错误次数应为 0;该值统计过去 60 秒内新增的错误次数。
- 如果某个节点或方法的错误次数持续增加,说明 kubelet 与 CSI Node Driver 的调用可能失败。例如:Driver 未就绪、节点网络异常、接口超时、挂载参数异常或组件重启等。
CSI RPC P99 时延秒统计 Sidecar 和 kubelet 调用 vePFS CSI Driver 的 P99 时延,帮助您判断控制面与节点侧 CSI RPC 链路是否变慢。- 正常情况下,各方法的时延围绕历史基线小幅波动;基于过去 60 秒采样,约 99% 的 RPC 调用耗时不超过该值。
- 如果某个方法的时延持续升高或频繁出现明显尖峰,说明对应 CSI 调用链路可能阻塞。例如:Driver 负载升高、节点资源不足、后端存储响应变慢、网络异常或请求重试等。
Node mount 错误次数次统计 Node 侧执行 vePFS 挂载操作的错误次数,帮助您按采集实例 IP 和挂载服务定位 CSI Node 挂载链路异常。- 正常情况下,各实例和挂载服务的错误次数应为 0;该值统计过去 60 秒内新增的错误次数。
- 如果某个实例或挂载服务的错误次数持续增加,说明节点挂载操作可能失败。例如:挂载服务不可用、网络不通、权限或参数配置错误、节点客户端异常或目标路径冲突等。
原生命令Controller 原生命令 QPS次/秒统计 Controller 侧执行 vePFS 原生命令的每秒平均次数,帮助您判断控制面命令调用负载和变化趋势。- 正常情况下,该值与业务操作和控制器调谐频率一致;基于过去 60 秒采样,通常围绕历史基线波动。
- 如果 QPS 突然升高、持续高于基线或异常降为 0,说明 Controller 命令链路可能异常。例如:资源状态反复变化、命令频繁重试、业务操作突增或 Controller 未正常工作等。
Controller 原生命令错误率%统计 Controller 侧执行 vePFS 原生命令时错误次数占全部执行次数的比例,帮助您判断控制面命令执行是否稳定。- 正常情况下,各实例、位置和命令的错误率应接近 0%;该值基于过去 60 秒采样计算。
- 如果某个命令的错误率持续升高或频繁出现尖峰,说明 Controller 原生命令执行失败。例如:命令参数异常、后端服务不可用、网络异常、资源状态冲突或权限不足等。
Controller 原生命令 P99 时延秒统计 Controller 侧执行 vePFS 原生命令耗时的 P99 值,帮助您判断控制面命令执行链路是否变慢。- 正常情况下,各命令的时延围绕历史基线小幅波动;基于过去 60 秒采样,约 99% 的命令执行耗时不超过该值。
- 如果某个命令的时延持续升高或频繁出现明显尖峰,说明 Controller 命令链路可能阻塞。例如:后端服务响应变慢、网络延迟升高、资源竞争或命令重试等。
Node 原生命令 QPS次/秒统计 Node 侧执行 vePFS 原生命令的每秒平均次数,帮助您判断节点命令调用负载和变化趋势。- 正常情况下,该值与节点挂载、卸载等业务操作频率一致;基于过去 60 秒采样,通常围绕历史基线波动。
- 如果 QPS 突然升高、持续高于基线或异常降为 0,说明 Node 命令链路可能异常。例如:挂载操作突增、命令频繁重试、节点状态反复变化或 CSI Node 组件未正常工作等。
Node 原生命令错误率%统计 Node 侧执行 vePFS 原生命令时错误次数占全部执行次数的比例,帮助您判断节点命令执行是否稳定。- 正常情况下,各实例、位置和命令的错误率应接近 0%;该值基于过去 60 秒采样计算。
- 如果某个节点或命令的错误率持续升高或频繁出现尖峰,说明 Node 原生命令执行失败。例如:挂载参数异常、网络不通、目标路径冲突、客户端异常或后端服务不可用等。
Node 原生命令 P99 时延秒统计 Node 侧执行 vePFS 原生命令耗时的 P99 值,帮助您判断节点命令执行链路是否变慢。- 正常情况下,各命令的时延围绕历史基线小幅波动;基于过去 60 秒采样,约 99% 的命令执行耗时不超过该值。
- 如果某个节点或命令的时延持续升高或频繁出现明显尖峰,说明 Node 命令链路可能阻塞。例如:节点资源不足、网络延迟升高、后端存储响应变慢、命令等待或重试等。
节点挂载服务变更错误次数次统计添加和删除挂载服务节点时的错误次数,帮助您判断节点挂载服务变更链路是否正常。- 正常情况下,添加和删除节点的错误次数应为 0;该值统计过去 60 秒内新增的错误次数。
- 如果错误次数持续增加,说明节点挂载服务变更操作失败。例如:节点状态异常、挂载服务不可用、网络异常、资源状态冲突或原生命令执行失败等。
节点挂载服务变更 P99 时延秒统计添加、删除和强制删除挂载服务节点的 P99 时延,帮助您判断节点挂载服务变更链路是否变慢。- 正常情况下,各类变更操作的时延围绕历史基线小幅波动;基于过去 60 秒采样,约 99% 的变更操作耗时不超过该值。
- 如果某类变更操作的时延持续升高或频繁出现明显尖峰,说明节点挂载服务变更链路可能阻塞。例如:节点响应缓慢、挂载服务异常、网络延迟升高、资源状态冲突或命令重试等。
EBS 监控
开启 csi-ebs 组件监控后,您可以查看该组件的指标看板。支持设置查询的时间段,并指定刷新方式(手动刷新、自动刷新)。
- 在集群管理页面的左侧导航栏中,选择 监控中心 > 监控看板。
- 在左侧看板列表中选择 存储服务监控 > EBS 监控,即可查看监控看板。
-
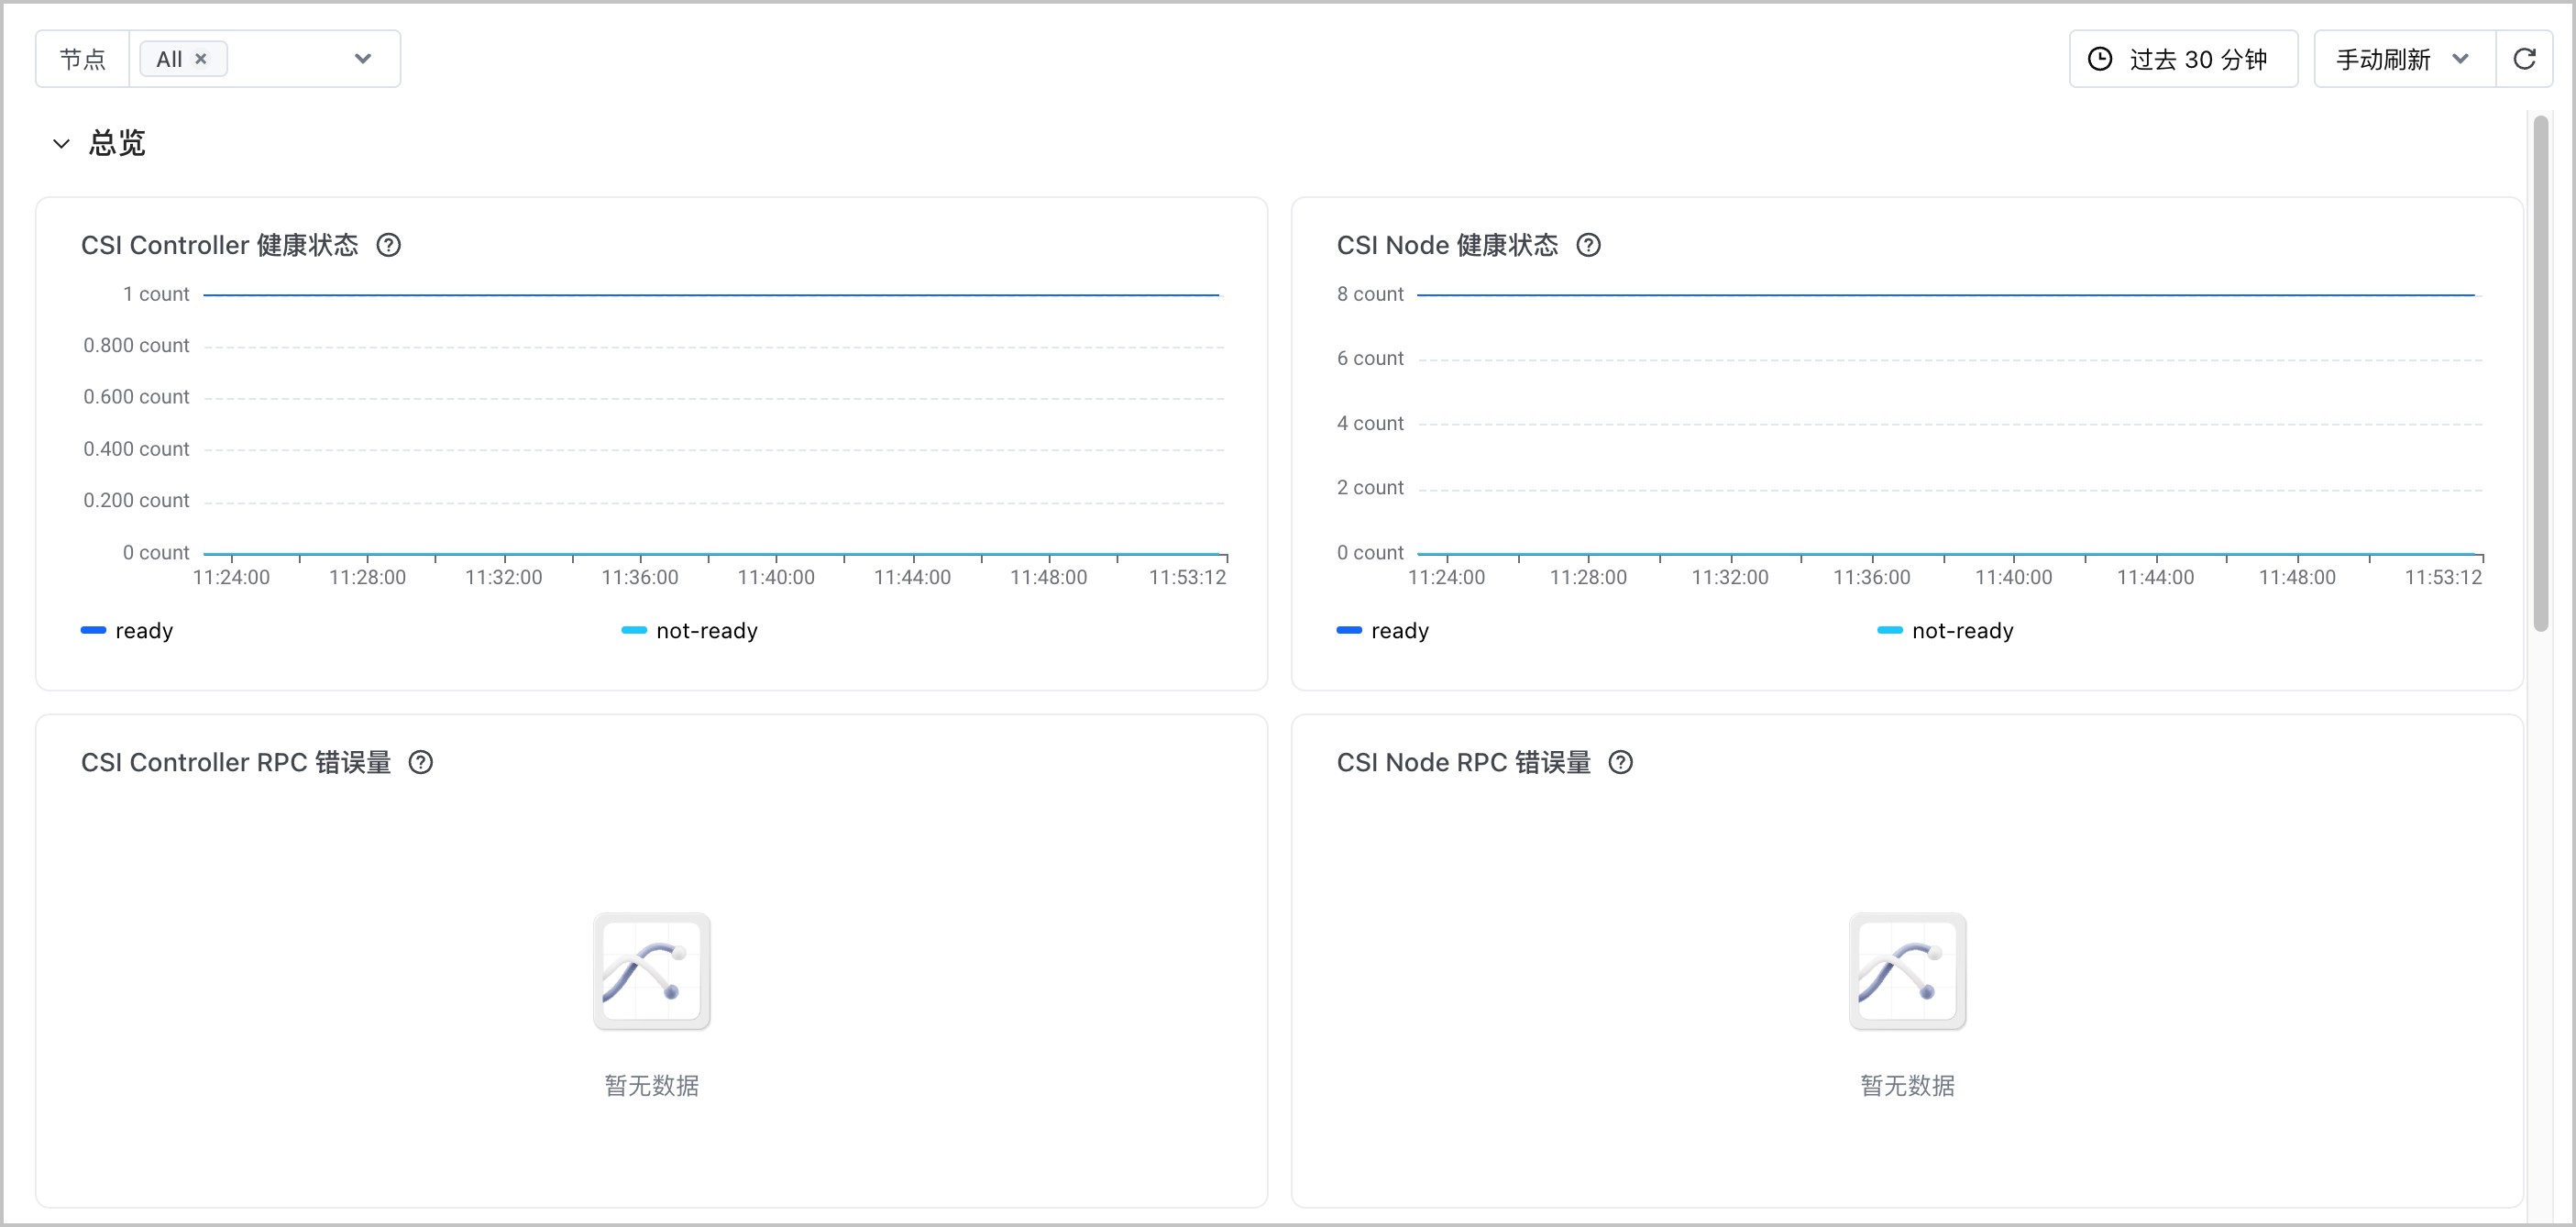
- csi-ebs 监控看板主要分为 3 个部分,分别面向总览、控制面和数据面监控。详细的图表说明,如下表所示。
说明
- 图表名称单位图表说明图表名称单位图表说明总览CSI Controller 健康状态个统计 csi-ebs-controller Pod 处于 Ready 和 NotReady 状态的数量,帮助您判断 EBS CSI 控制面组件是否健康。
- 正常情况下,Ready 状态的 Pod 数量应与预期副本数一致,NotReady 状态的 Pod 数量应为 0。
- 如果 Ready 数量低于预期或 NotReady 数量持续大于 0,说明部分 Controller Pod 未正常提供服务。例如:Pod 启动失败、节点资源不足、镜像拉取异常、健康检查失败或组件反复重启等。
CSI Node 健康状态个统计 csi-ebs-node Pod 处于 Ready 和 NotReady 状态的数量,帮助您判断 EBS CSI 节点组件是否已正常覆盖集群节点。- 正常情况下,Ready 状态的 Pod 数量应与需要部署 CSI Node 组件的节点数量一致,NotReady 状态的 Pod 数量应为 0。
- 如果 Ready 数量下降、持续低于预期或 NotReady 数量持续大于 0,说明部分节点上的 CSI Node Pod 未正常运行。例如:节点异常、DaemonSet 调度失败、镜像拉取异常、健康检查失败或组件反复重启等。
CSI Controller RPC 错误量次统计 EBS CSI Sidecar 调用 Controller Driver 时失败的 gRPC 操作次数,帮助您判断控制面 RPC 链路是否正常。- 正常情况下,各 Sidecar 任务和方法的错误次数应为 0;该值统计过去 2 分钟内新增的错误次数。
- 如果某个 Sidecar 任务或方法的错误次数持续增加,说明控制面 RPC 调用可能失败。例如:Controller Driver 未就绪、接口超时、请求参数异常、组件重启或网络通信异常等。
CSI Node RPC 错误量次统计 kubelet 调用 EBS CSI Node Driver 时失败的 gRPC 操作次数,帮助您判断节点侧 RPC 链路是否正常。- 正常情况下,各方法的错误次数应为 0;该值统计过去 2 分钟内新增的错误次数。
- 如果某个方法的错误次数持续增加,说明节点侧 RPC 调用可能失败。例如:Node Driver 未就绪、节点网络异常、接口超时、挂载参数异常或组件重启等。
控制面Pending PVC 数量个统计处于 Pending 状态的持久卷声明(PersistentVolumeClaim,PVC)数量,帮助您判断 EBS 卷供给是否存在积压或失败。- 正常情况下,该值应为 0;新建 PVC 等待创建和绑定卷期间可能短暂大于 0,完成绑定后应恢复为 0。
- 如果该值持续大于 0 或不断增加,说明 EBS 卷供给链路可能阻塞。例如:StorageClass 配置错误、可用区资源不足、配额不足、Controller 异常或云盘创建失败等。
VolumeAttachment 未完成数量个统计尚未完成挂载的 VolumeAttachment 数量,帮助您判断 EBS 卷附加链路是否存在阻塞。- 正常情况下,该值应为 0;新建工作负载等待云盘附加期间可能短暂大于 0,附加完成后应恢复为 0。
- 如果该值持续大于 0 或不断增加,说明 EBS 卷附加操作可能未完成。例如:节点异常、云盘与节点可用区不一致、附加数量达到上限、Controller 异常或云盘状态异常等。
CSI Sidecar → EBS CSI Controller RPC 请求量次统计各 CSI Sidecar 调用 EBS CSI Controller Driver 的 gRPC 请求次数,帮助您判断控制面各类存储操作的调用负载。- 正常情况下,各 Sidecar 任务和方法的请求次数与 PVC 创建、挂载、扩容和快照等业务操作频率一致;该值统计过去 2 分钟内新增的请求次数。
- 如果请求量突然升高、持续高于历史基线或异常降为 0,说明控制面操作负载或组件状态可能异常。例如:业务操作突增、资源状态反复变化、Sidecar 频繁重试或组件未正常工作等。
CSI Sidecar → EBS CSI Controller RPC 错误量次统计各 CSI Sidecar 调用 EBS CSI Controller Driver 时失败的 gRPC 请求次数,帮助您定位控制面调用异常。- 正常情况下,各 Sidecar 任务和方法的错误次数应为 0;该值统计过去 2 分钟内新增的错误次数。
- 如果某个 Sidecar 任务或方法的错误次数持续增加,说明对应控制面操作可能失败。例如:Controller Driver 未就绪、接口超时、请求参数异常、云盘资源状态冲突或组件重启等。
CSI Sidecar → EBS CSI Controller RPC 平均耗时秒统计各 CSI Sidecar 调用 EBS CSI Controller Driver 的平均耗时,帮助您判断控制面 RPC 调用的整体响应速度。- 正常情况下,各 Sidecar 任务和方法的平均耗时围绕历史基线小幅波动;该值基于过去 2 分钟采样,使用累计耗时增速除以请求次数增速计算。
- 如果某个 Sidecar 任务或方法的平均耗时持续升高或明显偏离历史基线,说明控制面 RPC 调用变慢。例如:Controller Driver 负载过高、IaaS 接口响应变慢、网络延迟升高或请求重试等。
CSI Sidecar → EBS CSI Controller RPC P99 耗时秒统计各 CSI Sidecar 调用 EBS CSI Controller Driver 的 P99 耗时,帮助您判断控制面 RPC 调用的尾部时延。- 正常情况下,各 Sidecar 任务和方法的 P99 耗时围绕历史基线小幅波动;基于过去 2 分钟采样,约 99% 的请求耗时不超过该值。
- 如果某个 Sidecar 任务或方法的 P99 耗时持续升高或频繁出现明显尖峰,说明控制面 RPC 链路可能阻塞。例如:Controller Driver 负载过高、IaaS 接口响应变慢、网络异常或请求频繁重试等。
IaaS 成功请求量次统计 EBS CSI Controller 调用云存储 OpenAPI 的成功请求次数,帮助您判断各类 IaaS 操作的业务量和执行情况。- 正常情况下,各操作的成功请求次数与 PVC 创建、云盘附加、扩容和删除等业务操作频率一致;该值统计过去 2 分钟内新增的成功请求次数。
- 如果成功请求量异常降为 0、明显低于历史基线或与错误请求量同步上升,说明 IaaS 调用链路可能异常。例如:Controller 未发起请求、接口调用失败、鉴权异常、限流或后端服务不可用等。
IaaS 错误请求量次统计 EBS CSI Controller 调用云存储 OpenAPI 时的错误请求次数,帮助您判断 IaaS 接口调用是否稳定。- 正常情况下,各操作的错误请求次数应为 0;该值统计过去 2 分钟内新增的错误请求次数。
- 如果某个操作的错误请求次数持续增加,说明对应云存储 OpenAPI 调用失败。例如:鉴权失败、请求参数异常、资源配额不足、接口限流、网络异常或后端服务不可用等。
IaaS 请求 P99 延迟秒统计 EBS CSI Controller 调用云存储 OpenAPI 的 P99 延迟,帮助您判断 IaaS 接口请求的尾部时延。- 正常情况下,各操作的 P99 延迟围绕历史基线小幅波动;基于过去 2 分钟采样,约 99% 的请求耗时不超过该值。
- 如果某个操作的 P99 延迟持续升高或频繁出现明显尖峰,说明云存储 OpenAPI 响应变慢。例如:网络延迟升高、接口限流、后端服务负载过高或请求重试等。
数据面Kubelet → EBS CSI Node RPC 请求量次统计 kubelet 调用 EBS CSI Node Driver 的 gRPC 请求次数,帮助您判断节点侧挂载、卸载等操作的调用负载。- 正常情况下,各方法的请求次数与节点侧卷挂载和卸载等业务操作频率一致;该值统计过去 2 分钟内新增的请求次数。
- 如果请求量突然升高、持续高于历史基线或异常降为 0,说明节点侧操作负载或组件状态可能异常。例如:Pod 调度突增、卷操作反复重试、节点状态变化或 Node Driver 未正常工作等。
Kubelet → EBS CSI Node RPC 错误量次统计 kubelet 调用 EBS CSI Node Driver 时失败的 gRPC 请求次数,帮助您定位节点侧卷操作异常。- 正常情况下,各方法的错误次数应为 0;该值统计过去 2 分钟内新增的错误次数。
- 如果某个方法的错误次数持续增加,说明节点侧挂载或卸载操作可能失败。例如:Node Driver 未就绪、挂载参数异常、设备未就绪、目标路径冲突或节点网络异常等。
Kubelet → EBS CSI Node RPC 平均耗时秒统计 kubelet 调用 EBS CSI Node Driver 的平均耗时,帮助您判断节点侧 RPC 调用的整体响应速度。- 正常情况下,各方法的平均耗时围绕历史基线小幅波动;该值基于过去 2 分钟采样,使用累计耗时增速除以请求次数增速计算。
- 如果某个方法的平均耗时持续升高或明显偏离历史基线,说明节点侧 RPC 调用变慢。例如:节点资源不足、设备响应缓慢、文件系统操作耗时、网络异常或请求重试等。
Kubelet → EBS CSI Node RPC P99 耗时秒统计 kubelet 调用 EBS CSI Node Driver 的 P99 耗时,帮助您判断节点侧 RPC 调用的尾部时延。- 正常情况下,各方法的 P99 耗时围绕历史基线小幅波动;基于过去 2 分钟采样,约 99% 的请求耗时不超过该值。
- 如果某个方法的 P99 耗时持续升高或频繁出现明显尖峰,说明节点侧 RPC 链路可能阻塞。例如:节点资源不足、设备响应缓慢、文件系统操作耗时、网络异常或请求频繁重试等。
节点已挂载 EBS 卷数个统计各节点当前已挂载的 EBS 卷数量,帮助您判断卷在节点间的分布和单节点挂载规模。- 正常情况下,该值与各节点上使用 EBS 卷的工作负载数量一致,仅随 Pod 调度、卷挂载或卸载操作变化。
- 如果某个节点的挂载卷数突然下降、持续异常增长或接近节点挂载上限,说明卷使用或调度可能异常。例如:工作负载迁移、VolumeAttachment 未完成、卷未正常卸载、Pod 反复重建或节点容量规划不足等。
NAS 监控
开启 csi-nas 组件监控后,您可以查看该组件的指标看板。支持设置查询的时间段,并指定刷新方式(手动刷新、自动刷新)。
- 在集群管理页面的左侧导航栏中,选择 监控中心 > 监控看板。
- 在左侧看板列表中选择 存储服务监控 > NAS 监控,即可查看监控看板。
-
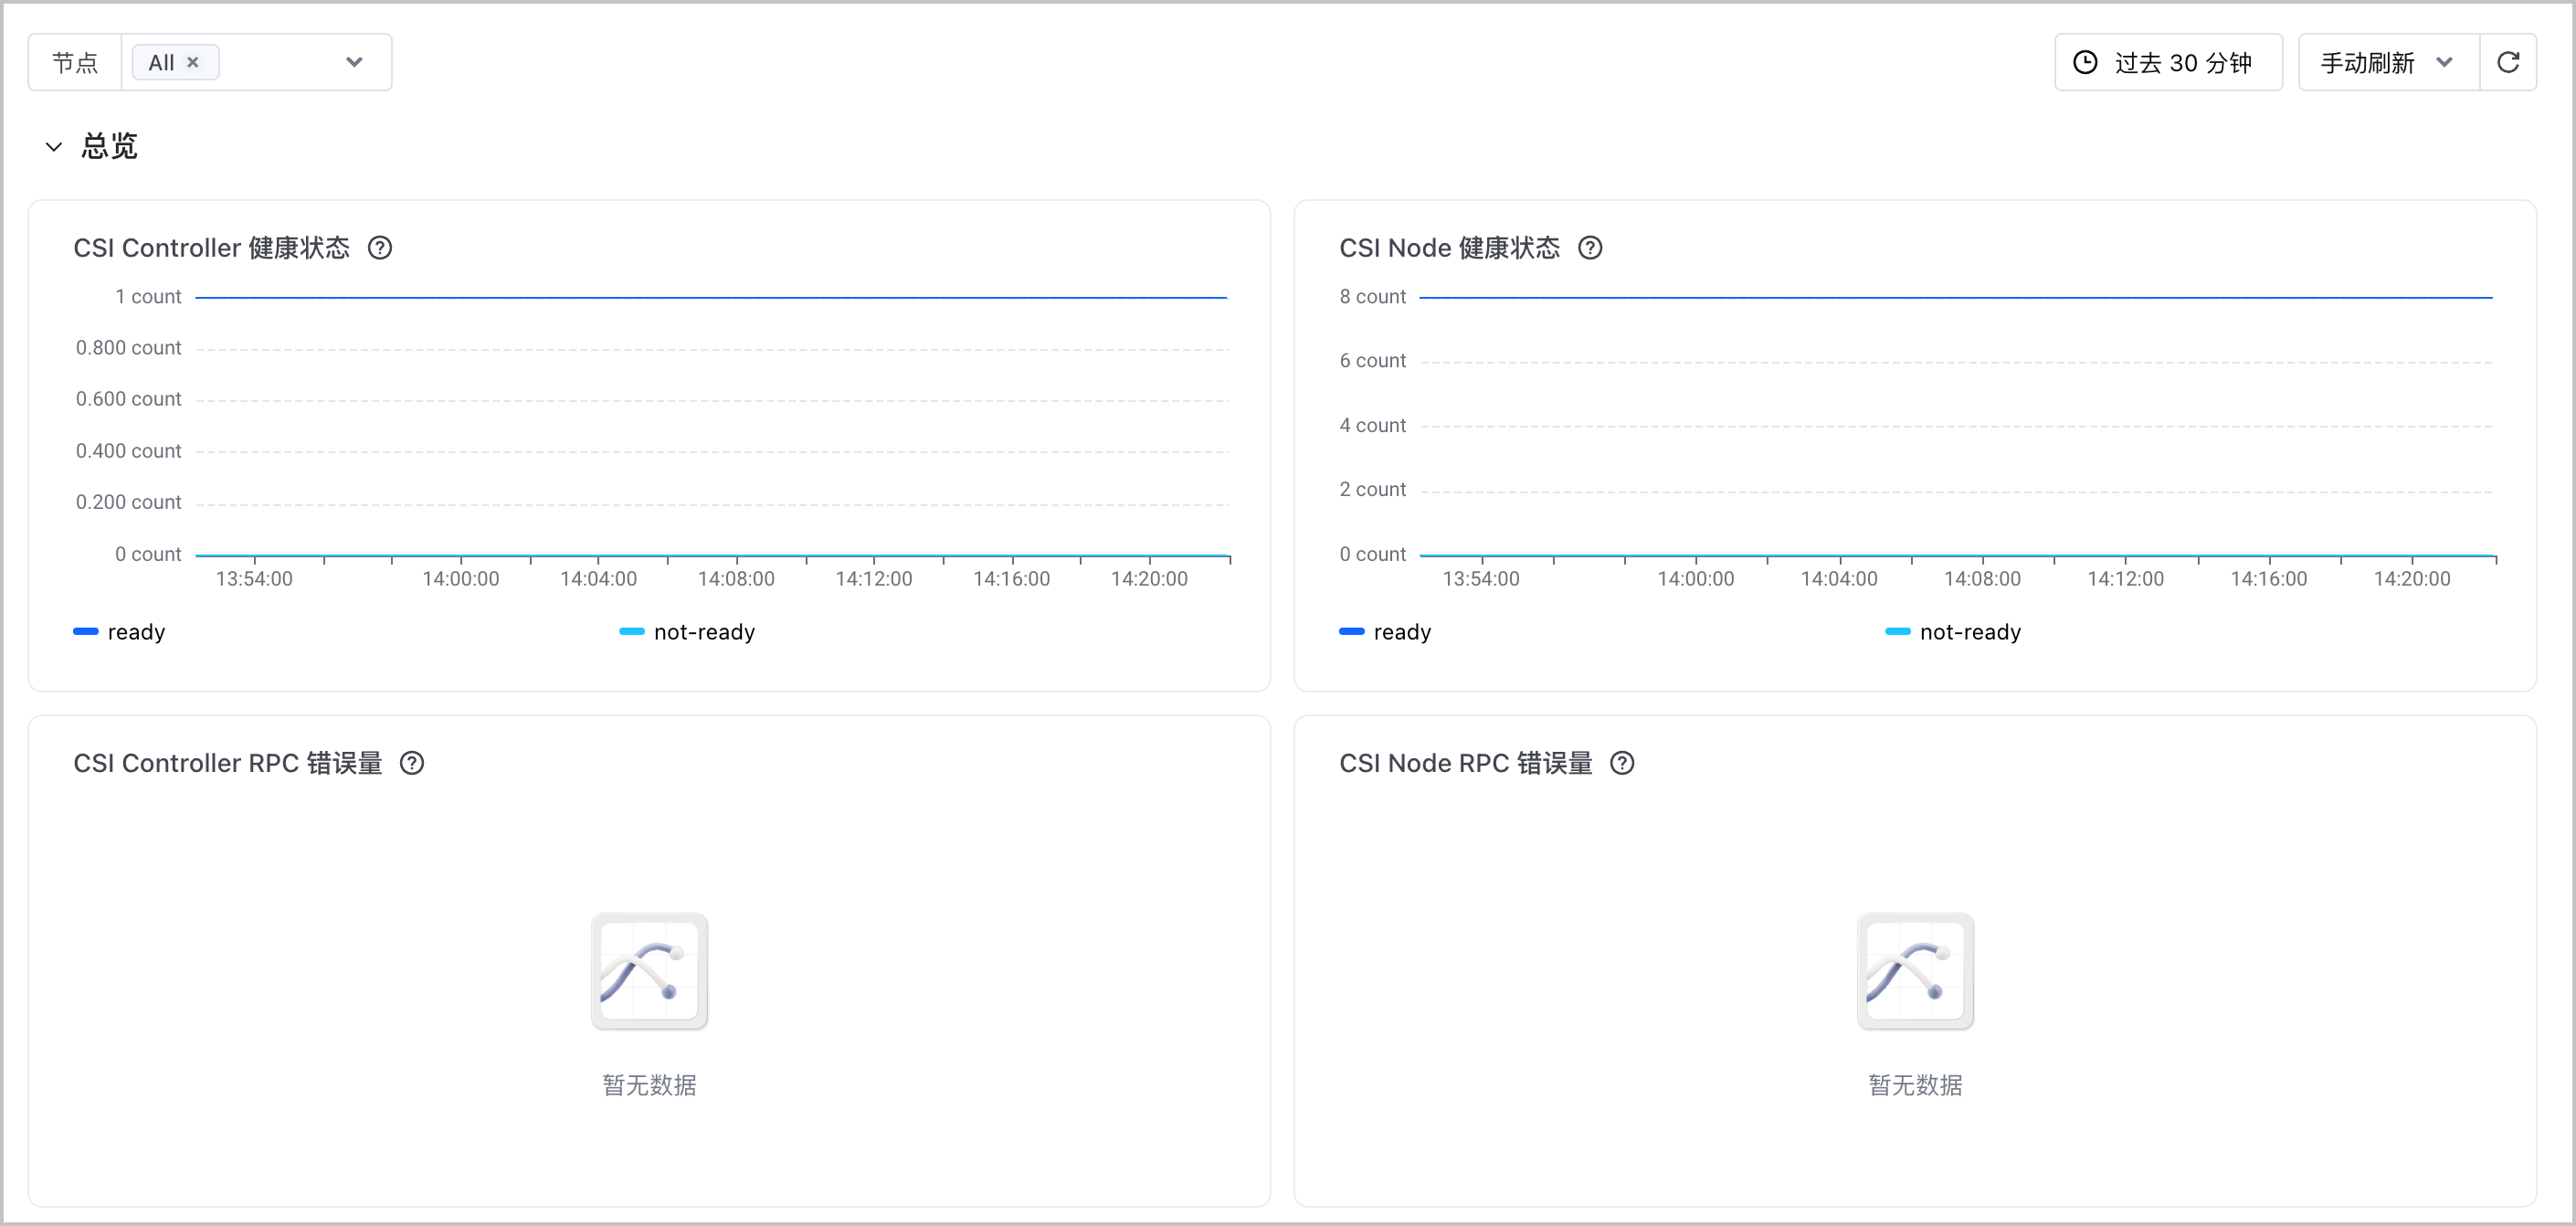
- csi-nas 监控看板主要分为 3 个部分,分别面向总览、控制面和数据面监控。详细的图表说明,如下表所示。
说明
- 图表名称单位图表说明图表名称单位图表说明总览CSI Controller 健康状态个统计 csi-nas-controller Pod 处于 Ready 和 NotReady 状态的数量,帮助您判断 NAS CSI 控制面组件是否健康。
- 正常情况下,Ready 状态的 Pod 数量应与预期副本数一致,NotReady 状态的 Pod 数量应为 0。
- 如果 Ready 数量低于预期或 NotReady 数量持续大于 0,说明部分 Controller Pod 未正常提供服务。例如:Pod 启动失败、节点资源不足、镜像拉取异常、健康检查失败或组件反复重启等。
CSI Node 健康状态个统计 csi-nas-node Pod 处于 Ready 和 NotReady 状态的数量,帮助您判断 NAS CSI 节点组件是否已正常覆盖集群节点。- 正常情况下,Ready 状态的 Pod 数量应与需要部署 CSI Node 组件的节点数量一致,NotReady 状态的 Pod 数量应为 0。
- 如果 Ready 数量下降、持续低于预期或 NotReady 数量持续大于 0,说明部分节点上的 CSI Node Pod 未正常运行。例如:节点异常、DaemonSet 调度失败、镜像拉取异常、健康检查失败或组件反复重启等。
CSI Controller RPC 错误量次统计 NAS CSI Sidecar 调用 Controller Driver 时失败的 gRPC 操作次数,帮助您判断控制面 RPC 链路是否正常。- 正常情况下,各 Sidecar 任务和方法的错误次数应为 0;该值统计过去 2 分钟内新增的错误次数。
- 如果某个 Sidecar 任务或方法的错误次数持续增加,说明控制面 RPC 调用可能失败。例如:Controller Driver 未就绪、接口超时、请求参数异常、组件重启或网络通信异常等。
CSI Node RPC 错误量次统计 kubelet 调用 NAS CSI Node Driver 时失败的 gRPC 操作次数,帮助您判断节点侧 RPC 链路是否正常。- 正常情况下,各方法的错误次数应为 0;该值统计过去 2 分钟内新增的错误次数。
- 如果某个方法的错误次数持续增加,说明节点侧 RPC 调用可能失败。例如:Node Driver 未就绪、节点网络异常、接口超时、挂载参数异常或组件重启等。
控制面CSI Sidecar → CSI Controller RPC 请求量次统计各 CSI Sidecar 调用 NAS CSI Controller Driver 的 gRPC 请求次数,帮助您判断控制面各类存储操作的调用负载。- 正常情况下,各 Sidecar 任务和方法的请求次数与 PVC 创建、删除和扩容等业务操作频率一致;该值统计过去 2 分钟内新增的请求次数。
- 如果请求量突然升高、持续高于历史基线或异常降为 0,说明控制面操作负载或组件状态可能异常。例如:业务操作突增、资源状态反复变化、Sidecar 频繁重试或组件未正常工作等。
CSI Sidecar → CSI Controller RPC P99 耗时秒统计各 CSI Sidecar 调用 NAS CSI Controller Driver 的 P99 耗时,帮助您判断控制面 RPC 调用的尾部时延。- 正常情况下,各 Sidecar 任务和方法的 P99 耗时围绕历史基线小幅波动;基于过去 2 分钟采样,约 99% 的请求耗时不超过该值。
- 如果某个 Sidecar 任务或方法的 P99 耗时持续升高或频繁出现明显尖峰,说明控制面 RPC 链路可能阻塞。例如:Controller Driver 负载过高、NAS 后端响应变慢、网络异常或请求频繁重试等。
CSI Controller NAS 操作请求量次统计 NAS CSI Controller Driver 内部各细粒度操作的请求次数,并按方法、操作和结果展示,帮助您判断控制面 NAS 操作的调用负载和执行结果。- 正常情况下,各方法和操作的请求次数与 PVC 生命周期操作频率一致,成功结果应占主要比例;该值统计过去 2 分钟内新增的请求次数。
- 如果某类操作请求量突然升高、持续高于历史基线或失败结果明显增加,说明控制面 NAS 操作可能异常。例如:资源状态反复变化、操作频繁重试、业务请求突增或后端 NAS 服务异常等。
CSI Controller NAS 操作 P99 耗时秒统计 NAS CSI Controller Driver 内部各细粒度操作的 P99 耗时,并按方法和操作展示,帮助您判断控制面 NAS 操作的尾部时延。- 正常情况下,各方法和操作的 P99 耗时围绕历史基线小幅波动;基于过去 2 分钟采样,约 99% 的操作耗时不超过该值。
- 如果某类操作的 P99 耗时持续升高或频繁出现明显尖峰,说明控制面 NAS 操作链路可能阻塞。例如:NAS 后端响应变慢、网络延迟升高、资源状态冲突或操作频繁重试等。
CSI Controller NAS 操作错误量次统计 NAS CSI Controller Driver 内部各细粒度操作的错误次数,并按方法和操作展示,帮助您定位控制面 NAS 操作异常。- 正常情况下,各方法和操作的错误次数应为 0;该值统计过去 2 分钟内新增的错误次数。
- 如果某类操作的错误次数持续增加,说明控制面 NAS 操作可能失败。例如:请求参数异常、权限不足、NAS 后端服务不可用、网络异常或资源状态冲突等。
数据面Kubelet → CSI Node RPC 请求量次统计 kubelet 调用 NAS CSI Node Driver 的 gRPC 请求次数,帮助您判断节点侧挂载、卸载等操作的调用负载。- 正常情况下,各方法的请求次数与节点侧卷挂载和卸载等业务操作频率一致;该值统计过去 2 分钟内新增的请求次数。
- 如果请求量突然升高、持续高于历史基线或异常降为 0,说明节点侧操作负载或组件状态可能异常。例如:Pod 调度突增、卷操作反复重试、节点状态变化或 Node Driver 未正常工作等。
Kubelet → CSI Node RPC P99 耗时秒统计 kubelet 调用 NAS CSI Node Driver 的 P99 耗时,帮助您判断节点侧 RPC 调用的尾部时延。- 正常情况下,各方法的 P99 耗时围绕历史基线小幅波动;基于过去 2 分钟采样,约 99% 的请求耗时不超过该值。
- 如果某个方法的 P99 耗时持续升高或频繁出现明显尖峰,说明节点侧 RPC 链路可能阻塞。例如:节点资源不足、NAS 服务响应缓慢、NFS 挂载耗时、网络异常或请求频繁重试等。
Kubelet → CSI Node RPC 错误量次统计 kubelet 调用 NAS CSI Node Driver 时失败的 gRPC 请求次数,帮助您定位节点侧卷操作异常。- 正常情况下,各方法的错误次数应为 0;该值统计过去 2 分钟内新增的错误次数。
- 如果某个方法的错误次数持续增加,说明节点侧挂载或卸载操作可能失败。例如:Node Driver 未就绪、挂载参数异常、NAS 服务不可用、目标路径冲突或节点网络异常等。
CSI Node NAS 操作错误量次统计 NAS CSI Node Driver 内部各细粒度操作的错误次数,并按方法和操作展示,帮助您定位节点侧 NAS 操作异常。- 正常情况下,各方法和操作的错误次数应为 0;该值统计过去 2 分钟内新增的错误次数。
- 如果某类操作的错误次数持续增加,说明节点侧 NAS 操作可能失败。例如:NFS 挂载参数异常、NAS 服务不可用、网络不通、权限不足或目标路径冲突等。
CSI Node NAS 操作请求量次统计 NAS CSI Node Driver 内部各细粒度操作的请求次数,并按方法、操作和结果展示,帮助您判断节点侧 NAS 操作的调用负载和执行结果。- 正常情况下,各方法和操作的请求次数与节点侧挂载、卸载等业务操作频率一致,成功结果应占主要比例;该值统计过去 2 分钟内新增的请求次数。
- 如果某类操作请求量突然升高、持续高于历史基线或失败结果明显增加,说明节点侧 NAS 操作可能异常。例如:Pod 调度突增、挂载操作频繁重试、节点状态变化或 NAS 服务异常等。
CSI Node NAS 操作 P99 耗时秒统计 NAS CSI Node Driver 内部各细粒度操作的 P99 耗时,并按方法和操作展示,帮助您判断节点侧 NAS 操作及 NFS 挂载链路的尾部时延。- 正常情况下,各方法和操作的 P99 耗时围绕历史基线小幅波动;基于过去 2 分钟采样,约 99% 的操作耗时不超过该值。
- 如果某类操作的 P99 耗时持续升高或频繁出现明显尖峰,说明节点侧 NAS 操作或 NFS 挂载链路可能阻塞。例如:NAS 服务响应变慢、网络延迟升高、节点资源不足、挂载等待或操作频繁重试等。
Snapshot Controller 监控
开启 snapshot-controller 组件监控后,您可以查看该组件的指标看板。支持设置查询的时间段,并指定刷新方式(手动刷新、自动刷新)。
- 在集群管理页面的左侧导航栏中,选择 监控中心 > 监控看板。
- 在左侧看板列表中选择 存储服务监控 > Snapshot-Controller 监控,即可查看监控看板。
-
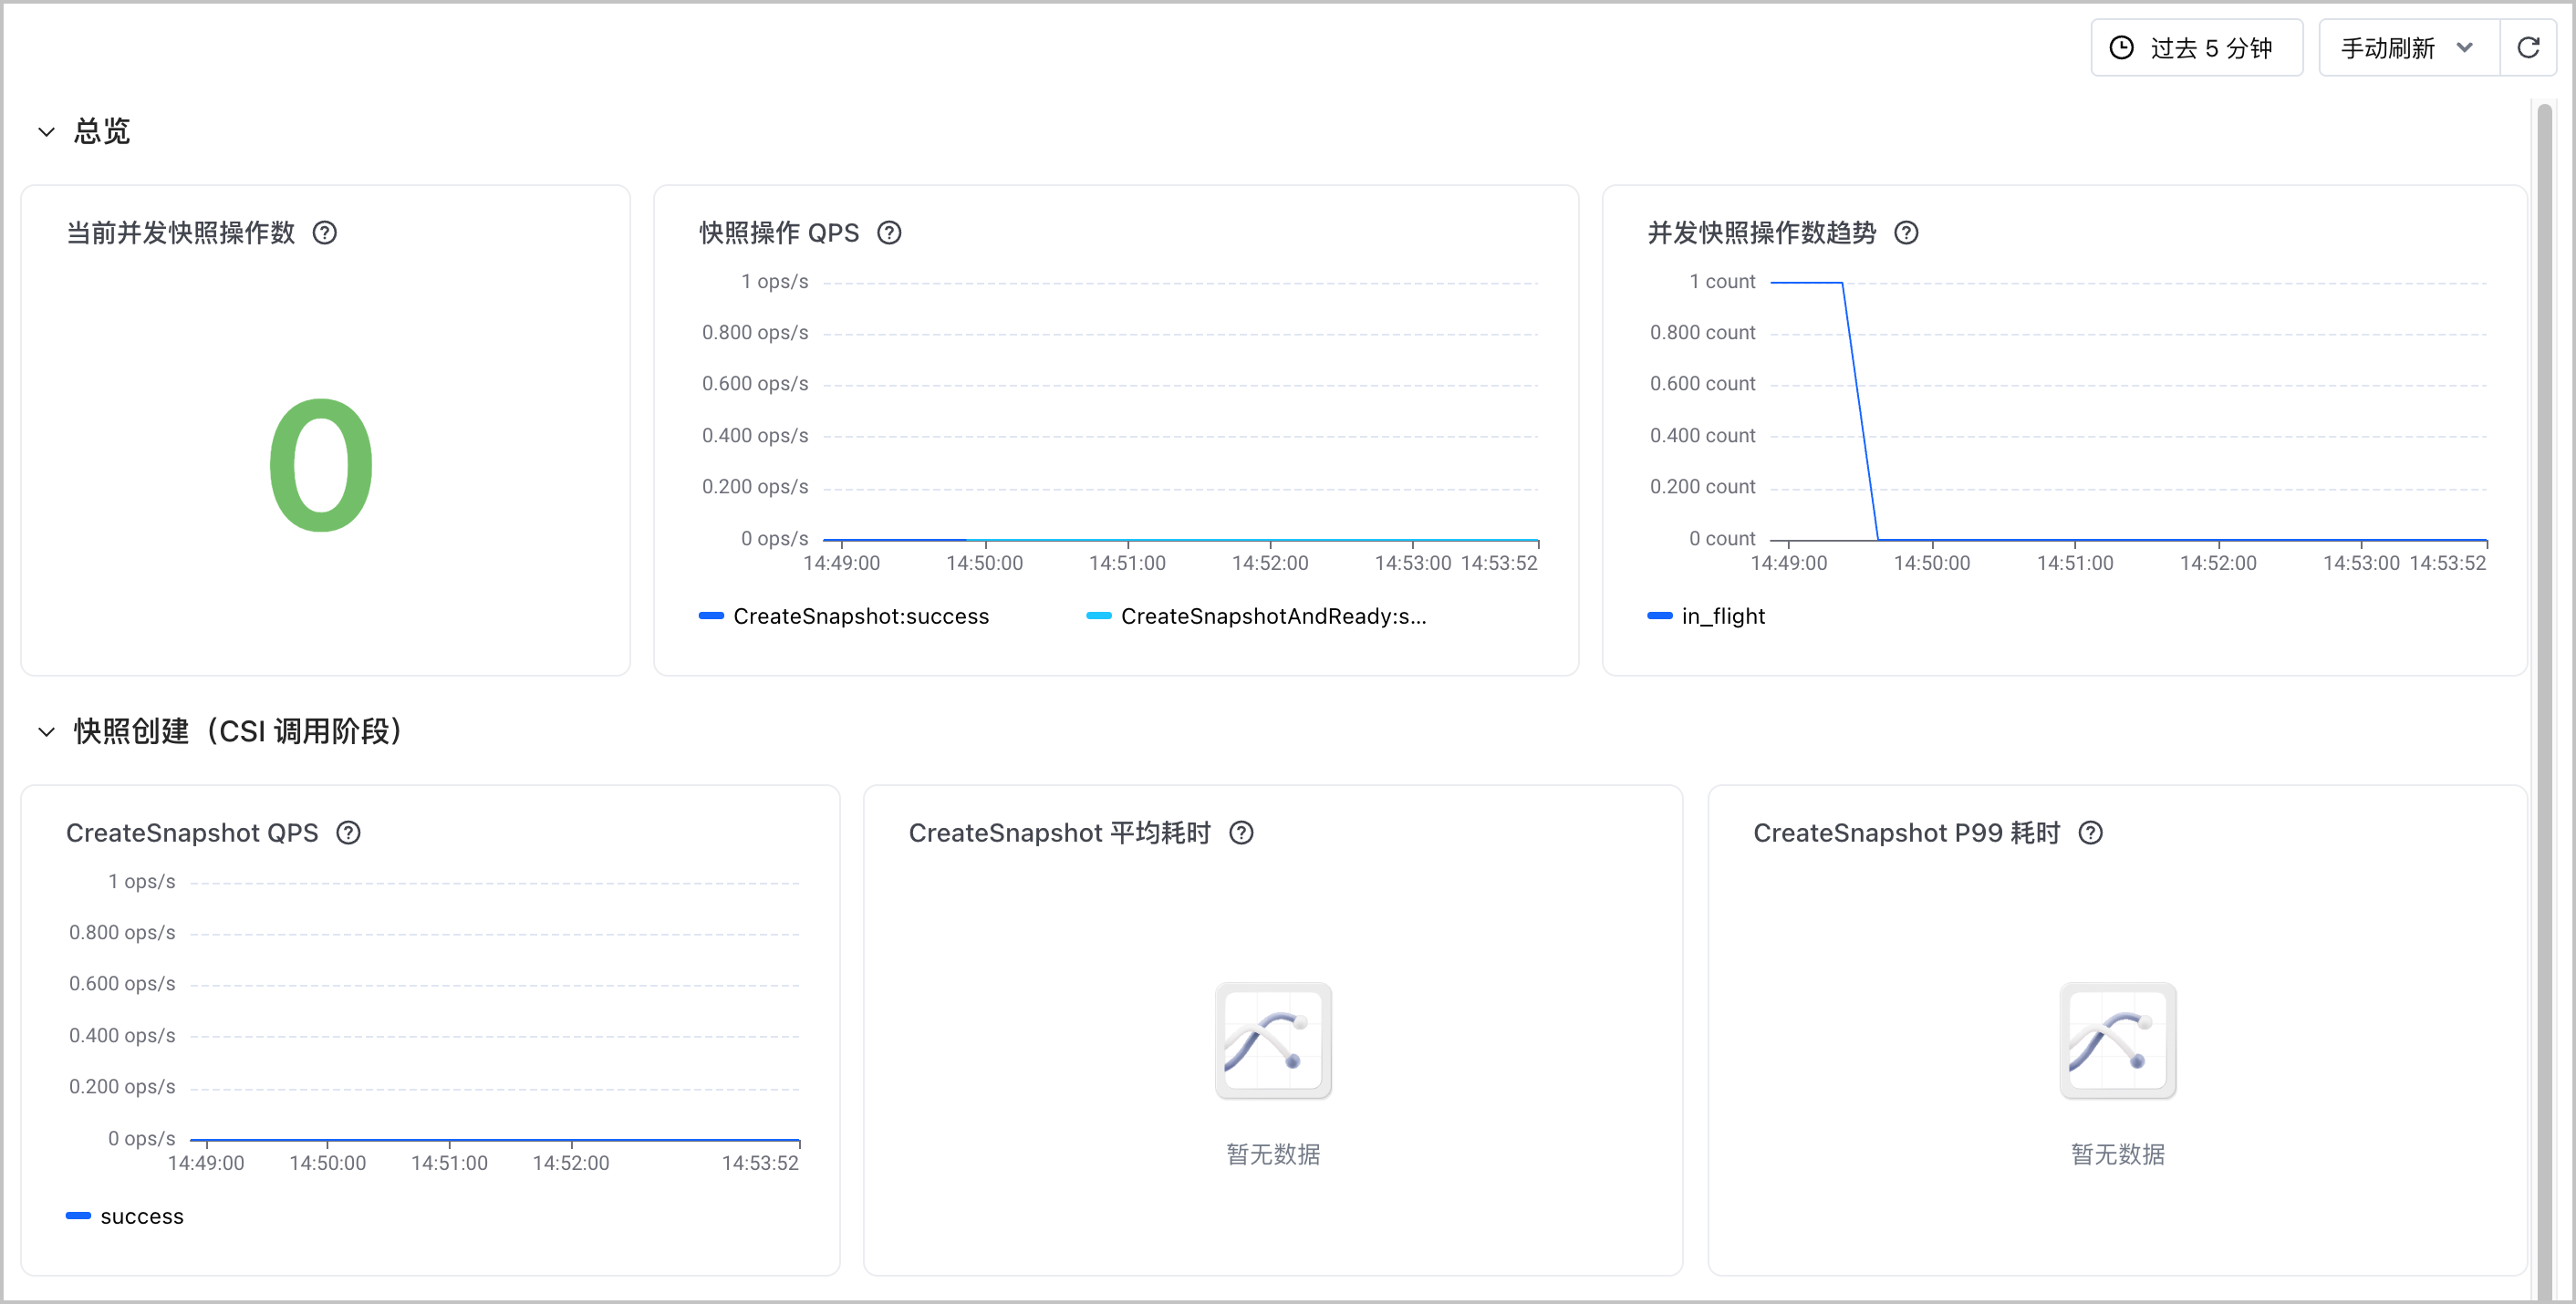
- snapshot-controller 监控看板主要分为 3 个部分,分别面向总览、快照创建和快照创建端到端监控。详细的图表说明,如下表所示。
说明
- 图表名称单位图表说明图表名称单位图表说明总览当前并发快照操作数个统计 Snapshot Controller 当前正在处理的快照操作数量,帮助您判断快照控制器的实时并发负载。
- 正常情况下,该值与当前快照创建和状态同步任务量一致,任务完成后应及时回落。
- 如果该值持续升高、长时间不回落或接近处理能力上限,说明快照操作可能出现积压。例如:后端存储响应缓慢、CSI Driver 调用阻塞、快照长时间未就绪或控制器处理能力不足等。
快照操作 QPS次/秒统计各类快照操作的每秒平均请求次数,并按操作类型和状态展示,帮助您判断快照业务负载和执行结果。- 正常情况下,各操作的 QPS 与快照创建、删除和状态同步等业务频率一致;该值基于过去 5 分钟采样,通常围绕历史基线波动。
- 如果 QPS 突然升高、持续高于历史基线、异常降为 0 或失败状态占比明显增加,说明快照操作负载或控制器状态可能异常。例如:业务请求突增、操作频繁重试、资源状态反复变化或控制器未正常工作等。
并发快照操作数趋势个展示 Snapshot Controller 正在处理的快照操作数量变化趋势,帮助您判断并发负载是否持续增长或出现积压。- 正常情况下,该值随快照任务进入和完成而波动,业务高峰后应逐步回落至历史基线。
- 如果该值持续上涨、长时间保持高位或出现异常尖峰且不回落,说明快照操作可能积压。例如:后端存储响应缓慢、快照长时间未就绪、CSI Driver 调用阻塞或控制器处理能力不足等。
快照创建(CSI 调用阶段)CreateSnapshot QPS次/秒统计 CreateSnapshot 操作的每秒平均请求次数,并按操作状态展示,帮助您判断 CSI 快照创建调用阶段的负载和执行结果。- 正常情况下,该值与快照创建请求频率一致;基于过去 5 分钟采样,通常围绕历史基线波动,成功状态应占主要比例。
- 如果 QPS 突然升高、持续高于历史基线、异常降为 0 或失败状态明显增加,说明 CSI 快照创建调用可能异常。例如:创建请求突增、操作频繁重试、CSI Driver 不可用或请求参数异常等。
CreateSnapshot 平均耗时秒统计 CreateSnapshot 操作的平均耗时,帮助您判断 CSI 快照创建调用阶段的整体响应速度。- 正常情况下,各状态的平均耗时围绕历史基线小幅波动;该值基于过去 60 秒采样,使用累计耗时增速除以操作次数增速计算。
- 如果平均耗时持续升高或明显偏离历史基线,说明 CSI 快照创建调用变慢。例如:CSI Driver 负载过高、后端存储响应缓慢、网络延迟升高或操作频繁重试等。
CreateSnapshot P99 耗时秒统计 CreateSnapshot 操作的 P99 耗时,帮助您判断 CSI 快照创建调用阶段的尾部时延。- 正常情况下,各状态的 P99 耗时围绕历史基线小幅波动;基于过去 5 分钟采样,约 99% 的操作耗时不超过该值。
- 如果 P99 耗时持续升高或频繁出现明显尖峰,说明少量 CreateSnapshot 调用可能严重变慢。例如:CSI Driver 响应缓慢、后端存储负载过高、网络异常或操作频繁重试等。
快照创建端到端(含等待 Ready)CreateSnapshotAndReady QPS次/秒统计 CreateSnapshotAndReady 端到端操作的每秒平均请求次数,并按操作状态展示,帮助您判断从创建快照到快照就绪的整体业务负载和执行结果。- 正常情况下,该值与快照端到端创建请求频率一致;基于过去 5 分钟采样,通常围绕历史基线波动,成功状态应占主要比例。
- 如果 QPS 突然升高、持续高于历史基线、异常降为 0 或失败状态明显增加,说明端到端快照创建流程可能异常。例如:创建请求突增、快照长期未就绪、状态轮询频繁重试或后端存储异常等。
CreateSnapshotAndReady 平均耗时秒统计 CreateSnapshotAndReady 端到端操作的平均耗时,帮助您判断从创建快照到快照就绪的整体响应速度。- 正常情况下,各状态的平均耗时围绕历史基线小幅波动;该值基于过去 60 秒采样,使用累计耗时增速除以操作次数增速计算。
- 如果平均耗时持续升高或明显偏离历史基线,说明端到端快照创建流程变慢。例如:CSI 创建调用变慢、后端快照生成耗时增加、状态同步延迟或轮询重试等。
CreateSnapshotAndReady P90 耗时秒统计 CreateSnapshotAndReady 端到端操作的 P90 耗时,帮助您判断大多数快照从创建到就绪所需的时间。- 正常情况下,各状态的 P90 耗时围绕历史基线小幅波动;基于过去 5 分钟采样,约 90% 的操作耗时不超过该值。
- 如果 P90 耗时持续升高或频繁出现明显尖峰,说明较大比例的端到端快照创建操作变慢。例如:后端快照生成速度下降、状态同步延迟、网络异常或轮询重试等。
CreateSnapshotAndReady P99 耗时秒统计 CreateSnapshotAndReady 端到端操作的 P99 耗时,帮助您判断快照从创建到就绪的尾部时延。- 正常情况下,各状态的 P99 耗时围绕历史基线小幅波动;基于过去 5 分钟采样,约 99% 的操作耗时不超过该值。
- 如果 P99 耗时持续升高或频繁出现明显尖峰,说明少量端到端快照创建操作严重变慢。例如:后端存储响应缓慢、快照长时间未就绪、状态同步异常或操作频繁重试等。
CreateSnapshotAndReady 操作累计次数次统计 CreateSnapshotAndReady 端到端操作的完成次数,并按操作状态展示,帮助您判断近期快照创建结果和失败规模。- 正常情况下,成功状态的次数应与近期快照创建任务量一致,失败状态应为 0 或仅偶发出现;该值统计过去 2 分钟内新增的完成次数。
- 如果失败状态的次数持续增加、成功次数异常下降或总次数明显偏离业务预期,说明端到端快照创建流程可能异常。例如:CSI 调用失败、快照长期未就绪、后端存储异常或状态同步失败等。
快照操作延迟分布对比秒对比各类快照操作的 P50、P90 和 P99 耗时,帮助您判断不同操作的典型时延和尾部时延差异。- 正常情况下,同一操作的 P50、P90 和 P99 按分位数依次升高,并围绕各自历史基线波动;该值基于过去 5 分钟采样计算。
- 如果某类操作的 P90 或 P99 明显升高、与 P50 差距持续扩大或整体分位数同步上升,说明该操作存在尾部延迟或整体变慢。例如:后端存储负载升高、CSI Driver 响应缓慢、网络抖动或部分请求频繁重试等。
查看指标
- 如需查询集群中的已接入/未接入指标,或查询指标的具体含义,请参见 指标查询。
- 支持使用托管 Prometheus 的 Explore 功能来快速查询和展示指标数据。详情请参见 指标查询。
最近更新时间:2026.10.16 15:59:50
这个页面对您有帮助吗?
有用
有用
无用
无用