容器服务
容器服务
容器服务


文档指南
请输入


容器服务 VKE
产品动态
Kubernetes 版本发布记录
组件发布记录
监控组件
DNS 组件
GPU 组件
Sandbox 组件
安全公告
产品公告
历史公告
用户指南
集群
节点池
授权
网络
容器网络
服务(Service)
路由(Ingress)
APIG Ingress
ALB Ingress
自定义转发规则配置示例
CLB Ingress
Nginx Ingress
Gateway API
工作负载
存储
数据管理中心(DMC)
对象存储(TOS)
FSX 访问方式
文件存储(NAS)
FSX 访问方式
弹性文件存储(EFS)
文件存储(vePFS)
FSX 访问方式
vePFS Client 访问方式
NFS 访问方式
大数据文件存储(CloudFS)
弹性伸缩
工作负载弹性伸缩
事件驱动伸缩(KEDA)
组件管理
网络组件
监控组件
DNS 组件
GPU 组件
Sandbox 组件
异构计算
调度管理
可观测性
基础观测
诊断与巡检
最佳实践
网络
可观测性
安全合规
API 参考
集群管理
节点池管理
组件管理
机型镜像管理
云原生观测
巡检诊断
弹性容器实例
附录
开发指南
常见问题
通用 FAQ
集群 FAQ
集群管理
集群升级
节点与节点池 FAQ
授权 FAQ
工作负载 FAQ
服务与路由 FAQ
存储 FAQ
弹性伸缩 FAQ
可观测性 FAQ
配额 FAQ
组件 FAQ
容器镜像 FAQ
AI 云原生
推理套件
Helm 模板 AI 应用
Deepseek 实践
Qwen 实践
最佳实践
MiniMax 模型部署
Qwen 模型部署
弹性容器实例 VCI
最新动态
用户指南
虚拟节点
VKE 集群使用虚拟节点
自建/跨云集群使用虚拟节点
创建 VCI 实例
VCI Agent Sandbox
安全合规
- 文档首页
 容器服务容器服务 VKE常见问题异构计算 FAQGPU 实例硬件相关问题
 复制全文
 下载 pdf
GPU 实例硬件相关问题
 文档反馈
 问问助手
本文主描述 GPU 实例硬件相关问题及其解决方法。
如何判断和处理硬件相关故障?
GPU实例相比普通云服务器实例,增加了较多的外设,包括GPU、RDMA网络直通网卡、本地盘等。因此,除普通云服务器可能发生的常见问题外,还有如GPU、直通网卡以及PCIe链路上发生的亚健康或故障。针对GPU实例的常见故障和处理建议具体如图1所示。
图1 常见故障及处理建议
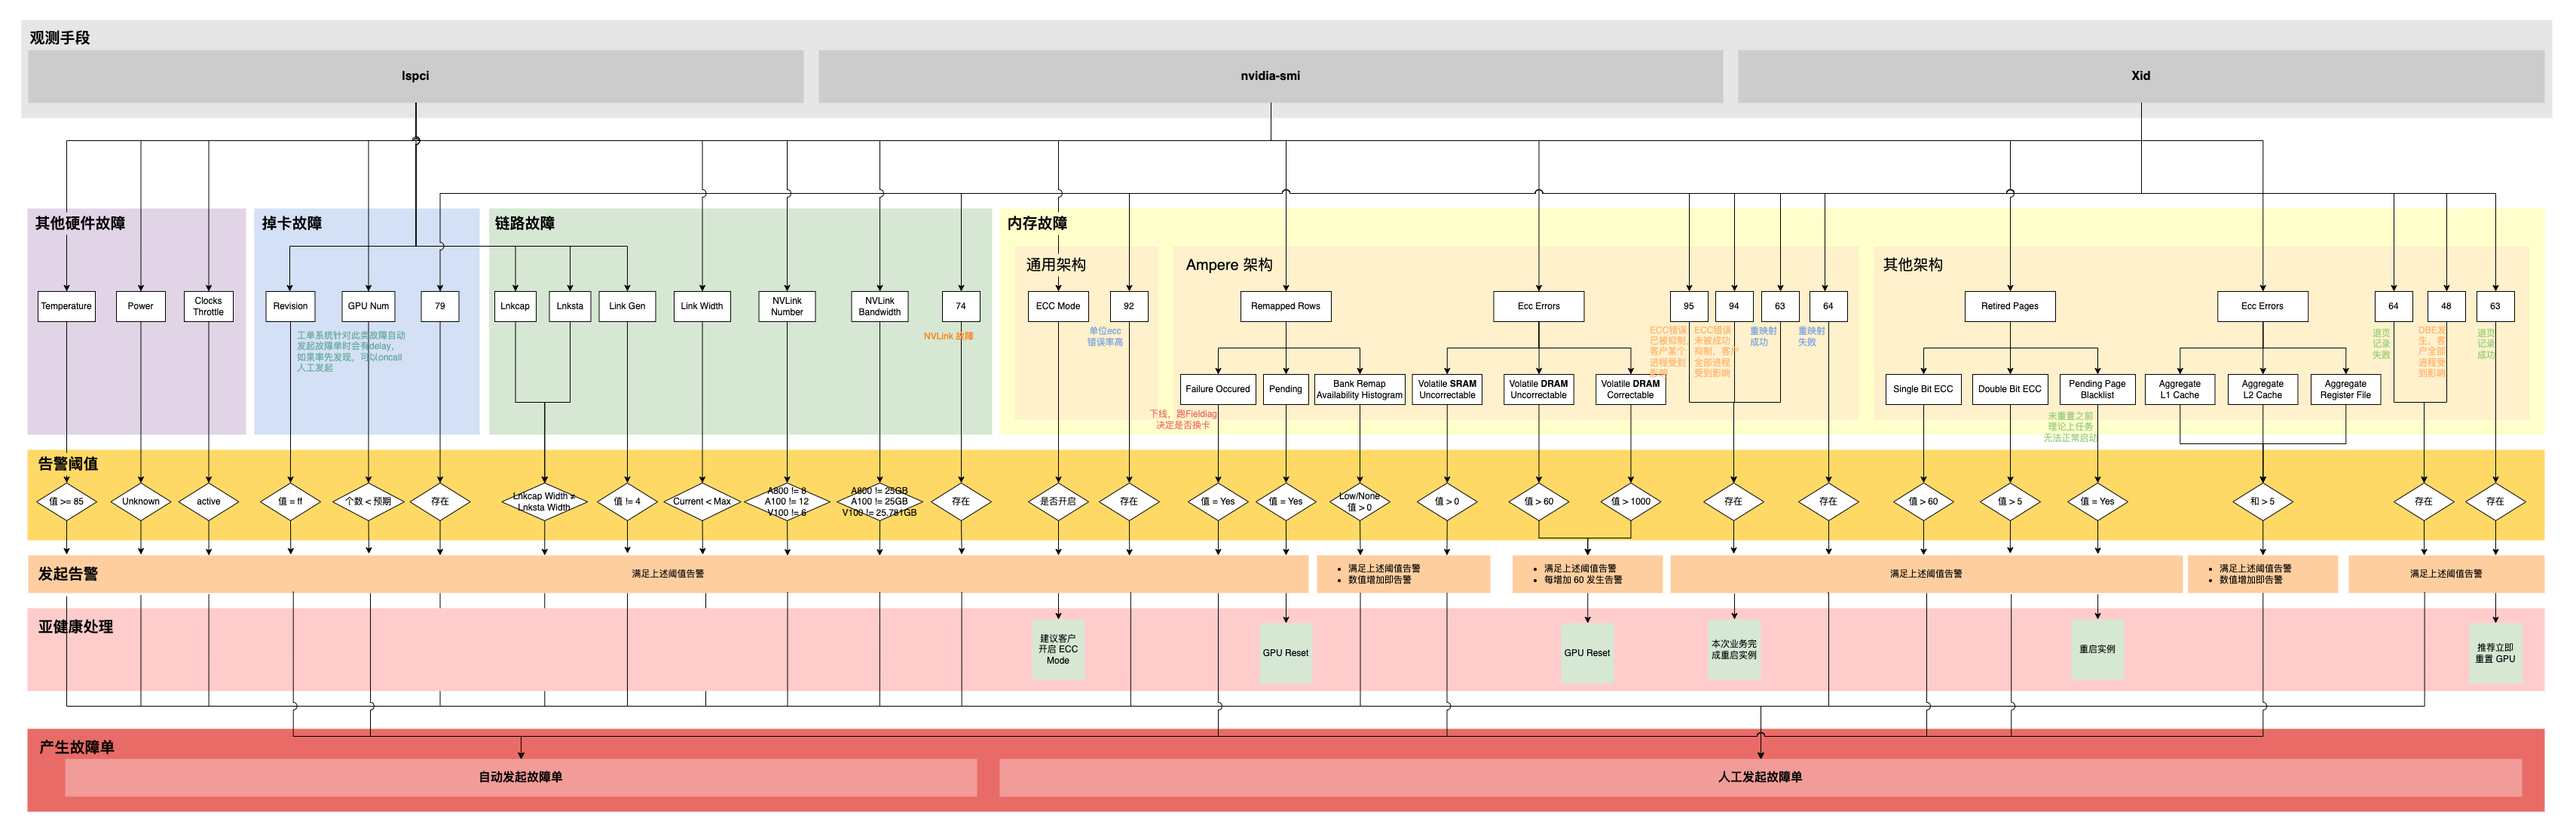
图2 故障处理流程
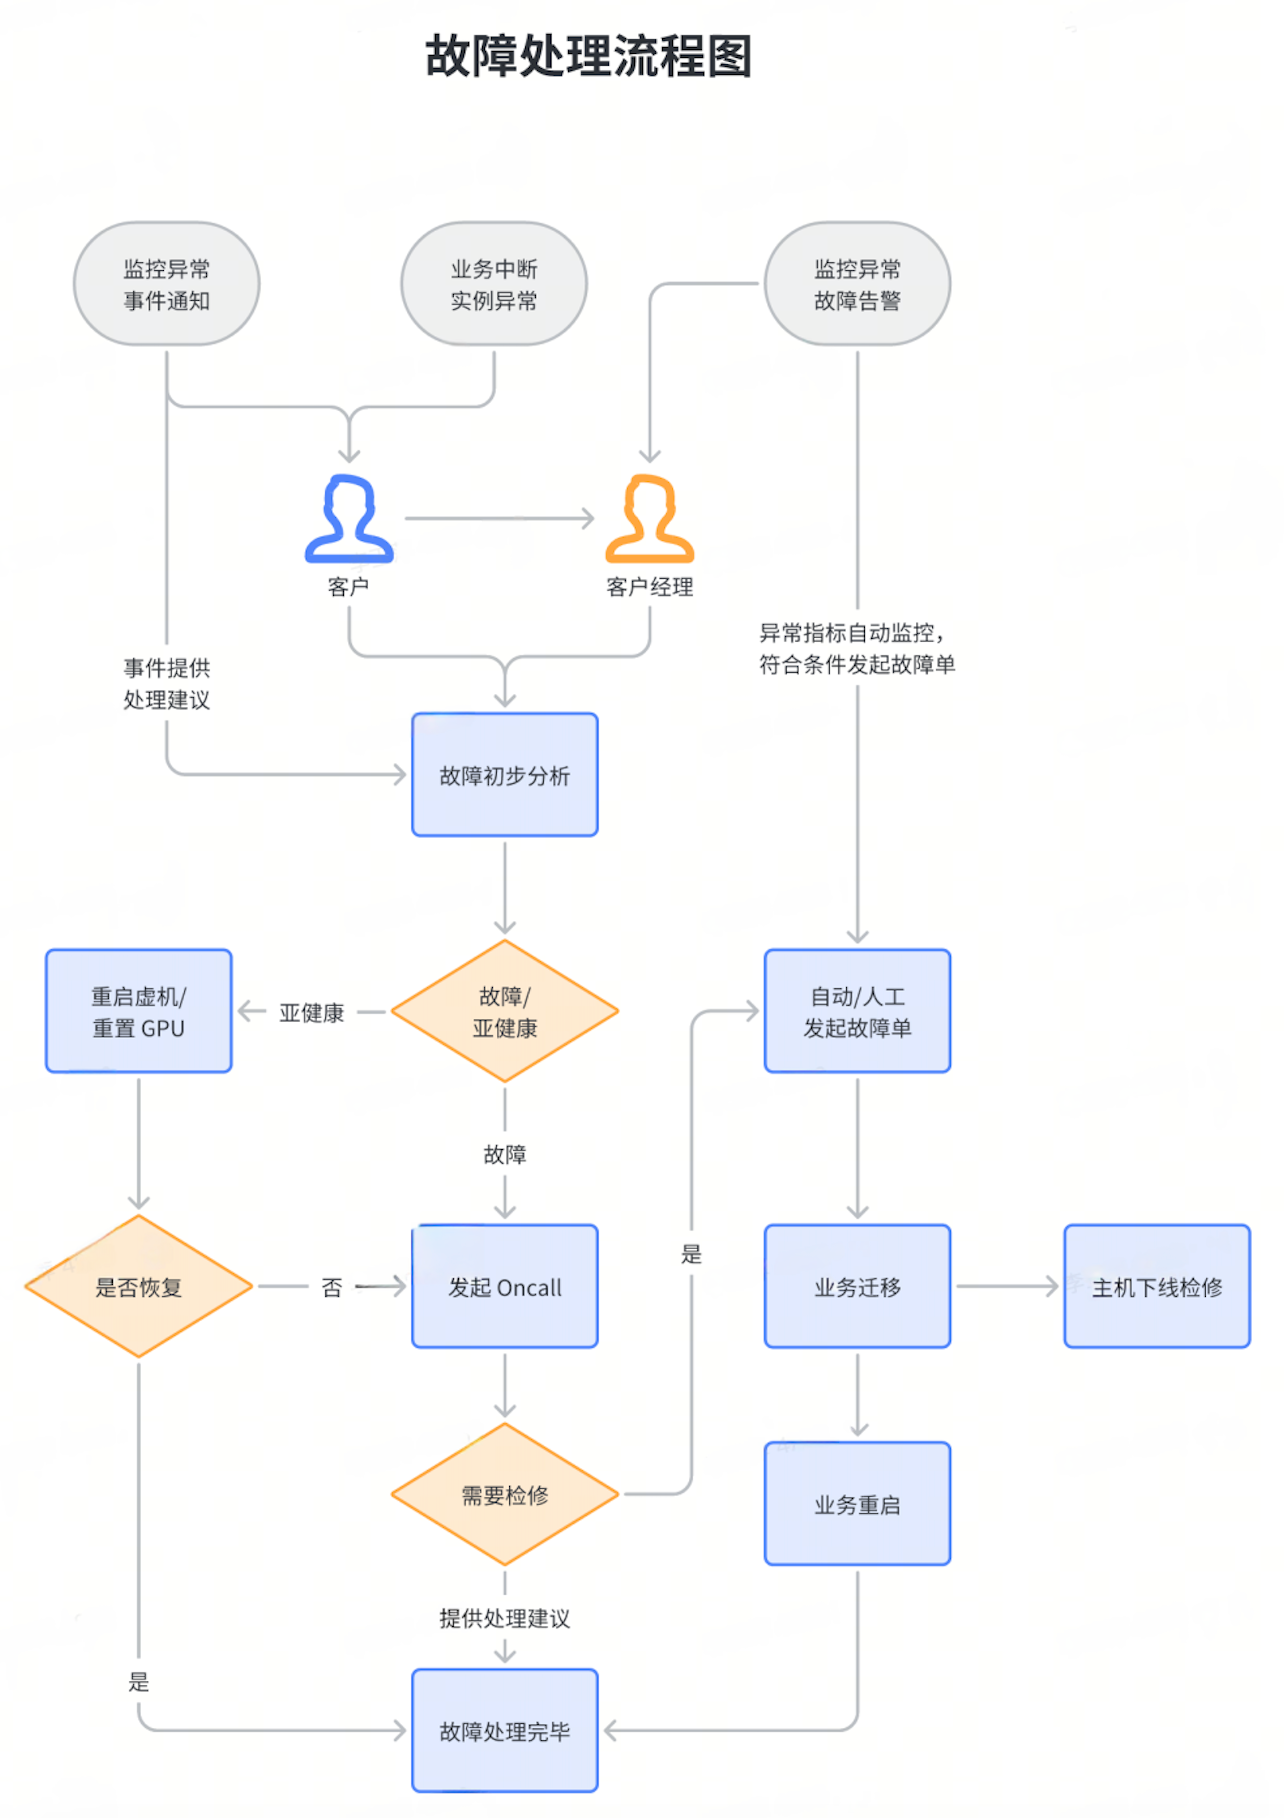
GPU亚健康或故障处理流程如图2所示,以下重点介绍亚健康现象的处理流程。
- 当发生“监控异常事件通知”、“业务中断实例异常”情况时,需要分析是否为亚健康现象(参考图1)。
- 若不是,则为故障,请发起Oncall或提交工单处理。
- 查看亚健康现象是否恢复。
- 未恢复,发起Oncall或提交工单处理。
- 已恢复,处理完毕。
常见问题列表
相关文档 |
相关文档 | |
掉卡故障 | |
链路故障 | |
内存故障 | |
| |
| |
- | |
- |
如何查看GPU是否掉卡?
- 方式一
- 登录实例。
- 执行如下命令,若回显结尾为(rev ff),表明GPU识别异常。
- lspci | grep -i nvidia
- # lspci | grep -i nvidia31:00.0 3D controller: NVIDIA Corporation Device 2236 (rev a1)65:00.0 3D controller: NVIDIA Corporation Device 2236 (rev a1)98:00.0 3D controller: NVIDIA Corporation Device 2236 (rev a1)e3:00.0 3D controller: NVIDIA Corporation Device 2236 (rev ff)
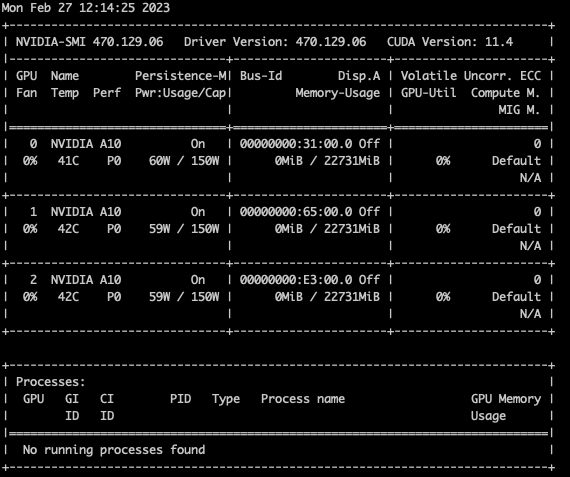
- 执行如下命令查看GPU卡数量,如下图,查询的是4卡规格,丢失1张。
- nvidia-smi
-
- 方式二
- 登录实例。
- 执行如下命令查看系统日志。
- cat /var/log/kern.log | grep -i xid
- 回显如下,表明GPU卡丢失。
-

如何查看带宽/链路是否正常?
- 方式一:Lspci带宽检测
- 登录实例。
- 执行如下命令。
- lspci -vvd 10de: | grep -i "Lnkcap:\|Lnksta:"
- 回显如下,其中Lnkcap为额定带宽,Lnksta为当前带宽,两者一致则表明带宽/链路未发生异常。
- # lspci -vvd 10de: | grep -i Lnkcap:LnkCap: Port #0, Speed 8GT/s, Width x16, ASPM not supportedLnkCap: Port #4, Speed 8GT/s, Width x16, ASPM not supportedLnkCap: Port #16, Speed 8GT/s, Width x16, ASPM not supportedLnkCap: Port #20, Speed 8GT/s, Width x16, ASPM not supported# lspci -vvd 10de: | grep -i Lnksta:LnkSta: Speed 2.5GT/s (downgraded), Width x16 (ok)LnkSta: Speed 2.5GT/s (downgraded), Width x16 (ok)LnkSta: Speed 2.5GT/s (downgraded), Width x16 (ok)LnkSta: Speed 2.5GT/s (downgraded), Width x16 (ok)
- 方式二:Nvidia-smi检查
- 登录实例。
- 执行如下命令。
- nvidia-smi -q | grep -i -A 2 'Link width'
- 回显如下,Max和Current的值保持一致,表明带宽/链路未发生异常。
- # nvidia-smi -q | grep -i -A 2 'Link width'Link WidthMax : 16xCurrent : 16x--Link WidthMax : 16xCurrent : 16x--Link WidthMax : 16xCurrent : 16x--Link WidthMax : 16xCurrent : 16x
如何判断GPU实例是否为Ampere架构?
根据GPU显卡判断架构类型,具体如下表所示。
架构类型 | GPU卡 | 实例规格 |
架构类型 | GPU卡 | 实例规格 |
Ampere 架构 | A100 | |
| A800 | |
| A30 | |
| A10 | |
Volt 架构 | V100 | |
Turing 架构 | T4 | |
如何查看Remapped Rows相关指标(仅Ampere架构)?
Remapped Rows是NVIDIA Ampere架构新增的一种硬件机制,用于提高GPU上帧缓冲存储器的可靠性,GPU检测到内存错误时,会尝试重新映射到GPU设备内存行,当一行被重新映射时,NVIDIA驱动程序会将错误的行重新映射到保留行,后续对该行的所有访问都将访问保留行而不是错误行。
您可以通过以下操作查看Remapped Rows相关指标:
- 登录实例。
- 执行如下命令。
- nvidia-smi -q -d ECC,ROW_REMAPPER
- 正常返回如下图所示。
-
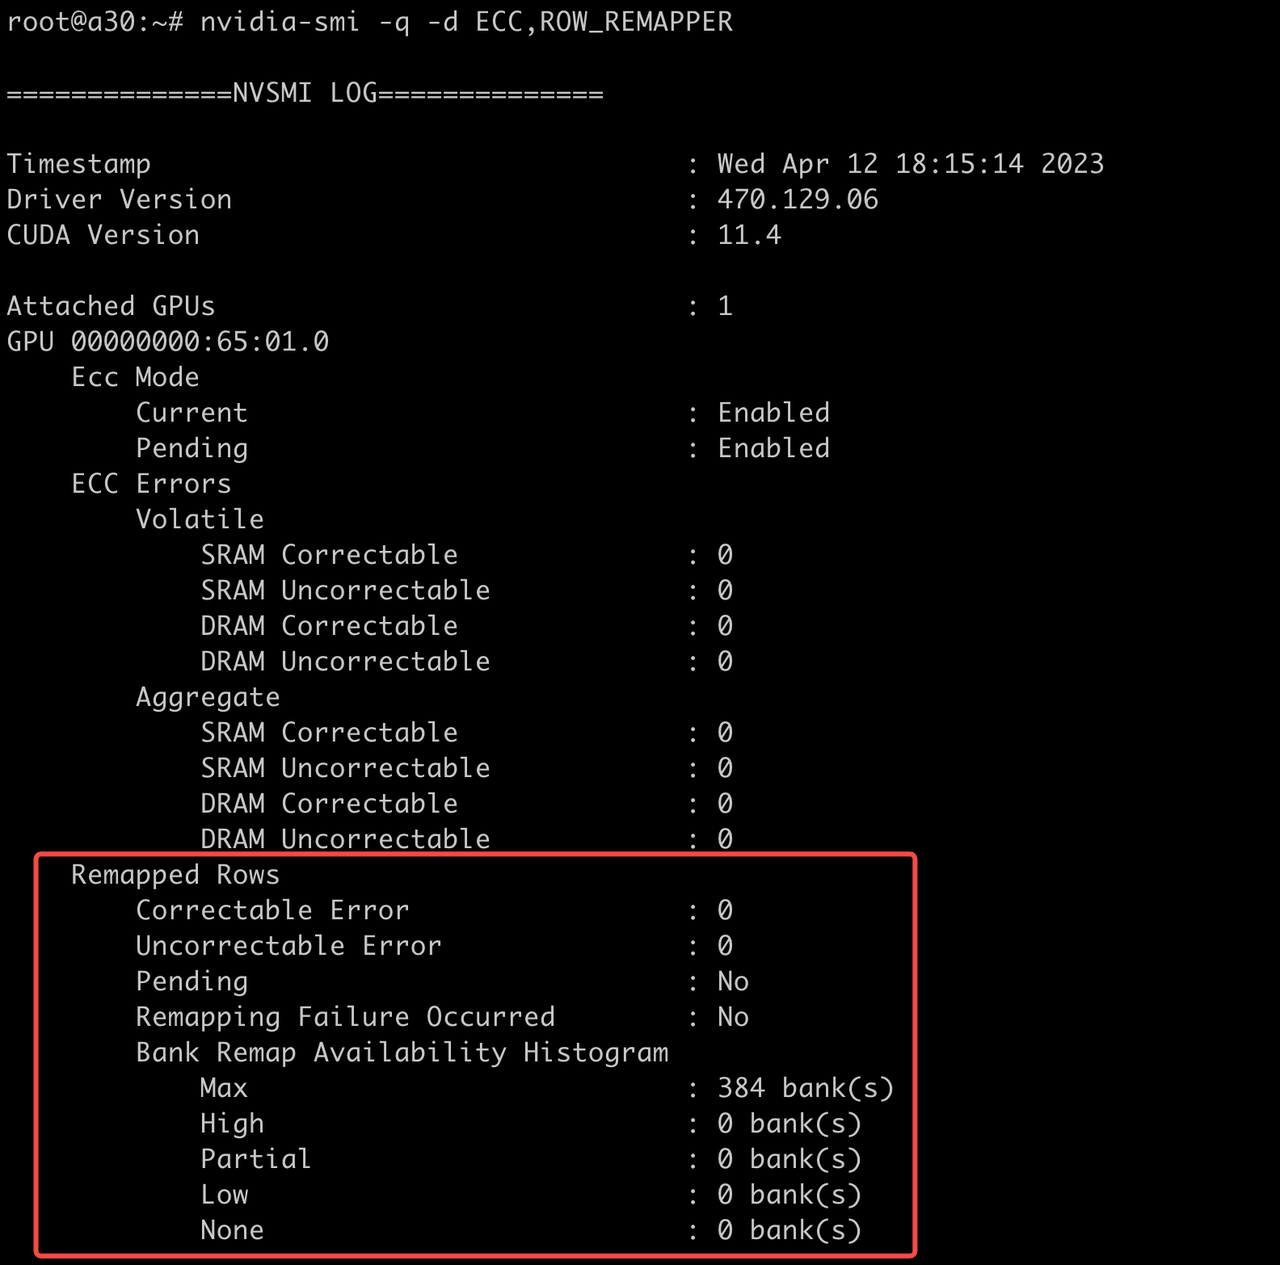
- 如果Pending指标为YES,表示当前发生行重映射,需要重启实例。
- 如果Remapping Failure Occurred指标为YES,表示当前行重映射发生异常,主机需要下线检修。
- 如果Bank Remap Availability Histogram指标的Low/None值 > 0,表示可用的重映射保留行不足,主机需要下线检修。
如何查看Retired Pages相关指标(除Ampere外的其它架构)?
当发生Double Bit ECC错误或多个Single Bit ECC错误时,可能会淘汰GPU设备内存页面。当页面被淘汰时,NVIDIA驱动程序会将其隐藏,这样任何驱动程序或应用程序内存分配都无法访问该页面。
ECC:Error Correcting Code,错误检查和纠正技术。
您可以通过以下操作查看Retired Pages相关指标:
- 登录实例。
- 执行如下命令。
- nvidia-smi -q -d ECC,PAGE_RETIREMENT
- 正常返回如下图所示。
-
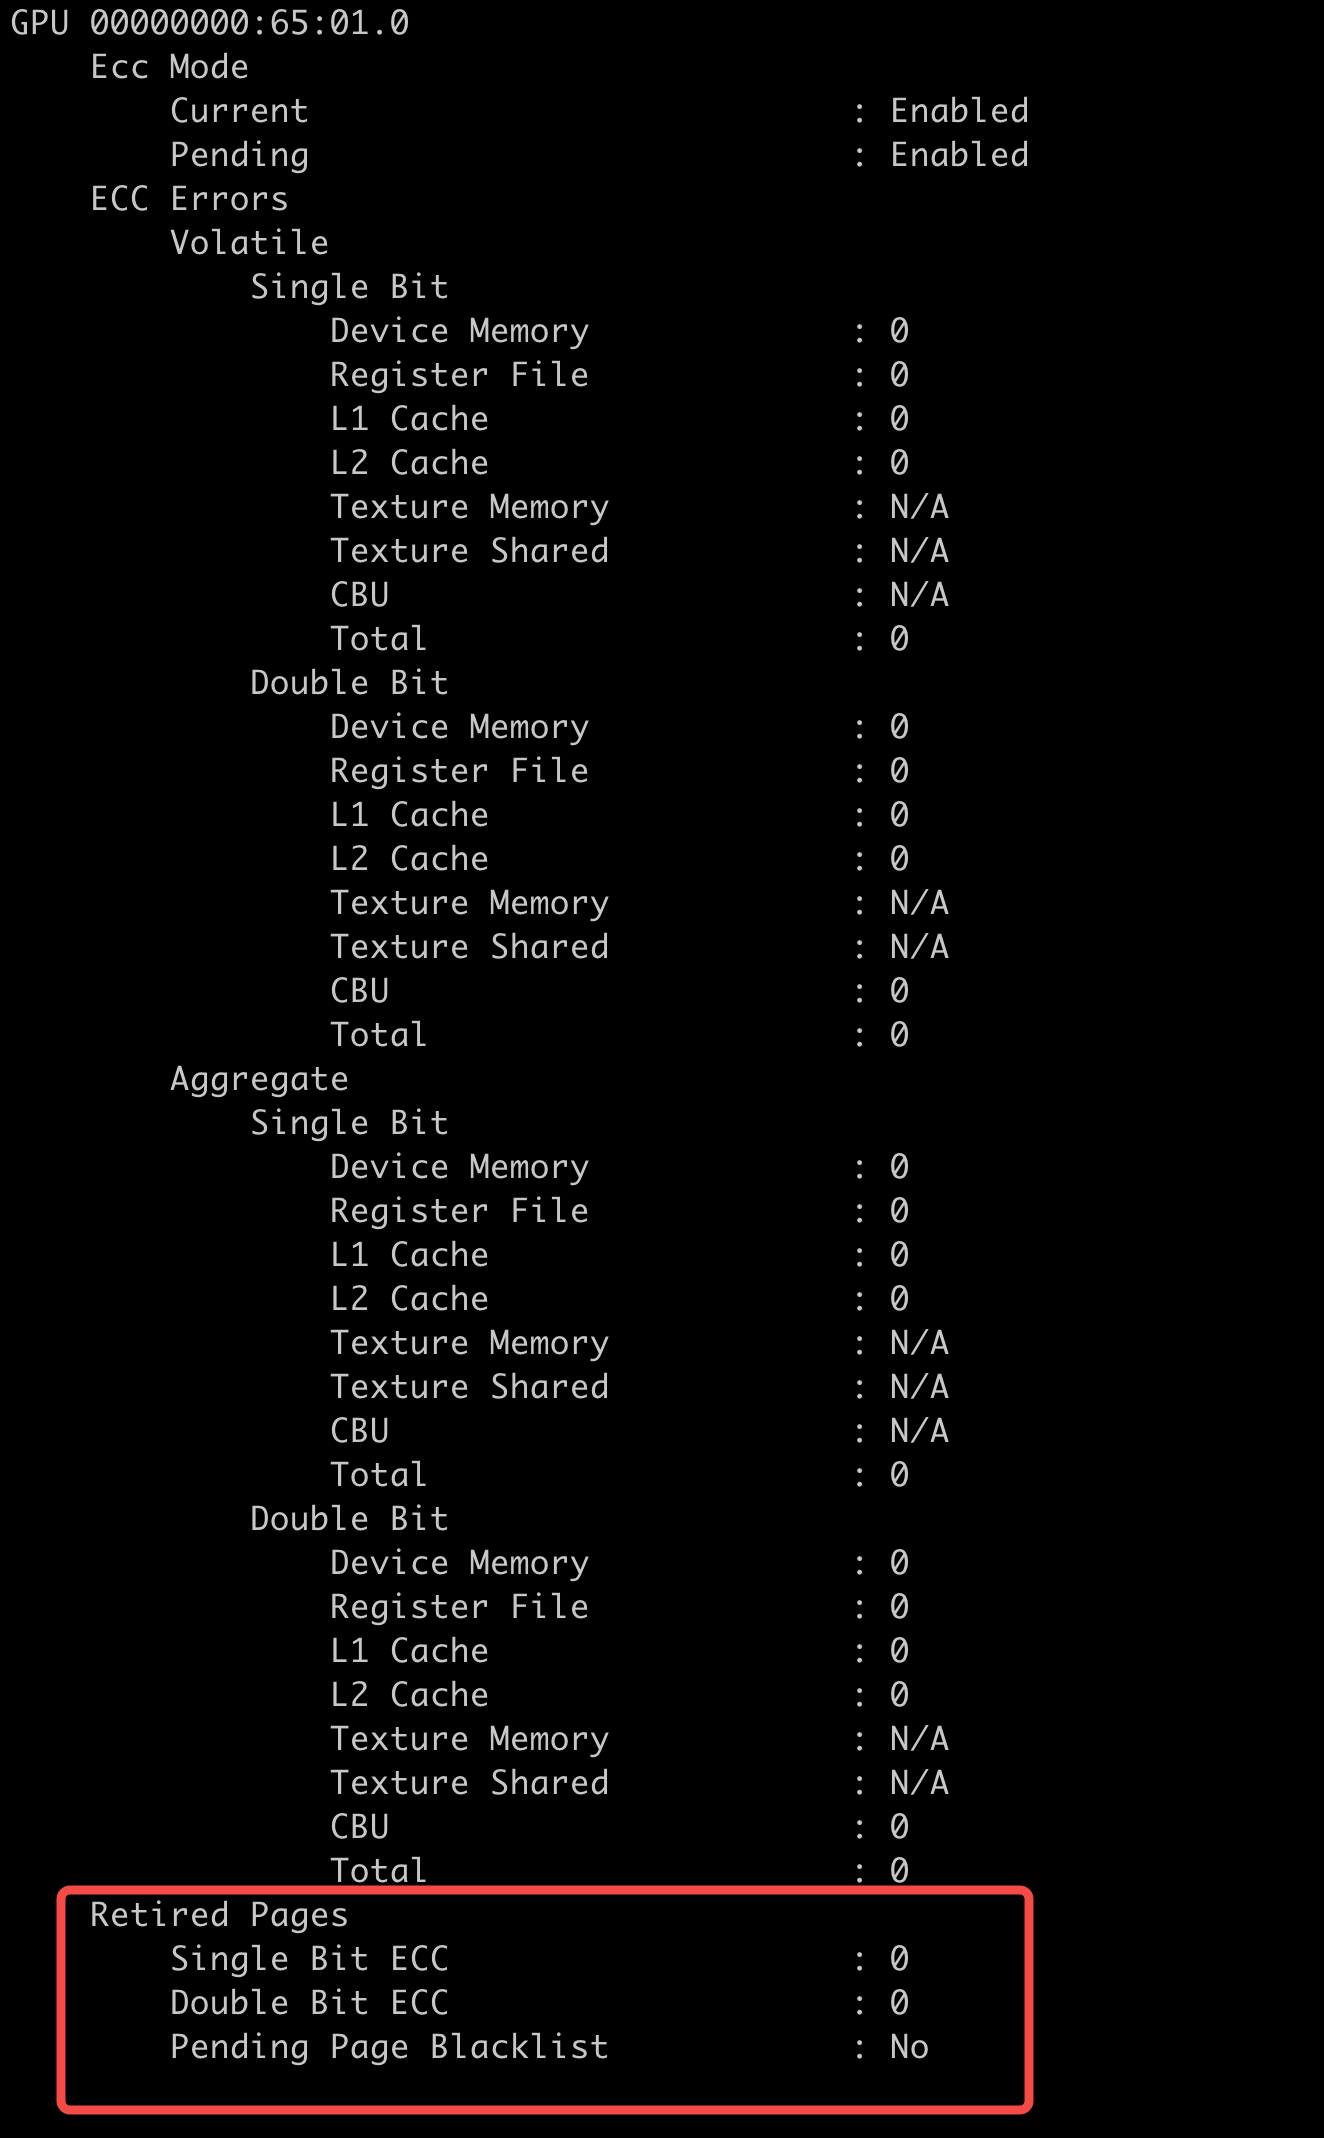
- 如果Pending Page Blacklist指标为YES,需要重启实例。
- Single Bit ECC错误淘汰的内存页数超过60或者Double Bit ECC错误淘汰的内存页数超过5(见图1),需要下线检修物理机。
如何查看Xid信息?
XID是指“X Error ID”,是一种错误代码,用于标识在GPU操作期间发生的错误。XID通常与GPU硬件或驱动程序中的错误相关,例如内存错误、电源问题、温度过高等。
当GPU检测到错误时,它会生成一个XID并记录在系统日志中,管理员可以查看系统日志以查找与XID相关的错误信息,并采取适当的措施来修复问题。
您可以通过以下操作查看Xid信息:
- 登录实例。
- 执行如下命令。
- cat /var/log/messages | grep "Xid (PCI"
- cat /var/log/kern.log | grep "Xid (PCI"
- 结果如下图所示。
-

如何收集NVIDIA日志?
- 虚拟机场景
- 登录实例。
- 执行如下命令。
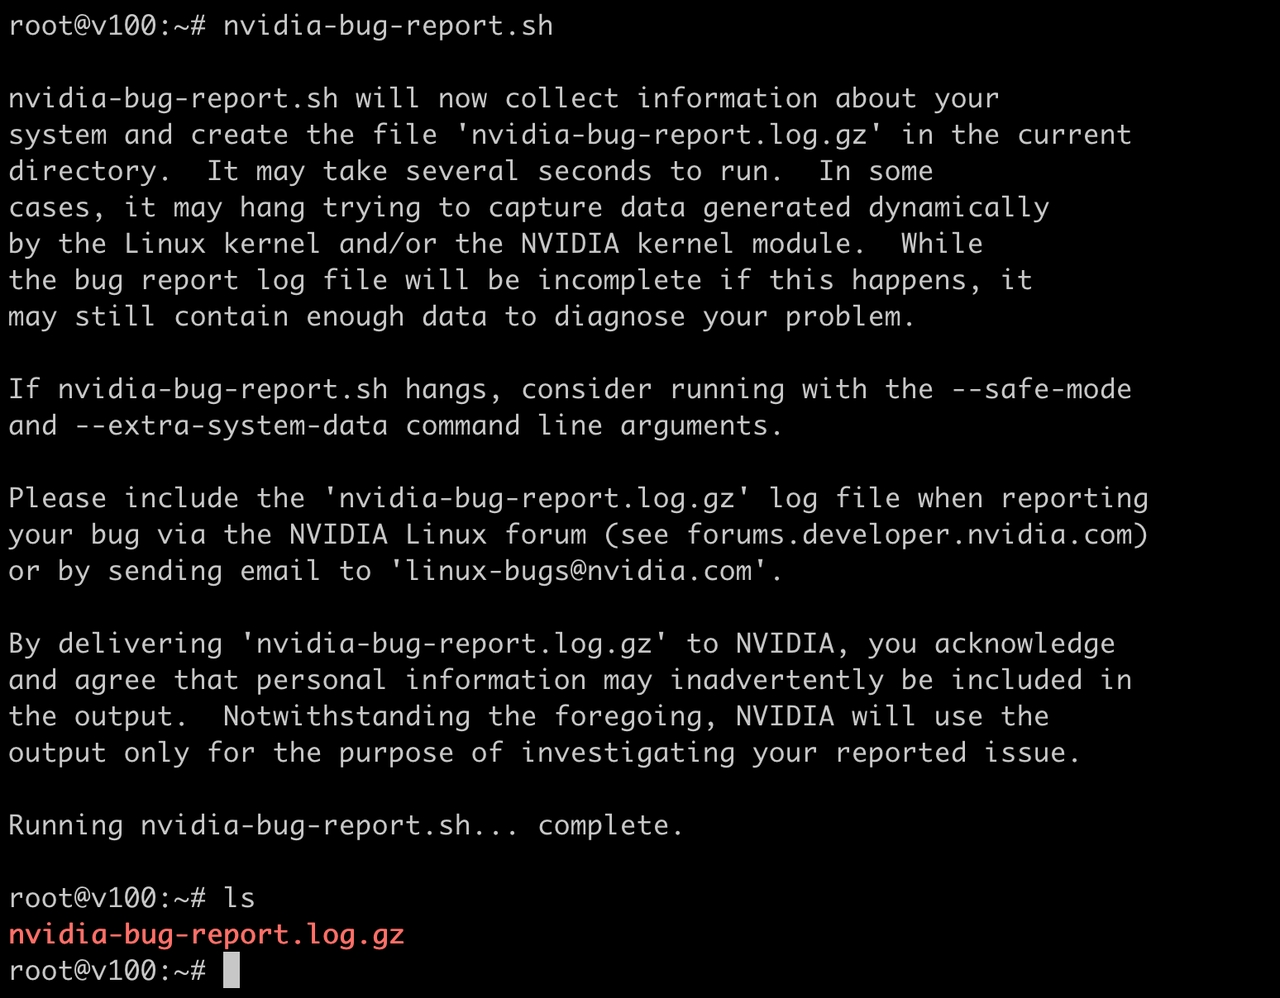
- nvidia-bug-report.sh
- 收集到的文件如下图所示。
-
- VKE场景
- 登录实例。
- 执行如下命令获取日志下载链接。
- curl -s https://diagnose-beijing.tos-cn-beijing.ivolces.com/cmds/diagnose.sh | bash
- 结果如下图所示。
-

- 执行上面生成的wget命令获取日志文件。
最近更新时间:2025.08.08 15:35:14
这个页面对您有帮助吗?
有用
有用
无用
无用