You need to enable JavaScript to run this app.
文档中心
容器服务

容器服务

复制全文
下载 pdf
调度
负载感知调度最佳实践
复制全文
下载 pdf
负载感知调度最佳实践
本文主要介绍 VKE 负载感知调度能力相关的最佳实践。​
适用场景​
负载感知调度是 VKE 提供的基于节点真实负载进行调度的策略。调度过程中,调度器会参考节点负载的历史指标,将 Pod 优先调度到负载较低的节点,实现节点负载均衡,降低单个节点负载过高导致应用或节点故障的概率。根据不同的业务场景,推荐使用方式如下。​
​
场景​
推荐方式​
关键配置​
适用业务​
在线服务避开热点节点​
将负载感知生效范围设置为特定 Pod,给目标工作负载添加 Annotation。​
vke.volcengine.com/load-aware-enabled: "true",并设置 CPU、Memory 阈值。​
Web 服务、网关、常驻 Worker、对 P95/P99 延迟敏感的服务。​
不同节点池设置不同阈值​
通过 NodeSchedulingConfig 为不同节点池覆盖不同负载阈值。​
使用节点池 Label 匹配节点,分别设置 cpu、memory 目标阈值。​
通用计算池、内存型节点池、高配节点池、混部节点池并存的集群。​
存量集群灰度推广​
先选择少量工作负载灰度,再扩大到同类服务,最后评估是否全局开启。​
生效范围优先选择特定 Pod,观察 Pending、调度事件和节点热点变化。​
已有生产业务运行、调度策略变更风险较高的集群。​
​
短生命周期 Job 不建议默认开启负载感知调度。Job 调度完成后很快退出,调度时看到的节点负载可能很快变化,收益通常低于在线服务。​
前置检查​
  • 集群处于运行中状态,且至少存在两个需要均衡负载的节点。​
  • 集群 Kubernetes 版本满足负载感知调度要求,并已安装 scheduler-plugin 组件。​
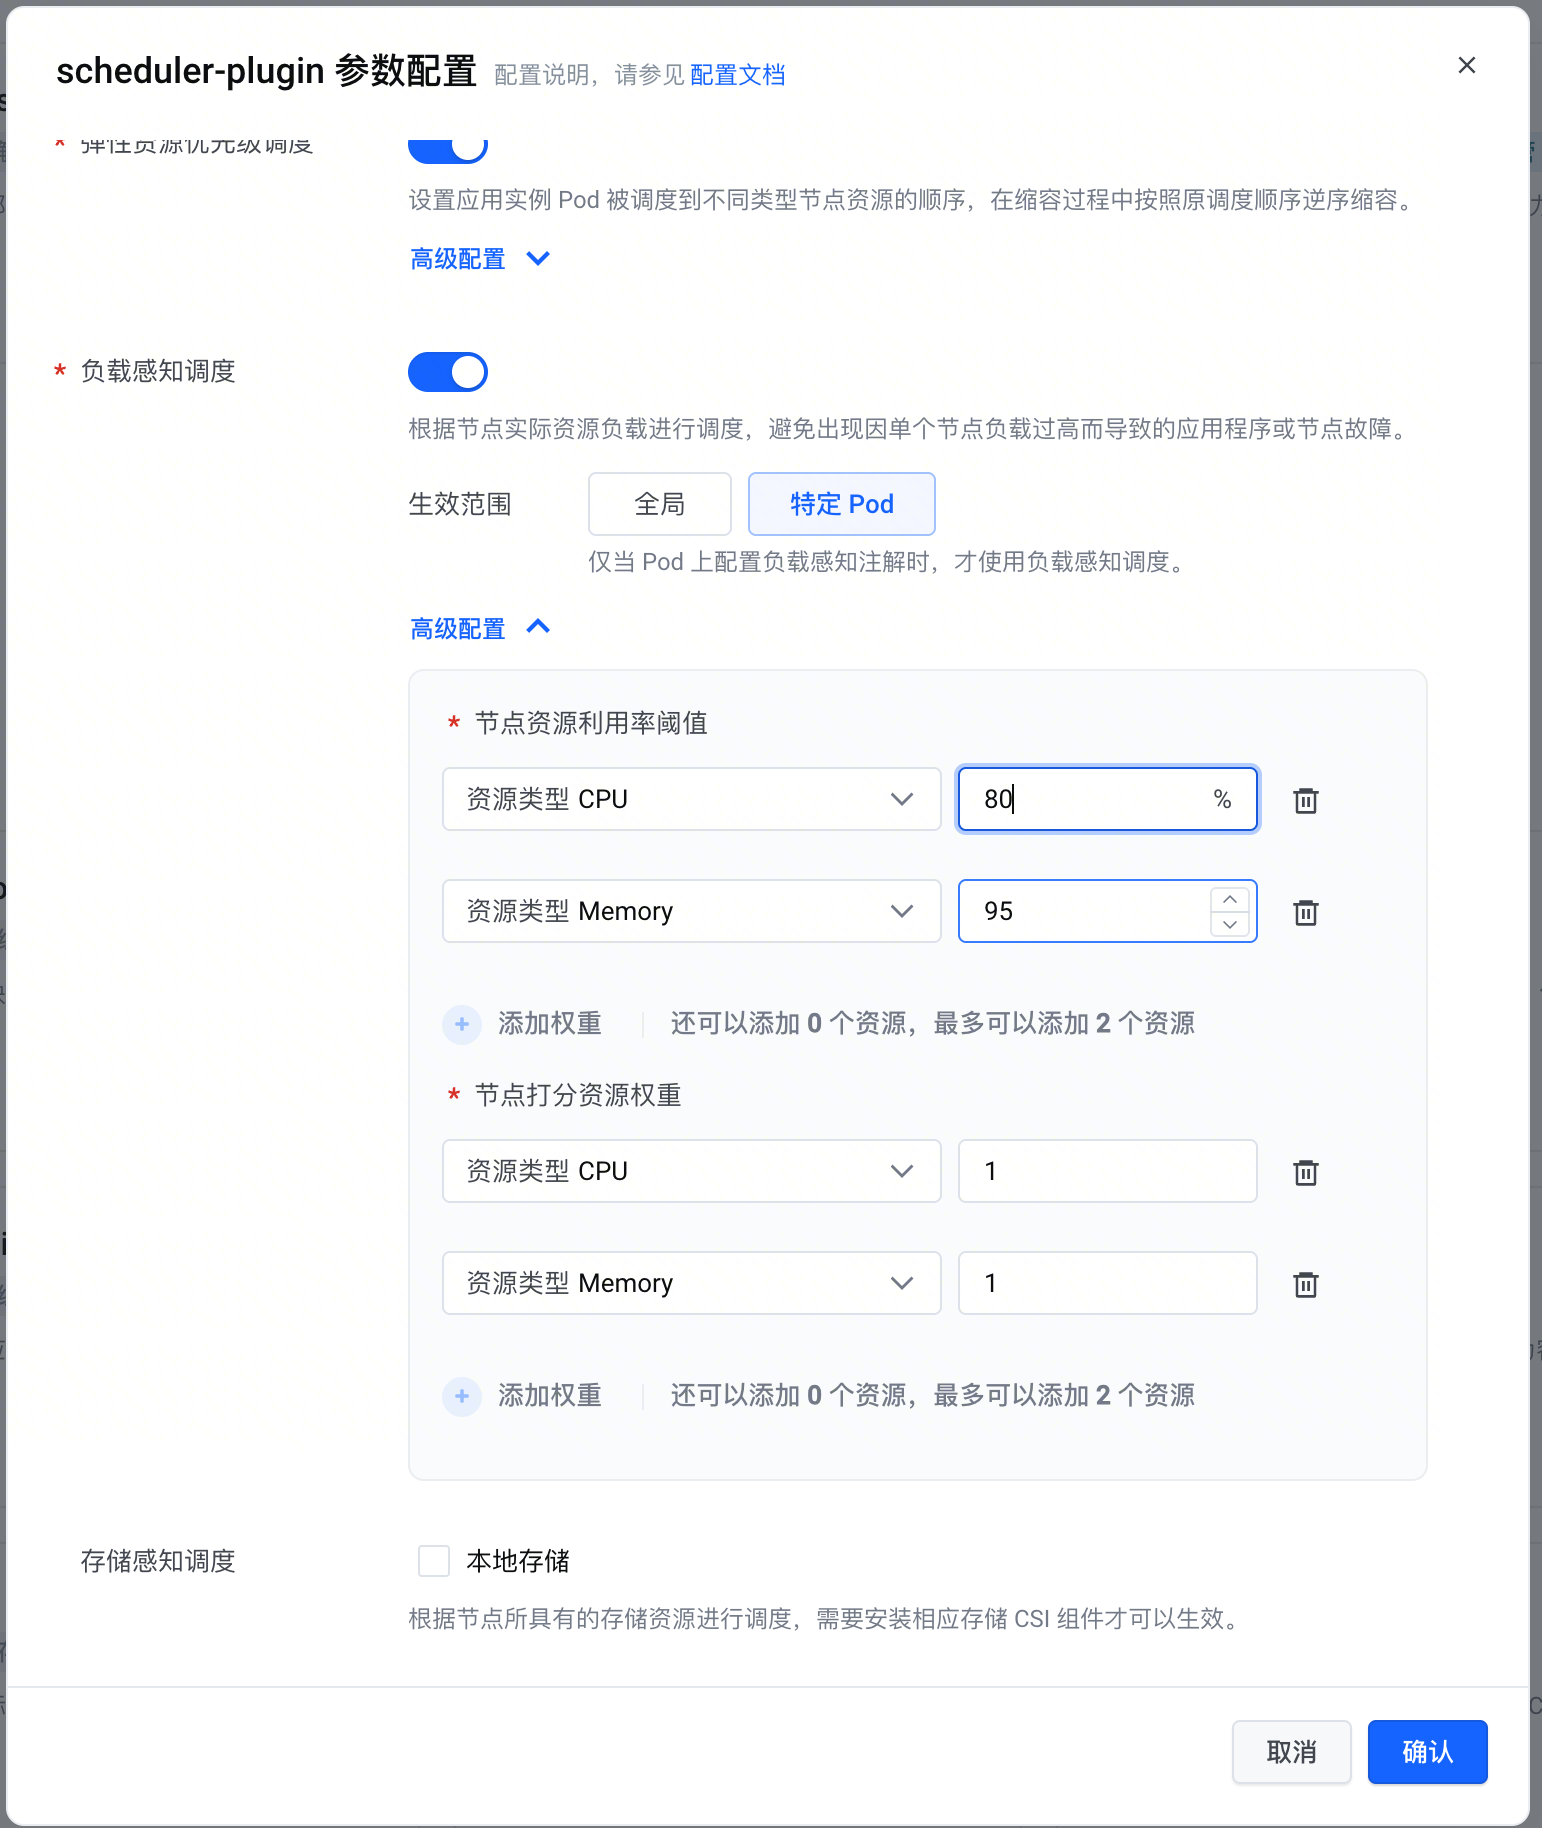
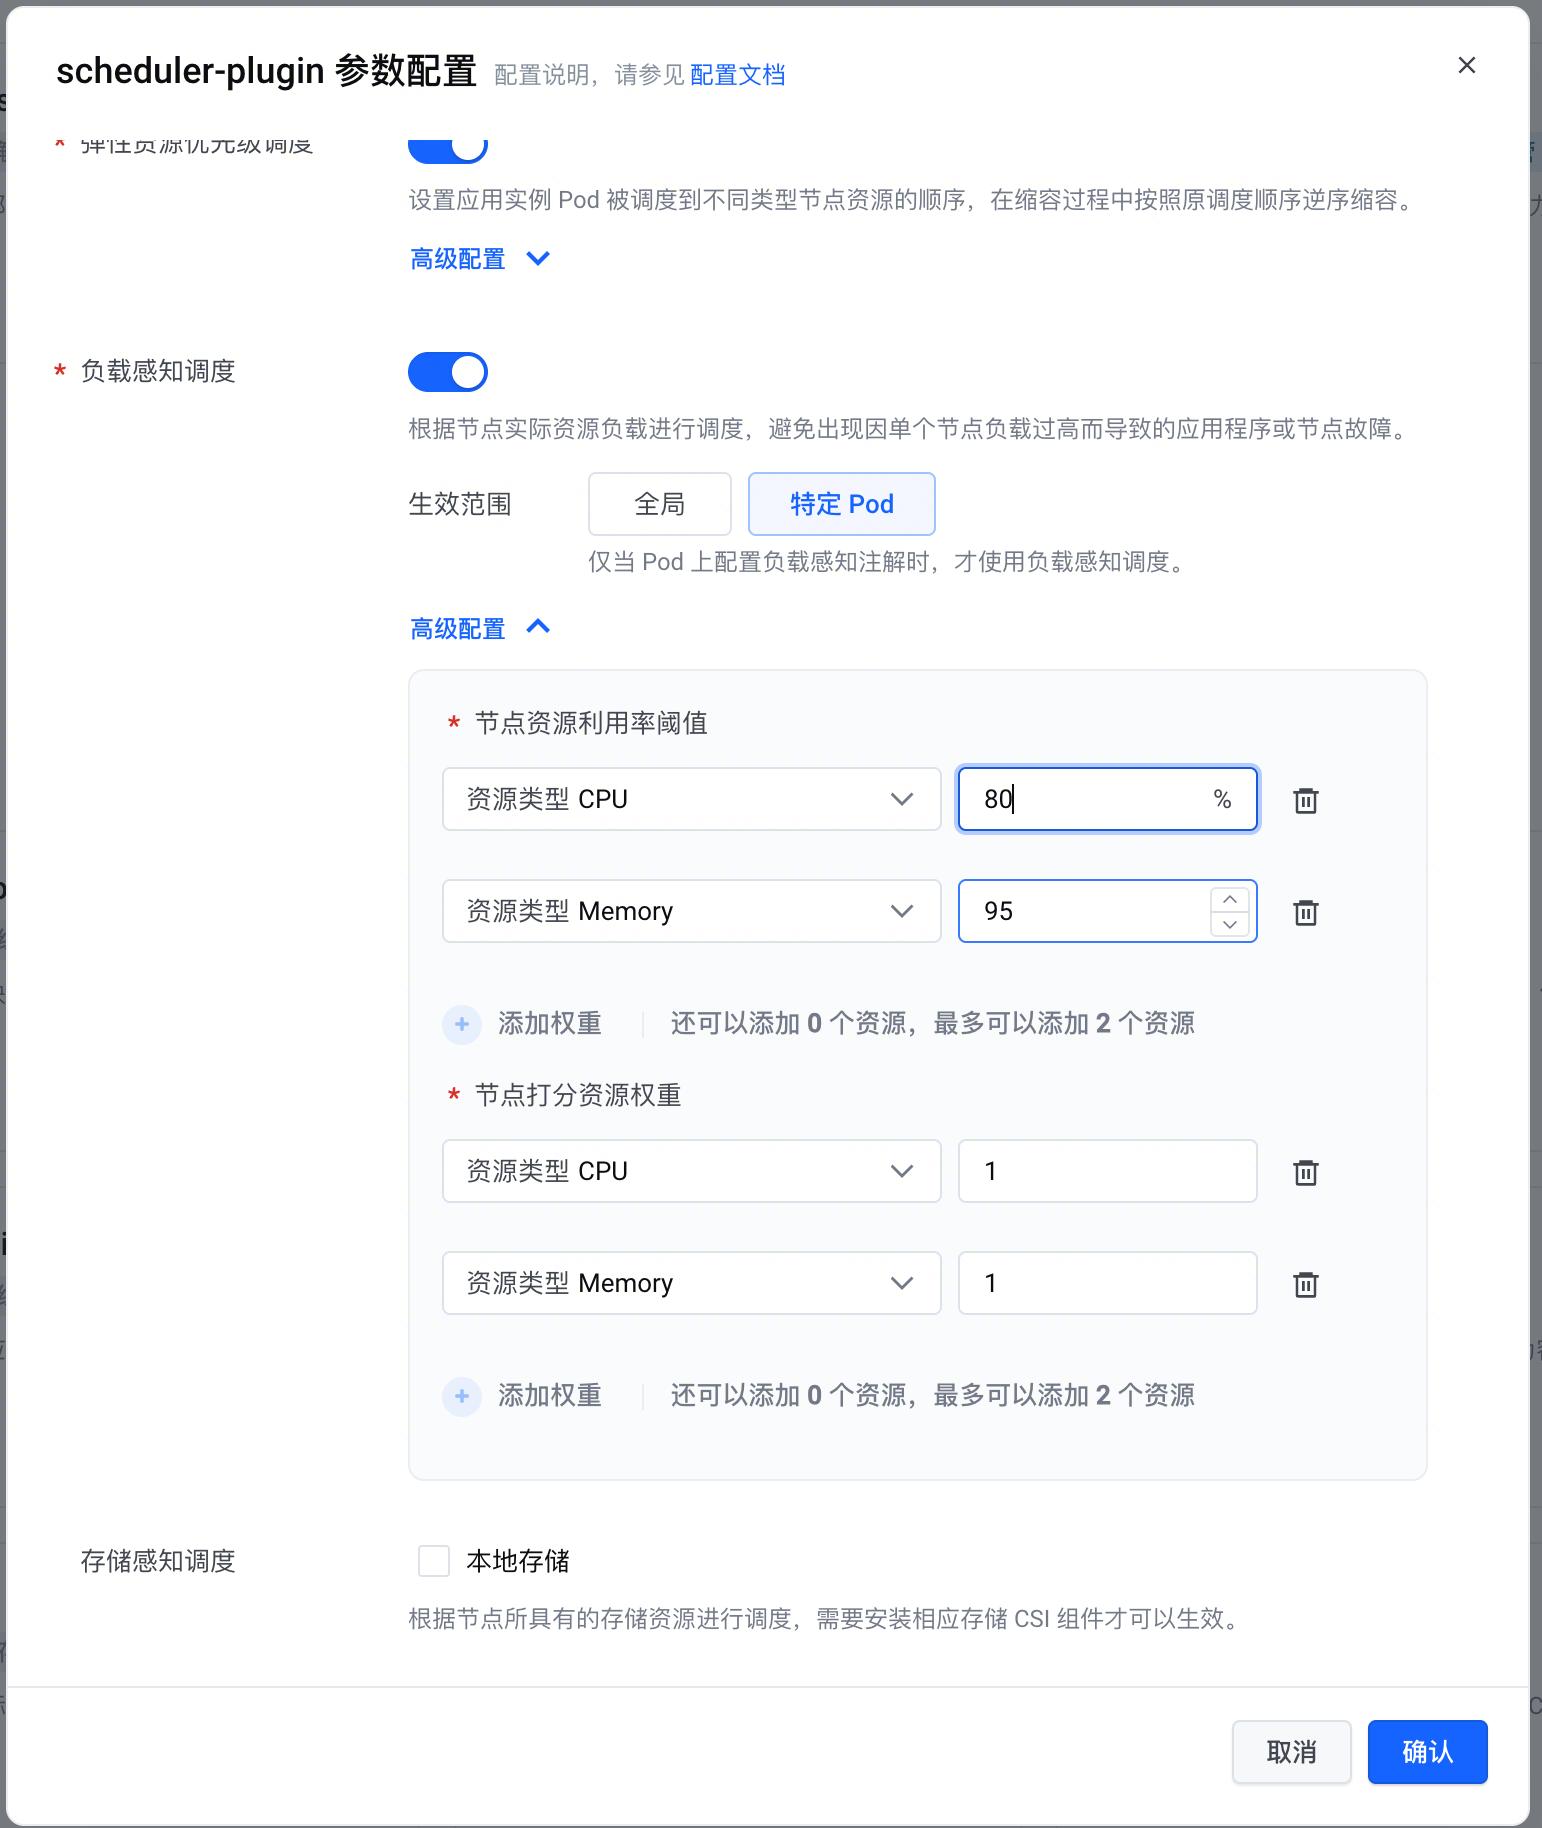
  • scheduler-plugin 已开启负载感知调度;如需灰度,生效范围配置为特定 Pod。​
  • 节点池标签稳定,可使用cluster.vke.volcengine.com/machinepool-name或业务自定义节点标签区分节点池。​
  • 可通过 kubectl top nodes、监控大盘或节点负载指标判断节点 CPU、Memory 使用率。​
更多使用限制参考 负载感知调度。​
详细配置参数​
负载感知调度主要由 scheduler-plugin 组件配置、Pod Annotation、节点负载指标和节点池级阈值覆盖配置共同生效。关键参数如下。​
​
参数​
含义​
配置建议​
生效范围​
控制负载感知调度对哪些 Pod 生效。可选择特定 Pod 或全局生效。​
生产集群建议先选择特定 Pod;新建集群或已充分验证的同质业务集群,再评估全局生效。​
vke.volcengine.com/load-aware-enabled​
Pod Annotation,用于标识该 Pod 是否开启负载感知调度。​
灰度阶段设置为 "true"。若需要回滚,可改为 "false" 或删除该 Annotation。​
节点资源利用率阈值​
调度器用于过滤节点的 CPU、Memory 使用率阈值。​
阈值不是容量规划线,应低于业务不可接受水位,并预留 5~15 个百分点缓冲。​
节点打分资源权重​
调度器根据资源利用率给节点打分时,不同资源维度的影响权重。​
CPU 密集型业务提高 CPU 权重;内存敏感业务提高 Memory 权重。不要让权重与业务瓶颈相反。​
NodeSchedulingConfig.metadata.name​
节点池级阈值覆盖配置名称。​
建议体现节点池用途,例如load-threshold-general-pool、load-threshold-memory-pool。​
NodeSchedulingConfig.spec.nodeSelector​
选择该阈值配置作用的节点集合,类型为 Kubernetes LabelSelector。​
优先使用稳定节点池标签,例如cluster.vke.volcengine.com/machinepool-name。避免多个配置同时命中同一个节点。​
NodeSchedulingConfig.spec.targetLoadThreshold​
为匹配节点设置目标负载阈值,源码中定义为资源名到百分比的映射。​
按节点池资源瓶颈分别设置 cpu、memory。内存型节点池的 Memory 阈值通常应比通用池更保守。​
NodeMonitor.status.nodeUsage​
节点负载数据,包含节点资源使用情况。​
排障时确认节点负载数据是否正常更新。若数据缺失或延迟,调度结果可能退化。​
NodeMonitor.status.updateTime​
节点负载数据最近更新时间。​
用于判断负载数据新鲜度。若更新时间过旧,应优先排查监控采集链路。​
​
场景一:在线服务避开热点节点​
该场景适合在线服务、网关、常驻 Worker 等长生命周期 Pod。业务希望新增 Pod 避开已经出现 CPU 或内存热点的节点,优先调度到低负载节点,降低单节点热点对业务延迟和稳定性的影响。​
推荐配置​
  1. 在 scheduler-plugin 中开启负载感知调度能力。​
  1. 生效范围选择特定 Pod,先通过 Annotation 灰度目标工作负载。​
  1. 设置全局默认 CPU、Memory 阈值,作为未配置节点池覆盖时的默认保护线。​
  1. 按业务瓶颈设置节点打分资源权重。CPU 密集型服务提高 CPU 权重,内存敏感服务提高 Memory 权重。​
  1. 对目标 Deployment 添加vke.volcengine.com/load-aware-enabled: "true"。​
  • ​
    apiVersion: apps/v1​
    kind: Deployment​
    metadata:​
    name: web-load-aware-verify​
    namespace: default​
    spec:​
    replicas: 6​
    selector:​
    matchLabels:​
    app: web-load-aware​
    template:​
    metadata:​
    labels:​
    app: web-load-aware​
    annotations:​
    vke.volcengine.com/load-aware-enabled: "true"​
    spec:​
    schedulerName: default-scheduler​
    containers:​
    - name: nginx​
    image: cr-helm-test-cn-beijing.cr.volces.com/vke/nginx:latest​
    resources:​
    requests:​
    cpu: 500m​
    memory: 512Mi​
    ​
验证方法​
  1. 连接目标集群,详情请参见使用 kubectl 连接集群。​
  1. 确认 scheduler-plugin 已开启负载感知调度,且生效范围符合预期。​
  • ​​​
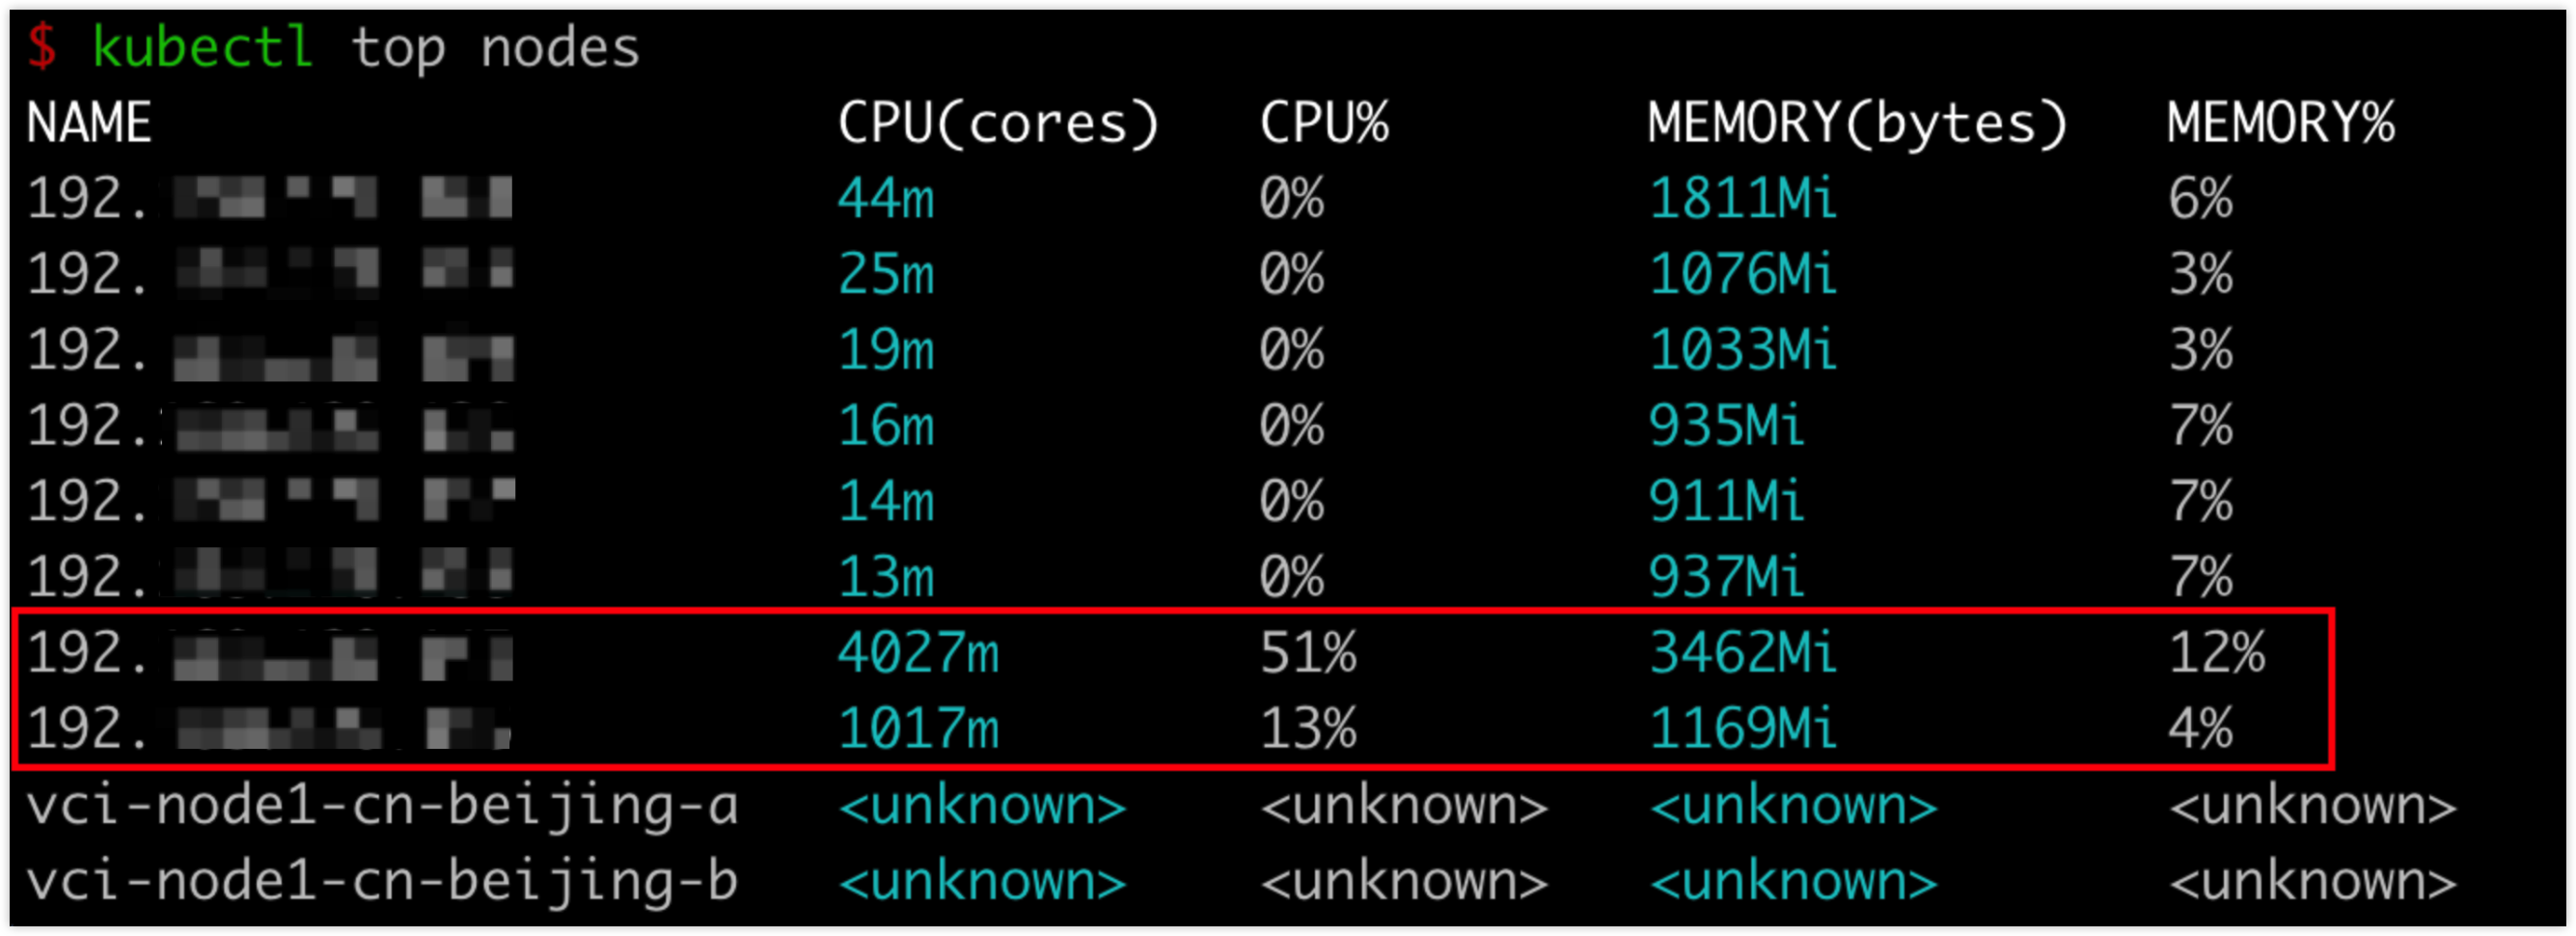
  1. 准备热点节点。可使用压测工作负载或已有业务负载制造 CPU/Memory 高水位,确保集群中至少存在一个高负载节点和一个低负载节点。​
说明​
仅在测试集群或隔离节点池执行,不得在承载生产流量的节点上制造高负载。开始前确认监控和回滚路径,验证完成后立即删除压测工作负载。​
  • ​​​
  • ​
    $ kubectl top nodes​
    NAME CPU(cores) CPU% MEMORY(bytes) MEMORY%​
    192.**.**.** 44m 0% 1811Mi 6%​
    192.**.**.** 25m 0% 1076Mi 3%​
    192.**.**.** 19m 0% 1033Mi 3%​
    192.**.**.** 16m 0% 935Mi 7%​
    192.**.**.** 14m 0% 911Mi 7%​
    192.**.**.** 13m 0% 937Mi 7%​
    192.**.**.** 4027m 51% 3462Mi 12%​
    192.**.**.** 1017m 13% 1169Mi 4%​
    vci-node1-cn-beijing-a <unknown> <unknown> <unknown> <unknown>​
    vci-node1-cn-beijing-b <unknown> <unknown> <unknown> <unknown>​
    ​
  1. 部署示例应用,并确认 Pod 模板中包含vke.volcengine.com/load-aware-enabled: "true"。示例应用通过节点亲和性将可调度范围限定在节点池标签cluster.vke.volcengine.com/machinepool-name=pd9ji9ullqoqnlv6sok7g对应的节点池内,由调度器在该节点池内根据负载选择更合适的节点。​
  • ​
    apiVersion: apps/v1​
    kind: Deployment​
    metadata:​
    name: web-load-aware-verify​
    namespace: default​
    spec:​
    replicas: 3​
    selector:​
    matchLabels:​
    app: web-load-aware​
    template:​
    metadata:​
    labels:​
    app: web-load-aware​
    annotations:​
    vke.volcengine.com/load-aware-enabled: "true"​
    spec:​
    schedulerName: default-scheduler​
    affinity:​
    nodeAffinity:​
    requiredDuringSchedulingIgnoredDuringExecution:​
    nodeSelectorTerms:​
    - matchExpressions:​
    - key: cluster.vke.volcengine.com/machinepool-name​
    operator: In​
    values:​
    - "pd9ji9ullqoqnlv6sok7g"​
    containers:​
    - name: nginx​
    image: cr-helm-test-cn-beijing.cr.volces.com/vke/nginx:latest​
    imagePullPolicy: IfNotPresent​
    resources:​
    requests:​
    cpu: "500m"​
    memory: "512Mi"​
    limits:​
    cpu: "1"​
    memory: "1Gi"​
    ​
  1. 观察 Pod 分布。预期新建 Pod 更倾向调度到低负载节点。​
  • ​
    $ kubectl get pods -n default -l app=web-load-aware -o wide​
    NAME READY STATUS RESTARTS AGE IP NODE NOMINATED NODE READINESS GATES​
    web-load-aware-verify-5fcf****-**** 1/1 Running 0 6s 192.**.**.** 192.**.**.** <none> <none>​
    web-load-aware-verify-5fcf****-**** 1/1 Running 0 6s 192.**.**.** 192.**.**.** <none> <none>​
    web-load-aware-verify-5fcf****-**** 1/1 Running 0 6s 192.**.**.** 192.**.**.** <none> <none>​
    ​
  • ​​​
风险与调优​
该场景的核心风险是阈值过低导致可调度节点减少,或阈值过高导致热点规避效果不明显。建议先在单个工作负载灰度,观察 Pending、调度失败事件、节点热点数量和业务 P95/P99 延迟。若新增 Pod 仍然落到高负载节点,应同时检查 Annotation、生效范围、节点负载数据新鲜度、节点亲和性、污点容忍和资源请求等约束。​
场景二:不同节点池设置不同调度阈值​
该场景适合集群中存在多类节点池的情况,例如通用计算池、CPU 高配池、内存型节点池、混部或低优先级节点池。不同节点池的规格、业务类型和资源瓶颈不同,如果只使用一套全局阈值,可能出现通用池过载、内存型节点过晚保护、高配节点利用率不足等问题。​
推荐配置​
  1. 梳理节点池用途和稳定标签。推荐使用cluster.vke.volcengine.com/machinepool-name匹配节点池。​
  1. 为每类节点池设置不同 CPU、Memory 阈值。​
  1. 为每个节点池创建一个 NodeSchedulingConfig。一个节点应只命中一个预期配置,避免最终阈值来源不清晰。​
  1. 保留全局默认阈值作为兜底,覆盖未命中 NodeSchedulingConfig 的节点。​
  1. 灰度期间只选择一个或少量节点池验证,确认效果后再扩大到其它节点池。​
验证方法​
  1. 连接目标集群,详情请参见使用 kubectl 连接集群。​
  1. 确认 scheduler-plugin 已开启负载感知调度,且生效范围符合预期。​
  • ​​​
  1. 创建或更新 NodeSchedulingConfig。​
  • ​
    apiVersion: scheduling.vke.volcengine.com/v1beta1​
    kind: NodeSchedulingConfig​
    metadata:​
    name: load-threshold-pool-1​
    spec:​
    nodeSelector:​
    matchLabels:​
    cluster.vke.volcengine.com/machinepool-name: pd9jkutildci5lli87oo0​
    targetLoadThreshold:​
    cpu: 75​
    memory: 80​
    ---​
    apiVersion: scheduling.vke.volcengine.com/v1beta1​
    kind: NodeSchedulingConfig​
    metadata:​
    name: load-threshold-pool-2​
    spec:​
    nodeSelector:​
    matchLabels:​
    cluster.vke.volcengine.com/machinepool-name: pd9jkuh5lqoqnlv6solug​
    targetLoadThreshold:​
    cpu: 80​
    memory: 85​
    ---​
    apiVersion: scheduling.vke.volcengine.com/v1beta1​
    kind: NodeSchedulingConfig​
    metadata:​
    name: load-threshold-pool-3​
    spec:​
    nodeSelector:​
    matchLabels:​
    cluster.vke.volcengine.com/machinepool-name: pd9jkv5qldci5lli87oog​
    targetLoadThreshold:​
    cpu: 85​
    memory: 90​
    ​
  • ​
    kubectl apply -f nodeschedulingconfig.yaml​
    kubectl get nodeschedulingconfig​
    ​
  1. 检查节点池 Label,确认每个节点只命中一个预期配置。​
  • ​
    kubectl get nodes --show-labels | grep cluster.vke.volcengine.com/machinepool-name​
    ​
  1. 查询 NodeSchedulingConfig 配置详情。​
  • ​
    kubectl get nodeschedulingconfig load-threshold-pool-1 -o yaml​
    kubectl get nodeschedulingconfig load-threshold-pool-2 -o yaml​
    kubectl get nodeschedulingconfig load-threshold-pool-3 -o yaml​
    ​
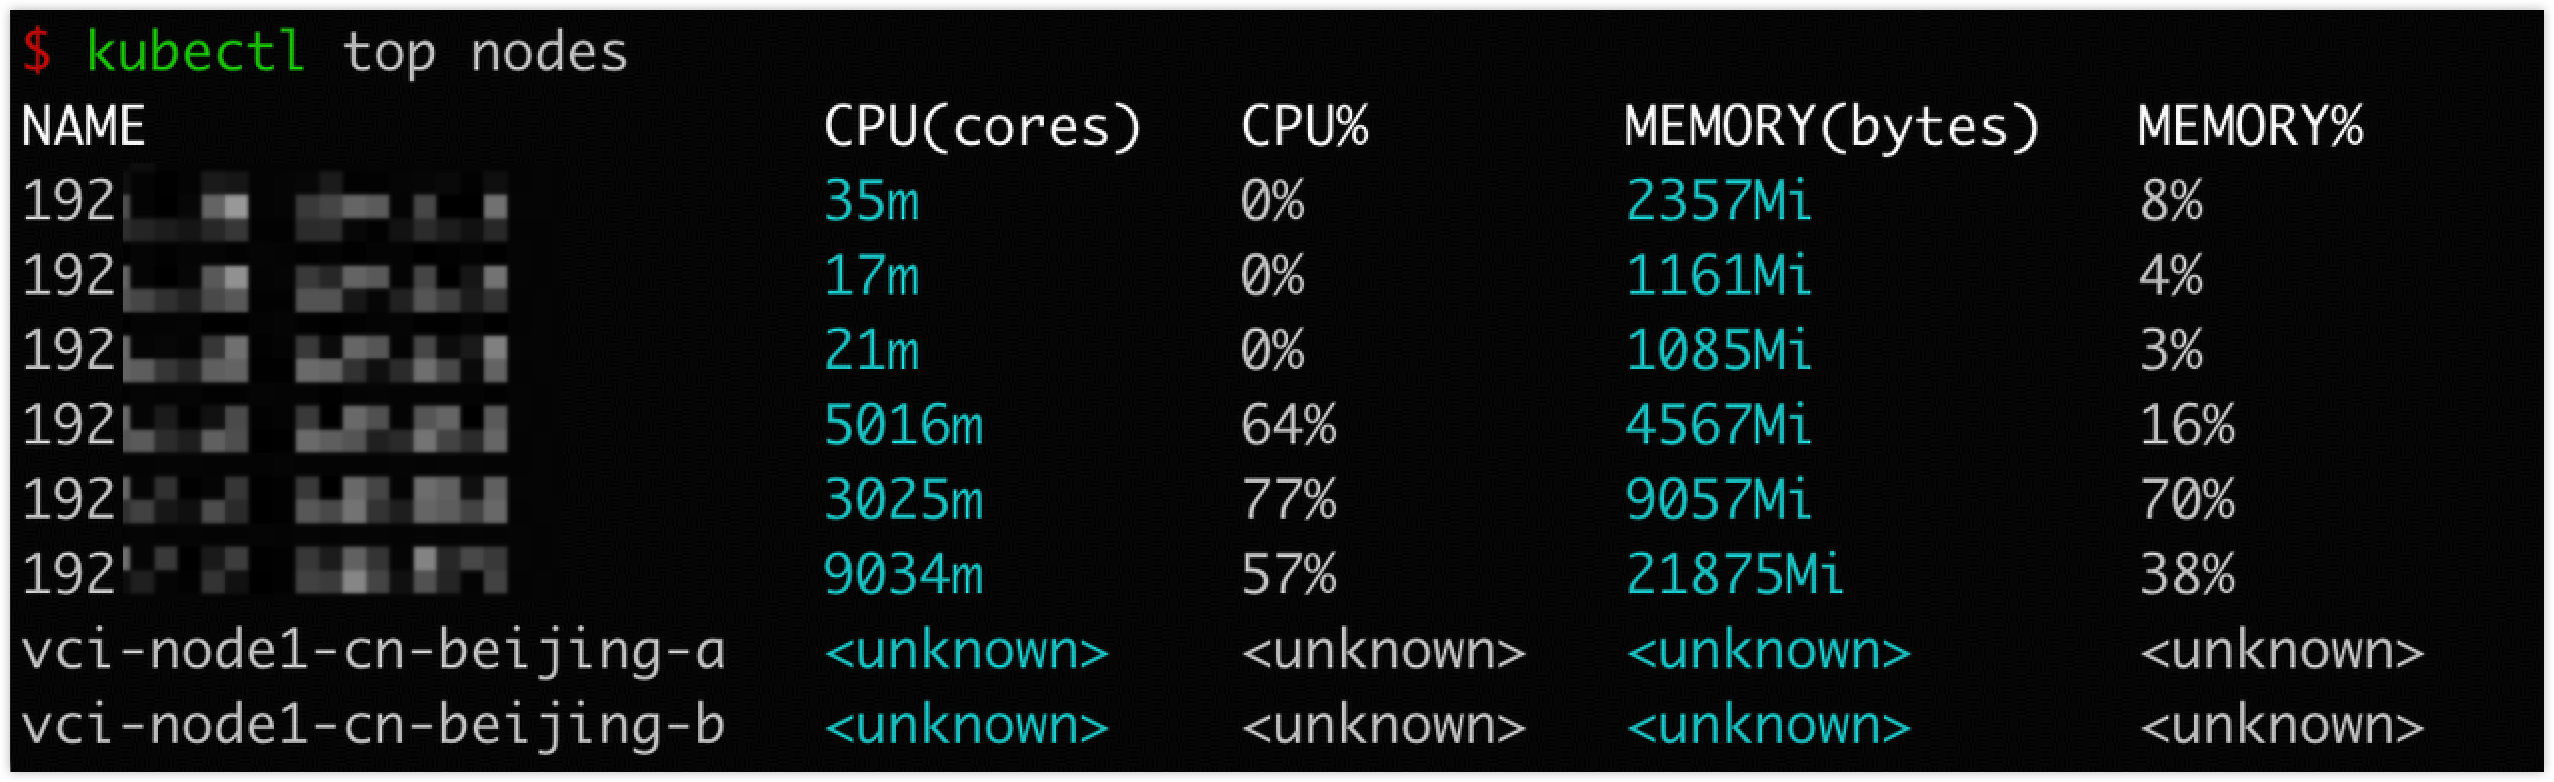
  1. 构造节点池的真实负载。​
  • ​
    $ kubectl top nodes​
    NAME CPU(cores) CPU% MEMORY(bytes) MEMORY%​
    192.**.**.** 35m 0% 2357Mi 8%​
    192.**.**.** 17m 0% 1161Mi 4%​
    192.**.**.** 21m 0% 1085Mi 3%​
    192.**.**.** 5016m 64% 4567Mi 16%​
    192.**.**.** 3025m 77% 9057Mi 70%​
    192.**.**.** 9034m 57% 21875Mi 38%​
    vci-node1-cn-beijing-a <unknown> <unknown> <unknown> <unknown>​
    vci-node1-cn-beijing-b <unknown> <unknown> <unknown> <unknown>​
    ​
  • ​​​
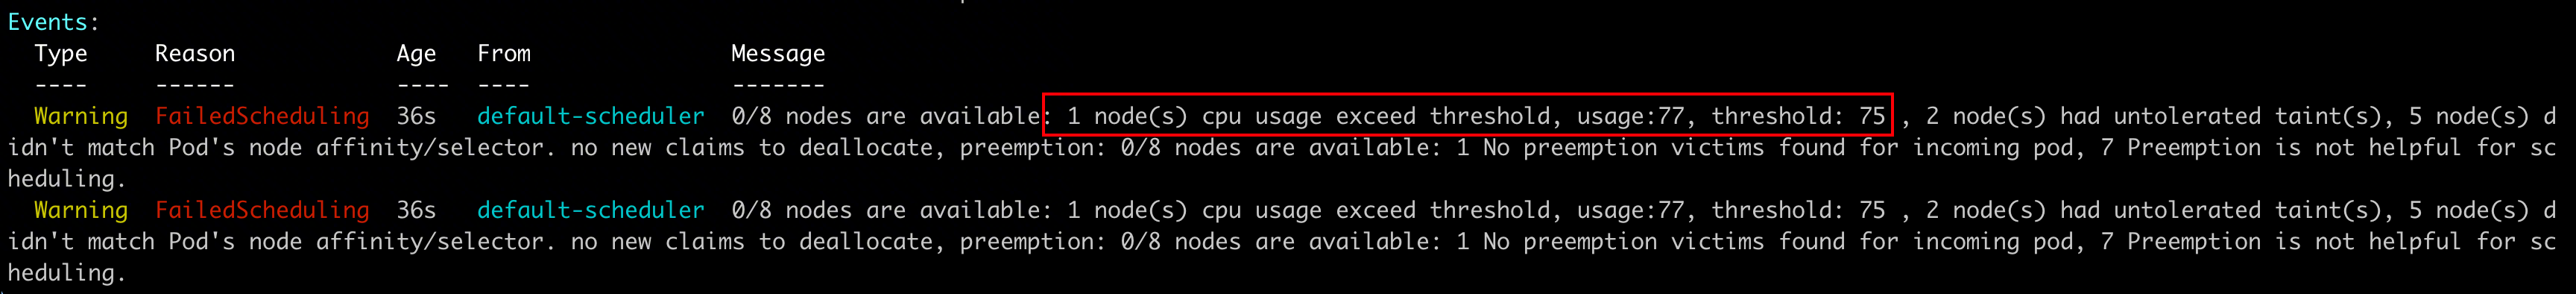
  1. 部署负载到load-threshold-pool-1对应的节点池,预计会拒绝调度,验证单独对该节点池设置的阈值生效。​
  • ​
    apiVersion: apps/v1​
    kind: Deployment​
    metadata:​
    name: load-aware-threshold-reject-pool-1​
    namespace: default​
    labels:​
    app: load-aware-threshold-reject-pool-1​
    spec:​
    replicas: 1​
    selector:​
    matchLabels:​
    app: load-aware-threshold-reject-pool-1​
    template:​
    metadata:​
    labels:​
    app: load-aware-threshold-reject-pool-1​
    annotations:​
    vke.volcengine.com/load-aware-enabled: "true"​
    spec:​
    schedulerName: default-scheduler​
    affinity:​
    nodeAffinity:​
    requiredDuringSchedulingIgnoredDuringExecution:​
    nodeSelectorTerms:​
    - matchExpressions:​
    - key: cluster.vke.volcengine.com/machinepool-name​
    operator: In​
    values:​
    - "pd9jkutildci5lli87oo0"​
    containers:​
    - name: nginx​
    image: cr-helm-test-cn-beijing.cr.volces.com/vke/nginx:latest​
    imagePullPolicy: IfNotPresent​
    resources:​
    requests:​
    cpu: "100m"​
    memory: "128Mi"​
    limits:​
    cpu: "500m"​
    memory: "512Mi"​
    ​
  • ​
    $ kubectl describe pod load-aware-threshold-reject-pool-1-5d96****-****​
    ...​
    Events:​
    Type Reason Age From Message​
    ---- ------ ---- ---- -------​
    Warning FailedScheduling 36s default-scheduler 0/8 nodes are available: 1 node(s) cpu usage exceed threshold, usage:77, threshold: 75 , 2 node(s) had untolerated taint(s), 5 node(s) didn't match Pod's node affinity/selector. no new claims to deallocate, preemption: 0/8 nodes are available: 1 No preemption victims found for incoming pod, 7 Preemption is not helpful for scheduling.​
    Warning FailedScheduling 36s default-scheduler 0/8 nodes are available: 1 node(s) cpu usage exceed threshold, usage:77, threshold: 75 , 2 node(s) had untolerated taint(s), 5 node(s) didn't match Pod's node affinity/selector. no new claims to deallocate, preemption: 0/8 nodes are available: 1 No preemption victims found for incoming pod, 7 Preemption is not helpful for scheduling.​
    ​
  • ​​​
  1. 扩容上述工作负载,节点池亲和性添加上述三个节点池,观察 Pod 避开超过对应节点池阈值的节点。​
  • ​
    $ kubectl get pods -owide​
    NAME READY STATUS RESTARTS AGE IP NODE NOMINATED NODE READINESS GATES​
    load-aware-threshold-reject-pool-1-67f9b****-**** 1/1 Running 0 79s 192.**.**.** 192..**.**.** <none> <none>​
    load-aware-threshold-reject-pool-1-67f9b****-**** 1/1 Running 0 53s 192.**.**.** 192.**.**.** <none> <none>​
    load-aware-threshold-reject-pool-1-67f9b****-**** 1/1 Running 0 71s 192.**.**.** 192.**.**.** <none> <none>​
    ​
  • ​​​
风险与调优​
分池阈值上线时,最大的风险是 Selector 设计不清晰。若同一个节点同时被多个 NodeSchedulingConfig 命中,排障时很难判断最终阈值来源。建议每个节点池使用唯一稳定标签,并在上线前用kubectl get nodes --show-labels校验匹配关系。​
阈值设计应结合历史监控数据。通用计算池可从 CPU 65%~75%、Memory 70%~80% 开始;CPU 高配池可适当提高 CPU 阈值;内存型节点池建议将 Memory 阈值设置得更保守,例如 60%~70%。上线后根据业务延迟、Pending、节点热点数量和资源利用率继续调整。​
上线步骤​
  1. 选择目标工作负载,确认 Pod Label、资源请求和调度约束稳定。​
  1. 开启 scheduler-plugin 的负载感知调度能力,生效范围优先选择特定 Pod。​
  1. 为灰度工作负载添加vke.volcengine.com/load-aware-enabled: "true"。​
  1. 设置全局默认 CPU、Memory 阈值和资源权重。​
  1. 如需按节点池设置阈值,创建 NodeSchedulingConfig 并校验节点匹配关系。​
  1. 部署或扩容灰度工作负载,观察 Pod 分布、节点负载和调度事件。​
  1. 灰度稳定后,扩大到同类业务;确认监控稳定、阈值清晰、回滚路径明确后再评估全局开启。​
风险与限制​
负载感知调度依赖节点负载数据。若监控数据缺失、延迟或与真实负载偏差较大,调度效果会下降。排障时应同时检查 NodeMonitor 更新时间、节点监控指标、Pod 事件和 scheduler-plugin 配置。​
负载感知调度不会绕过 Kubernetes 原生调度约束。节点亲和性、污点容忍、资源请求、拓扑约束等仍然会影响最终调度结果。如果这些约束已经把可选节点范围缩小到少数节点,即使开启负载感知调度,也可能无法避开热点节点。​
回滚方案​
  1. 将灰度工作负载 Annotation 改为vke.volcengine.com/load-aware-enabled: "false",或删除该 Annotation。​
  1. 若已创建节点池级 NodeSchedulingConfig,先删除新建配置或将 Selector 改到空匹配,恢复全局默认阈值。​
  1. 若已全局开启,在 scheduler-plugin 配置中将生效范围改回特定 Pod 或关闭负载感知调度。​
  1. 重新发布工作负载,观察新 Pod 是否恢复普通调度,确认 Pending 和节点热点指标恢复到预期范围。​
最近更新时间:2026.10.14 16:58:09
这个页面对您有帮助吗?
有用
有用
无用
无用