容器服务
容器服务


文档指南

请输入


- 文档首页
 容器服务容器服务 VKE用户指南异构计算容器共享 mGPU通过 mGPU 实现在离线混部
 复制全文
 下载 pdf
通过 mGPU 实现在离线混部
 文档反馈
 问问助手
mGPU 在离线混部功能支持在容器服务集群中,实现在线任务与离线任务共卡部署,最大化 GPU 资源利用率,有效降低算力使用成本。本文详细介绍 mGPU 在离线混部调度方案的技术原理和使用步骤。
背景信息
功能概述
默认情况下,mGPU 采用公平调度策略分配 GPU 资源,其内核驱动会为各类任务分配均等的 GPU 时间片。但不同 GPU 计算任务的运行特性与优先级存在显著差异,对应的资源需求也各不相同。此时可借助在离线混部技术,充分挖掘 GPU 算力潜能。例如:实时推理任务对 GPU 资源延迟敏感,需快速获取算力完成计算,但其资源利用率通常偏低;而模型训练任务对算力需求量大,对延迟的敏感度却较低,能够耐受一定时长的算力抑制。通过部署在离线混部技术,可有效提升 GPU 整体资源利用率,实现算力价值最大化。
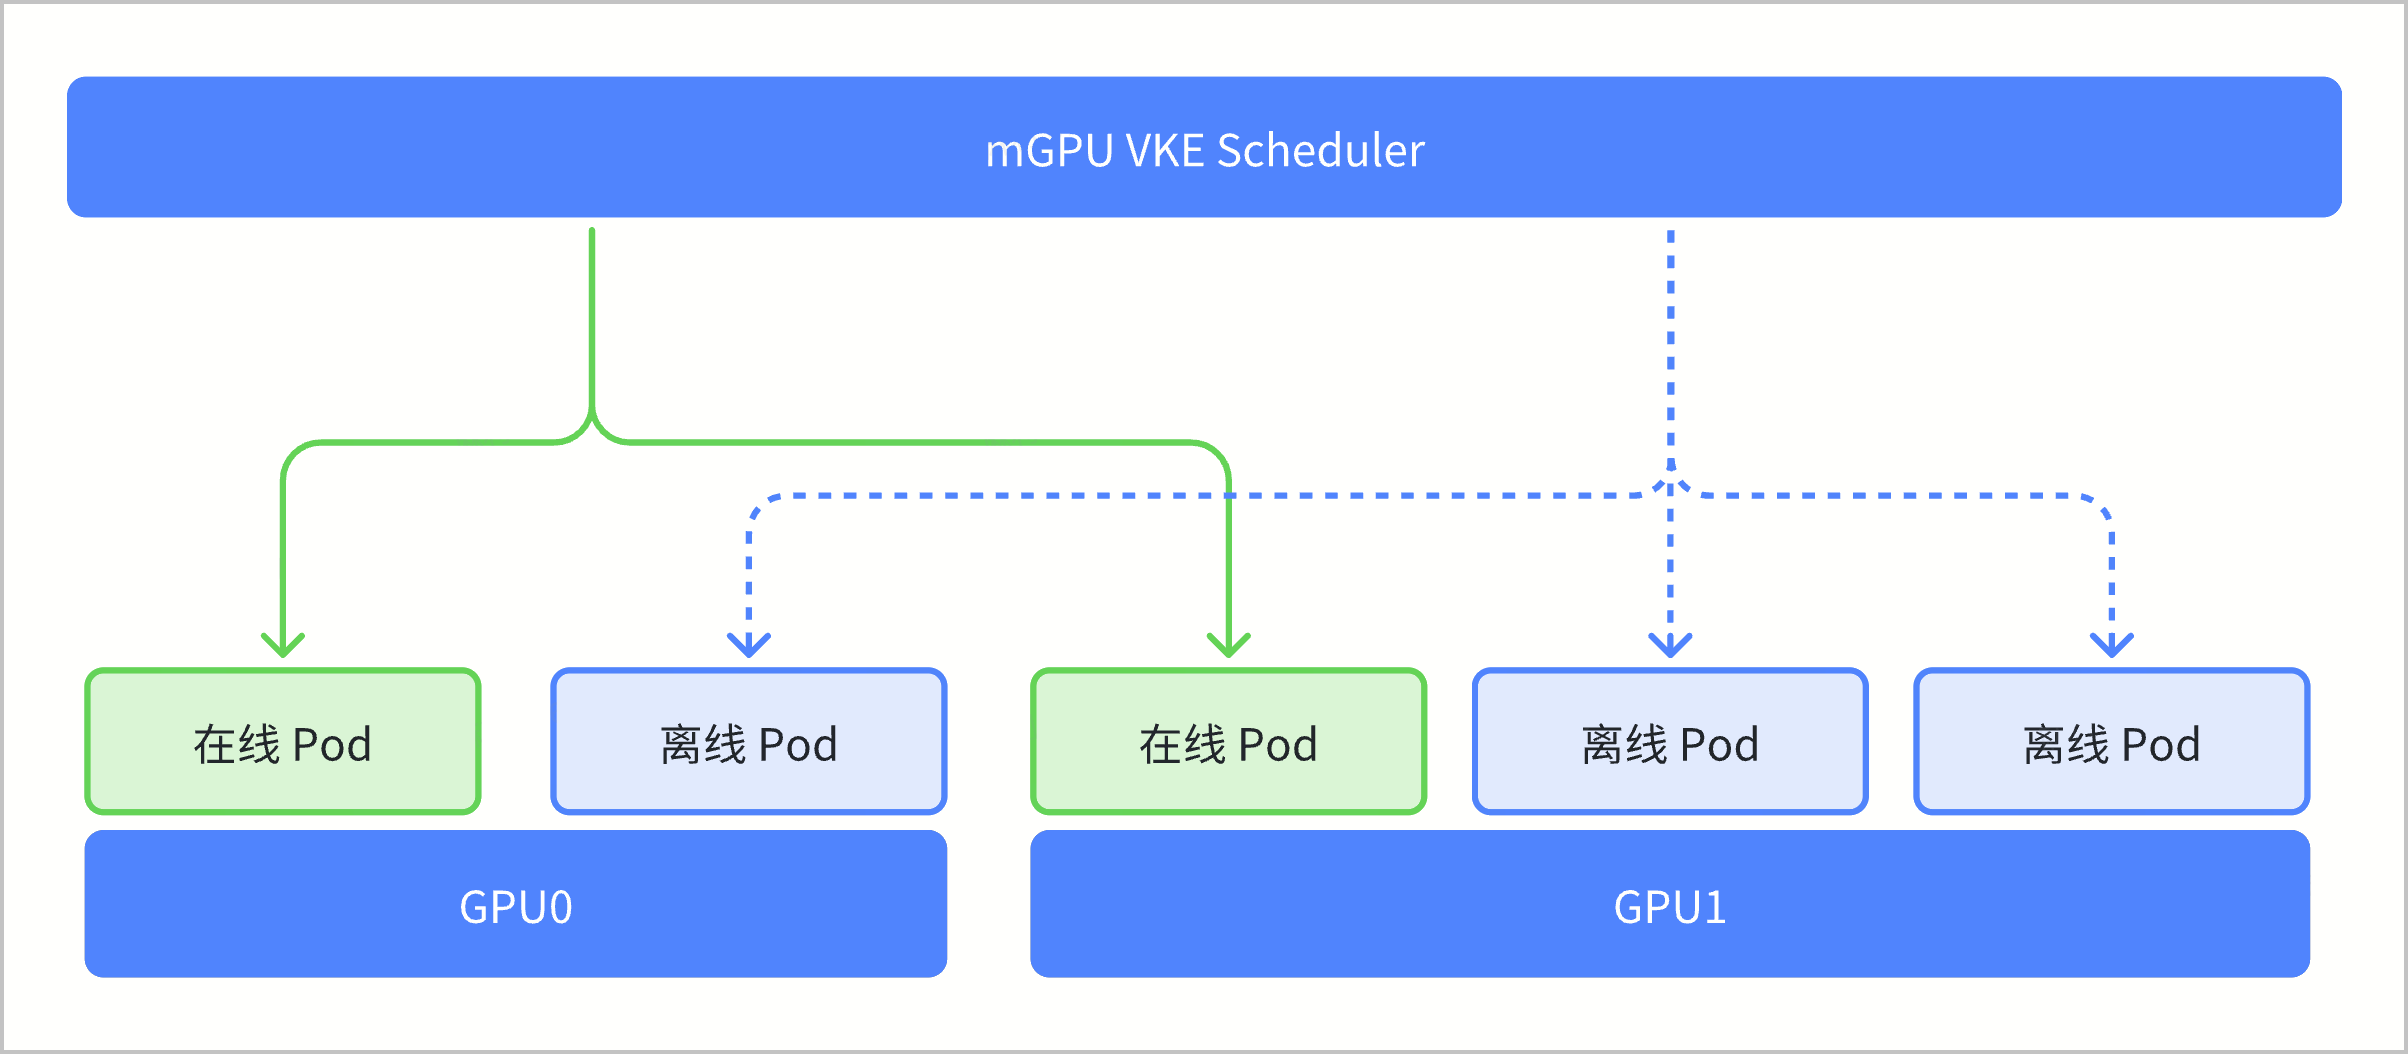
mGPU 在离线混部功能支持将在线任务和离线任务混合部署在同一张 GPU 卡上,在内核与驱动层面,实现离线任务 100% 利用闲置算力、在线任务 100% 抢占离线任务,从而进一步压榨 GPU 资源,把 GPU 使用成本降到最低。
应用场景
针对 GPU 算力需求具有互补性的业务场景,可通过在离线混部的方式,最大化挖掘 GPU 资源潜力。
典型场景 | 场景描述 |
在线推理与离线推理混部 | 搜索或推荐等实时推理任务,需基于已有数据完成逻辑推演以输出目标结果,对 GPU 算力的实时性要求严苛;而数据预处理类离线推理任务,主要服务于线下数据清洗与加工流程,对算力实时性的要求相对宽松。将两类任务分别配置为在线任务与离线任务,混合部署于单张 GPU 卡,可实现 GPU 资源利用率的显著提升。 |
在线推理与离线训练混部 | 搜索或推荐等实时推理任务,需基于已有数据完成逻辑推演以输出目标结果,其特点是对 GPU 算力实时性要求高,但资源消耗量较低;模型训练任务则涵盖数据准备、参数配置、模型评估与调优等环节,对 GPU 算力需求规模大,且对延迟的敏感度较低。将实时推理设为高优在线任务,模型训练设为低优离线任务,混合部署于单张 GPU 卡,可进一步提升 GPU 资源的利用效率。 |
技术原理
- 离线 Pod 对 GPU 闲置算力的 100% 利用
离线 Pod 调度至节点 GPU 后,若当前 GPU 算力未被在线 Pod 占用,即可完全占用该 GPU 的全部算力。当存在多个离线 Pod 共享 GPU 资源时,算力分配逻辑将遵循 mGPU 预设的算力调度策略执行。
- 在线 Pod 对离线 Pod 算力的 100% 绝对抢占
mGPU 驱动层内置优先级绝对抢占机制,具体实现逻辑如下:
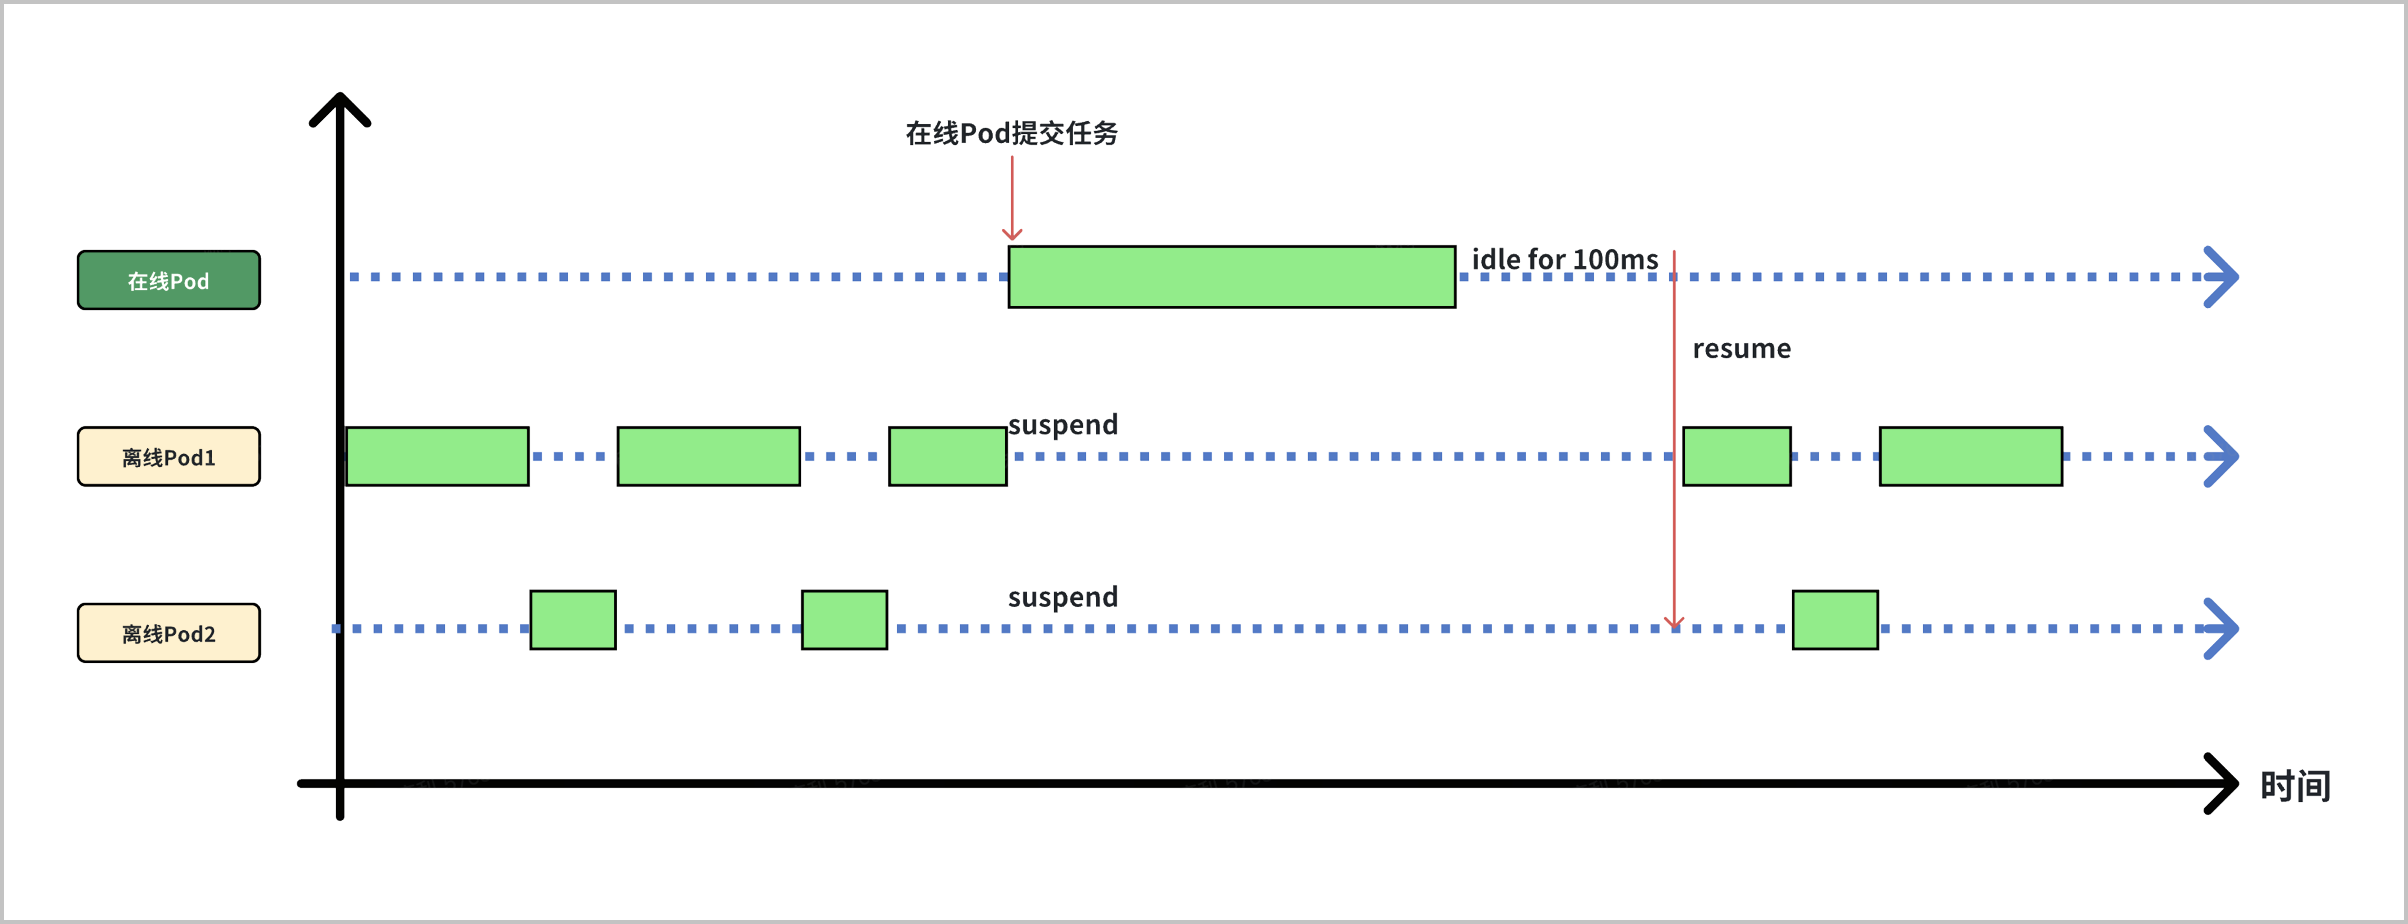
- 资源瞬时调度:在线 Pod 提交 GPU 算力需求的计算任务后,mGPU 驱动会立即将 GPU 全部算力分配给在线 Pod;若存在多个在线 Pod 共享算力,分配规则同样遵循 mGPU 算力调度策略。当在线 Pod 无任务运行时,驱动将在 100ms 后释放已占用算力,并重新将资源分配给离线 Pod。
- 任务断点续算:mGPU 驱动支持计算任务的暂停/恢复功能。当在线 Pod 发起算力请求时,正在占用 GPU 资源的离线 Pod 会被立即暂停并释放算力;待在线 Pod 任务执行完毕,离线 Pod 将自动唤醒,并从任务中断点处继续执行计算流程。
前提条件
- 已完成 mGPU 资源配置,包括:安装 mGPU 组件、创建 GPU 节点。详情请参见 配置 mGPU 调度。
- 已配置 mGPU 算力分配策略,mGPU 在离线混部场景支持fixed-share、guaranteed-burst-share策略。详情请参见 配置 mGPU 算力分配策略。
使用限制
- 在离线混部场景目前仅支持使用fixed-share、guaranteed-burst-share算力分配策略,暂不支持使用native-burst-share算力分配策略。若要最大程度保障在线业务的性能,建议使用guaranteed-burst-share算力分配策略。
- 多卡共享模式暂不支持在离线混部。
- 目前仅支持算力的在离线抢占,暂不支持显存的在离线抢占。
- 使用 velinux2.0/ubuntu22.04 镜像的节点暂不支持使用在离线混部。
操作步骤
步骤一:配置集群
依赖组件 | 版本限制 | 查看方法 |
Kubernetes |
| |
mGPU 驱动 | 0.07.35.23 及以上 | 登录 mGPU 所属云服务器,执行mgpu-cli version命令即可查看 mGPU 驱动版本。 |
mGPU 组件 | v0.6.0 及以上 | |
general-webhook | v1.20.0 及以上 | 托管组件,控制台不可见。新建集群已经使用最新版本,存量集群需联系官方技术支持查看或升级版本。 |
步骤二:配置业务
您可以在集群中混合部署在线 Pod 和离线 Pod,并将其调度到同一 GPU 卡中争抢算力,实现在离线任务混部需求。
支持通过 Annotationkatalyst.kubewharf.io/qos_level: reclaimed_cores标识离线 Pod,并通过vke.volcengine.com/reclaimed-mgpu-core申请离线算力。离线 Pod 的 YAML 示例如下:
支持通过 Annotationkatalyst.kubewharf.io/qos_level: shared_cores或不配置此 Annotation 来标识在线 Pod,通过vke.volcengine.com/mgpu-core申请在线算力。在线 Pod 的 YAML 示例如下:
结果验证
配置完成后,您可以根据业务 Pod 的调度情况,确认在线业务和离线业务的资源争抢情况:
- 当同一张 GPU 卡上只存在在线任务时,不属于在离线混部场景。此时,原有算力分配策略生效。
- 当同一张 GPU 卡上只存在离线任务时,不属于在离线混部场景。此时,原有算力分配策略生效。
- 当同一张 GPU 卡上同时存在在线任务和离线任务时,属于在离线混部场景。此时,在线任务运行时,离线算力将被 100% 压制,即便在线任务并未占满 GPU 算力;在线任务的 GPU 实际使用量为 0 时,允许离线任务 100% 利用闲置算力。
因此,可以通过观察 GPU 卡上在线任务和离线任务的GPU算力使用率来判断混部是否生效。例如:同一张 GPU 卡上,当在线任务一直不间断在使用 GPU 算力处理请求时,离线任务的 GPU 算力使用率会被一直压制为 0%。
最近更新时间:2026.07.07 19:29:03
这个页面对您有帮助吗?
有用
有用
无用
无用