容器服务
容器服务
容器服务


文档指南
请输入


容器服务 VKE
产品动态
Kubernetes 版本发布记录
组件发布记录
监控组件
DNS 组件
GPU 组件
Sandbox 组件
安全公告
产品公告
历史公告
用户指南
集群
节点池
授权
网络
容器网络
服务(Service)
路由(Ingress)
APIG Ingress
ALB Ingress
自定义转发规则配置示例
CLB Ingress
Nginx Ingress
Gateway API
工作负载
存储
数据管理中心(DMC)
对象存储(TOS)
FSX 访问方式
文件存储(NAS)
FSX 访问方式
弹性文件存储(EFS)
文件存储(vePFS)
FSX 访问方式
vePFS Client 访问方式
NFS 访问方式
大数据文件存储(CloudFS)
弹性伸缩
工作负载弹性伸缩
事件驱动伸缩(KEDA)
组件管理
网络组件
监控组件
DNS 组件
GPU 组件
Sandbox 组件
异构计算
调度管理
可观测性
基础观测
诊断与巡检
最佳实践
网络
可观测性
安全合规
API 参考
集群管理
节点池管理
组件管理
机型镜像管理
云原生观测
巡检诊断
弹性容器实例
附录
开发指南
常见问题
通用 FAQ
集群 FAQ
集群管理
集群升级
节点与节点池 FAQ
授权 FAQ
工作负载 FAQ
服务与路由 FAQ
存储 FAQ
弹性伸缩 FAQ
可观测性 FAQ
配额 FAQ
组件 FAQ
容器镜像 FAQ
AI 云原生
推理套件
Helm 模板 AI 应用
Deepseek 实践
Qwen 实践
最佳实践
MiniMax 模型部署
Qwen 模型部署
弹性容器实例 VCI
最新动态
用户指南
虚拟节点
VKE 集群使用虚拟节点
自建/跨云集群使用虚拟节点
创建 VCI 实例
VCI Agent Sandbox
安全合规
- 文档首页
 容器服务AI 云原生推理套件最佳实践Kimi 模型部署通过 LLM 通用模板快速部署 Kimi-K3 模型
 复制全文
 下载 pdf
通过 LLM 通用模板快速部署 Kimi-K3 模型
 文档反馈
 问问助手
本文主要介绍通过 ServingKit LLM 通用模板,在容器服务(VKE)集群中快速部署 Kimi-K3 模型。
背景信息
Kimi K3 是月之暗面(Moonshot AI)发布的开源多模态智能体大模型,也是全球首个突破3T参数门槛的开源模型。模型基于 KDA(Kimi Delta Attention)与注意力残差(AttnRes)架构构建,参数规模达 2.8T,原生支持视觉理解,并拥有百万 Token 的超长上下文窗口。Kimi K3 专为长周期编程、复杂推理及深度知识工作而设计,在多项权威评测中表现优异。本文介绍如何通过 LLM 通用模板,在 Kubernetes 集群上快速部署 Kimi-K3 模型。
使用说明
- 本实践涉及较多组件,相互间有依赖,配置复杂,为了获得符合预期的结果,请务必根据本文指引操作。
- 为了获得符合预期的结果,同时符合容器服务的 使用限制,请按照本文方案(或在本文推荐的资源上)操作。如需替换方案,您可以联系对应的火山引擎客户经理咨询。
- 请勿使用 mGPU 对 GPU 进行切分。
准备工作
- 部署 AI 业务,依赖火山引擎邀测资源,请联系客户经理申请如下资源的邀测试用:
- 邀测资源涉及产品说明邀测资源涉及产品说明高性能计算 GPU 型 hpcpni3ln 规格高性能计算实例,提供计算能力。部署 Kimi-K3 模型时,推荐申请 4 台ecs.hpcpni3ln.45xlarge规格的 GPU 实例。
- 本示例通过 API 网关对外暴露服务,需要准备 API 网关实例。您可以提前创建 API 网关实例或使用已有 API 网关实例,也可以在 ServingKit 上部署应用时同步自动创建实例。
说明
提前创建 API 网关实例或使用已有 API 网关实例时请确保实例的 地域 需要与 VKE 集群的 地域 一致,且建议 网络类型 同时开启 公网 和 私网。创建 API 网关实例相关操作,请参见 创建实例。
- 需要创建高性能计算集群,用于实现高性能计算 GPU 实例(计算节点)的逻辑隔离,实现同一集群内实例间 RDMA 网络互联互通。详情请参见 创建高性能计算集群。
说明
高性能计算集群所在的 地域和可用区 需要与 VKE 集群的 地域和可用区 一致。
操作步骤
步骤一:创建 VKE 异构计算集群
配置项 | 说明 |
配置项 | 说明 |
集群及节点池配置 | |
地域 | 地域 和 可用区,需要与前期准备的高性能计算集群的地域和可用区一致。 您可以通过顶部导航栏切换地域。 |
可用区 | |
计算规格 | 选择 高性能计算 GPU 型 的ecs.hpcpni3ln.45xlarge规格。 |
节点数量 | 设置为 4。 |
高级配置 | |
数据盘 | 配置如下两个数据盘:
|
步骤二:部署 Kimi-K3
- 通过 ServingKit 提供的 LLM 通用部署模板 下载并部署模型。部署过程中,需要注意以下列举的参数配置,其余参数说明和详细的操作步骤,请参见 部署 LLM 通用模板应用。
- 参数说明参数说明选择框架及编排镜像选择 预置,然后在 高级筛选 下拉框中选择 POC 和 SGLang 后,找到v0.5.16.iaas.202607280000-kimi-k3-cu130镜像,并选中镜像。模型配置
- 存储类型:选择 数据盘。
- 模型选择:单击 添加预置模型,选择 Kimi-K3 和 Kimi-K3-DSpark 两个预置模型,并配置 挂载路径 为/data01、容器挂载路径 为/data/models,表示将模型数据下载至/data01目录。
推理模式选择 PD 共置。实例规格- 实例数: 设置为 1。
- 单实例 GPU 数:设置为 32。
资源配置选择 步骤一 中创建的 VKE 异构计算集群,以及该集群下ecs.hpcpni3ln.45xlarge规格节点所在的节点池。启动命令添加如下启动命令。启动命令中各字段的详细说明,请参见下方“启动命令详细说明”表格。source /workspace/nccl_env.sh && GLOO_SOCKET_IFNAME=eth0 NCCL_MIN_NCHANNELS=24 NCCL_IB_QPS_PER_CONNECTION=8 NCCL_CUMEM_ENABLE=1 PYTORCH_CUDA_ALLOC_CONF=expandable_segments:True SGLANG_ENABLE_TP_MEMORY_INBALANCE_CHECK=0 SGLANG_K3_ATTN_RES_MODE=jit SGLANG_MOE_FUSED_GATE_RADIX=1 sglang serve --trust-remote-code \--model-path /data/models/Kimi-K3 \--served-model-name kimi-k3 \--tp-size 32 \--nnodes 4 \--node-rank $POD_GROUP_INDEX \--dist-init-addr "${ROLESET_NAME}-${ROLE_NAME}-${ROLE_TEMPLATE_HASH}-${ROLE_REPLICA_INDEX}-0.${STORM_SERVICE_NAME}:20000" \--ep-size 32 \--moe-runner-backend marlin \--decode-attention-backend flashmla \--mem-fraction-static 0.85 \--mamba-radix-cache-strategy extra_buffer_lazy \--dist-timeout 3600 \--reasoning-parser kimi_k3 \--tool-call-parser kimi_k3 \--mamba-full-memory-ratio 0.8 \--host 0.0.0.0 \--port 8080 \--speculative-algorithm DSPARK \--speculative-draft-model-path /data/models/Kimi-K3-DSpark \--speculative-dspark-block-size 7 \--enable-linear-replayssm-spec \--cuda-graph-max-bs 128 \--max-running-requests 128 \--enable-metrics \--enable-cache-report \--show-time-cost端口号 设置为 8080。API 网关勾选 开启,绑定前期准备的 API 网关实例。说明
- 启动命令详细说明
- 参数类型说明取值示例参数类型说明取值示例sglang serve启动指令通过 SGLang CLI 启动模型服务端。该字段属于命令入口,非参数。无--model路径 / 模型 ID加载的 LLM 模型,可配置如下值:
- Hugging Face 模型 ID。
- 本地模型路径。
/data/models/Kimi-K3--tp-size整数配置张量并行度(Tensor Parallelism)。32--nnodes整数指定分布式集群总节点数。4--node-rank整数指定当前节点在集群中的序号,从0开始。0--dist-init-addrIP: 端口分布式集群的初始化地址(主节点地址),用于多节点通信同步。变量注入--ep-size整数配置专家并行度(Expert Parallelism)。32--hostIP 地址服务绑定的主机地址。0.0.0.0--port整数服务监听的端口号,用于连接客户端。8000--mem-fraction-static浮点数控制静态显存占比,给运行时 Workspace 留出更多余量。0.85--cuda-graph-max-bs整数用于设置 CUDA Graph 的最大批量大小,可以降低 CUDA graph capture/replay 的 batch 显存压力。128--max-running-requests整数限制同时处理的最大请求数。128--enable-metrics指令无
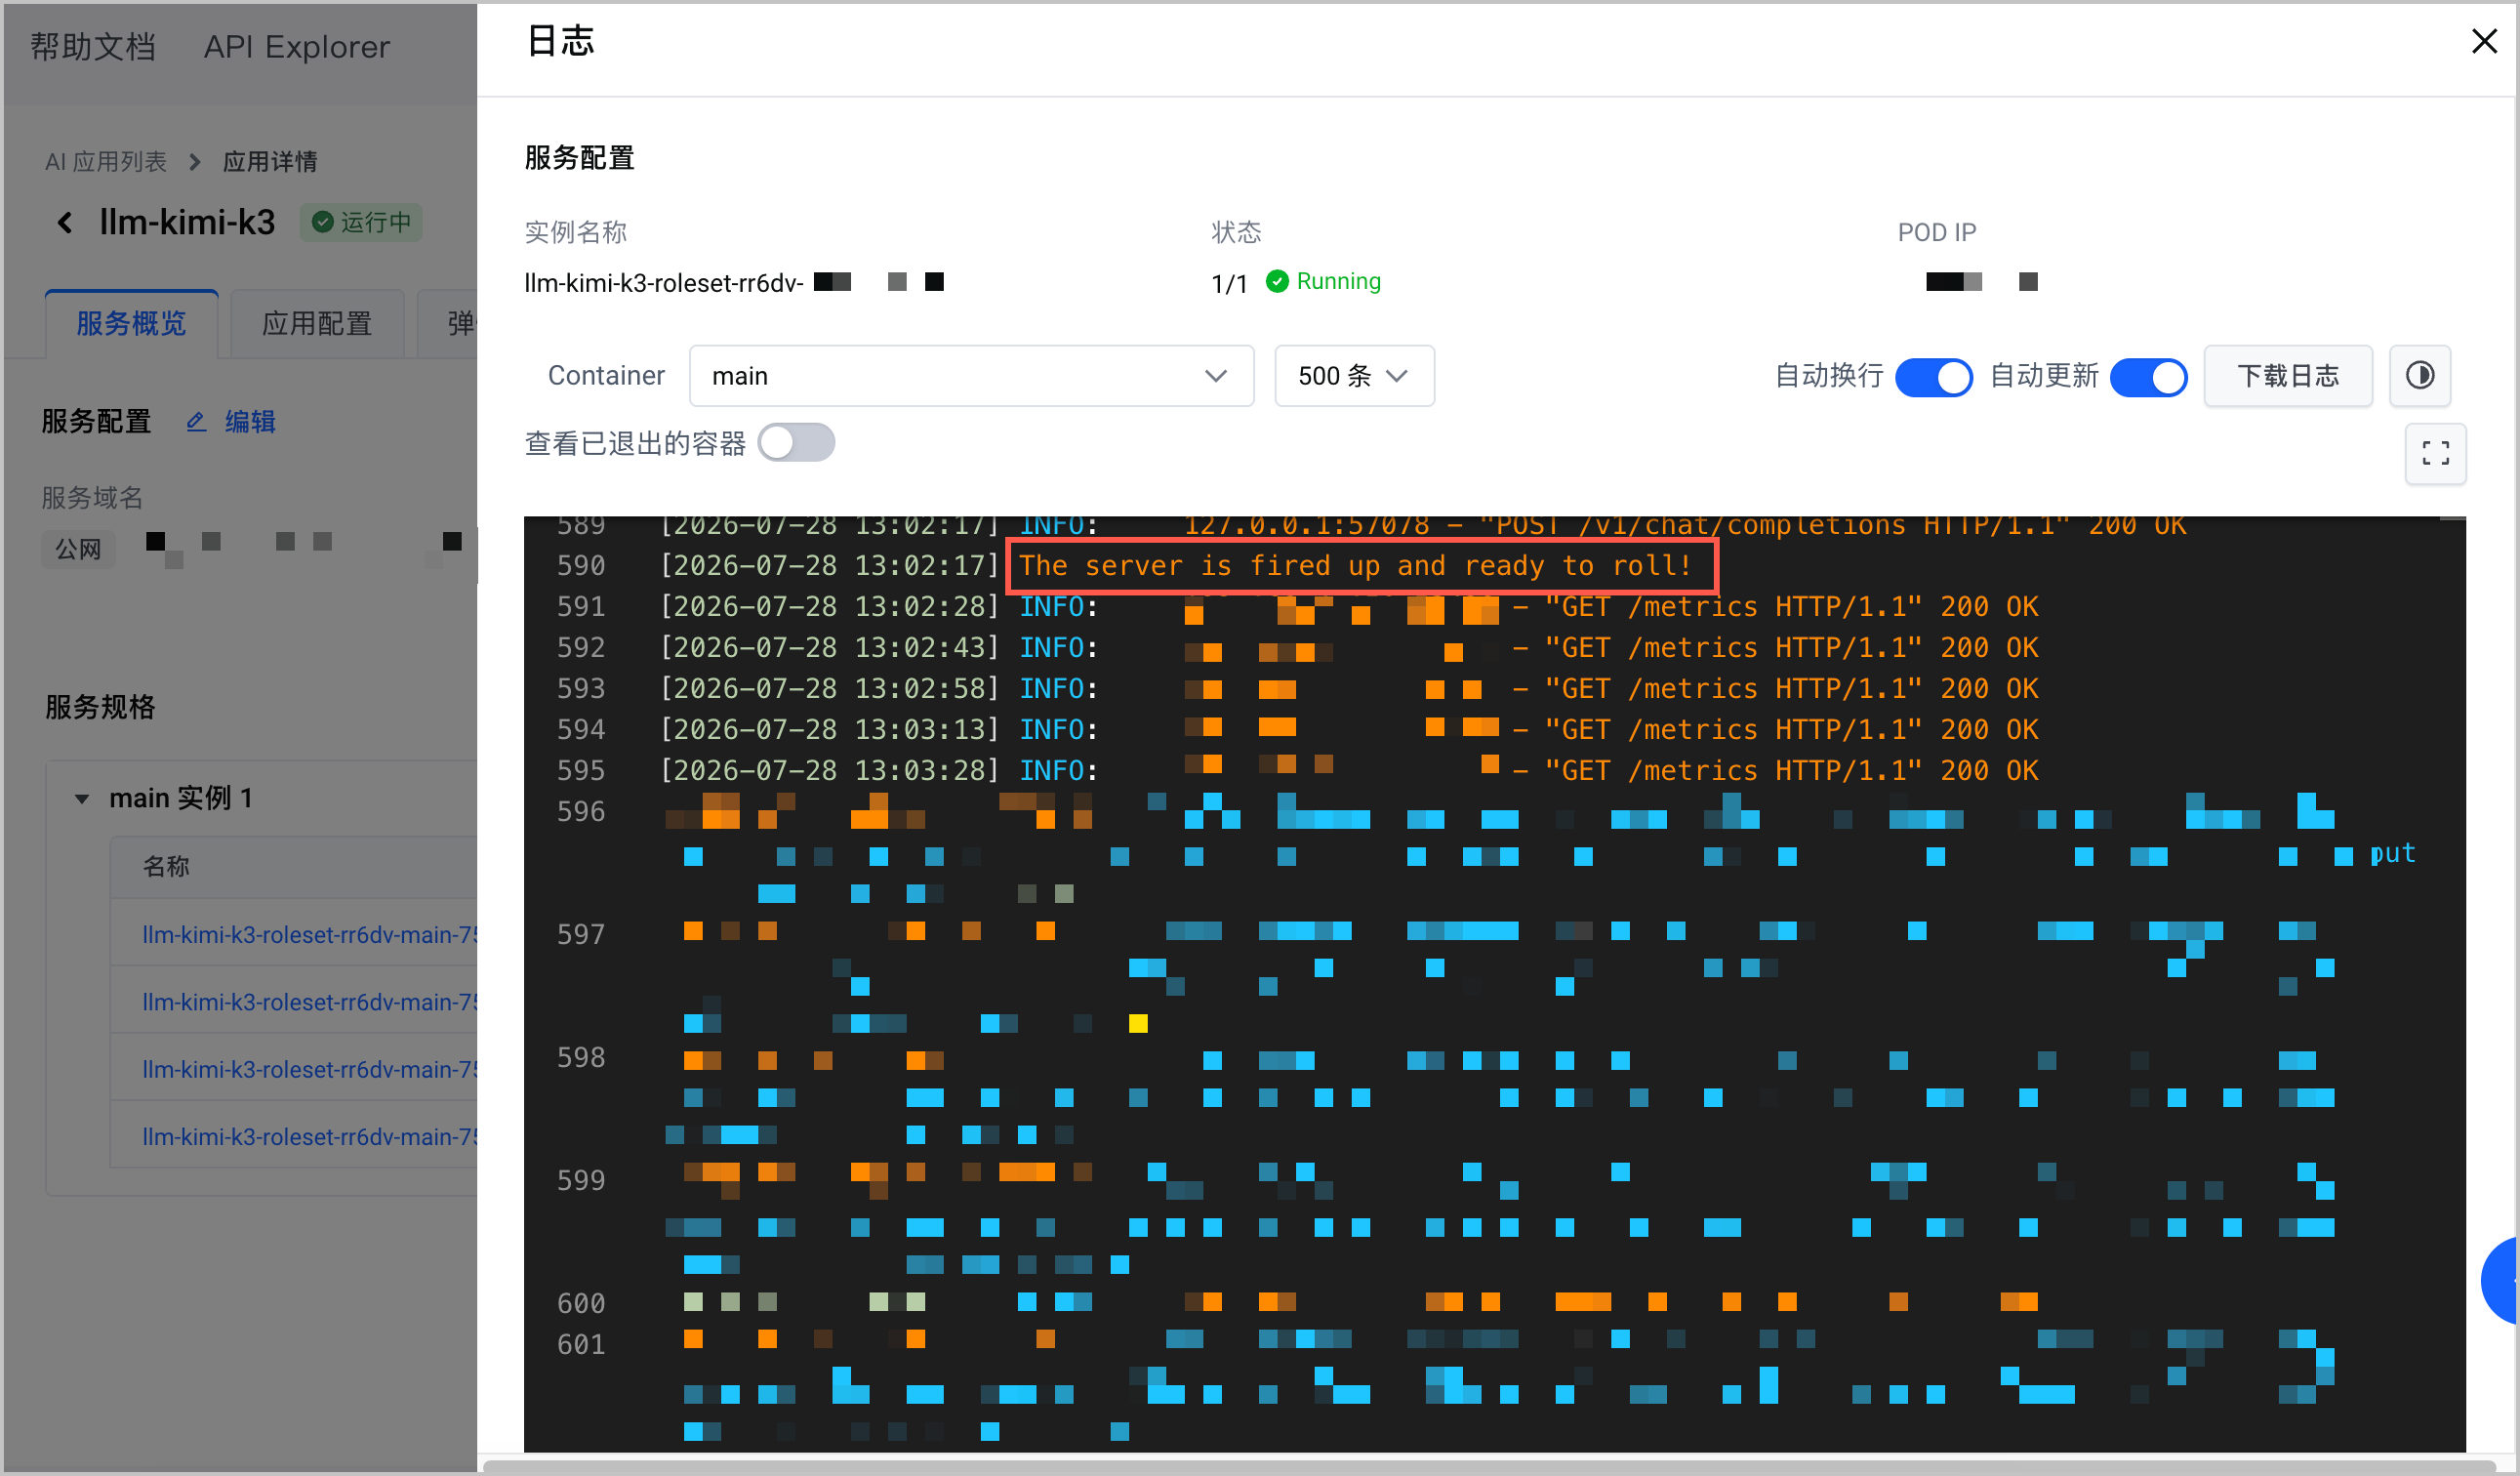
- 应用部署成功后,因模型大小不同,模型启动时间会有差异。请在应用状态变更为 运行中 后在 应用详情 页面查看应用对应实例的 日志。日志中显示The server is fired up and ready to roll!信息,则表示应用中的模型启动成功,您可以访问模型服务。
-
步骤三:访问服务
成功部署 Kimi-K3 模型服务后,获取服务域名,访问服务。
- 获取 Kimi-K3 模型服务域名。
- 在 容器服务控制台 的 推理套件 > AI 应用列表,找到已部署的 Kimi-K3 模型应用。
- 单击应用上的 → 图标,进入应用详情页,查看 服务域名 地址。
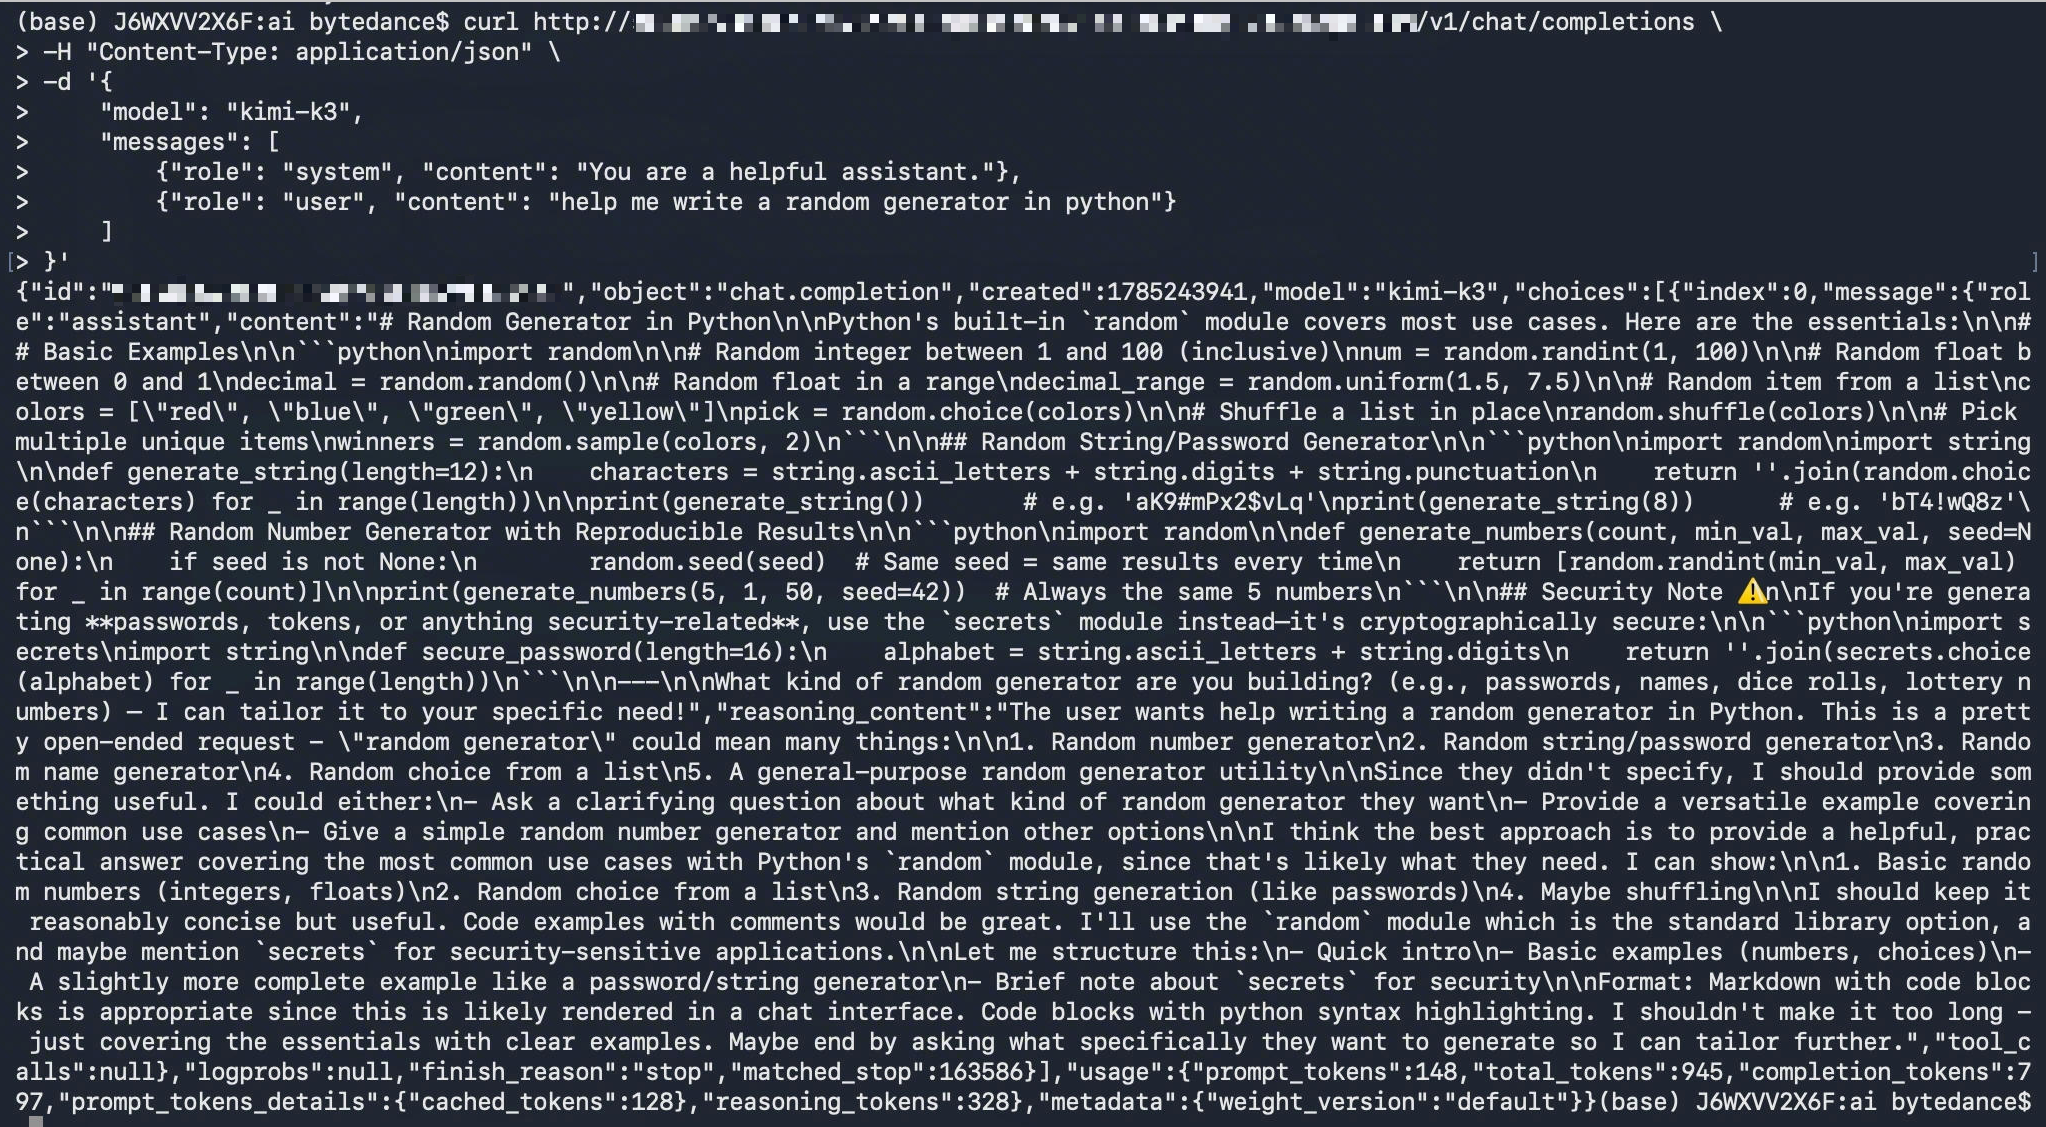
- 在可以使用curl命令的终端上,执行如下命令,访问 Kimi-K3 模型服务。
说明
- 请将${your_service_domain_name}替换为上一步获取的 服务域名 地址。
- 若无可用终端,可通过 ECS Terminal 方式,登录到部署模型的节点上,使用curl命令访问服务。详细操作,请参见 ECS Terminal。
- curl -X POST http://${your_service_domain_name}/v1/chat/completions \-H "Content-Type: application/json" \-d '{"model": "Kimi-K3","messages": [{"role": "system", "content": "You are a helpful assistant."},{"role": "user", "content": "help me write a random generator in python"}]}'
- 命令中的参数说明如下:
- 参数说明取值示例参数说明取值示例model使用的实际模型。Kimi-K3messages对话的消息列表。
- role:该消息的发起角色。
- content:消息的内容。
无
- 调用成功后预期返回结果如下图所示。
-
后续操作
增强服务安全
您可以通过 API 网关的 API Key,增强 Kimi-K3 服务安全能力。
- 为 API 网关实例创建消费者。详细操作,请参见 创建消费者。
- 基于消费者生成 Key Auth 插件认证信息。详细操作,请参见 生成认证信息。
- 启用 Key Auth 插件:在左侧导航栏选择 插件中心 > Key Auth插件,单击 创建插件,配置插件参数。
- 生效级别:选择 路由级别,并配置插件所属实例、服务和路由。
- 认证配置:选择 header,并配置来源为 Authorization,表示在请求头中的 Authorization 附带 API Key 认证信息。
- 消费者:选择步骤 1 中创建的消费者或选择全部,后续新创建的消费者也生效。
- 其他配置保持缺省。
- 开启 Key Auth 插件认证后执行访问服务的命令时,必须携带鉴权信息,未携带时会返回无权限调用的提示信息。
- curl http://${your_service_domain_name}/v1/chat/completions -X POST \-H "Content-Type: application/json" \-H "Authorization: Bearer ${your_api_key}" \-d '{"model": "Kimi-K3","messages": [{"role": "user","content": "help me write a random generator in python"}],"max_tokens": 500,"temperature": 0.7}'
开启观测
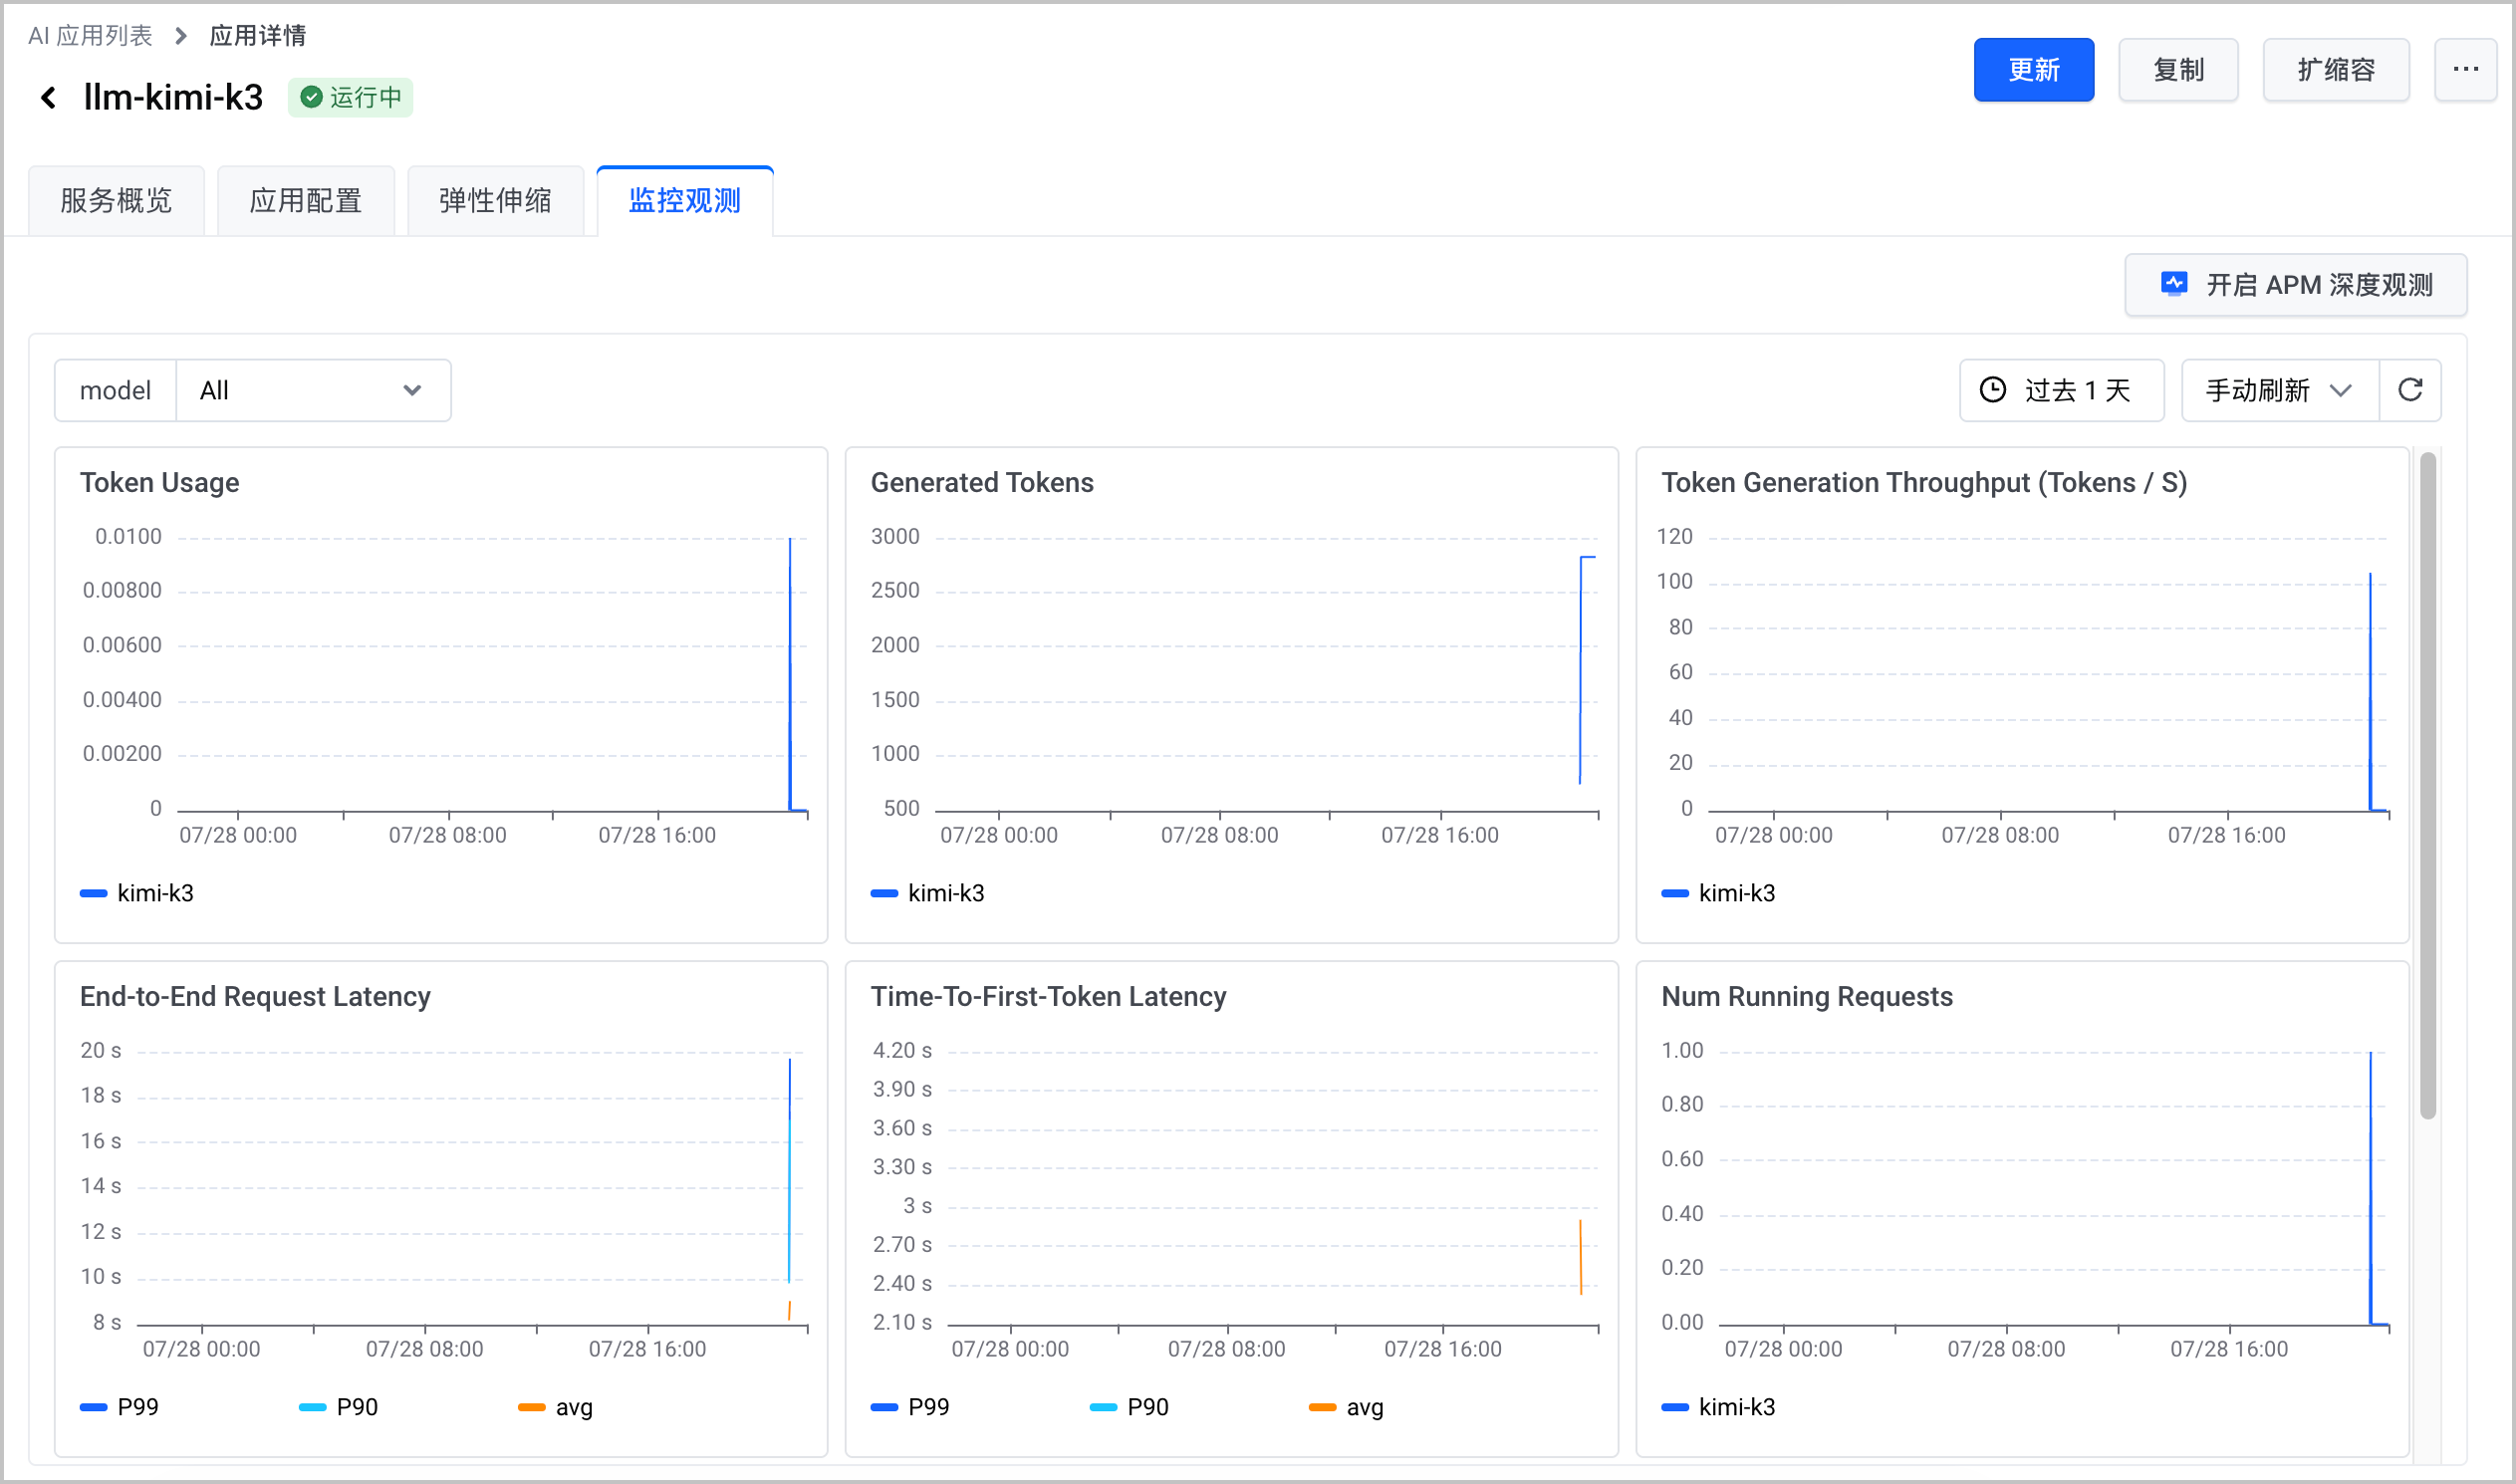
ServingKit AI 应用默认支持云原生基础观测能力,您可以在 AI 应用详情页查看应用监控看板。
- 在 容器服务控制台 的 推理套件 > AI 应用列表,找到已部署的 Kimi-K3 模型应用。
- 单击应用上的 → 图标,进入应用详情页,查看 监控观测 页签下的看板信息。
-
最近更新时间:2026.07.29 14:38:00
这个页面对您有帮助吗?
有用
有用
无用
无用