容器服务
容器服务


文档指南

请输入


- 文档首页
 容器服务AI 云原生推理套件最佳实践Qwen 模型部署通过 LLM 通用模板快速部署 Qwen3.5 模型
 复制全文
 下载 pdf
通过 LLM 通用模板快速部署 Qwen3.5 模型
 文档反馈
 问问助手
本文主要介绍通过 ServingKit LLM 通用模板,在容器服务(VKE)集群中快速部署 Qwen3.5 模型。
背景信息
Qwen3.5 是由通义千问推出的新一代模型,融合了多模态学习、架构效率、强化学习规模和全球可访问性等方面。本文介绍如何通过 LLM 通用模板,在 Kubernetes 集群上快速部署 Qwen3.5 模型。
使用说明
- 本实践涉及较多组件,相互间有依赖,配置复杂,为了获得符合预期的结果,请务必根据本文指引操作。
- 为了获得符合预期的结果,同时符合容器服务的 使用限制,请按照本文方案(或在本文推荐的资源上)操作。如需替换方案,您可以联系对应的火山引擎客户经理咨询。
- 请勿使用 mGPU 对 GPU 进行切分。
准备工作
- 部署 AI 业务,依赖火山引擎邀测资源,请联系客户经理申请如下资源的邀测试用:
-
- 本示例通过 API 网关对外暴露服务,需要准备 API 网关实例。您可以提前创建 API 网关实例或使用已有 API 网关实例,也可以在 ServingKit 上部署应用时同步自动创建实例。
说明
提前创建 API 网关实例或使用已有 API 网关实例时请确保实例的 地域 需要与 VKE 集群的 地域 一致,且建议 网络类型 同时开启 公网 和 私网。创建 API 网关实例相关操作,请参见 创建实例。
- 需要创建高性能计算集群,用于实现高性能计算 GPU 实例(计算节点)的逻辑隔离,实现同一集群内实例间 RDMA 网络互联互通。详情请参见 创建高性能计算集群。
说明
高性能计算集群所在的 地域和可用区 需要与 VKE 集群的 地域和可用区 一致。
操作步骤
步骤一:创建 VKE 异构计算集群
配置项 | 说明 |
集群及节点池配置 | |
地域 | 地域 和 可用区,需要与前期准备的高性能计算集群的地域和可用区一致。 您可以通过顶部导航栏切换地域。 |
可用区 | |
计算规格 | 选择 高性能计算 GPU 型 的ecs.hpcpni3ln.45xlarge规格。 |
节点数量 | 设置为 2。 |
高级配置 | |
数据盘 | 配置如下两个数据盘:
|
步骤二:部署 Qwen3.5
- 通过 ServingKit 提供的 LLM 通用部署模板 下载并部署模型。部署过程中,需要注意以下列举的参数配置,其余参数说明和详细的操作步骤,请参见 部署 LLM 通用模板应用。
- 参数说明选择框架及编排镜像选择 自定义 并根据您业务所在地域,从如下镜像地址中选择合适的镜像:
- 华北2(北京):ai-containers-cn-beijing.cr.volces.com/deeplearning/sglang:community_v0.5.8_0217
- 华东2(上海):ai-containers-cn-shanghai.cr.volces.com/deeplearning/sglang:community_v0.5.8_0217
- 亚太东南(柔佛):ai-containers-ap-southeast-1.cr.volces.com/deeplearning/sglang:community_v0.5.8_0217
模型配置- 存储类型:选择 云盘。
- 模型选择:单击 添加预置模型,选择 Qwen3.5-397B-A17B 模型并配置 挂载路径 为/data01、容器挂载路径 为/data/models,表示将模型数据下载至/data01目录。
推理模式选择 PD 共置。实例规格- 实例数: 设置为 1。
- 单实例 GPU 数:设置为 16。
资源配置选择 步骤一 中创建的 VKE 异构计算集群,以及该集群下ecs.hpcpni3ln.45xlarge规格节点所在的节点池。启动命令添加如下启动命令。启动命令中各字段的详细说明,请参见下方“启动命令详细说明”表格。端口号 设置为 8000。API 网关勾选 开启,绑定前期准备的 API 网关实例。说明
- 启动命令详细说明
- 参数名称参数类型说明取值示例python -m sglang.launch_server启动指令通过 Python 模块方式启动 SGLang 的模型服务端。说明该字段属于命令入口,非参数。---model-path路径/模型 ID指定加载的 LLM 模型,取值:
- Hugging Face 模型 ID。
- 本地模型路径。
/data/models/Qwen3.5-397B-A17B--tp-size 整数配置张量并行度(Tensor Parallelism),默认值为 16。16--hostIP地址指定服务绑定的主机地址。0.0.0.0--port整数指定服务监听的端口号,用于客户端连接。8000--dist-init-addrIP: 端口分布式集群的初始化地址(主节点地址),用于多节点通信同步。变量注入--nnodes整数指定分布式集群的总节点数,即参与服务的服务器数量。2--enable-metrics指令-
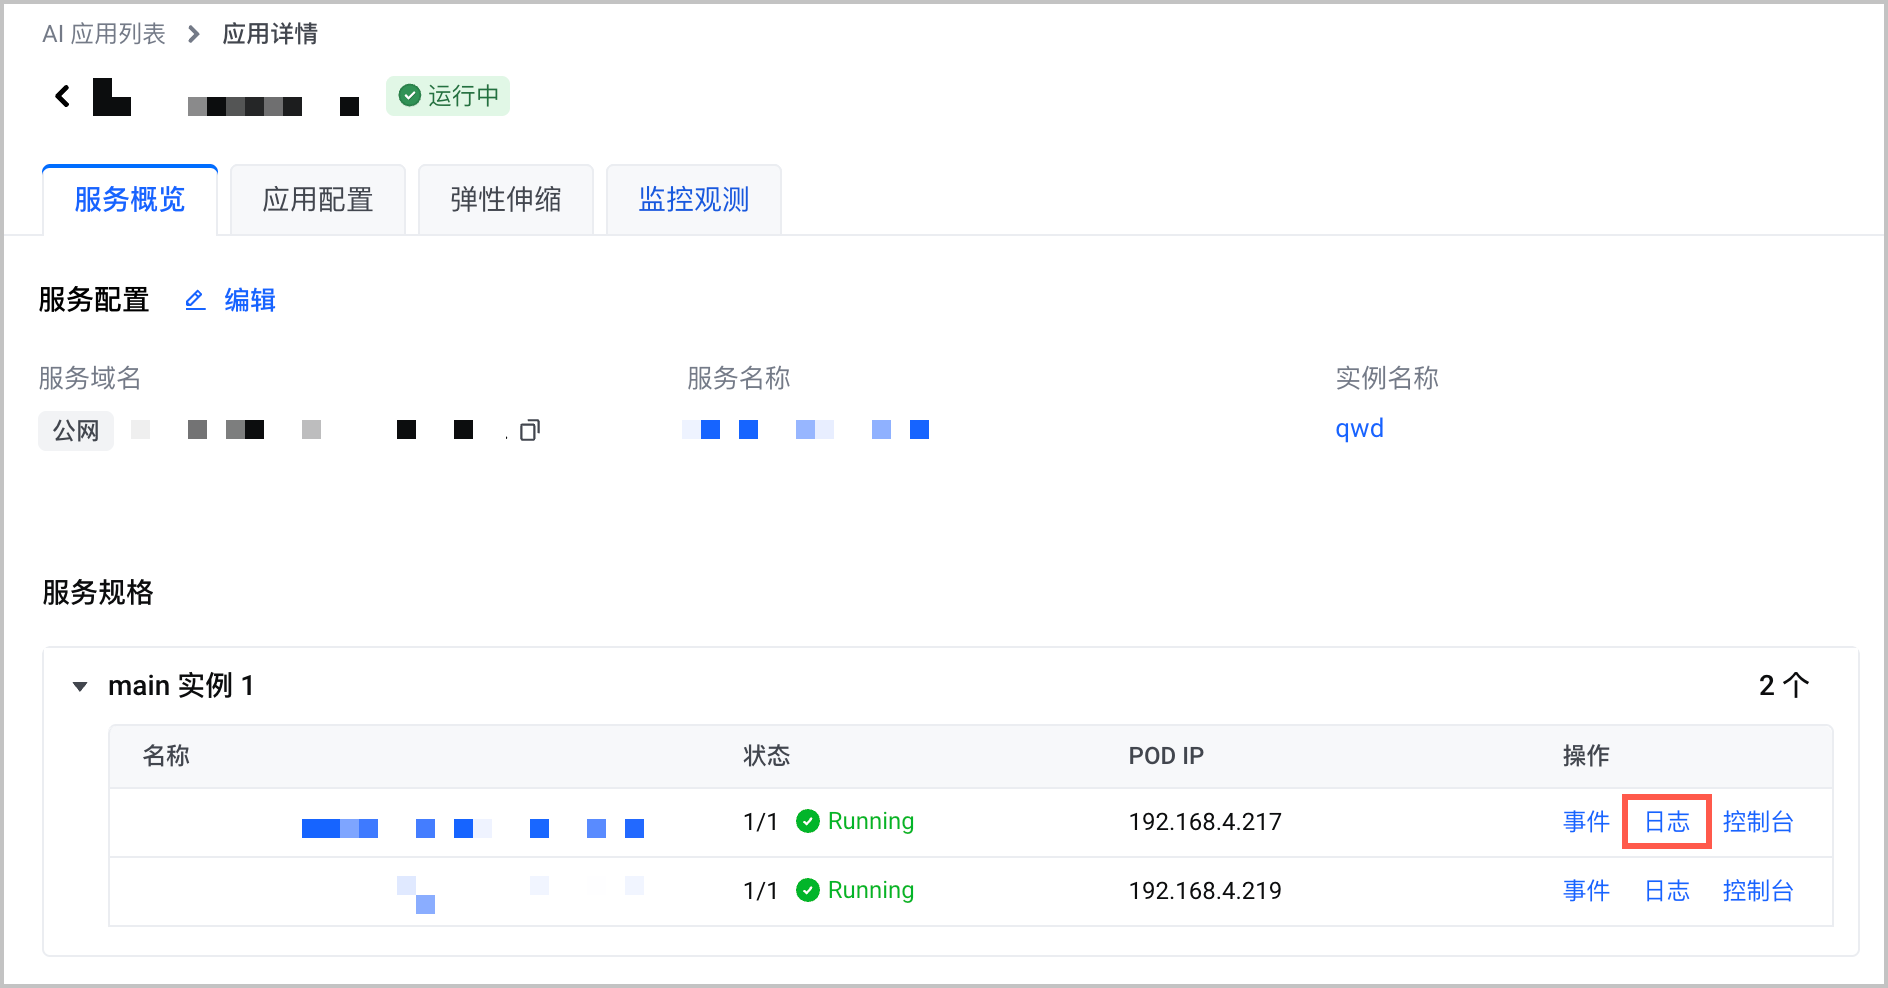
- 应用部署成功后,因模型大小不同,模型启动时间会有差异。请在应用状态变更为 运行中 后在 应用详情 页面查看应用对应实例的 日志。日志中显示The server is fired up and ready to roll!信息,则表示应用中的模型启动成功,您可以访问模型服务。
-
步骤三:访问服务
成功部署 Qwen3.5 模型服务后,获取服务域名,访问服务。
- 获取 Qwen3.5 模型服务域名。
- 在 容器服务控制台 的 推理套件 > AI 应用列表,找到已部署的 Qwen3.5 模型应用。
- 单击应用上的 → 图标,进入应用详情页,查看 服务域名 地址。
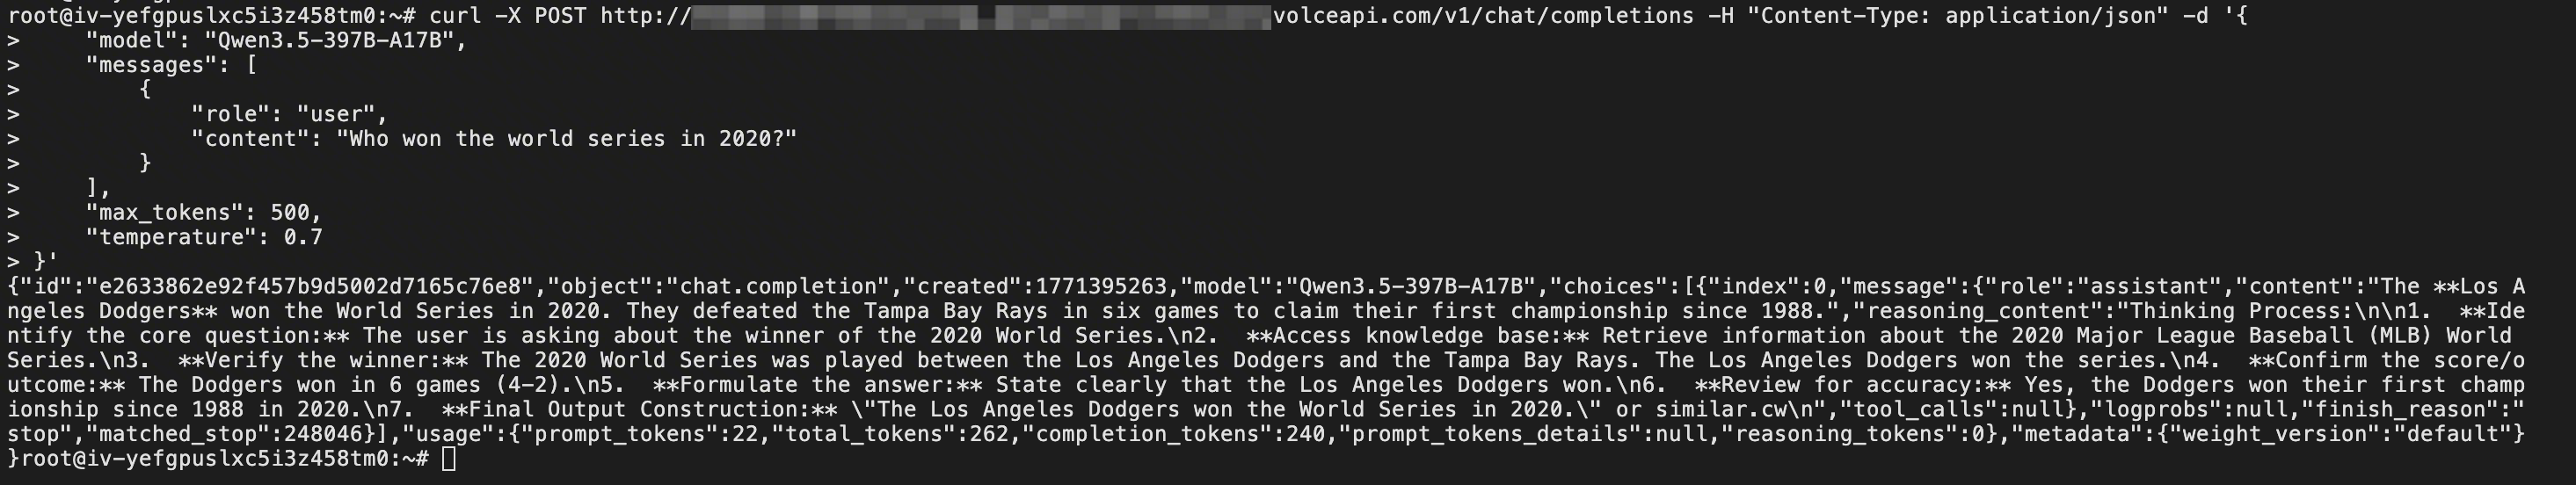
- 在可以使用curl命令的终端上,执行如下命令,访问 Qwen3.5 模型服务。
说明
- 请将${your_service_domain_name}替换为上一步获取的 服务域名 地址。
- 若无可用终端,可通过 ECS Terminal 方式,登录到部署模型的节点上,使用curl命令访问服务。详细操作,请参见 ECS Terminal。
-
- 命令中的参数说明如下:
-
- 调用成功后预期返回结果如下图所示。
-
后续操作
增强服务安全
您可以通过 API 网关的 API Key,增强 Qwen3.5 服务安全能力。
- 为 API 网关实例创建消费者。详细操作,请参见 创建消费者。
- 基于消费者生成 Key Auth 插件认证信息。详细操作,请参见 生成认证信息。
- 启用 Key Auth 插件:在左侧导航栏选择 插件中心 > Key Auth插件,单击 创建插件,配置插件参数。
- 生效级别:选择 路由级别,并配置插件所属实例、服务和路由。
- 认证配置:选择 header,并配置来源为 Authorization,表示在请求头中的 Authorization 附带 API Key 认证信息。
- 消费者:选择步骤 1 中创建的消费者或选择全部,后续新创建的消费者也生效。
- 其他配置保持缺省。
- 开启 Key Auth 插件认证后执行访问服务的命令时,必须携带鉴权信息,未携带时会返回无权限调用的提示信息。
-
开启观测
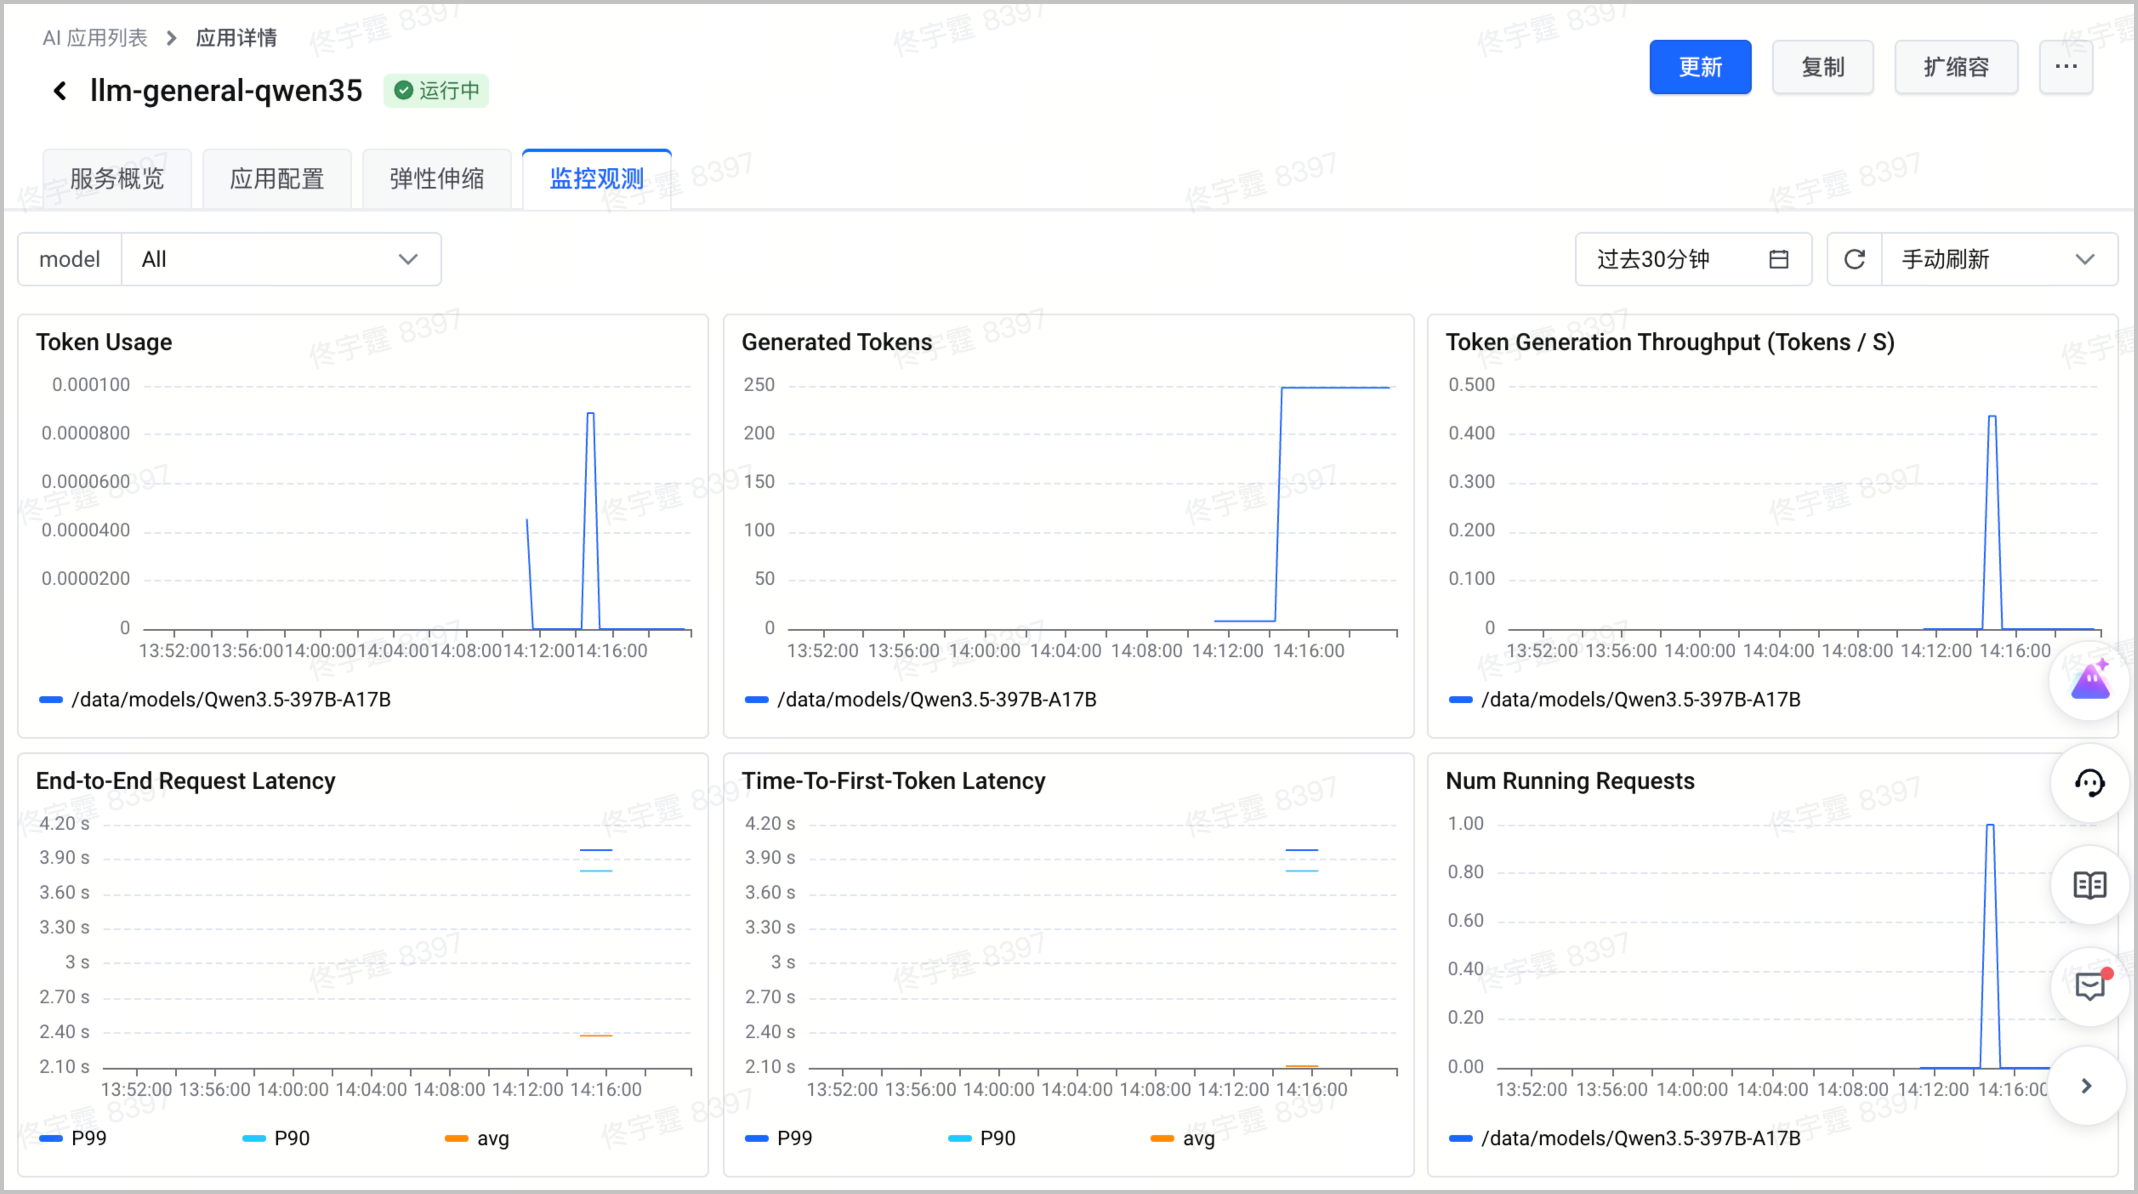
ServingKit AI 应用默认支持云原生基础观测能力,您可以在 AI 应用详情页查看应用监控看板。
- 在 容器服务控制台 的 推理套件 > AI 应用列表,找到已部署的 Qwen3.5 模型应用。
- 单击应用上的 → 图标,进入应用详情页,查看 监控观测 页签下的看板信息。
-
最近更新时间:2026.07.27 15:46:14
这个页面对您有帮助吗?
有用
有用
无用
无用