容器服务
容器服务
容器服务


文档指南
请输入


容器服务 VKE
产品动态
Kubernetes 版本发布记录
组件发布记录
监控组件
DNS 组件
GPU 组件
Sandbox 组件
安全公告
产品公告
历史公告
用户指南
集群
节点池
授权
网络
容器网络
服务(Service)
路由(Ingress)
APIG Ingress
ALB Ingress
自定义转发规则配置示例
CLB Ingress
Nginx Ingress
Gateway API
工作负载
存储
数据管理中心(DMC)
对象存储(TOS)
FSX 访问方式
文件存储(NAS)
FSX 访问方式
弹性文件存储(EFS)
文件存储(vePFS)
FSX 访问方式
vePFS Client 访问方式
NFS 访问方式
大数据文件存储(CloudFS)
弹性伸缩
工作负载弹性伸缩
事件驱动伸缩(KEDA)
组件管理
网络组件
监控组件
DNS 组件
GPU 组件
Sandbox 组件
异构计算
调度管理
可观测性
基础观测
诊断与巡检
最佳实践
网络
可观测性
安全合规
API 参考
集群管理
节点池管理
组件管理
机型镜像管理
云原生观测
巡检诊断
弹性容器实例
附录
开发指南
常见问题
通用 FAQ
集群 FAQ
集群管理
集群升级
节点与节点池 FAQ
授权 FAQ
工作负载 FAQ
服务与路由 FAQ
存储 FAQ
弹性伸缩 FAQ
可观测性 FAQ
配额 FAQ
组件 FAQ
容器镜像 FAQ
AI 云原生
推理套件
Helm 模板 AI 应用
Deepseek 实践
Qwen 实践
最佳实践
MiniMax 模型部署
Qwen 模型部署
弹性容器实例 VCI
最新动态
用户指南
虚拟节点
VKE 集群使用虚拟节点
自建/跨云集群使用虚拟节点
创建 VCI 实例
VCI Agent Sandbox
安全合规
- 文档首页
 容器服务容器服务 VKE用户指南可观测性AI Profiling
 复制全文
 下载 pdf
AI Profiling
 文档反馈
 问问助手
当您在容器服务集群中部署大语言模型(LLM)时,支持对指定容器进行 AI Profiling 分析,方便面向 LLM 全生命周期(训练、推理、优化)进行检测和调优。本文介绍如何配置 AI Profiling 功能。
背景信息
随着大语言模型(LLM)的普及,AI 训练与推理的性能检测和调优需求日益增长。对于 LLM 这种运行在 GPU 节点上的业务,对 GPU 容器进行在线性能分析尤为重要。AI Profiling 通过 eBPF 和动态进程注入技术,支持无侵入进行数据采集与分析,专为 Kubernetes 容器场景设计,可对运行 GPU 任务的容器进程实施在线检测。
当前 AI Profiling 支持的采集项及说明,如下表所示。
采集项 | 说明 |
采集项 | 说明 |
CUDA | 即 CUDA 核函数。可以用于观测和分析 LLM 底层 GPU 资源的状态,例如:GPU 繁忙时间、GPU 核函数的分布、TimeLine 分析(例如:分析一个训练步骤,包括数据加载、前向传播、后向传播和优化器更新)等。 |
PyTorch | 即 PyTorch 算子,可以用于 精准定位模型性能瓶颈,为优化模型效率、提升训练 / 推理速度、降低资源消耗提供数据支持。包括:
|
Python | 即 Python 进程调用栈。Python 作为动态语言,其代码执行路径灵活多变(如条件分支、动态函数调用),调用栈能将零散的性能数据(耗时、资源占用)锚定到具体代码位置。对于复杂 AI 系统(如大模型训练、分布式推理),调用栈分析更是解决跨模块、跨硬件性能问题的必备能力。例如:
|
使用限制
配置 AI Profiling 的容器,需要满足以下环境和版本要求。
要求分类 | 环境要求 |
要求分类 | 环境要求 |
基础环境 |
|
Pytorch 额外要求 |
|
工具链 |
|
插件版本 |
|
前提条件
操作步骤
步骤一:诊断设置
- 登录 容器服务控制台。
- 在左侧导航栏中选择 集群。
- 在集群列表页面,单击目标集群。
- 在集群管理页面的左侧导航栏中,选择 AI Profiling,单击 诊断设置。
- 选择已创建的 TOS 桶,并配置子目录。该对象存存储和目录用于存放 AI Profiling 采集到的数据。
- 配置项说明配置项说明桶名称在下拉菜单中选择已创建的 TOS 桶。子目录配置抓包结果保存在 TOS 桶中的路径,未配置时为/路径。
- 单击 确定,完成配置。
步骤二:创建诊断任务
- 单击 创建诊断任务,配置诊断任务详情。
-
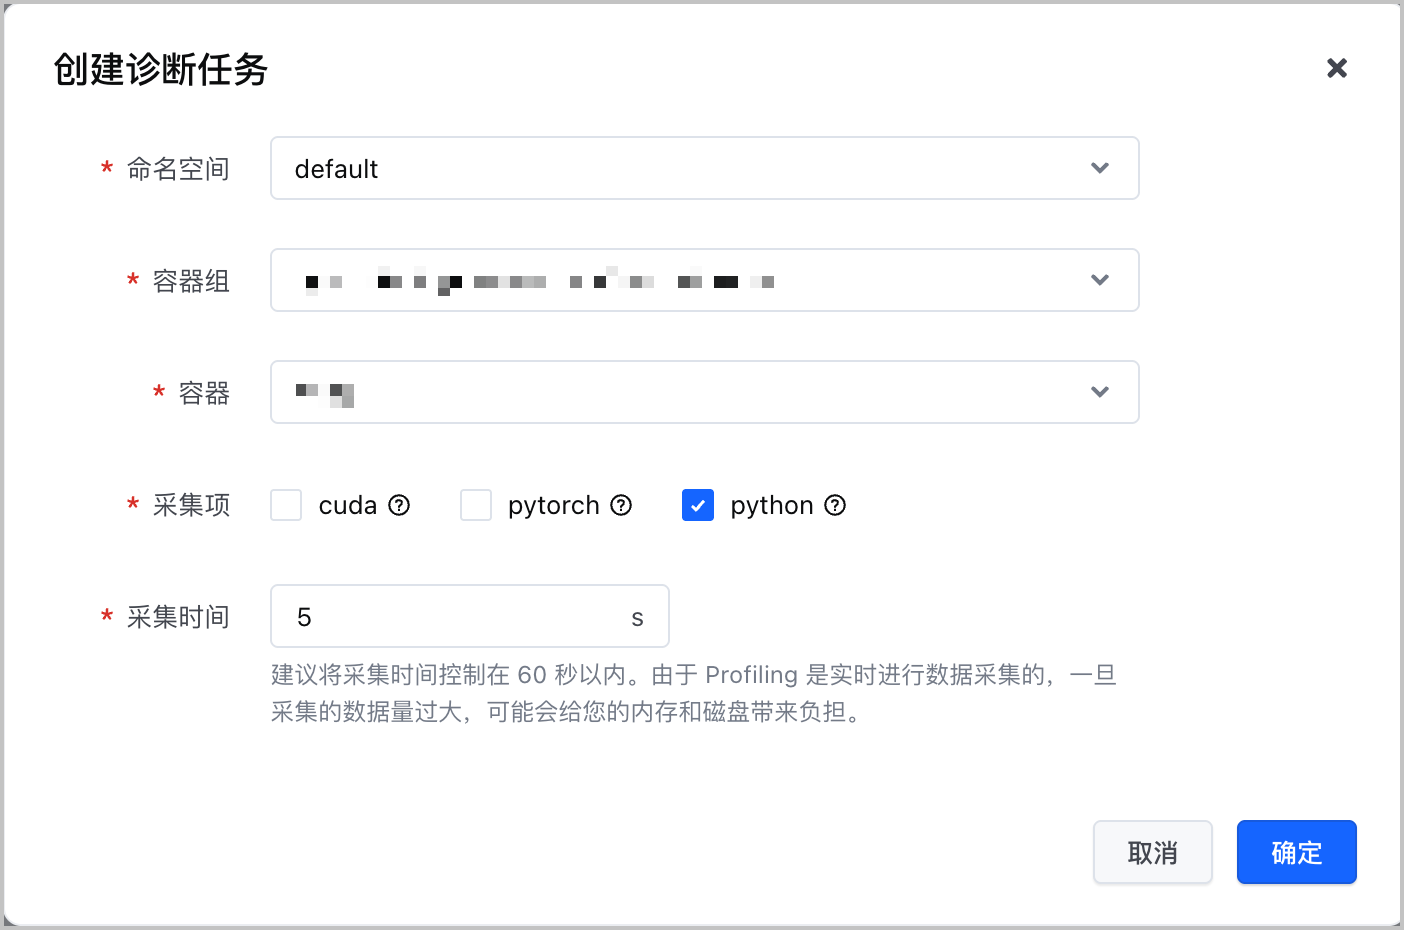
- 配置项说明配置项说明命名空间选择诊断任务目标所在的命名空间。容器组选择抓包任务的目标容器组。容器选择抓包任务的目标容器。采集项配置采集目标的采集项,包括:
- cuda:即 CUDA 核函数,需要保证目标容器正在使用 GPU,才能成功采集到相关数据。
- pytorch:PyTorch 算子。
- python:Python 进程调用栈。
采集时间配置检测时长。说明检测时长建议控制在 60 秒以内,AI Profiling 为实时采集,采集数据过多可能会对内存和磁盘产生压力。
- 单击 确定,完成配置。
结果验证
- 诊断任务配置完成后,系统开始进行诊断。当任务状态变为 完成 后,表示诊断任务进行完成。
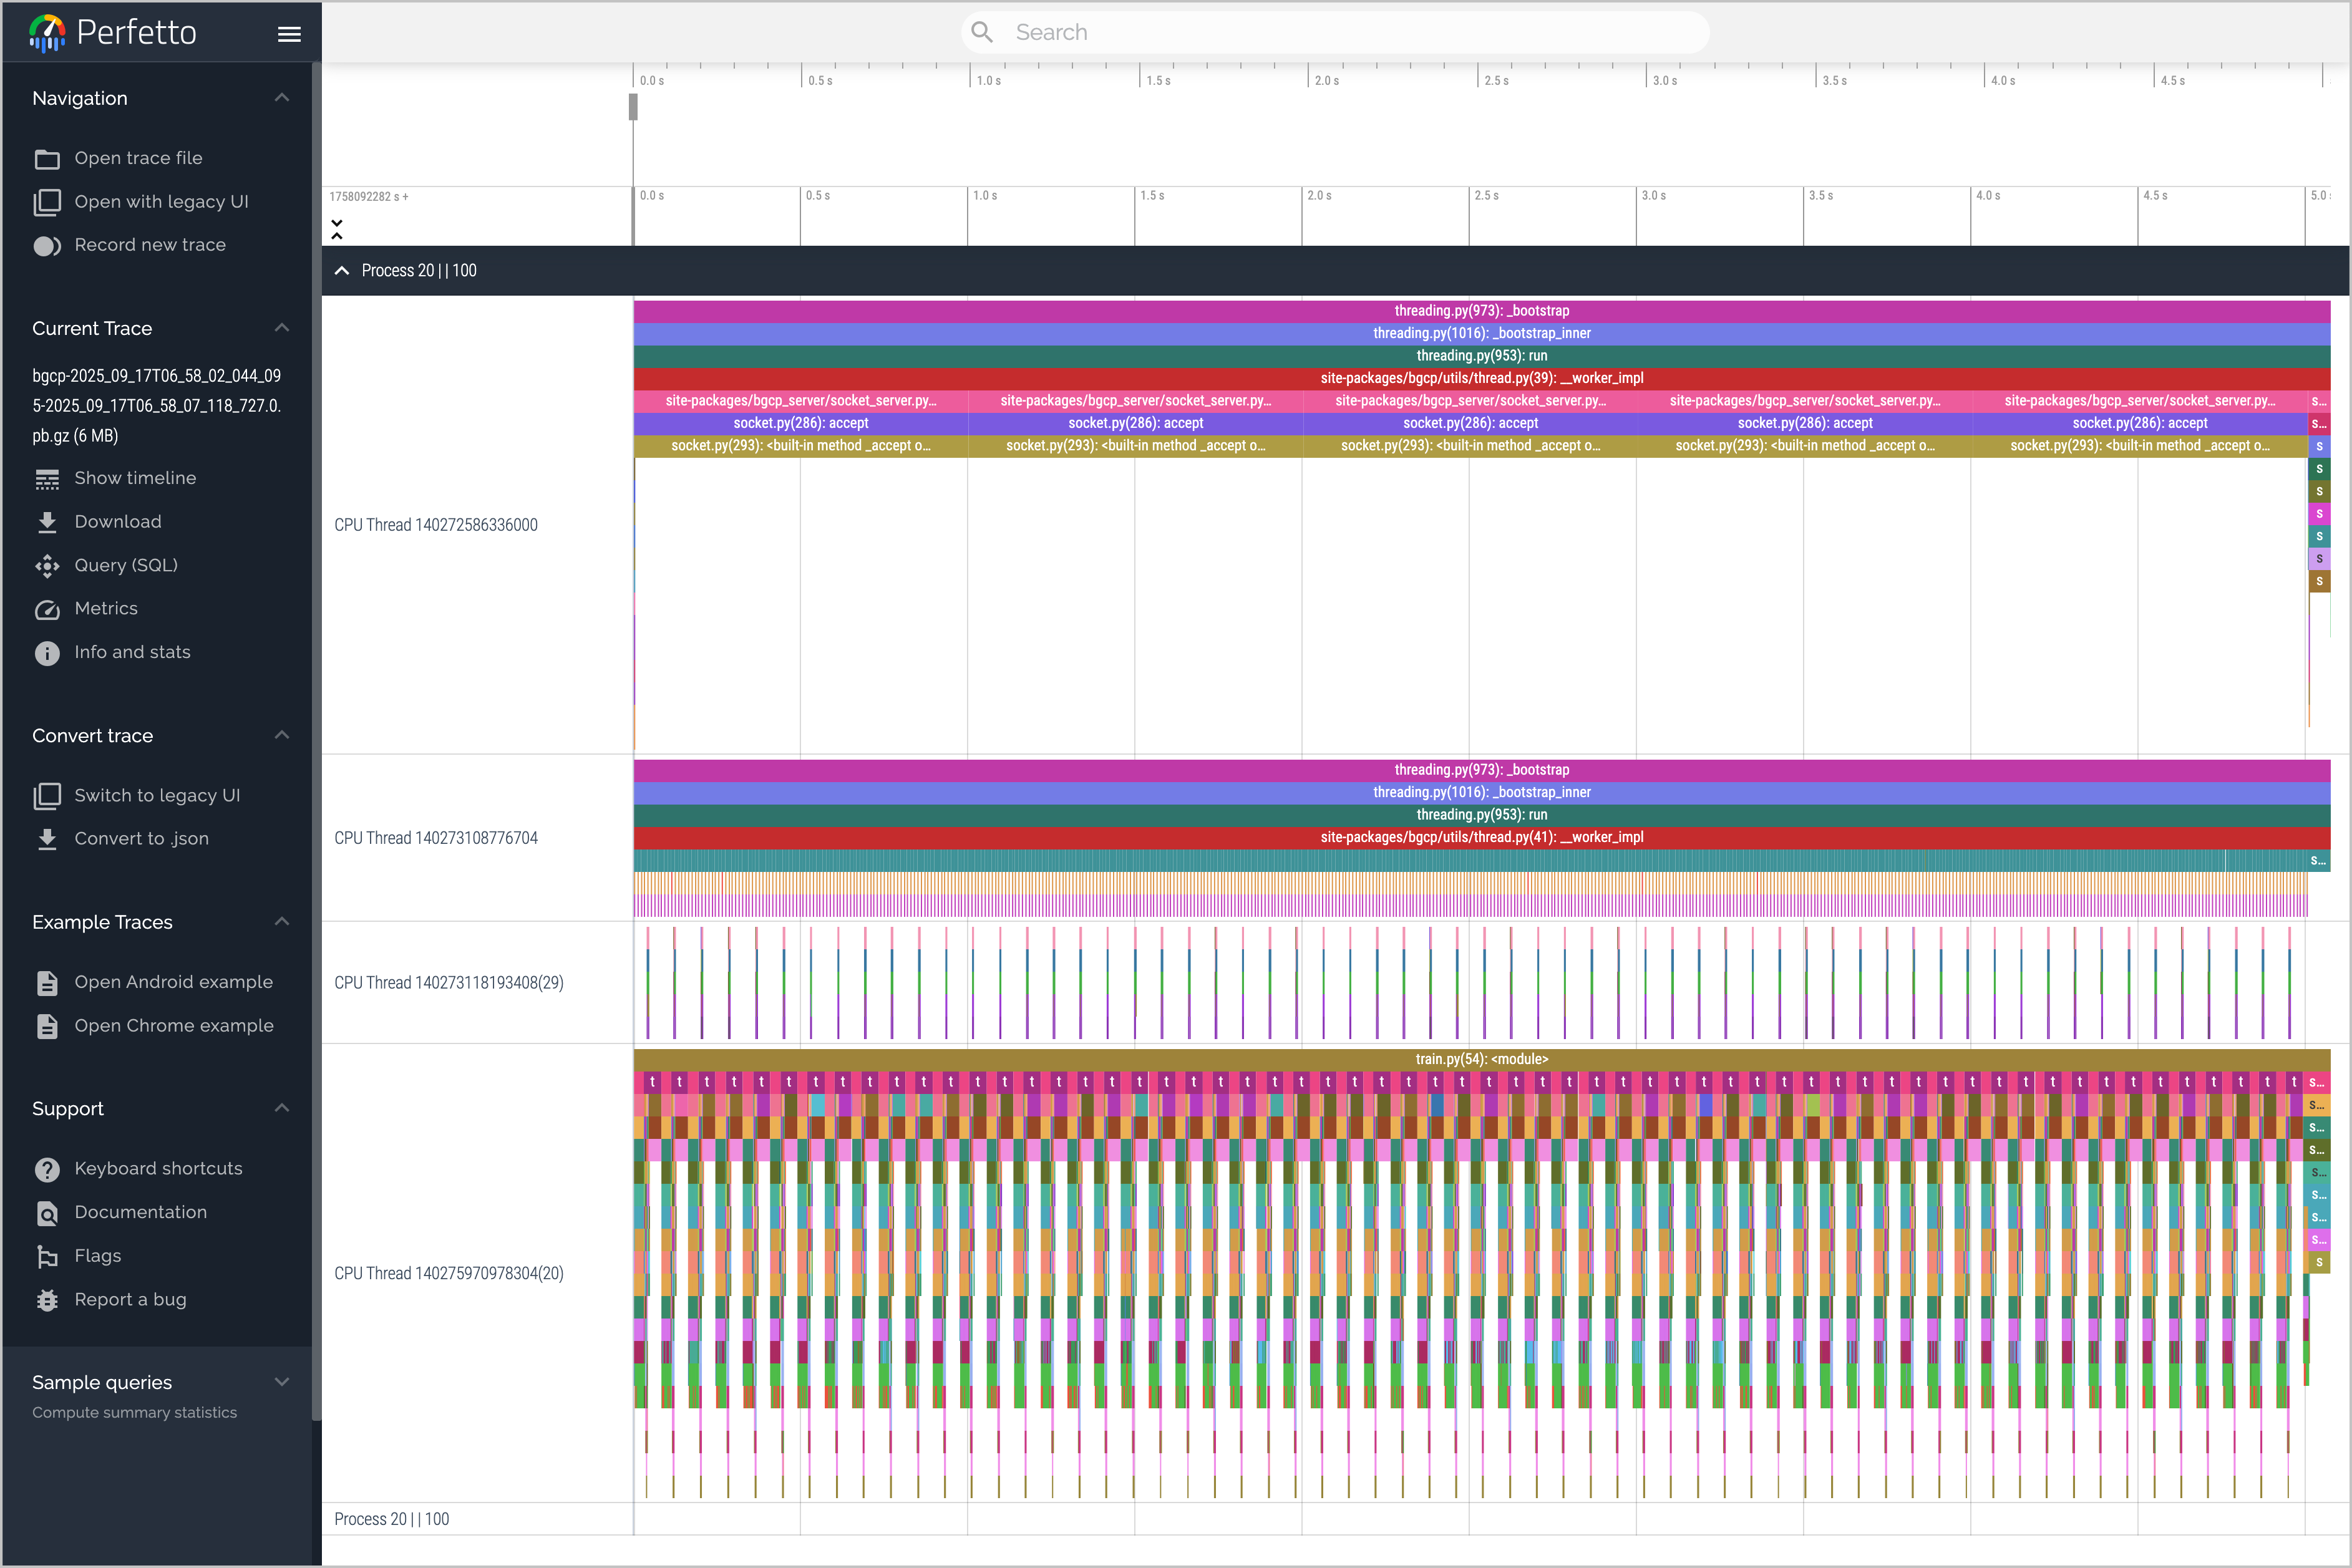
- 单击任务名称,进入任务详情页面。在 诊断结果 中单击 点击下载,可以将 AI Profiling 诊断结果文件下载到本地。您可以将 Profiling 文件上传到 Perfetto 在线工具 进行可视化分析。
-
最近更新时间:2026.03.17 10:36:11
这个页面对您有帮助吗?
有用
有用
无用
无用