容器服务
容器服务
容器服务


文档指南
请输入


容器服务 VKE
产品动态
Kubernetes 版本发布记录
组件发布记录
监控组件
DNS 组件
GPU 组件
Sandbox 组件
安全公告
产品公告
历史公告
用户指南
集群
节点池
授权
网络
容器网络
服务(Service)
路由(Ingress)
APIG Ingress
ALB Ingress
自定义转发规则配置示例
CLB Ingress
Nginx Ingress
Gateway API
工作负载
存储
数据管理中心(DMC)
对象存储(TOS)
FSX 访问方式
文件存储(NAS)
FSX 访问方式
弹性文件存储(EFS)
文件存储(vePFS)
FSX 访问方式
vePFS Client 访问方式
NFS 访问方式
大数据文件存储(CloudFS)
弹性伸缩
工作负载弹性伸缩
事件驱动伸缩(KEDA)
组件管理
网络组件
监控组件
DNS 组件
GPU 组件
Sandbox 组件
异构计算
调度管理
可观测性
基础观测
诊断与巡检
最佳实践
网络
可观测性
安全合规
API 参考
集群管理
节点池管理
组件管理
机型镜像管理
云原生观测
巡检诊断
弹性容器实例
附录
开发指南
常见问题
通用 FAQ
集群 FAQ
集群管理
集群升级
节点与节点池 FAQ
授权 FAQ
工作负载 FAQ
服务与路由 FAQ
存储 FAQ
弹性伸缩 FAQ
可观测性 FAQ
配额 FAQ
组件 FAQ
容器镜像 FAQ
AI 云原生
推理套件
Helm 模板 AI 应用
Deepseek 实践
Qwen 实践
最佳实践
MiniMax 模型部署
Qwen 模型部署
弹性容器实例 VCI
最新动态
用户指南
虚拟节点
VKE 集群使用虚拟节点
自建/跨云集群使用虚拟节点
创建 VCI 实例
VCI Agent Sandbox
安全合规
- 文档首页
 容器服务容器服务 VKE最佳实践可观测性云监控切换托管 Prometheus 告警配置最佳实践
 复制全文
 下载 pdf
云监控切换托管 Prometheus 告警配置最佳实践
 文档反馈
 问问助手
容器集群中的云监控组件(metrics-collector)下线后,对应的告警规则无法直接使用或迁移到托管 Prometheus 上。本文介绍如何在托管 Prometheus 上配置云监控对应的告警规则。
背景信息
容器服务(VKE) 即将于北京时间 2025 年 10 月 9 日停止 metrics-collector 组件服务,已有容器集群中安装的 metrics-collector 组件也将统一停止服务。当组件停止服务后,容器集群的指标监控不再由云监控提供支持,建议使用 云原生观测。
说明
云原生观测服务将集群中采集到的指标保存在托管 Prometheus 的工作区中,详情请参见 基础观测概述。托管 Prometheus 提供了免运维、高性能、高稳定的集群观测与告警服务,您可以在托管 Prometheus 的控制台中查看集群指标或集群预置大盘。具体操作方式,可参考如下文档:
- 指标查询
- 预置看板
由于云监控与托管 Prometheus 的告警配置方式不同。因此,云监控的告警规则无法直接使用或迁到在托管 Prometheus 产品上,您需要按照下文提供的操作步骤和指标对照清单,手工在托管 Prometheus 配置需要的告警。
操作步骤
以下以使用 集群 CPU 用量 指标配置告警规则为例,介绍在托管 Prometheus 控制台中配置告警的步骤。
- 登录 VMP 服务控制台。
- 在顶部导航栏,选择目标地域。
- 单击左侧导航栏的 告警中心 > 告警规则。单击 创建,在弹出的下拉菜单中选择 手动创建。
-

- 配置基本信息。
-

- 配置项说明配置项说明名称配置告警规则的名称。描述配置告警规则的描述信息。
- 配置告警触发条件。
-
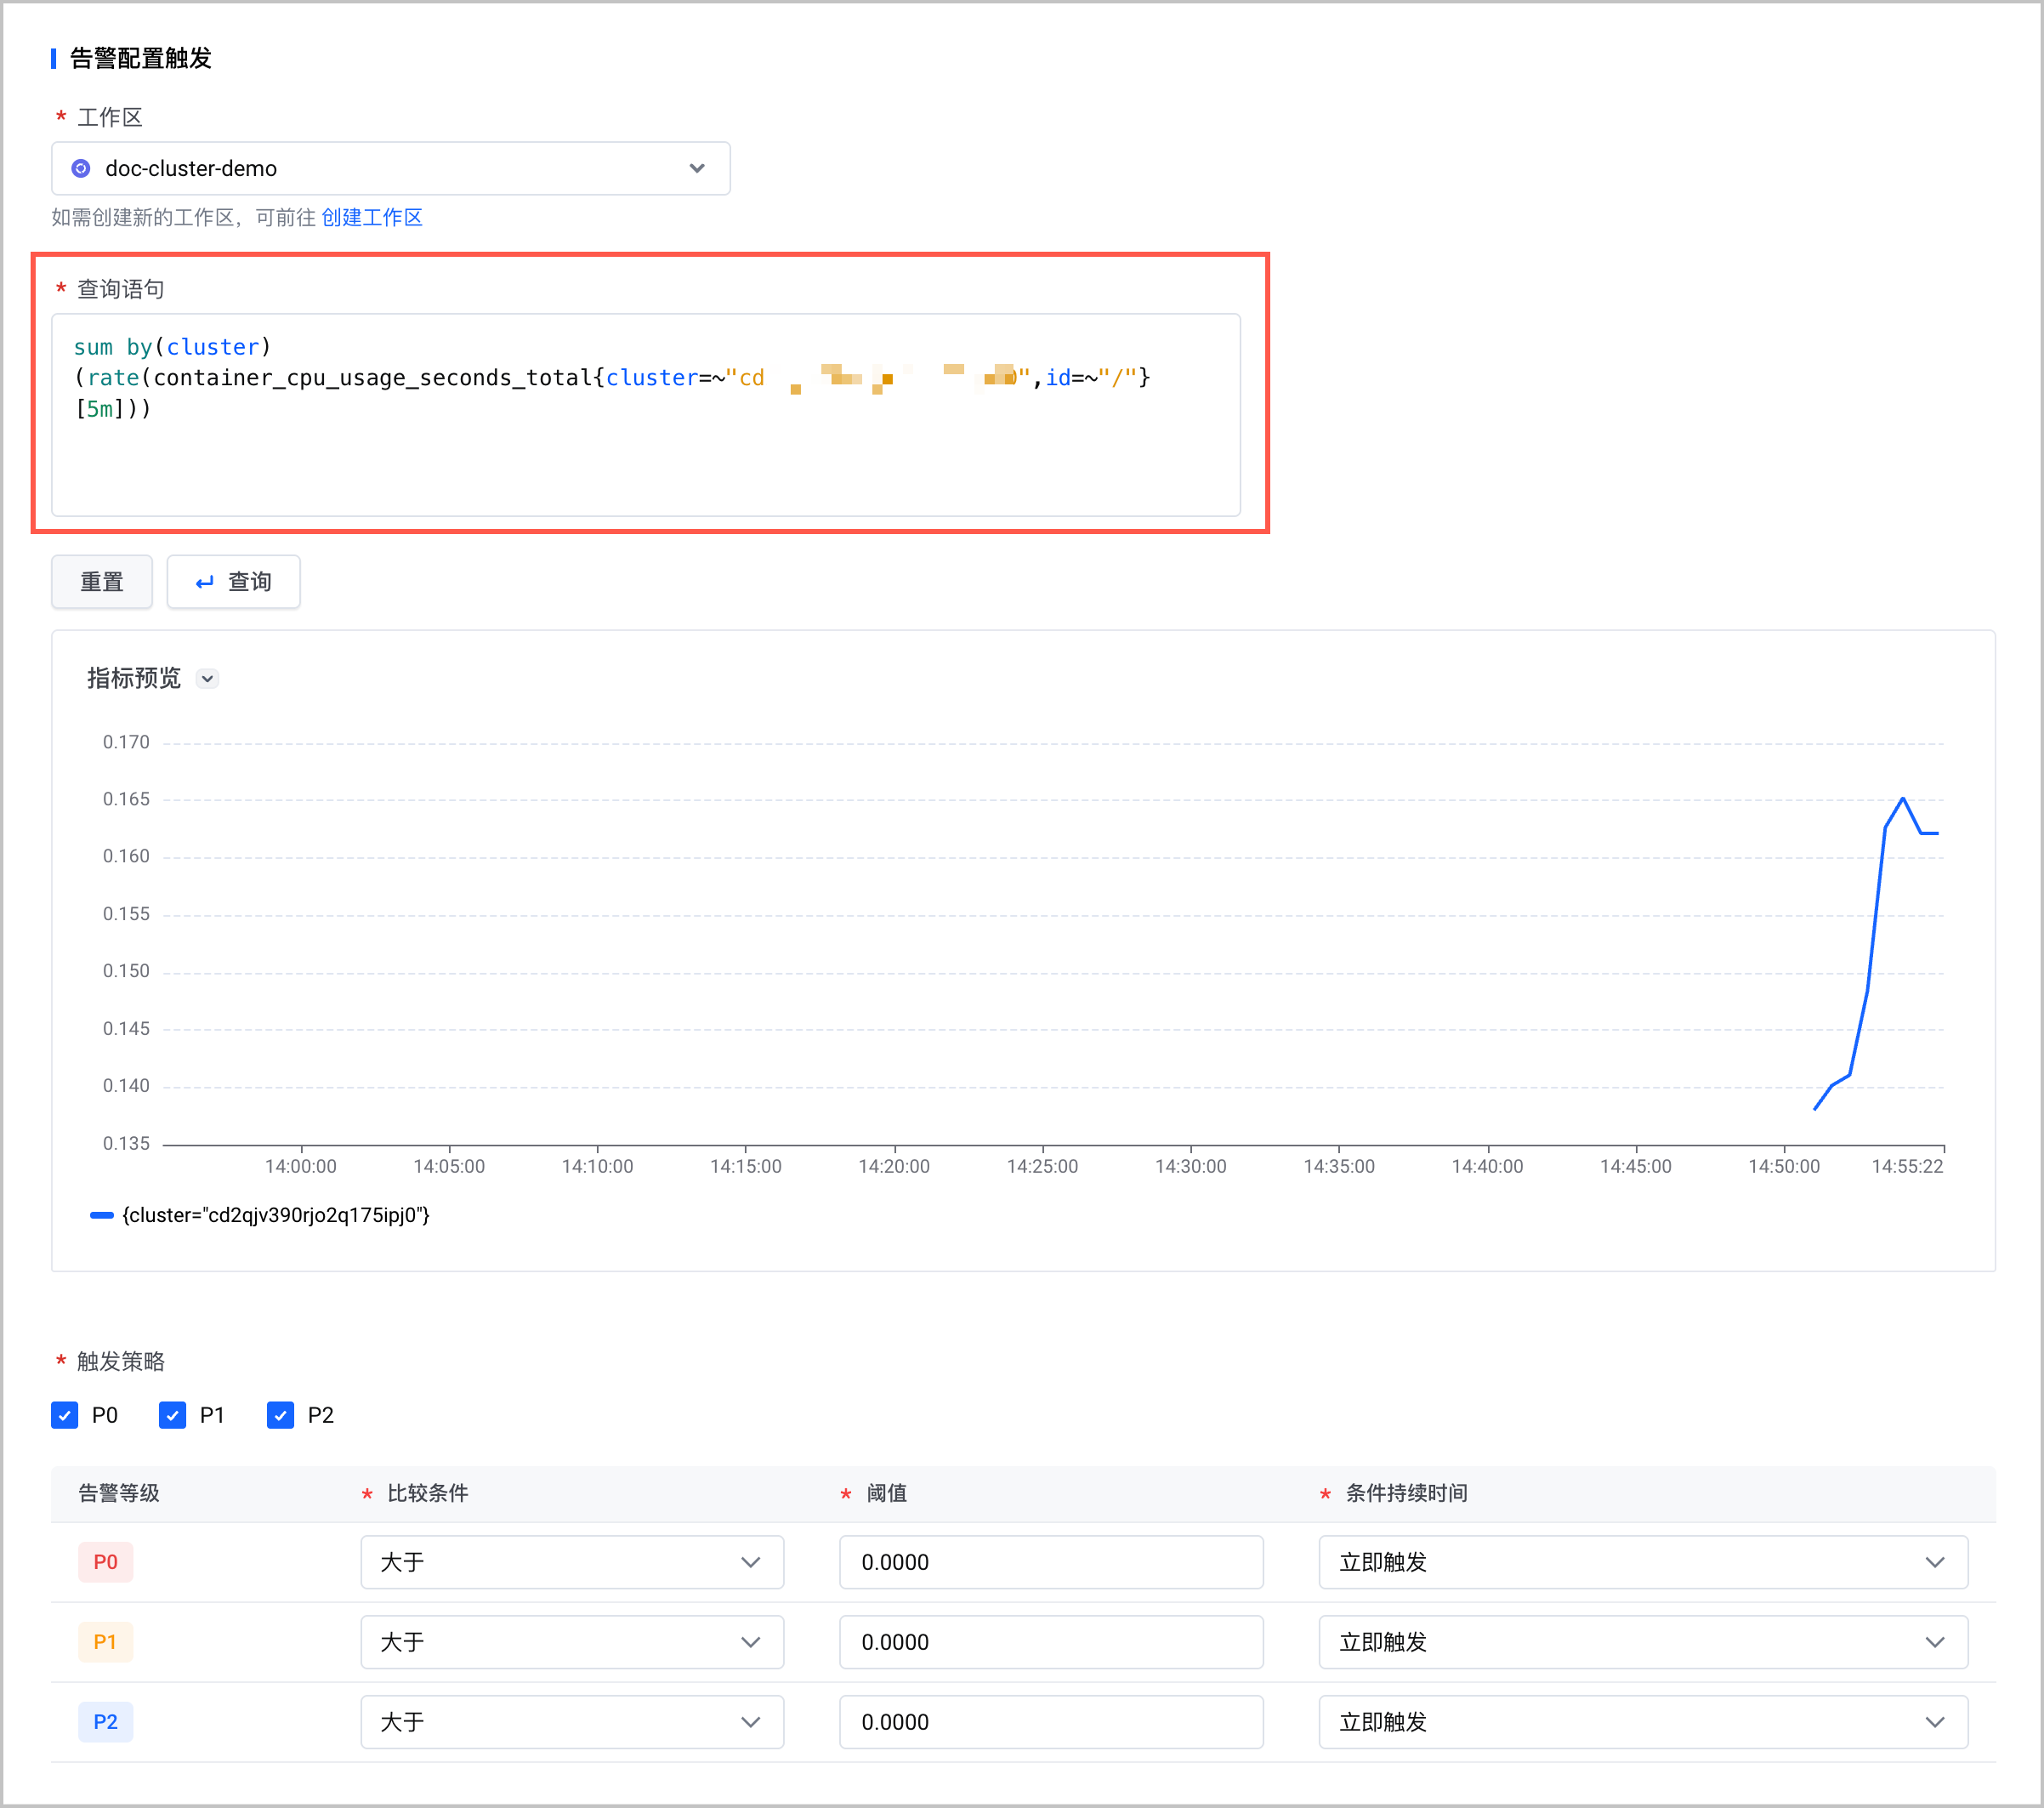
- 配置项说明配置项说明工作区在下拉菜单中选择配置云原生观测时,与集群绑定的工作区。查询语句使用标准 PromQL 语句,配置监控对象或指标。本文以 集群 CPU 用量 指标的 PromQL 语句sum by(cluster)(rate(container_cpu_usage_seconds_total{cluster=~"$Cluster",id=~"/"}[5m]))为例。更多指标详情,请参见下文 指标对照清单。触发策略配置告警触发策略。指定告警等级、条件、阈值和条件持续时间。
- 勾选 P0、P1 或 P2,表示设定不同的告警等级。取消勾选,则表示不设定该等级的告警。
- 比较条件:指定 PromQL 语句和阈值之间的比较条件。支持多个比较条件,包括: 大于、大于等于、小于、小于等于、等于 和 不等于。
- 阈值:配置指标的阈值。
- 条件持续时间:配置指标符合条件的持续时间,包括:
- 立即触发:满足告警条件后,立即触发告警。
- 1 分钟:满足告警条件,并持续 1 分钟后,再触发告警。
- 2 分钟:满足告警条件,并持续 2 分钟后,再触发告警。
- 5 分钟:满足告警条件,并持续 5 分钟后,再触发告警。
- 10 分钟:满足告警条件,并持续 10 分钟后,再触发告警。
- 配置告警通知。
-

-
- 单击 确定,完成配置。
后续配置
指标对照清单
说明
集群
参数
配置告警规则时,PromQL 语句中包含以下参数,需要在配置告警规则时,修改为您集群的实际值。
参数 | 说明 |
参数 | 说明 |
$Cluster |
指标
云监控指标 | 指标说明 | PromQL 语句 | 单位 |
云监控指标 | 指标说明 | PromQL 语句 | 单位 |
Cluster_MemoryUsed | 集群内存用量 | sum by (cluster) (container_memory_working_set_bytes{cluster=~"$Cluster", id=~"/"}) | Bytes(SI) |
Cluster_MemoryUsage | 集群内存使用率 | (sum by (cluster) (container_memory_working_set_bytes{cluster=~"$Cluster",id=~"/"}) / sum by (cluster) (machine_memory_bytes{cluster=~"$Cluster"}))*100 | Percent |
Cluster_CPUUsed | 集群 CPU 用量 | sum by(cluster)(rate(container_cpu_usage_seconds_total{cluster=~"$Cluster",id=~"/"}[5m])) | Core |
Cluster_CPUUsage | 集群 CPU 使用率 | (sum(rate(container_cpu_usage_seconds_total{cluster=~"$Cluster",id=~"/"}[5m])) by (cluster) / sum(machine_cpu_cores{cluster=~"$Cluster"}) by (cluster)) * 100 | Percent |
Cluster_NodeCount | 集群节点数量 | count(kube_node_info{cluster=~"$Cluster"}) | Count |
命名空间
参数
配置告警规则时,PromQL 语句中包含以下参数,需要在配置告警规则时,修改为您集群的实际值。
参数 | 说明 |
参数 | 说明 |
$Cluster | |
$Namespace | 命名空间名称,例如kube-system。 |
指标
云监控指标 | 指标说明 | PromQL 语句 | 单位 |
云监控指标 | 指标说明 | PromQL 语句 | 单位 |
Namespace_CPUUsed | 命名空间 CPU 用量 | sum by(cluster, namespace) (rate(container_cpu_usage_seconds_total{cluster=~"$Cluster", namespace!="", namespace=~"$Namespace",container="", name=""}[5m])) | Core |
Namespace_MemoryUsed | 命名空间内存用量 | sum by(cluster, namespace) (container_memory_working_set_bytes{cluster=~"$Cluster", namespace!="", namespace=~"$Namespace",container="", name=""}) | Bytes(SI) |
节点
参数
配置告警规则时,PromQL 语句中包含以下参数,需要在配置告警规则时,修改为您集群的实际值。
参数 | 说明 |
参数 | 说明 |
$Cluster | |
$Node | 节点 IP 地址,例如192.168.1.10。 |
指标
云监控指标 | 指标说明 | PromQL 语句 | 单位 |
云监控指标 | 指标说明 | PromQL 语句 | 单位 |
Node_PodCount | 容器组个数 | count by(cluster, node)(kube_pod_info{cluster=~"$Cluster", node=~"$Node"}) | Count |
Node_CPURequestUsage | 节点 CPU 分配率(request) | sum(kube_pod_container_resource_requests{cluster=~"$Cluster",resource="cpu", node=~"$Node"}) by (cluster,node,resource,unit) / ON(cluster,node,resource,unit) kube_node_status_allocatable{cluster=~"$Cluster"} * 100 | Percent |
Node_MemoryRequestUsage | 节点内存分配率(request) | sum(kube_pod_container_resource_requests{cluster=~"$Cluster",resource="memory", node=~"$Node"}) by (cluster,node,resource,unit) / ON(cluster,node,resource,unit) kube_node_status_allocatable{cluster=~"$Cluster"} * 100 | Percent |
Node_CPULimitUsage | 节点 CPU 分配率(limit) | sum(kube_pod_container_resource_limits{cluster=~"$Cluster",resource="cpu", node=~"$Node"}) by (cluster,node,resource,unit) / ON(cluster,node,resource,unit) kube_node_status_allocatable{cluster=~"$Cluster"} * 100 | Percent |
Node_MemoryLimitUsage | 节点内存分配率(limit) | sum(kube_pod_container_resource_limits{cluster=~"$Cluster",resource="memory", node=~"$Node"}) by (cluster,node,resource,unit) / ON(cluster,node,resource,unit) kube_node_status_allocatable{cluster=~"$Cluster"} * 100 | Percent |
Node_CPUUsage | 节点 CPU 使用率 | rate(container_cpu_usage_seconds_total{cluster=~"$Cluster",id=~"/", node=~"$Node"}[5m]) / ON(cluster, node) machine_cpu_cores{cluster=~"$Cluster"} * 100 | Percent |
Node_MemoryUsage | 节点内存使用率 | container_memory_working_set_bytes{cluster=~"$Cluster",id=~"/", node=~"$Node"} / ON(cluster, node) machine_memory_bytes{cluster=~"$Cluster"} * 100 | Percent |
存储卷声明
参数
配置告警规则时,PromQL 语句中包含以下参数,需要在配置告警规则时,修改为您集群的实际值。
参数 | 说明 |
参数 | 说明 |
$Cluster | |
$Namespace | 命名空间名称,例如kube-system。 |
$PersistentVolumeClaim | 存储卷声明名称,例如ebs-demo。 |
指标
云监控指标 | 指标说明 | PromQL 语句 | 单位 |
云监控指标 | 指标说明 | PromQL 语句 | 单位 |
PersistentVolumeClaim_VolumeUsage | 存储卷声明容量使用率 | kubelet_volume_stats_used_bytes{cluster=~"$Cluster", namespace=~"$Namespace", persistentvolumeclaim=~"$PersistentVolumeClaim"}/kubelet_volume_stats_capacity_bytes{cluster=~"$Cluster", namespace=~"$Namespace", persistentvolumeclaim=~"$PersistentVolumeClaim"} * 100 | Percent |
PersistentVolumeClaim_INodeUsage | 存储卷声明 inode 使用率 | kubelet_volume_stats_inodes_used{cluster=~"$Cluster", namespace=~"$Namespace", persistentvolumeclaim=~"$PersistentVolumeClaim"}/kubelet_volume_stats_inodes{cluster=~"$Cluster", namespace=~"$Namespace", persistentvolumeclaim=~"$PersistentVolumeClaim"} * 100 | Percent |
无状态负载
参数
配置告警规则时,PromQL 语句中包含以下参数,需要在配置告警规则时,修改为您集群的实际值。
参数 | 说明 |
参数 | 说明 |
$Cluster | |
$Namespace | 命名空间名称,例如kube-system。 |
$Deployment | 无状态负载名称,例如metrics-server。 |
指标
云监控指标 | 指标说明 | PromQL 语句 | 单位 |
云监控指标 | 指标说明 | PromQL 语句 | 单位 |
Deployment_MemoryUsed | 无状态负载内存用量 | sum(kube_replicaset_owner{cluster=~"$Cluster",owner_kind="Deployment",owner_is_controller="true", namespace=~"$Namespace",owner_name=~"$Deployment"} * ON(cluster, namespace, replicaset) group_right(owner_name) label_join(kube_pod_owner{cluster=~"$Cluster",namespace=~"$Namespace",owner_kind="ReplicaSet",owner_is_controller="true"},"replicaset", "" ,"owner_name") * ON(cluster, namespace, pod) group_right sum by(cluster, namespace, pod)(container_memory_working_set_bytes{cluster=~"$Cluster", name="", container="", pod!=""})) | Bytes(SI) |
Deployment_CPUUsage | 无状态负载 CPU 使用率(占limit) | avg(kube_replicaset_owner{cluster=~"$Cluster",owner_kind="Deployment",owner_is_controller="true", namespace=~"$Namespace",owner_name=~"$Deployment"} * ON(cluster, namespace, replicaset) group_right(owner_name) label_join(kube_pod_owner{cluster=~"$Cluster",namespace=~"$Namespace",owner_kind="ReplicaSet",owner_is_controller="true"},"replicaset", "" ,"owner_name") * ON(cluster, namespace, pod) group_right sum by(cluster, namespace, pod)(rate(container_cpu_usage_seconds_total{cluster=~"$Cluster", name="", container="", pod!=""}[5m])) / ON(cluster, namespace, pod) sum by(cluster, namespace, pod) (kube_pod_container_resource_limits{cluster=~"$Cluster", namespace=~"$Namespace", resource="cpu", unit="core"}) * 100) | Percent |
Deployment_MemoryUsage | 无状态负载内存使用率(占limit) | avg(kube_replicaset_owner{cluster=~"$Cluster",owner_kind="Deployment",owner_is_controller="true", namespace=~"$Namespace",owner_name=~"$Deployment"} * ON(cluster, namespace, replicaset) group_right(owner_name) label_join(kube_pod_owner{cluster=~"$Cluster",namespace=~"$Namespace",owner_kind="ReplicaSet",owner_is_controller="true"},"replicaset", "" ,"owner_name") * ON(cluster, namespace, pod) group_right sum by(cluster, namespace, pod)(container_memory_working_set_bytes{cluster=~"$Cluster", name="", container="", pod!=""}) / ON(cluster, namespace, pod) sum by(cluster, namespace, pod)(kube_pod_container_resource_limits{cluster=~"$Cluster", namespace=~"$Namespace", resource="memory", unit="byte"})) * 100 | Percent |
Deployment_CPUUsed | 无状态负载 CPU 用量 | sum(kube_replicaset_owner{cluster=~"$Cluster",owner_kind="Deployment",owner_is_controller="true", namespace=~"$Namespace",owner_name=~"$Deployment"} * ON(cluster, namespace, replicaset) group_right(owner_name) label_join(kube_pod_owner{cluster=~"$Cluster",namespace=~"$Namespace",owner_kind="ReplicaSet",owner_is_controller="true"},"replicaset", "" ,"owner_name") * ON(cluster, namespace, pod) group_right sum by(cluster, namespace, pod)(rate(container_cpu_usage_seconds_total{cluster=~"$Cluster", name="", container="", pod!=""}[5m]))) | Core |
Deployment_GPU_Usage | 无状态负载GPU使用率 | avg(kube_replicaset_owner{cluster=~"$Cluster",owner_kind="Deployment",owner_is_controller="true", namespace=~"$Namespace",owner_name=~"$Deployment"} * ON(cluster, namespace, replicaset) group_right(owner_name) label_join(kube_pod_owner{cluster=~"$Cluster",namespace=~"$Namespace",owner_kind="ReplicaSet",owner_is_controller="true"},"replicaset", "" ,"owner_name") * ON(cluster, namespace, pod) group_right sum by(cluster, namespace, pod)(DCGM_FI_DEV_GPU_UTIL{cluster=~"$Cluster", namespace=~"$Namespace"})) | Percent |
Deployment_GPU_Memory_Usage | 无状态负载GPU显存使用率 | avg(kube_replicaset_owner{cluster=~"$Cluster",owner_kind="Deployment",owner_is_controller="true", namespace=~"$Namespace",owner_name=~"$Deployment"} * ON(cluster, namespace, replicaset) group_right(owner_name) label_join(kube_pod_owner{cluster=~"$Cluster",namespace=~"$Namespace",owner_kind="ReplicaSet",owner_is_controller="true"},"replicaset", "" ,"owner_name") * ON(cluster, namespace, pod) group_right sum by(cluster, namespace, pod)(DCGM_FI_DEV_FB_USED{cluster=~"$Cluster", namespace=~"$Namespace"} / (DCGM_FI_DEV_FB_FREE + DCGM_FI_DEV_FB_USED)))*100 | Percent |
有状态负载
参数
配置告警规则时,PromQL 语句中包含以下参数,需要在配置告警规则时,修改为您集群的实际值。
参数 | 说明 |
参数 | 说明 |
$Cluster | |
$Namespace | 命名空间名称,例如kube-system。 |
$StatefulSet | 有状态负载名称,例如vmagent-prometheus-agent。 |
指标
云监控指标 | 指标 | PromQL | 单位 |
云监控指标 | 指标 | PromQL | 单位 |
StatefulSet_CPUUsed | 有状态负载 CPU 用量 | sum(kube_pod_owner{cluster=~"$Cluster",namespace=~"$Namespace",owner_kind="StatefulSet",owner_is_controller="true", owner_name=~"$StatefulSet"} * ON(cluster, namespace, pod) group_right sum by(cluster, namespace, pod)(rate(container_cpu_usage_seconds_total{cluster=~"$Cluster", name="", container="", pod!=""}[5m]))) | Core |
StatefulSet_MemoryUsed | 有状态负载内存用量 | sum(kube_pod_owner{cluster=~"$Cluster",namespace=~"$Namespace",owner_kind="StatefulSet", owner_name=~"$StatefulSet"} * ON(cluster, namespace, pod) group_right sum by(cluster, namespace, pod)(container_memory_working_set_bytes{cluster=~"$Cluster", name="", container="", pod!=""})) | Bytes(SI) |
StatefulSet_CPUUsage | 有状态负载 CPU 使用率(占limit) | avg(kube_pod_owner{cluster=~"$Cluster",namespace=~"$Namespace",owner_kind="StatefulSet",owner_is_controller="true", owner_name=~"$StatefulSet"} * ON(cluster, namespace, pod) group_right sum by(cluster, namespace, pod)(rate(container_cpu_usage_seconds_total{cluster=~"$Cluster", name="", container="", pod!=""}[5m])) / ON(cluster, namespace, pod) sum by(cluster, namespace, pod) (kube_pod_container_resource_limits{cluster=~"$Cluster", namespace=~"$Namespace", resource="cpu", unit="core"}) * 100) | Percent |
StatefulSet_MemoryUsage | 有状态负载内存使用率(占limit) | avg(kube_pod_owner{cluster=~"$Cluster",namespace=~"$Namespace",owner_kind="StatefulSet", owner_name=~"$StatefulSet"} * ON(cluster, namespace, pod) group_right sum by(cluster, namespace, pod)(container_memory_working_set_bytes{cluster=~"$Cluster", name="", container="", pod!=""}) / ON(cluster, namespace, pod) sum by(cluster, namespace, pod)(kube_pod_container_resource_limits{cluster=~"$Cluster", namespace=~"$Namespace", resource="memory", unit="byte"})) * 100 | Percent |
StatefulSet_GPU_Usage | 有状态负载GPU使用率 | avg(kube_pod_owner{cluster=~"$Cluster",namespace=~"$Namespace",owner_kind="StatefulSet", owner_name=~"$StatefulSet"} * ON(cluster, namespace, pod) group_right sum by(cluster, namespace, pod)(container_memory_working_set_bytes{cluster=~"$Cluster", name="", container="", pod!=""}) / ON(cluster, namespace, pod) sum by(cluster, namespace, pod)(DCGM_FI_DEV_GPU_UTIL{cluster=~"$Cluster", namespace=~"$Namespace"})) | Percent |
StatefulSet_GPU_Memory_Usage | 有状态负载GPU显存使用率 | avg(kube_pod_owner{cluster=~"$Cluster",namespace=~"$Namespace",owner_kind="StatefulSet", owner_name=~"$StatefulSet"} * ON(cluster, namespace, pod) group_right sum by(cluster, namespace, pod)(container_memory_working_set_bytes{cluster=~"$Cluster", name="", container="", pod!=""}) / ON(cluster, namespace, pod) sum by(cluster, namespace, pod)(DCGM_FI_DEV_FB_USED{cluster=~"$Cluster", namespace=~"$Namespace"} / (DCGM_FI_DEV_FB_FREE + DCGM_FI_DEV_FB_USED))) * 100 | Percent |
容器组
参数
配置告警规则时,PromQL 语句中包含以下参数,需要在配置告警规则时,修改为您集群的实际值。
参数 | 说明 |
参数 | 说明 |
$Cluster | |
$Namespace | 命名空间名称,例如kube-system。 |
$Pod | 容器组名称,例如csi-ebs-node-hs***。 |
指标
云监控指标 | 指标说明 | PromQL 语句 | 单位 |
云监控指标 | 指标说明 | PromQL 语句 | 单位 |
Pod_CPUUsed | 容器组 CPU 用量 | rate(container_cpu_usage_seconds_total{cluster=~"$Cluster", namespace=~"$Namespace",name="", container="", pod=~"$Pod"}[5m]) | Core |
Pod_MemoryUsed | 容器组内存用量 | container_memory_working_set_bytes{cluster=~"$Cluster", namespace=~"$Namespace", pod=~"$Pod", name="", container=""} | Bytes(SI) |
Pod_CPUUsage | 容器组 CPU 使用率(占limit) | rate(container_cpu_usage_seconds_total{cluster=~"$Cluster", namespace=~"$Namespace",name="", container="", pod=~"$Pod"}[5m]) / ON(cluster,namespace,pod) group_left sum by(cluster,namespace,pod)(kube_pod_container_resource_limits{cluster=~"$Cluster", namespace=~"$Namespace", pod=~"$Pod", resource="cpu", unit="core"}) * 100 | Percent |
Pod_MemoryUsage | 容器组内存使用率(占limit) | container_memory_working_set_bytes{cluster=~"$Cluster", namespace=~"$Namespace", pod=~"$Pod", name="", container=""} / ON(cluster,namespace,pod) group_left sum by(cluster,namespace,pod)(kube_pod_container_resource_limits{cluster=~"$Cluster", namespace=~"$Namespace", pod=~"$Pod", resource="memory", unit="byte"}) * 100 | Percent |
Pod_NetworkReceiveBytesRate | 容器组网络流入流量速率 | rate(container_network_receive_bytes_total{cluster=~"$Cluster", namespace=~"$Namespace", pod=~"$Pod"}[5m]) | Bytes/Second(SI) |
Pod_NetworkTransmitBytesRate | 容器组网络流出流量速率 | rate(container_network_transmit_bytes_total{cluster=~"$Cluster", namespace=~"$Namespace", pod=~"$Pod"}[5m]) | Bytes/Second(SI) |
Pod_NetworkReceiveLossPacketRate | 容器组网络流入丢包率 | rate(container_network_receive_packets_dropped_total{cluster=~"$Cluster", namespace=~"$Namespace", pod=~"$Pod"}[5m])/rate(container_network_receive_packets_total{}[5m]) * 100 | Percent |
Pod_NetworkTransmitLossPacketRate | 容器组网络流出丢包率 | rate(container_network_transmit_packets_dropped_total{cluster=~"$Cluster", namespace=~"$Namespace", pod=~"$Pod"}[5m])/rate(container_network_transmit_packets_total{}[5m]) * 100 | Percent |
Pod_Status | 容器组运行状态 | sum by(cluster,namespace,pod)(kube_pod_status_phase{phase=~"Running|Succeeded", cluster=~"$Cluster", namespace=~"$Namespace", pod=~"$Pod"}) | None |
Pod_Readiness | 容器组就绪状态 | kube_pod_status_ready{condition="true",cluster=~"$Cluster", namespace=~"$Namespace", pod=~"$Pod"} | None |
容器
参数
配置告警规则时,PromQL 语句中包含以下参数,需要在配置告警规则时,修改为您集群的实际值。
参数 | 说明 |
参数 | 说明 |
$Cluster | |
$Namespace | 命名空间名称,例如kube-system。 |
$Pod | 容器组名称,例如csi-ebs-node-hs***。 |
Container | 容器名称,例如csi-ebs-driver。 |
指标
云监控指标 | 指标说明 | PromQL 语句 | 单位 |
云监控指标 | 指标说明 | PromQL 语句 | 单位 |
Container_MemoryUsed | 容器内存用量 | container_memory_working_set_bytes{cluster=~"$Cluster", namespace=~"$Namespace", pod=~"$Pod", container=~"$Container"} | Bytes(SI) |
Container_CPUUsage | 容器 CPU 使用率(占limit) | rate(container_cpu_usage_seconds_total{cluster=~"$Cluster", namespace=~"$Namespace", pod=~"$Pod", container=~"$Container"}[5m]) / ON(cluster, namespace, pod, container)kube_pod_container_resource_limits{resource="cpu", unit="core"} * 100 | Percent |
Container_MemoryUsage | 容器内存使用率(占limit) | container_memory_working_set_bytes{cluster=~"$Cluster", namespace=~"$Namespace", pod=~"$Pod", container=~"$Container"}/ ON(cluster, namespace, pod, container)kube_pod_container_resource_limits{resource="memory", unit="byte"} * 100 | Percent |
Container_CPUUsed | 容器 CPU 用量 | rate(container_cpu_usage_seconds_total{cluster=~"$Cluster", namespace=~"$Namespace", pod=~"$Pod", container=~"$Container"}[5m]) | Core |
Container_GPU_Memory_Usage | 容器GPU显存使用率 | DCGM_FI_DEV_FB_USED{cluster=~"$Cluster", namespace=~"$Namespace", pod=~"$Pod", container=~"$Container"} / (DCGM_FI_DEV_FB_FREE + DCGM_FI_DEV_FB_USED) * 100 | Percent |
常见问题
- 如何选择免费指标和收费指标?
- 托管 Prometheus 支持按量计费后付费方式,并提供不同存储时长(15 天、30 天等)的工作区。其中,存储时长为 15 天的工作区,基础指标为免费指标。因此,如果您有免费指标需求,可以采取以下方式:
- 建议创建并在集群中绑定 15 天存储时长的工作区。详情请参见 开启观测。
- 您可以在开启集群和组件的观测功能后,配置对应的采集规则,关闭不需要采集的指标。详情请参见 容器服务观测。
- 托管 Prometheus 收费说明,请参见 产品计费。
- 容器观测支持的指标详情,请参见 容器服务指标。
最近更新时间:2025.12.15 19:15:39
这个页面对您有帮助吗?
有用
有用
无用
无用