容器服务
容器服务
容器服务


文档指南
请输入


容器服务 VKE
产品动态
Kubernetes 版本发布记录
组件发布记录
监控组件
DNS 组件
GPU 组件
Sandbox 组件
安全公告
产品公告
历史公告
用户指南
集群
节点池
授权
网络
容器网络
服务(Service)
路由(Ingress)
APIG Ingress
ALB Ingress
自定义转发规则配置示例
CLB Ingress
Nginx Ingress
Gateway API
工作负载
存储
数据管理中心(DMC)
对象存储(TOS)
FSX 访问方式
文件存储(NAS)
FSX 访问方式
弹性文件存储(EFS)
文件存储(vePFS)
FSX 访问方式
vePFS Client 访问方式
NFS 访问方式
大数据文件存储(CloudFS)
弹性伸缩
工作负载弹性伸缩
事件驱动伸缩(KEDA)
组件管理
网络组件
监控组件
DNS 组件
GPU 组件
Sandbox 组件
异构计算
调度管理
可观测性
基础观测
诊断与巡检
最佳实践
网络
可观测性
安全合规
API 参考
集群管理
节点池管理
组件管理
机型镜像管理
云原生观测
巡检诊断
弹性容器实例
附录
开发指南
常见问题
通用 FAQ
集群 FAQ
集群管理
集群升级
节点与节点池 FAQ
授权 FAQ
工作负载 FAQ
服务与路由 FAQ
存储 FAQ
弹性伸缩 FAQ
可观测性 FAQ
配额 FAQ
组件 FAQ
容器镜像 FAQ
AI 云原生
推理套件
Helm 模板 AI 应用
Deepseek 实践
Qwen 实践
最佳实践
MiniMax 模型部署
Qwen 模型部署
弹性容器实例 VCI
最新动态
用户指南
虚拟节点
VKE 集群使用虚拟节点
自建/跨云集群使用虚拟节点
创建 VCI 实例
VCI Agent Sandbox
安全合规
- 文档首页
 容器服务AI 云原生推理套件ComfyUI 应用使用 ComfyUI 应用实现数字人对口型播客
 复制全文
 下载 pdf
使用 ComfyUI 应用实现数字人对口型播客
 文档反馈
 问问助手
本文介绍基于 Wan2.1 + InfiniteTalk,在 ServingKit 中部署和使用 ComfyUI 实现“数字人对口型播客”的基本能力。
方案介绍
ServingKit 提供数字人对口型播客相关 ComfyUI Workflow,该 Workflow 引入了 ServingKit 中的加速节点,模型使用 FP8 精度,通过加速节点实现 8 卡并行 + FP8 激活值量化 + 异步 Offload,实现 1 分钟播客视频生成时间 437.72 秒(使用非加速 Workflow,同等配置下执行时间需 2451.9 秒),极大地缩短了生成时间(80%),提升了创作效率。
Workflow 中的各节点参数说明如下:
Resource Pool
参数 | 说明 |
参数 | 说明 |
works_per_node | works_per_node为资源池一个节点的 Worker 数量,nnodes为集群节点总数。 取值需满足works_per_node × nnodes = gpu_num。
|
nnodes | |
use_gpu | 是否使用 GPU 资源:
|
max_colocate_count | 最大支持的 Worker 数量。如果模型需要DiT、CLIP、VAE三个 Loader,则max_colocate_count取值为 3。 |
pool_num | 资源池名称。 |
OpenVefuser WanVideo Model Loader
参数 | 说明 |
参数 | 说明 |
ulysess_degree | Ulysses 并行数。 取值需要被模型head_num整除,例如 Wan2.1-14B 模型的head_num是 40,则ulysess_degree可以设置为 40、80 等。 |
ring_degree | Ring Attention 并行数。 |
cfg_degree | CFG(Classifier-Free Guidance)并行数,最高为 2,支持 Wan 模型与 HiDream 模型。 取值需满足ulysess_degree x ring_degree x cfg_degree = gpu_num。 |
base_precision | 模型推理时的基础计算精度:
|
quantization | 模型的量化配置。如果需要 FP8 激活量化值,请选择xxx_fast模式。 |
load_device | 模型存储位置:
|
attention_mode | Attention 算子类型。本场景建议使用sageattn,即 Sage Attention。 Sage Attention 通过 8 位量化技术大幅降低 VRAM 占用,同时保持性能,适合显存资源受限的设备。 |
rms_norm_function | RMS 归一化(RMSNorm)的实现方式:
|
OpenVefuser WanVideo Sampler
说明
与原生节点相比,仅改动了Offload 的逻辑,其余输入保持不变。
参数 | 说明 |
参数 | 说明 |
steps | 采样步数,即去噪的迭代次数。步数越多生成质量通常越高,但速度会越慢。 |
cfg | 提示词引导强度,数值越高,提示词对生成结果的影响越强,但过高可能导致画面失真。 |
shift | 扩展节点参数,控制采样过程中的偏移量。 |
seed | 种子值,去噪过程中生成的随机数。seed值和其它参数配置一致时,生成的图像可复现,不同的seed值则生成不同的随机效果。 |
生成后控制 | 产生seed之后,控制seed的后续行为,取值:
|
force_offload | 采样后是否强制将模型组件临时转移到 CPU 等设备:
|
scheduler | 噪声调度策略,控制采样过程中噪声的变化节奏。该参数影响生成质量与效率。 |
riflex_freq_index | RIFLEX 模块所作用的频率通道索引。值为 0 时禁用,默认值为 6,表示允许在不循环的情况下生成新帧。 |
denoise_strength | 对初始噪声的去噪程度。1.0 表示完全去噪,数值越低画面随机性越强 取值范围为 0~1.0 ,1.0 表示完全去噪,基于初始潜变量生成全新内容,小于 1 则表示是在原有内容上修改。 |
batched_cfg | 是否以批量方式计算 CFG(Classifier-Free Guidance,无分类器引导):
|
rope_function | 旋转位置编码(RoPE)实现逻辑:
|
start_step | 采样的起始步骤。0 表示全量采样,否则从设置的步骤开始采样。 |
end_step | 采样的结束步骤。-1 表示全量采样,否则仅采样到设置的步骤。 |
add_noise_to_samples | 样本加噪开关,是否在采样前向视频样本中添加初始噪声:
|
准备工作
使用 ComfyUI 应用前,您需要准备 ComfyUI 依赖的各云产品资源、环境等。
云产品 | 是否必备 | 准备工作 | 相关链接 |
云产品 | 是否必备 | 准备工作 | 相关链接 |
GPU 云服务器 | 是 | 提供 GPU 计算资源。本文中的视频生成场景,推荐使用如下 GPU 云服务器实例规格:
说明 【邀测】上述 GPU 云服务器实例规格目前处于邀测阶段,请联系您的火山引擎客户经理,获取规格邀测权限。 | |
TOS | 推荐 | 实现 ComfyUI 应用持久化存储。 说明 | |
IAM | 使用 TOS 时必备 | 获取 IAM 的 API 访问秘钥(AK&SK),实现通过 VKE 访问 TOS。 | |
VKE | 是 | 提供部署 ComfyUI 应用的异构计算托管集群资源。 | |
APIG | 可选 | 通过 APIG 实例实现七层路由。会话保持场景必备资源。 注意
| |
网际快车 | 推荐 | 插件安装需要拉取 Github,HuggingFace 等内容,依赖网际快车服务。 注意
| 无 |
步骤一:部署 ComfyUI 应用
参数 | 说明 |
参数 | 说明 |
选择框架及编排 | |
部署方式 | 选择 预置模板部署。 |
模型 | 选择 Wan2.1 和 Infinite Talk。 |
应用配置 | |
ComfyUI 配置 | 保存位置 建议选择 永久存储,其余参数自定义配置。 ServingKit 会在对应路径下创建 ComfyUI 常用的目录,包括custom_nodes、input、output、models、user目录。 |
实例配置 | |
实例规格 | GPU 卡数 设置为 8,其余参数自定义配置。 |
更多配置 |
注意
|
服务配置 | |
API 网关 | 开启 API 网关配置,并关联已提前准备的 API 网关实例。 注意 请确保所选的 API 网关实例与部署应用的集群同属一个私有网络。 |
步骤二:访问 ComfyUI 应用
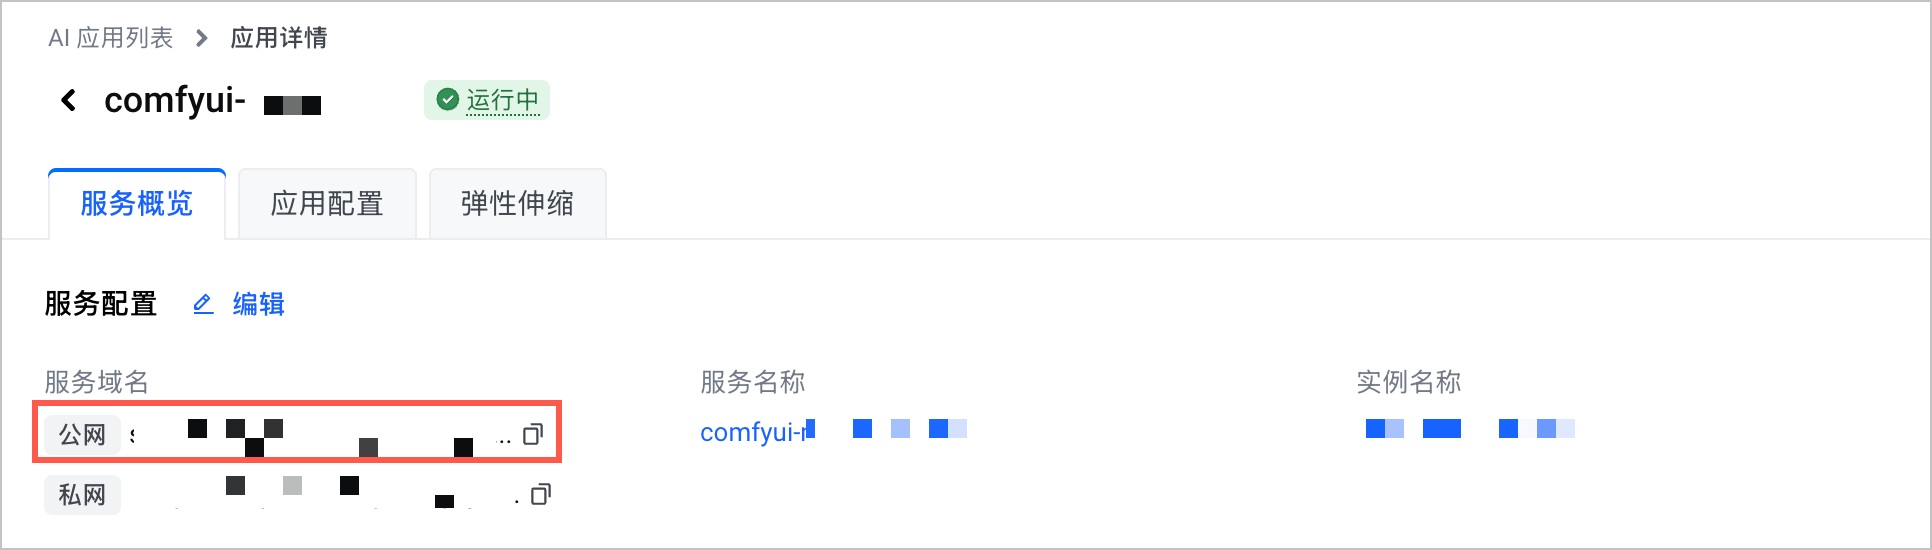
部署完应用后,进入 应用详情 页面的 基本信息 页签,找到 服务配置 区域的 服务域名,并在浏览器中输入服务域名,访问 ComfyUI 应用。
步骤三:使用 ComfyUI 应用实现“数字人对口型播客”能力
- 准备“数字人对口型播客”需要使用的音频和图像。
- 您可以使用 ServingKit 为您准备的测试用例音频和图像,也可以使用您自己准备的音频和图像。
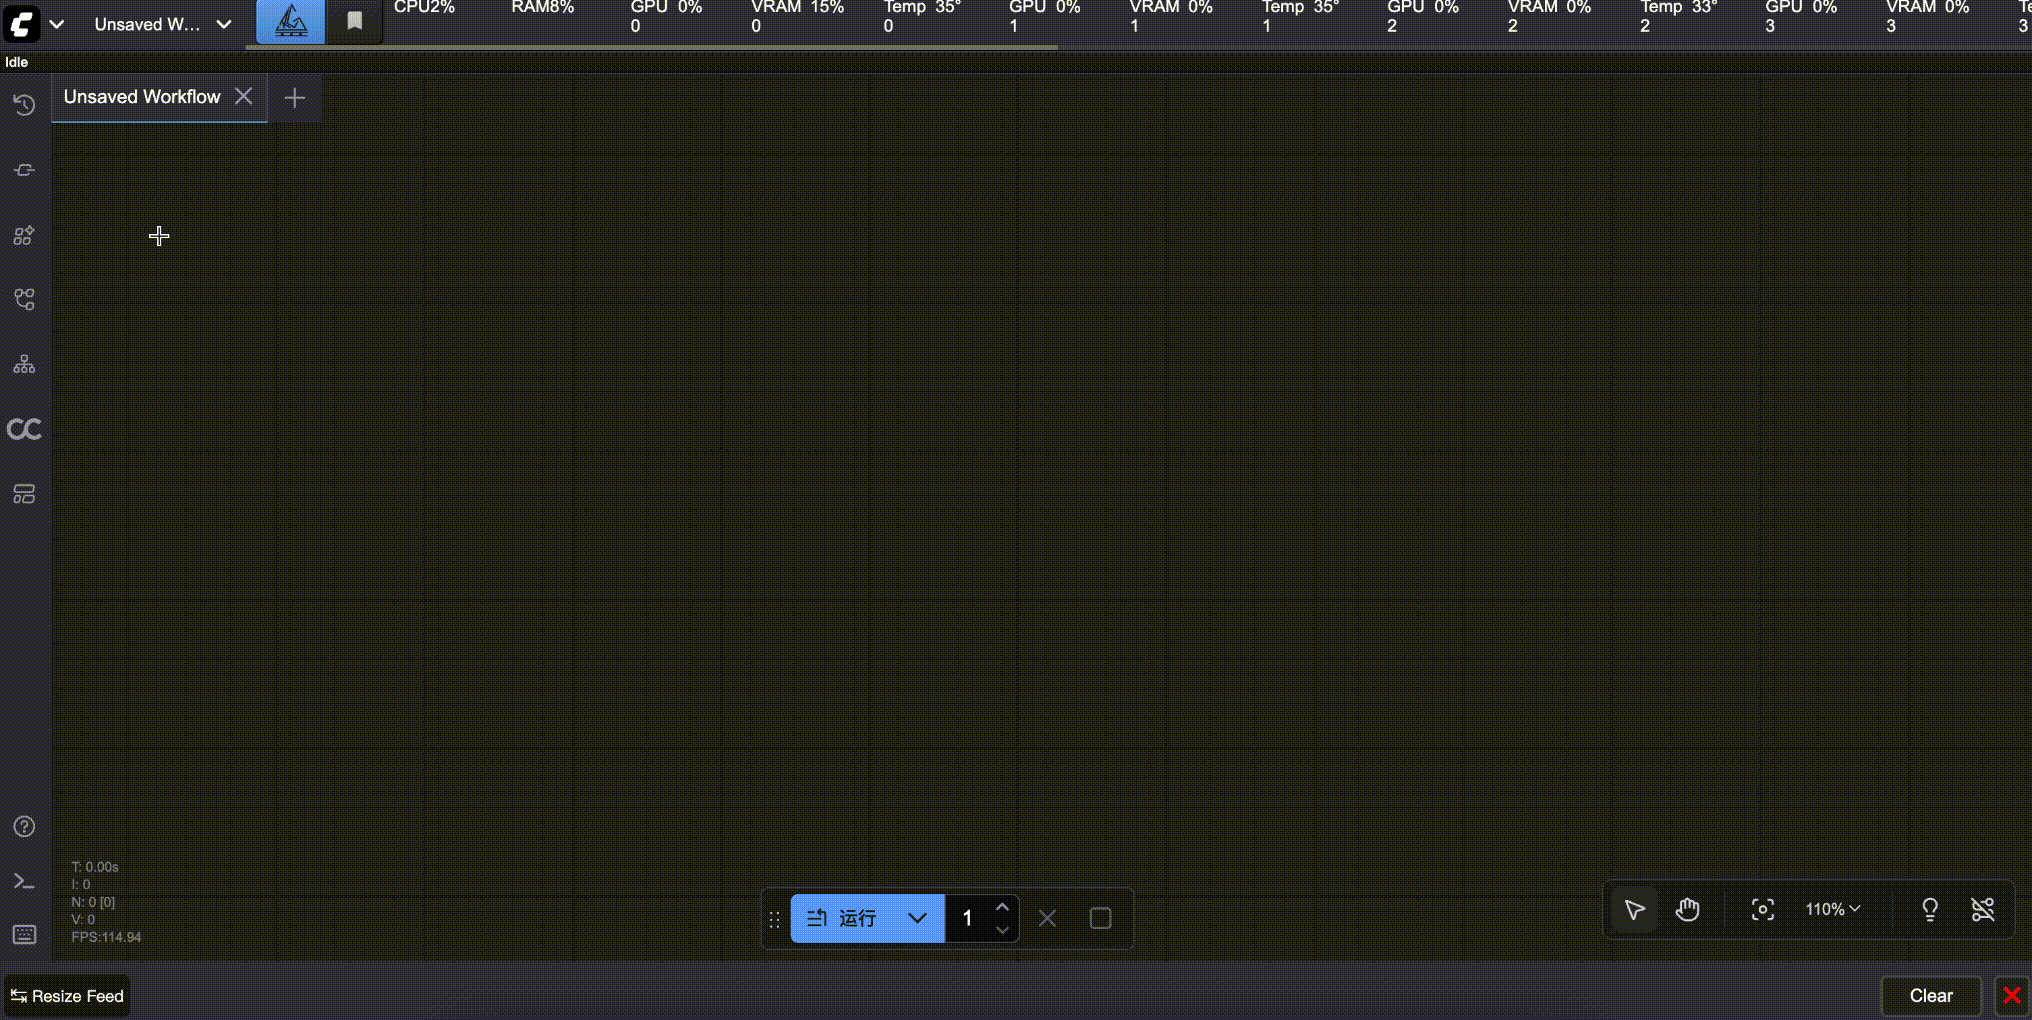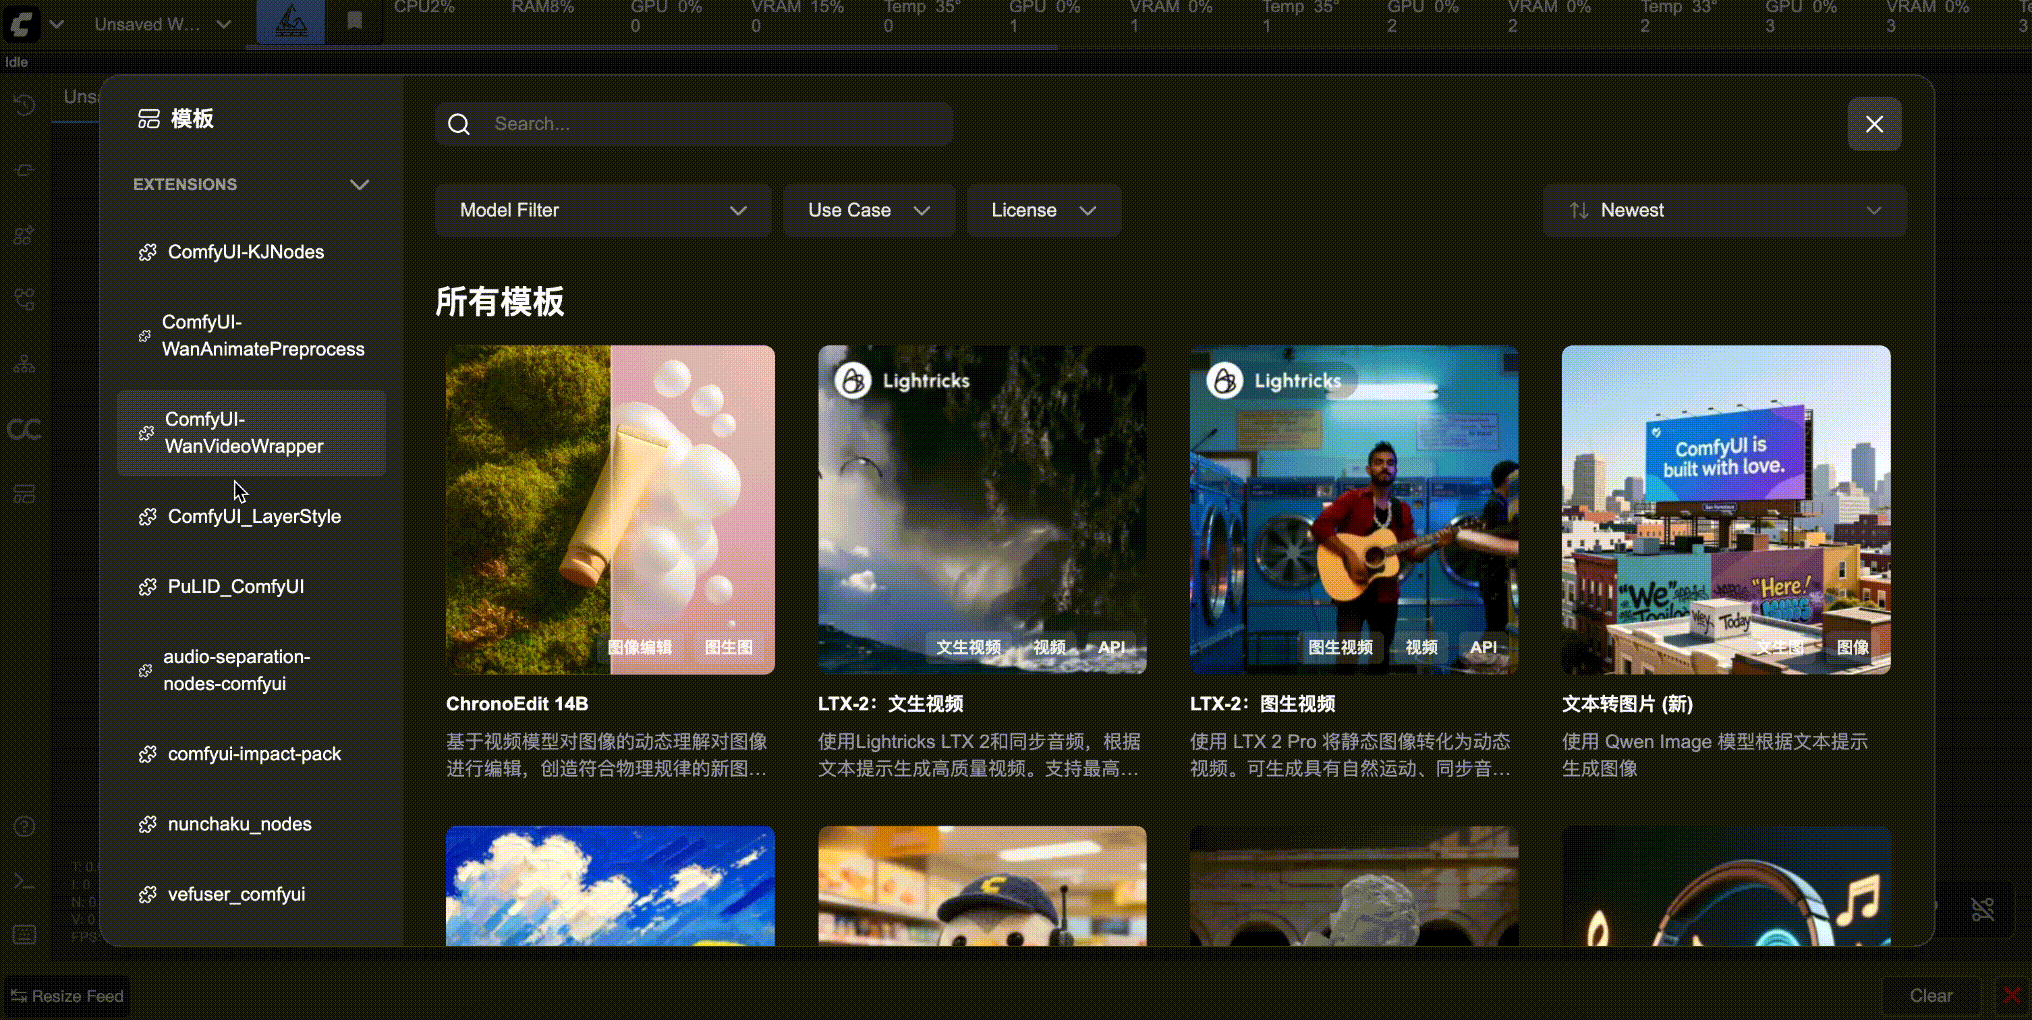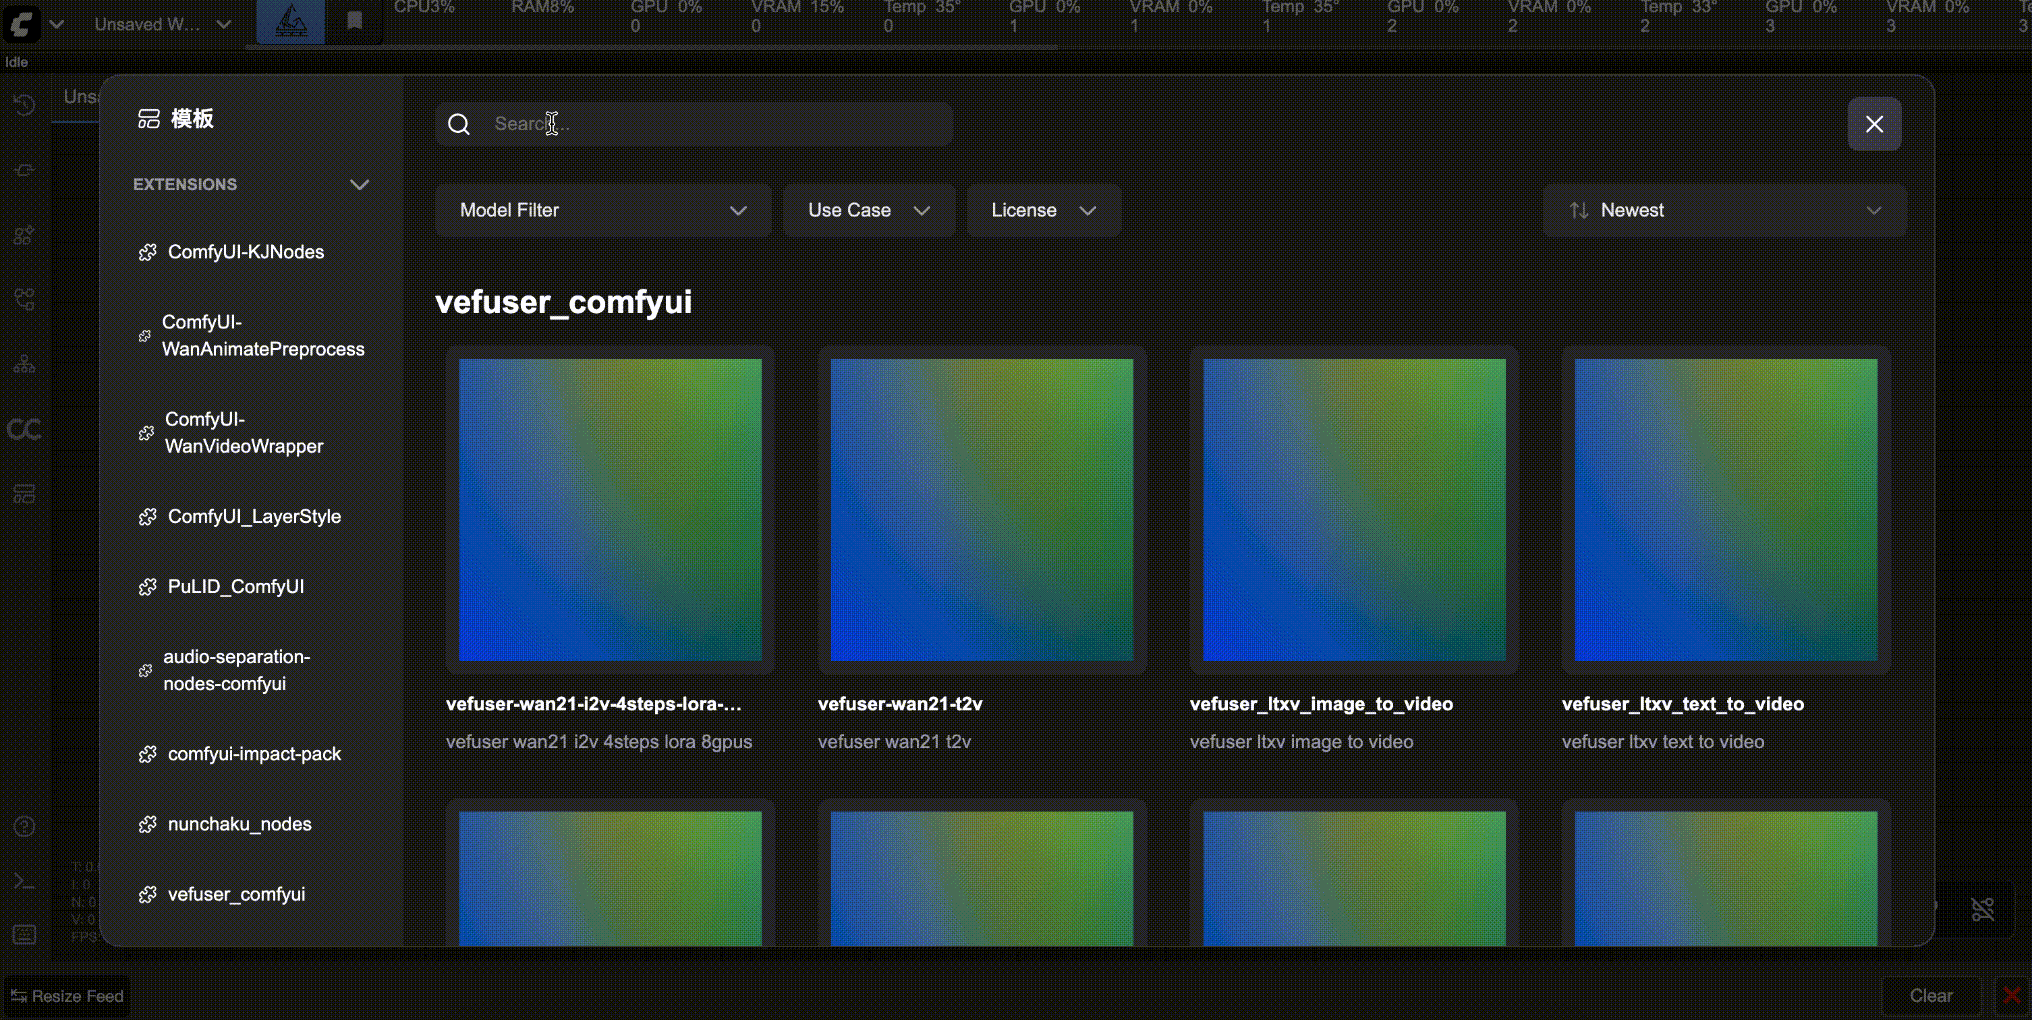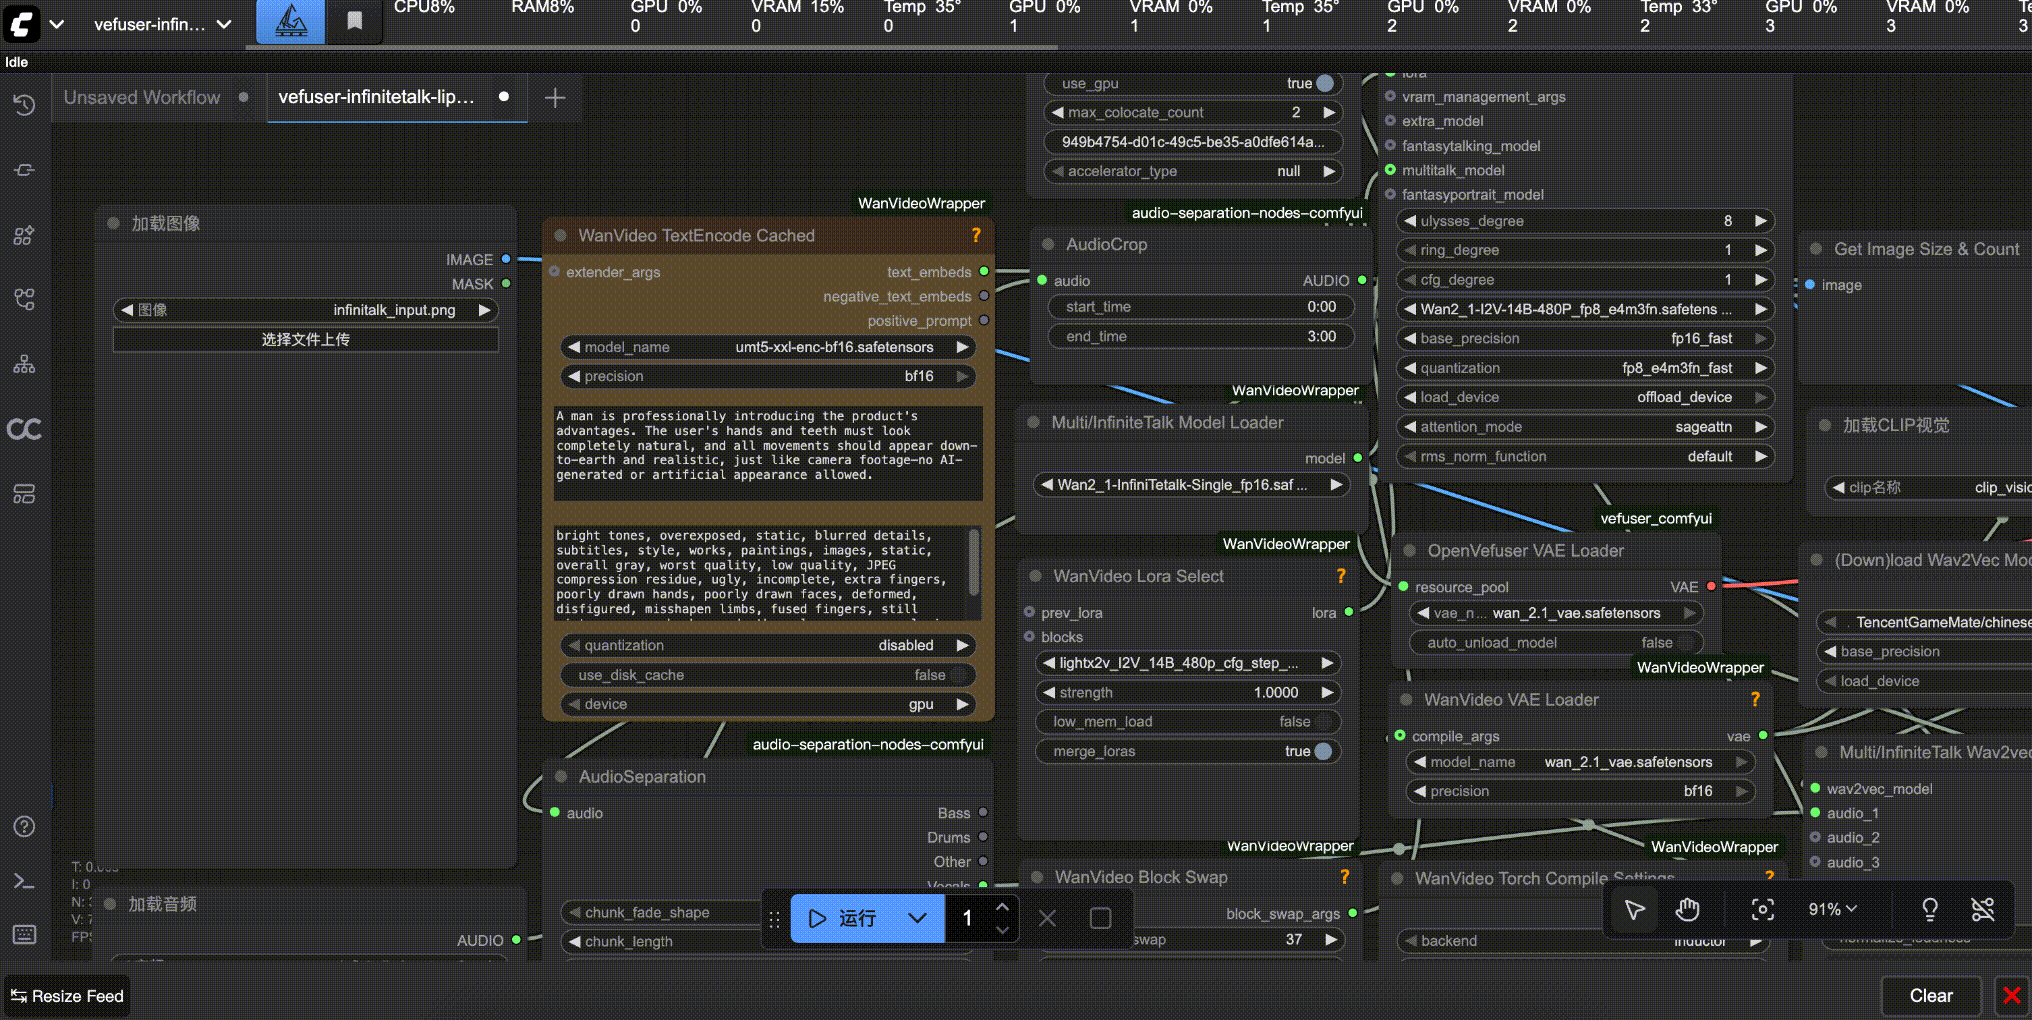
- 在 ComfyUI 应用页面,选择左上角下拉符号,单击 浏览模板,在 EXTENSIONS 下找到 vefuser_comfyui 系列模板,选择 vefuser-infinitetalk-lipsync-8gpus 模板。
-
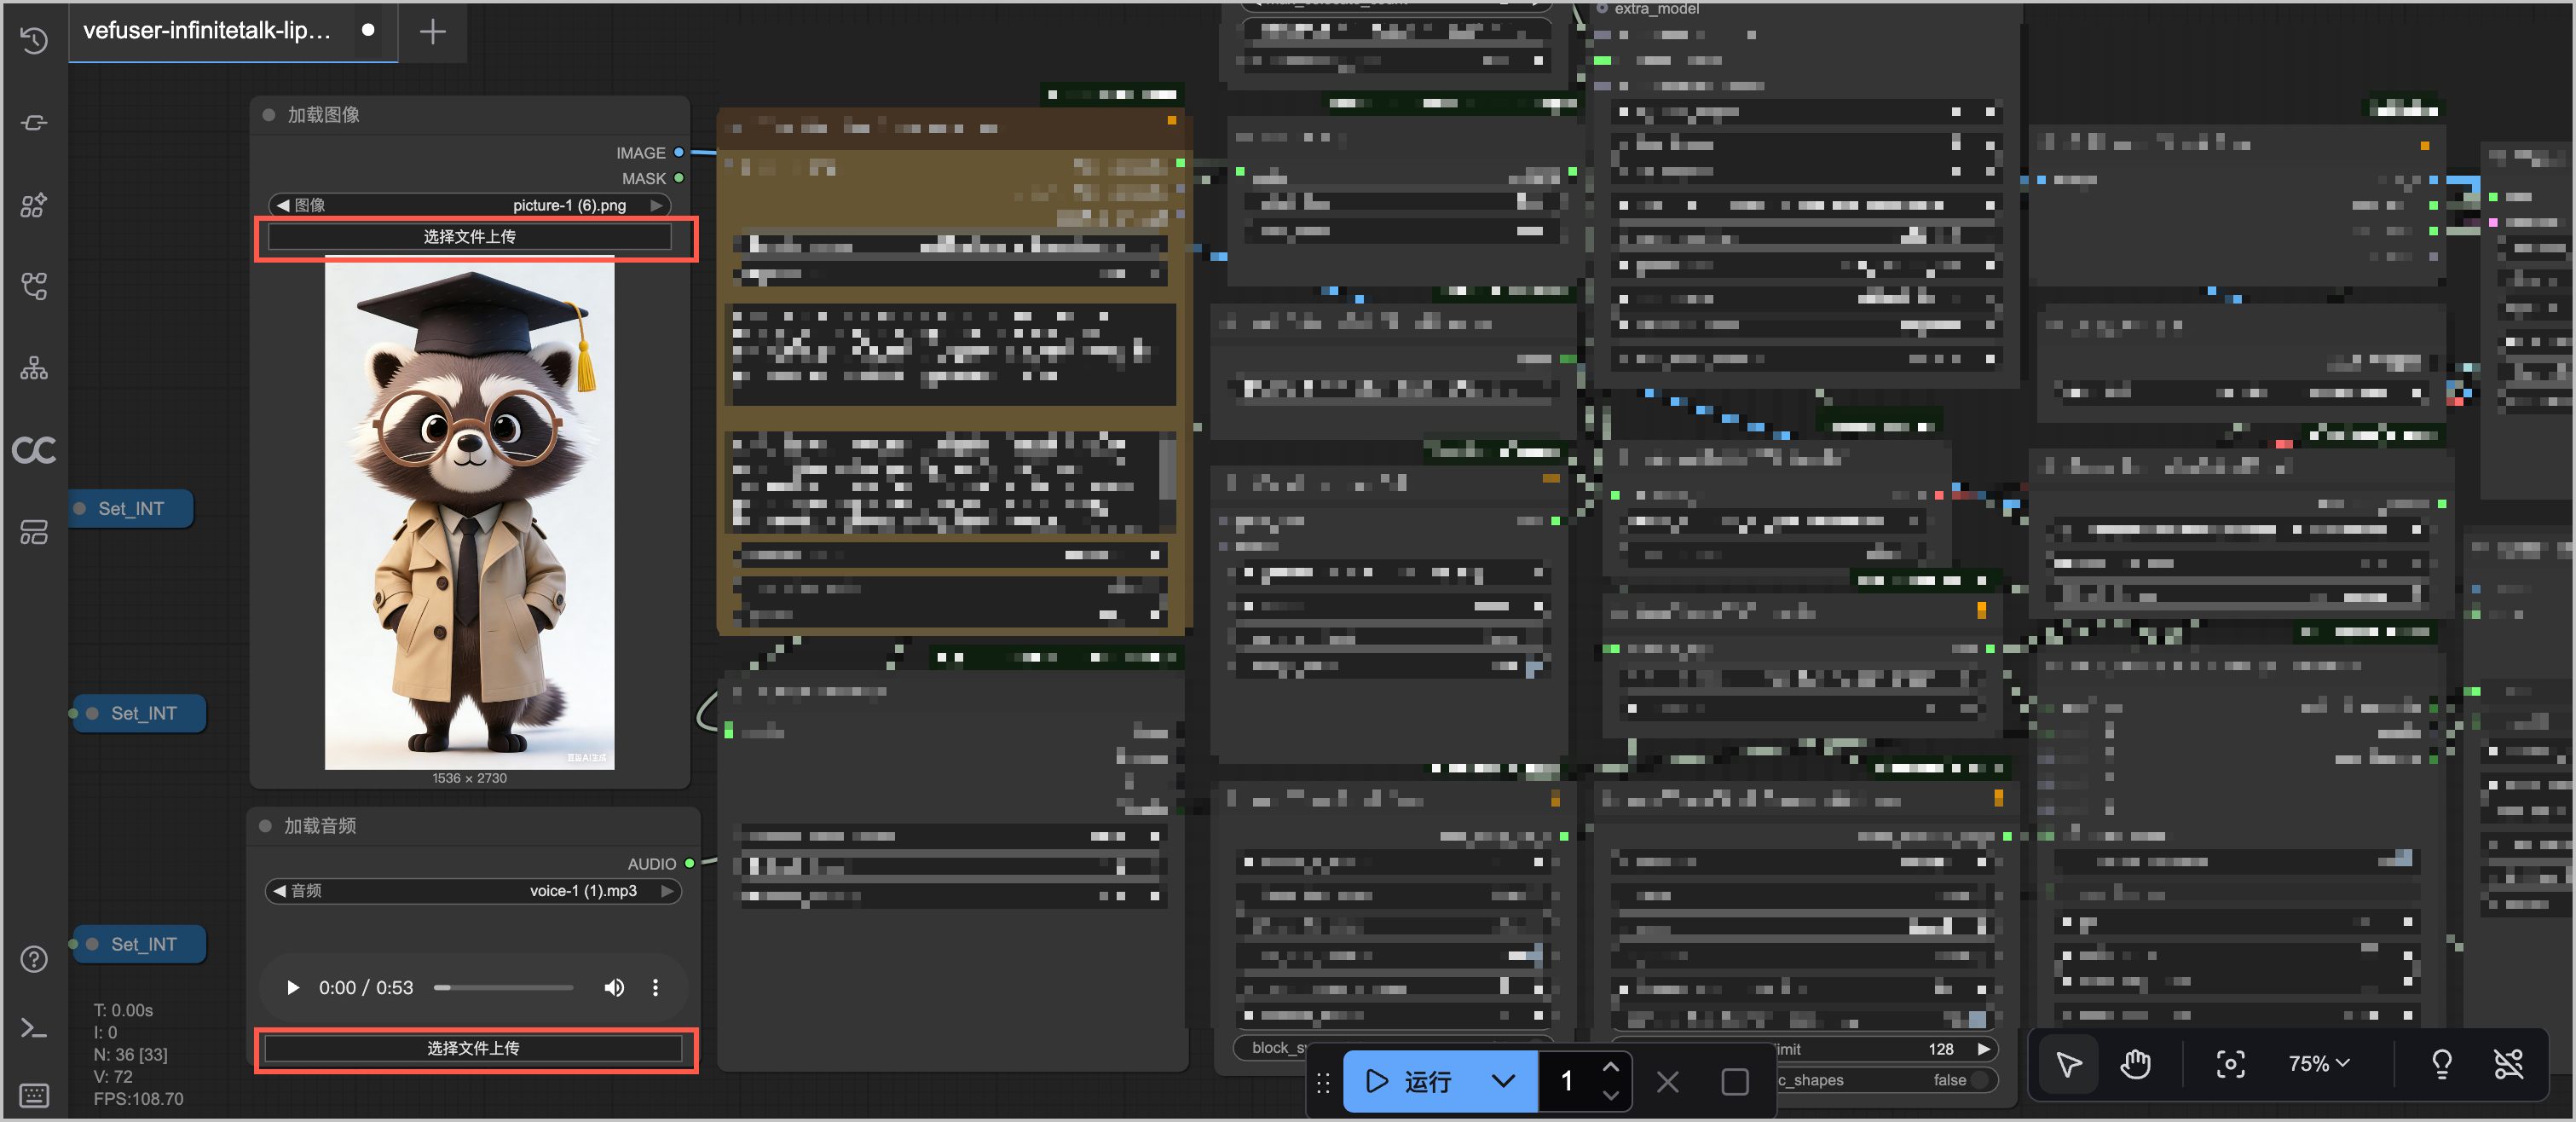
- 导入音频和图像到工作流中。
-
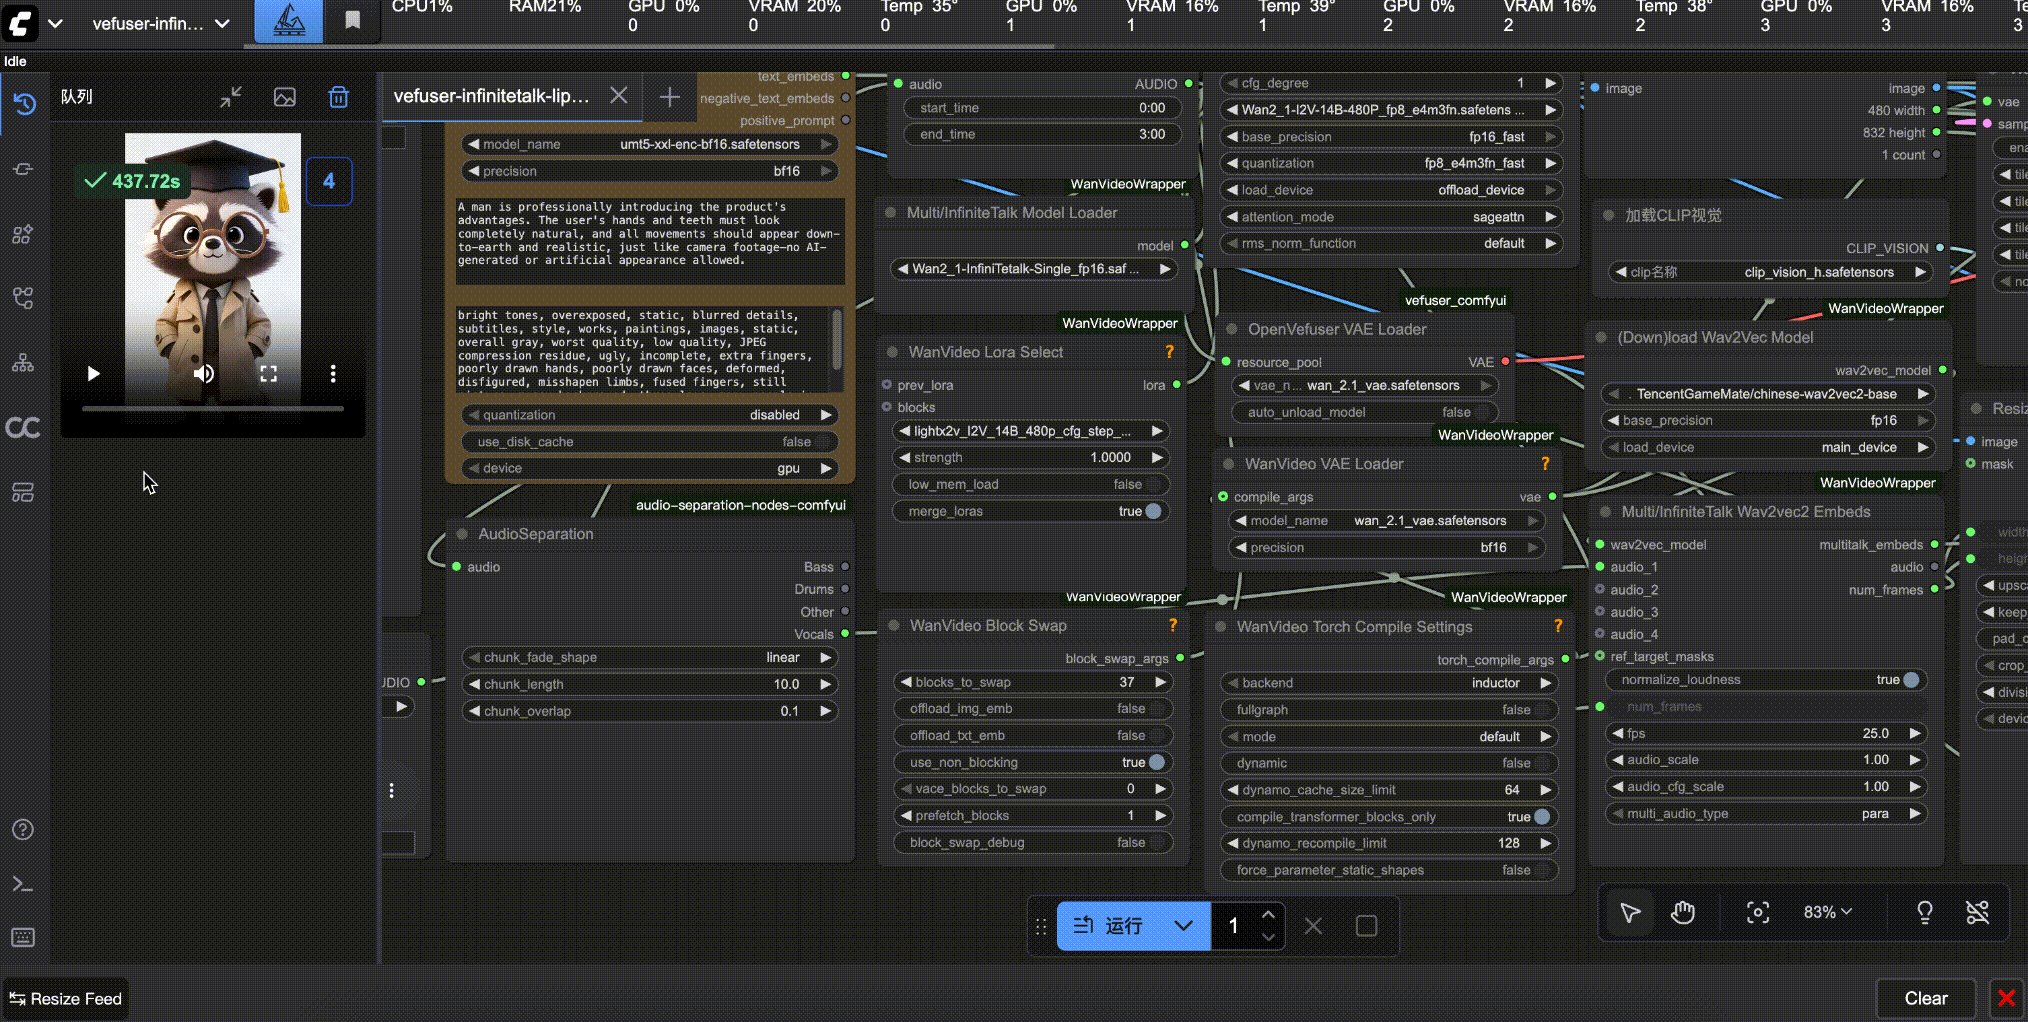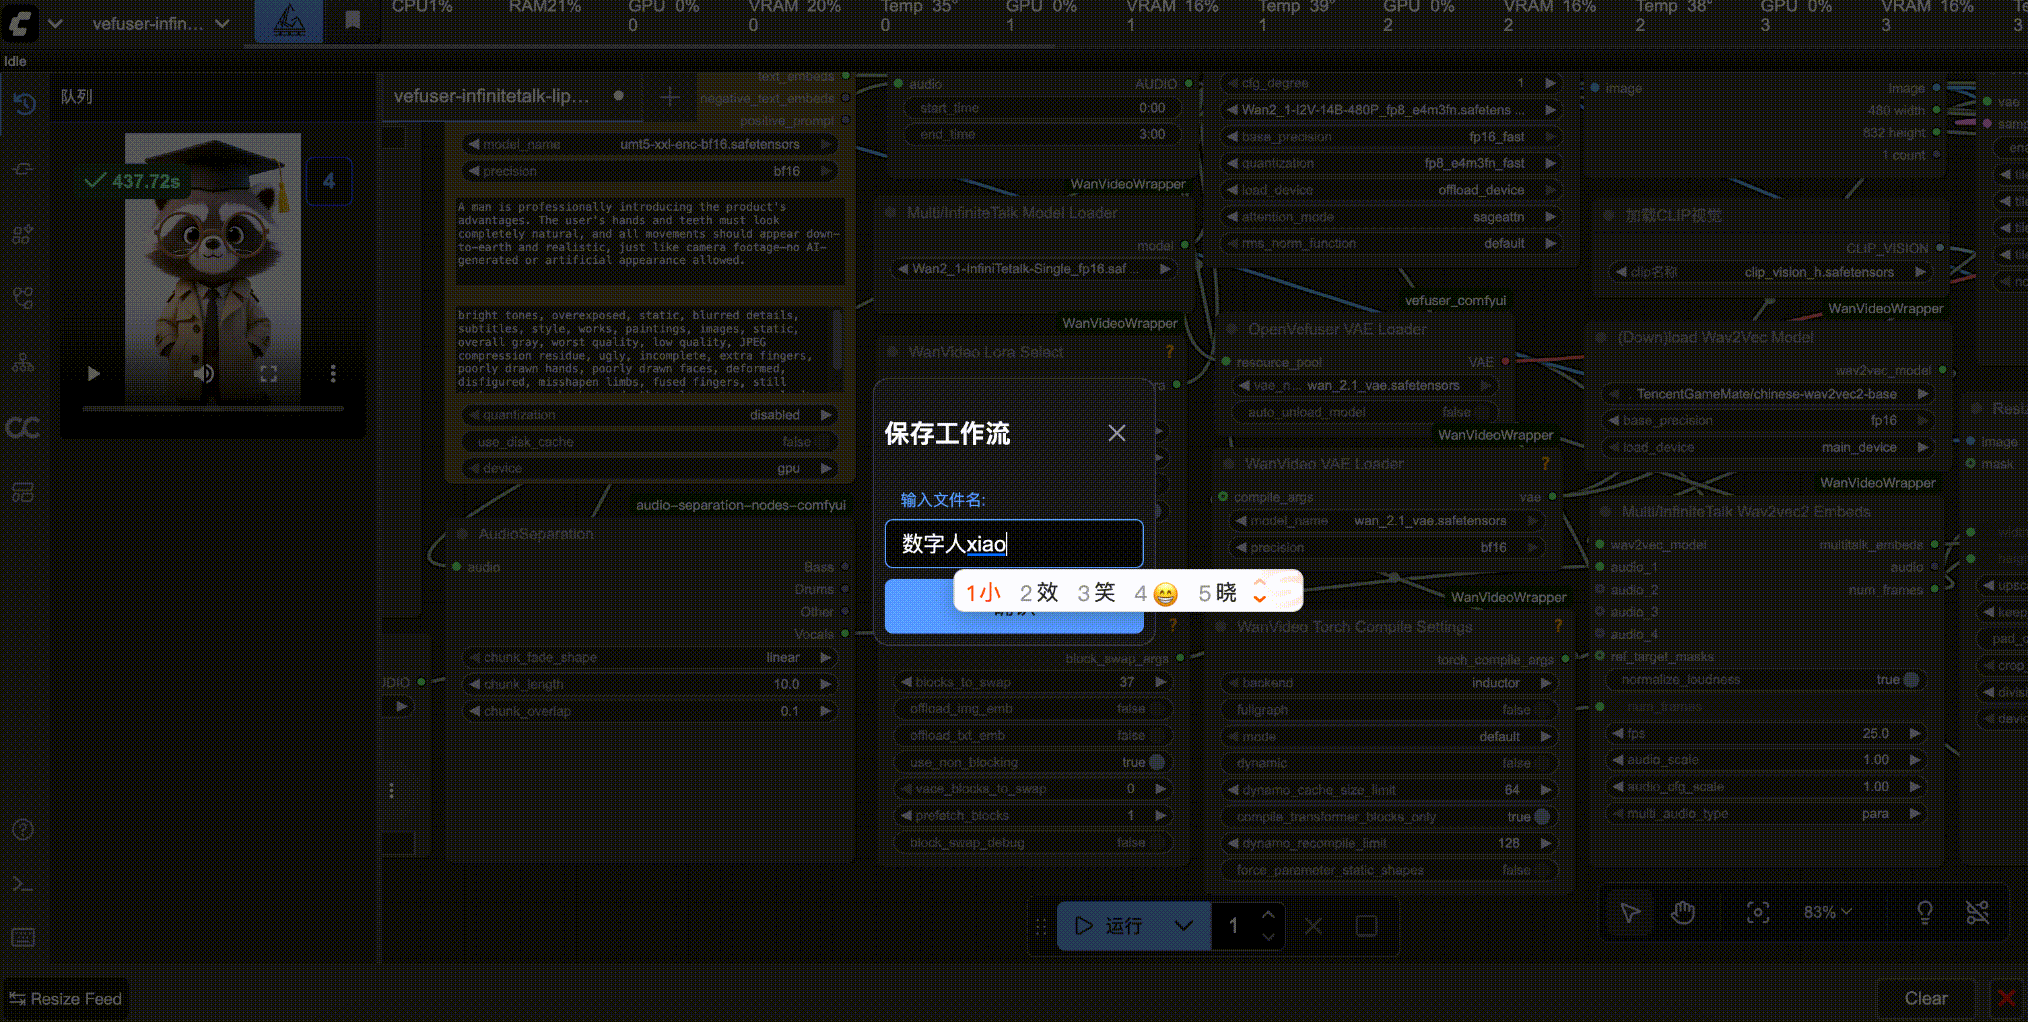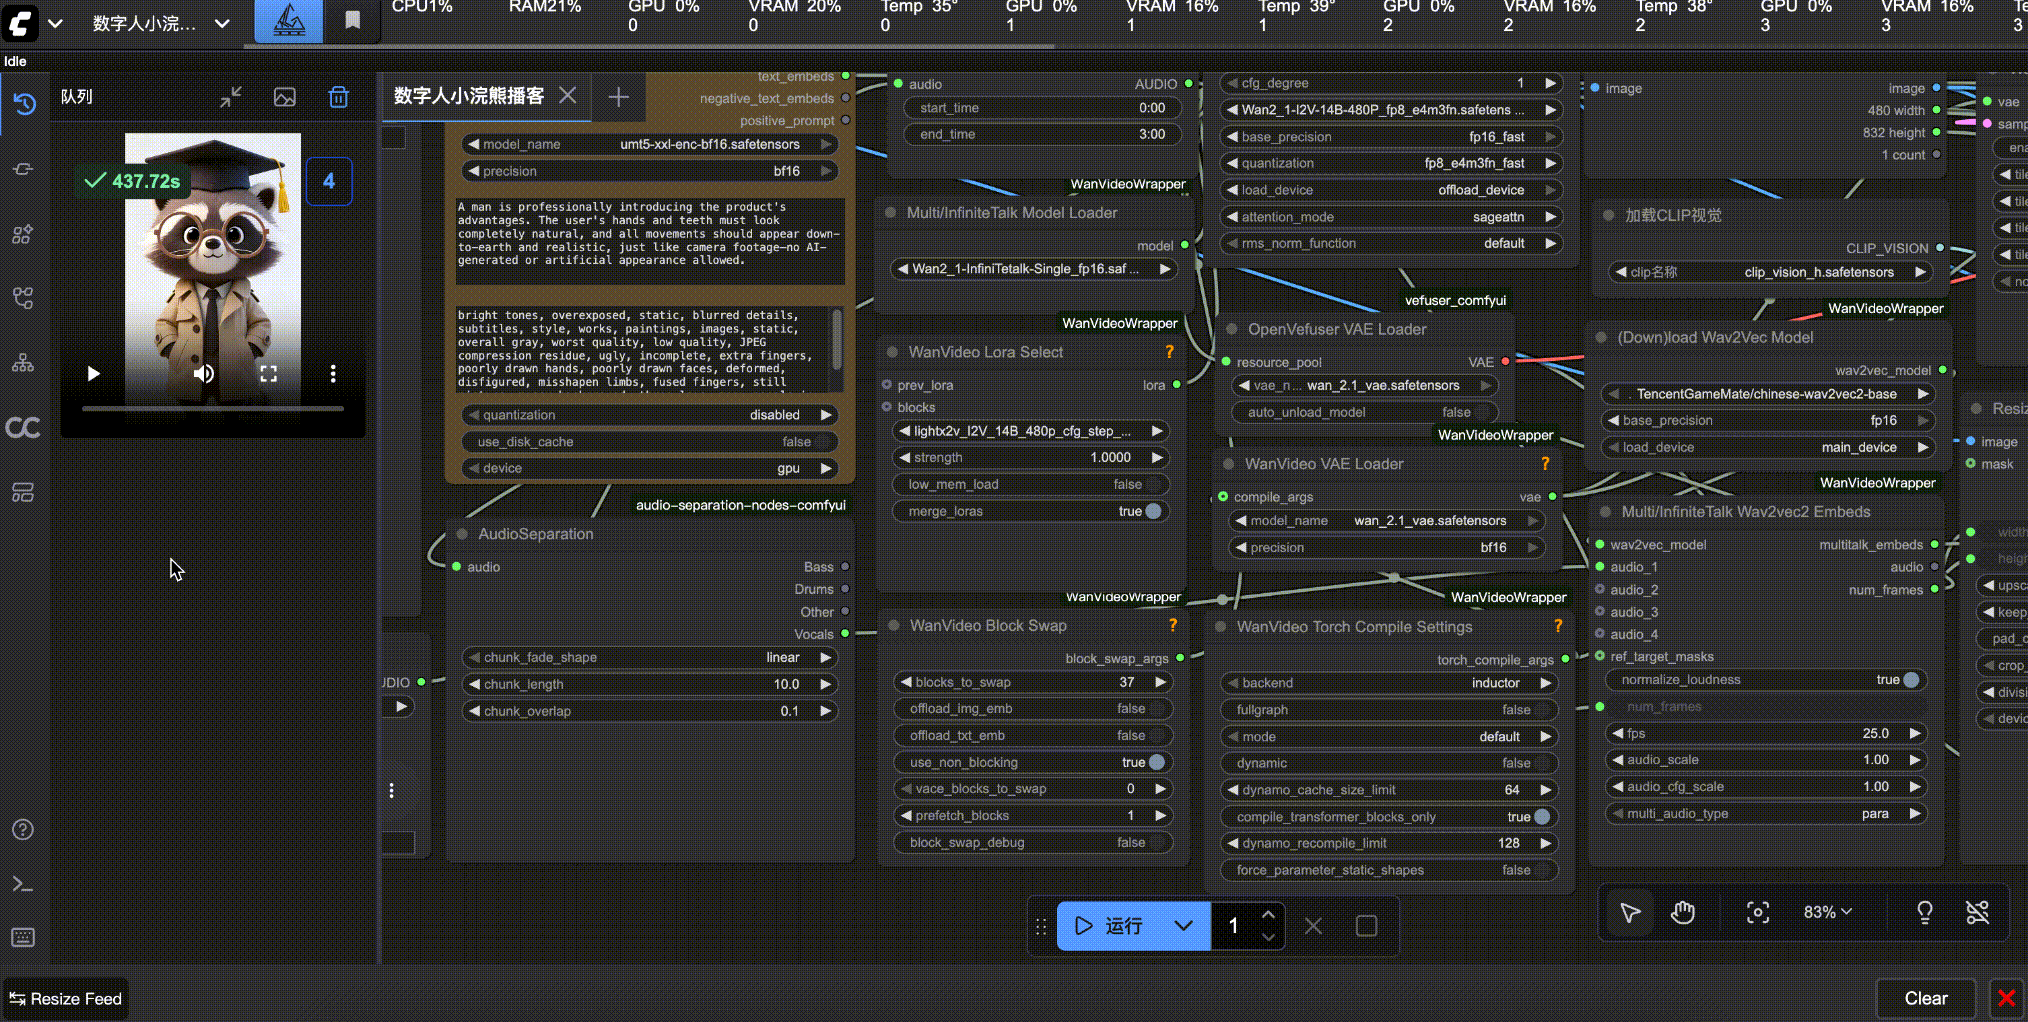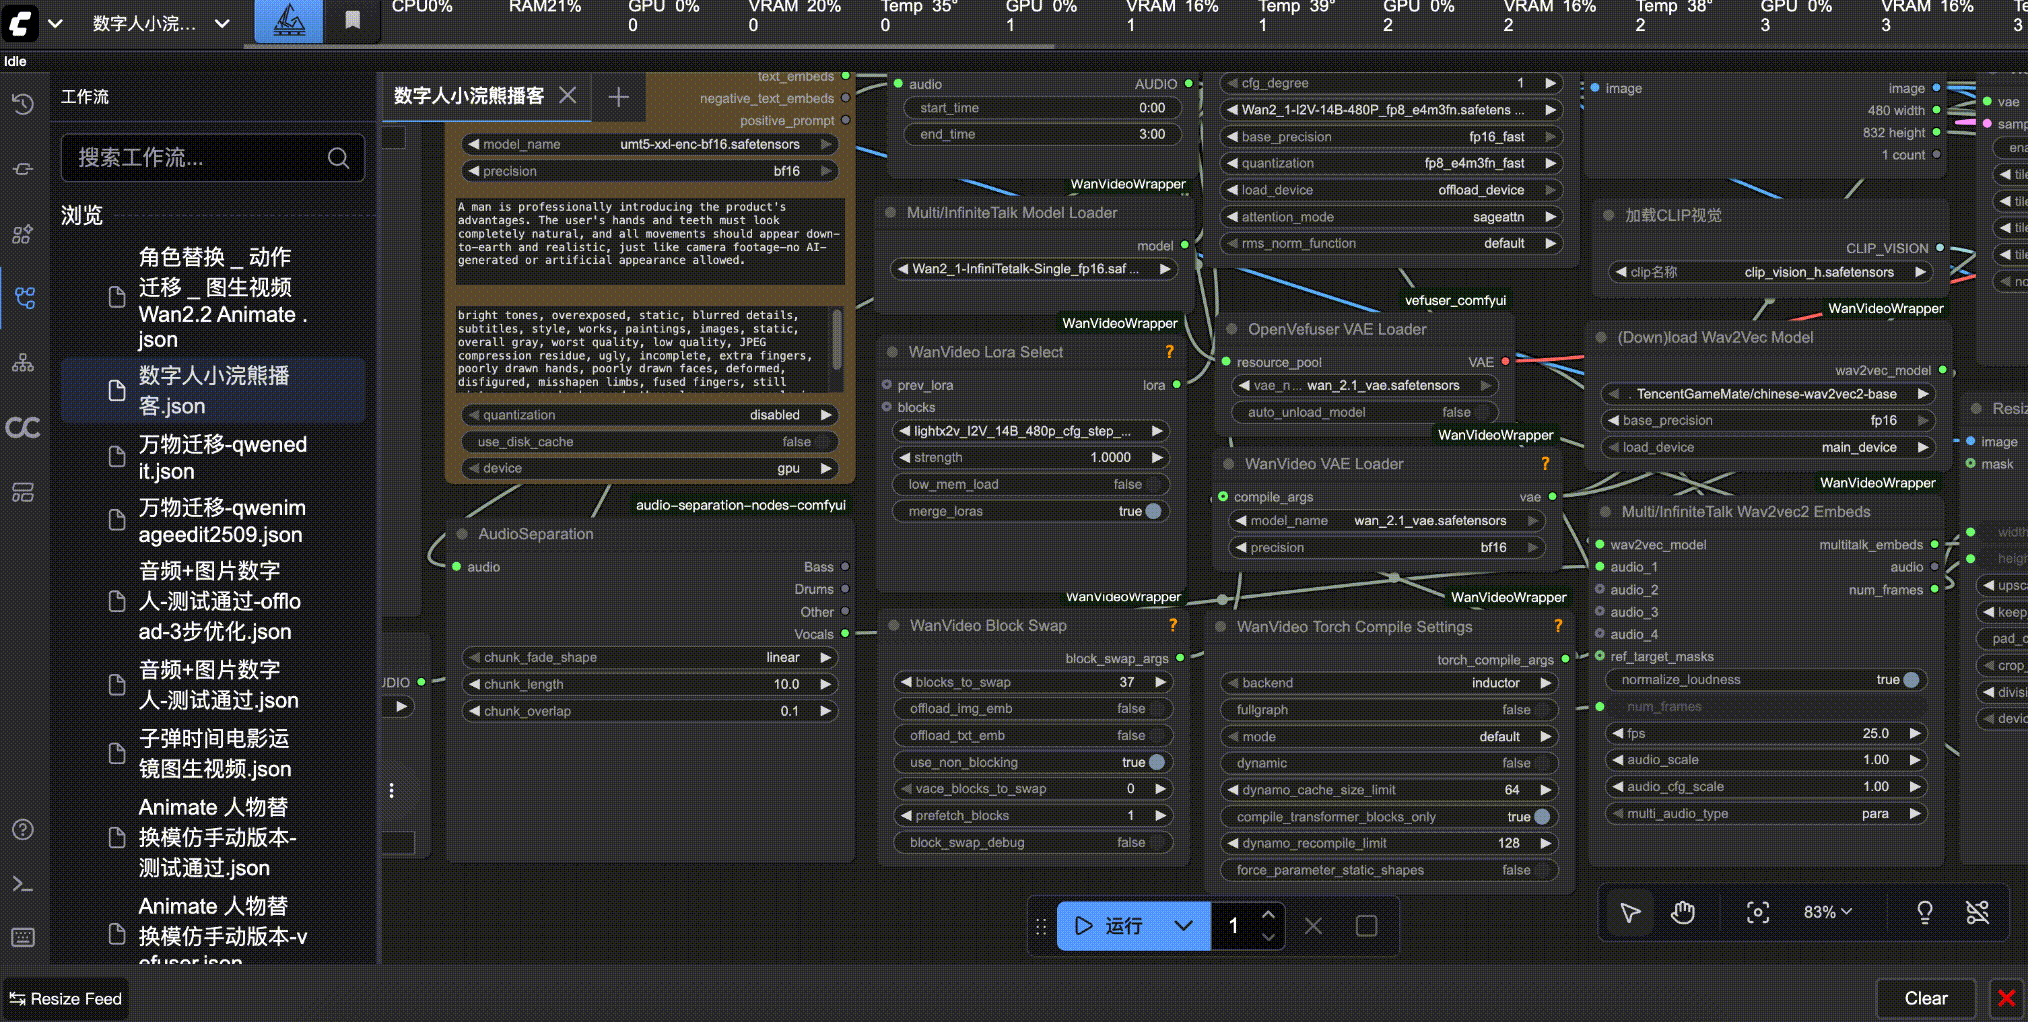
- 单击 运行 进入执行队列,等待任务执行完成。
- 任务执行完成后,即可看到“小浣熊数字人播客”已完成,实现数字人对口型播客视频效果。
- 确认输出的效果符合预期后,单击左上角下拉符号,选择 文件 > 保存,保存流水线。后续可在工作流内直接打开该工作流,选择合适的音频、图像及场景进行“数字人播客”创作。
-
后续操作
可根据本文上方 方案介绍 中的 Workflow 各节点参数说明,自定义修改参数配置,实现不同的效果。
最近更新时间:2026.10.14 19:17:57
这个页面对您有帮助吗?
有用
有用
无用
无用