容器服务
容器服务


文档指南

请输入


- 文档首页
 容器服务容器服务 VKE最佳实践可观测性使用自建 Grafana 搭建集群观测看板
 复制全文
 下载 pdf
使用自建 Grafana 搭建集群观测看板
 文档反馈
 问问助手
集群监控是集群运维的重要组成部分。通过监控,您可以了解集群中各种资源的使用情况和工作状态,及时发现异常并处理,保障业务的正常运行。本文为您介绍如何使用自定义 Grafana 搭建集群看板。
前提条件
- 已开启云原生观测。详情请参见 开启观测。
- 已在集群中,开启目标资源的观测功能。详情请参见 基础观测。
说明
操作步骤
步骤一:搭建 Grafana
您可以在不同的环境中搭建自定义 Grafana 环境,例如:
- 在 VKE 集群中搭建 Grafana,并接入托管 Prometheus 工作区。详情请参见 在容器服务集群中部署 Grafana 并接入工作区。
- 在 ECS 实例中搭建 Grafana,并接入托管 Prometheus 工作区。详情请参见 在云服务器实例中部署 Grafana 并接入工作区。
- 在其他环境中搭建自定义 Grafana,并使用公网地址接入托管 Prometheus 工作区。详情请参见 创建通用工作区。
步骤二:获取集群看板
- 登录 全栈可观测平台控制台。
- 在左侧导航栏选择 自定义看板,并选择 预置看板 页签,查看系统预置看板列表。
-
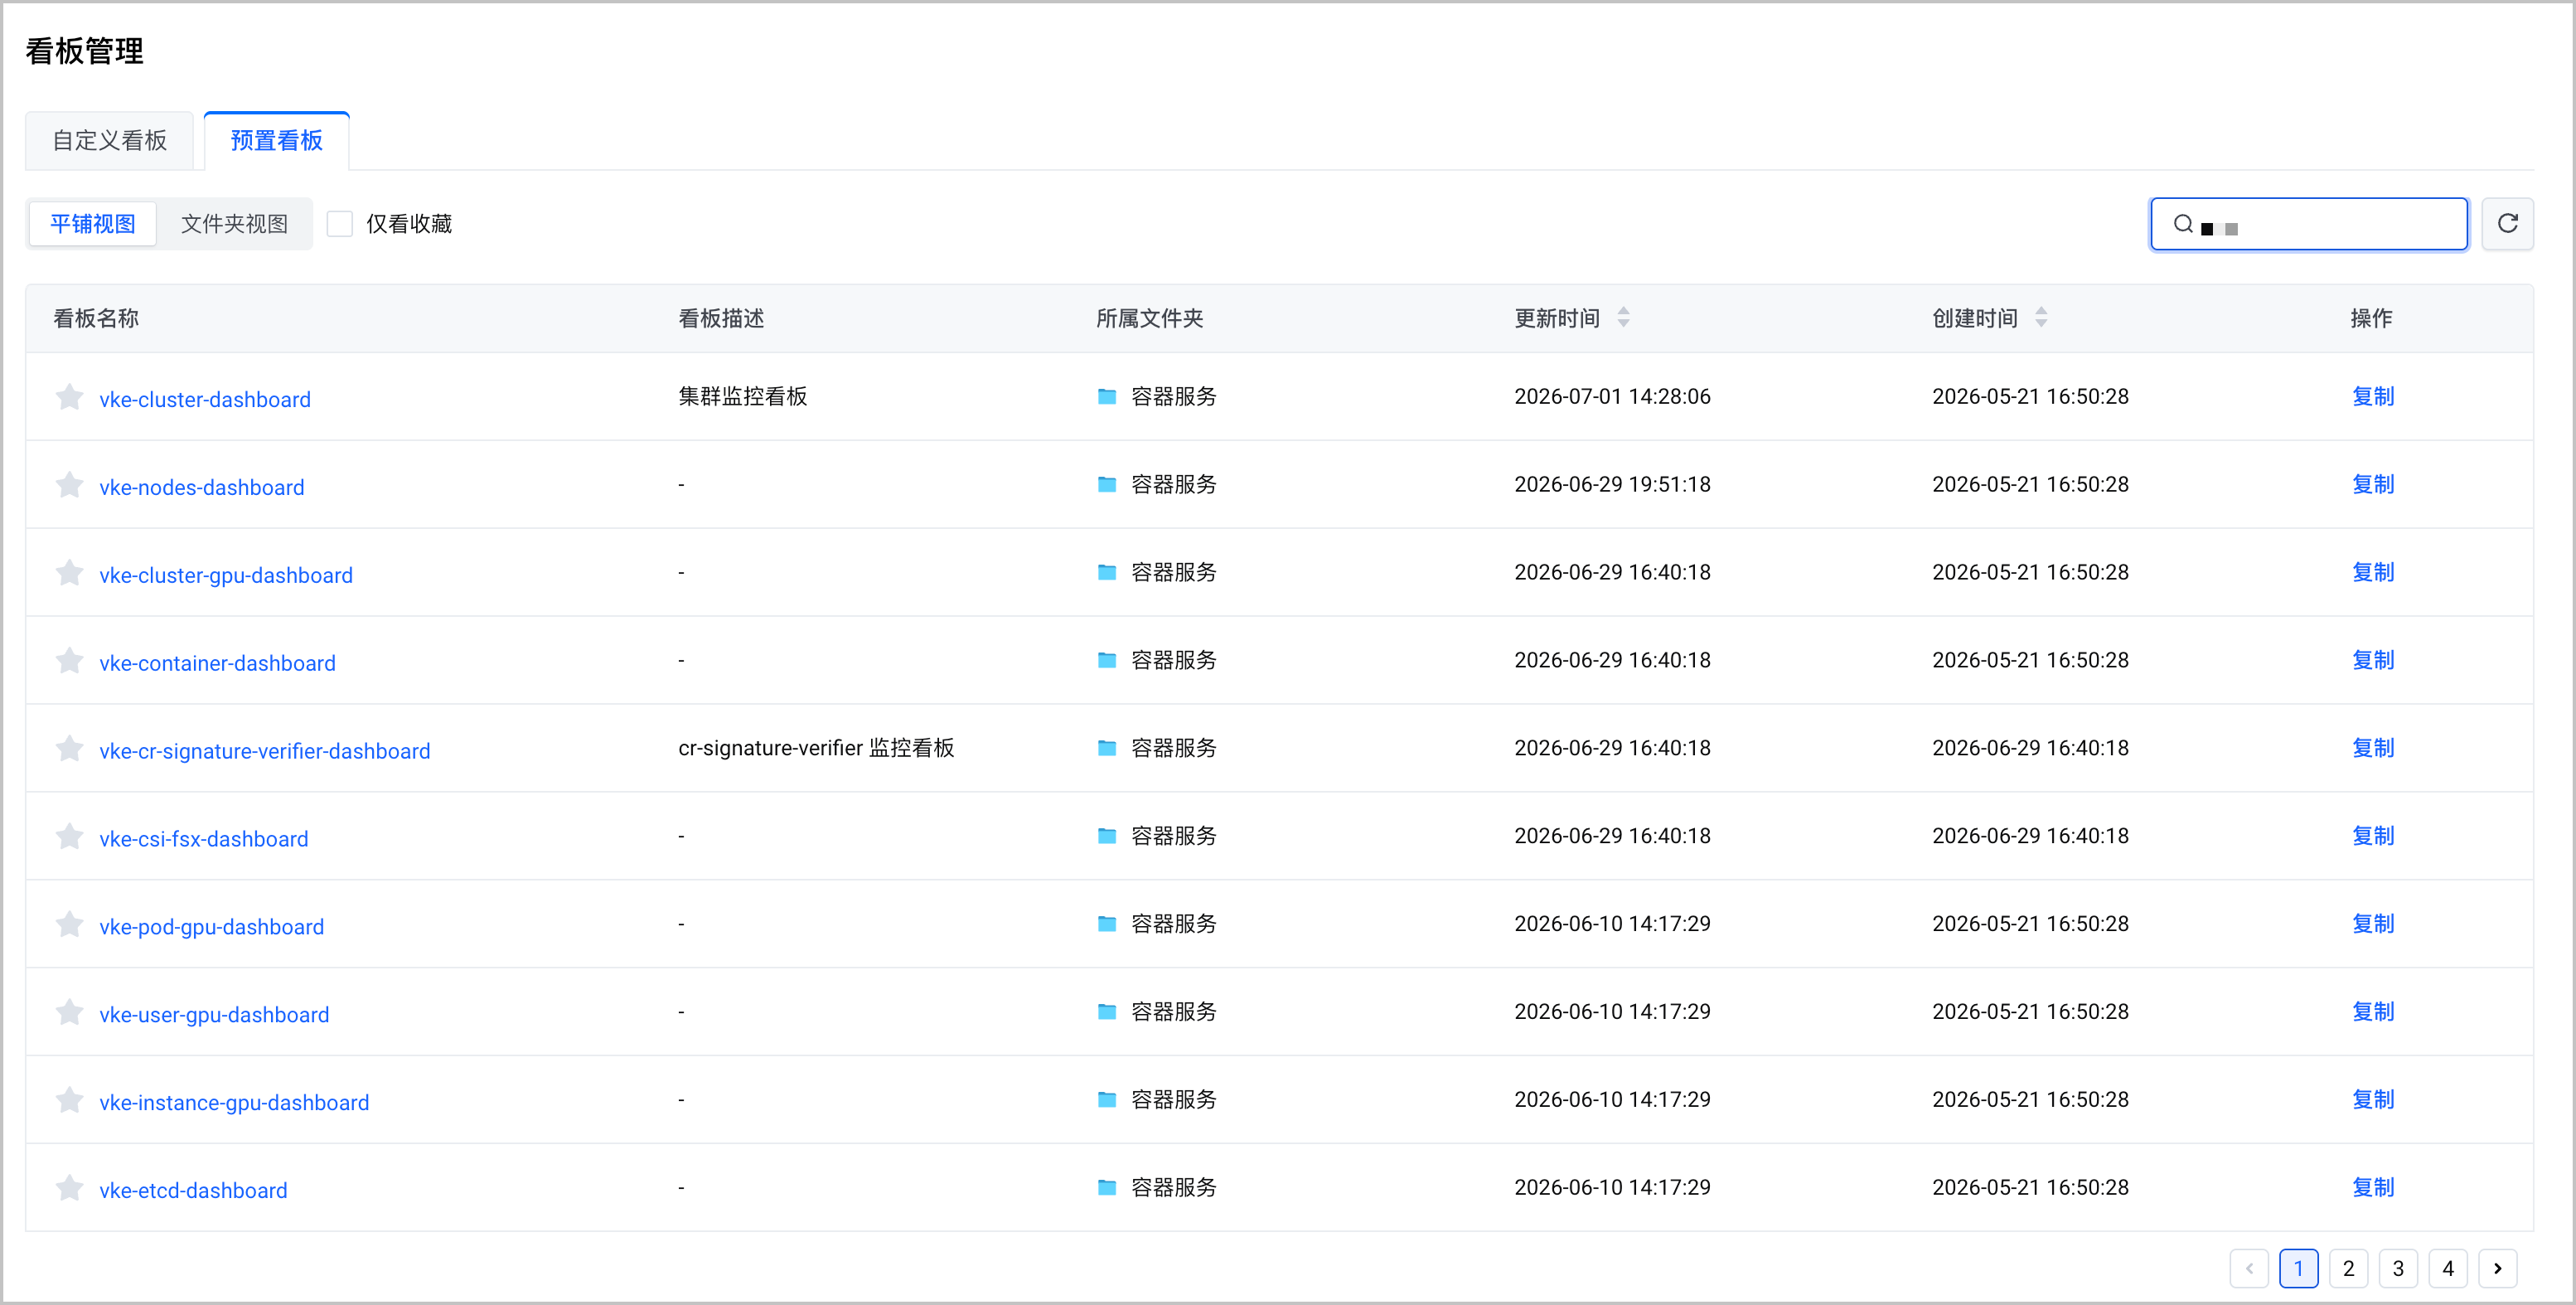
- VKE 中的监控看板与全栈可观测平台中预置看板的对应关系,如下表所示。
- VKE 看板分类VKE 看板名称全栈可观测平台中的看板名称集群监控集群监控概览vke-cluster-dashboard集群 Namespace 监控vke-namespace-dashboard核心组件监控kube-apiserver 监控vke-apiserver-dashboardetcd 监控vke-etcd-dashboardkube-scheduler 监控vke-scheduler-dashboardcluster-autoscaler 监控vke-ca-dashboardkube-controller-manager 监控vke-kcm-dashboardmetrics-server 监控vke-metrics-server-dashboard节点监控节点概览vke-nodes-dashboard节点详情监控vke-node-dashboard虚拟节点监控vci-virtual-node-dashboard工作负载监控无状态负载监控vke-deployment-dashboard有状态负载监控vke-statefulset-dashboard守护进程监控vke-daemonset-dashboard容器组监控vke-pod-dashboard容器监控vke-container-dashboard弹性伸缩监控vke-hpa-dashboard智能伸缩监控vke-katalyst-dashboard网络服务监控core-dns 监控vke-core-dns-dashboardnode-local-dns 监控vke-local-dns-dashboardvpc-cni 监控vke-cni-dashboard存储服务监控存储卷声明监控vke-pvc-dashboardFSX 监控vke-csi-fsx-dashboardGPU 监控集群 GPU 监控vke-cluster-gpu-dashboardGPU 实例监控
- 当 nvidia-device-plugin 组件为 v2.0.0 以下版本时,使用 vke-instance-gpu-dashboard
- 当 nvidia-device-plugin 组件为 v2.0.0 及以上版本时,使用 vke-instance-gpu-v2-dashboard
说明容器组 GPU 监控vke-pod-gpu-dashboard节点 GPU 监控- 当 nvidia-device-plugin 组件为 v2.0.0 以下版本时,使用 vke-node-gpu-dashboard
- 当 nvidia-device-plugin 组件为 v2.0.0 及以上版本时,使用 vke-node-gpu-v2-dashboard
说明用户 GPU 监控vke-user-gpu-dashboard镜像加速服务监控p2p 镜像加速监控vke-p2p-dashboard镜像懒加载(Nydus)监控vke-nydus-dashboard资源管理监控CPU Burst功能监控vke-katalyst-cpu-burst-dashboardkatalyst 监控vke-katalyst-dashboard智能运维检测自愈vke-aiops-remediation-dashboard
- 单击目标看板名称,进入看板详情。在页面右上角单击 导出,并在弹出的菜单中选择 Grafana JSON,将看板导出到本地。
-
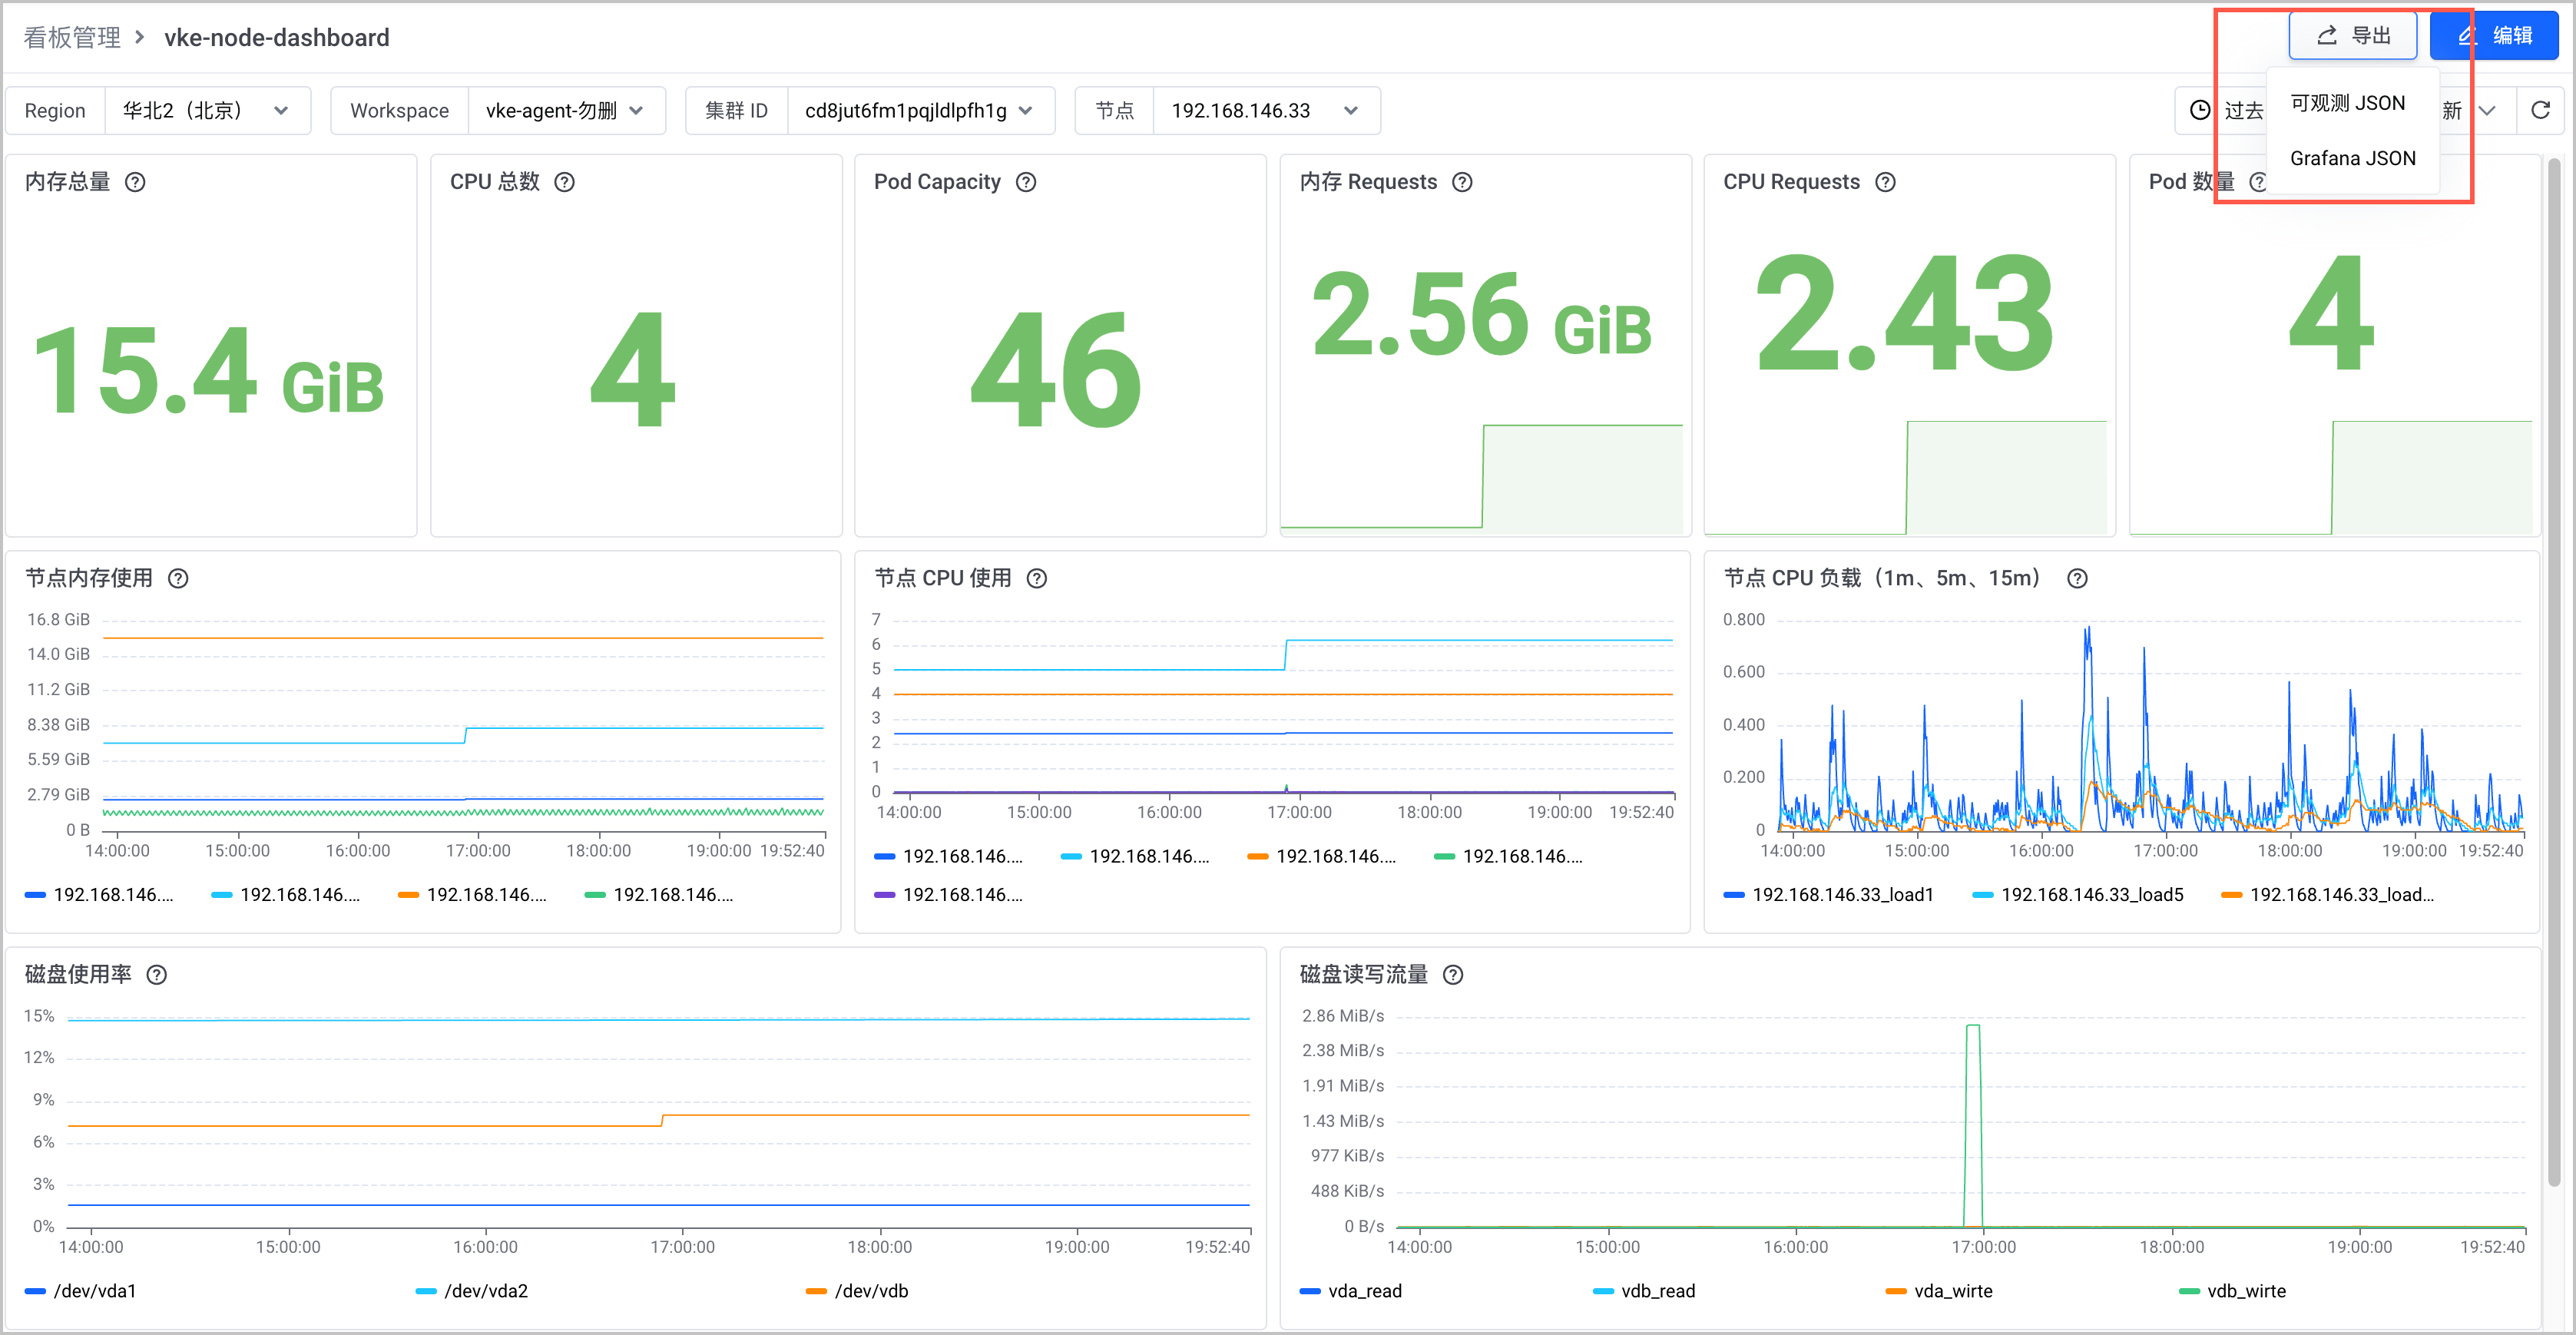
- 在本地环境中打开导出的看板文件,删除templating.list[0].current字段。如下面代码中的删除部分所示:
说明
templating.list[0].current字段保存的是导出 Grafana JSON 文件时选中的集群 ID,为原平台环境的残留内容,因此该值在自建环境中不适用。删除该参数后,导入 Grafana 时会从空状态开始,并允许您从下拉框重新选择集群 ID。
-
- 修改完成后,保存文件。
步骤三:导入监控看板
- 登录自建 Grafana 环境。
- 在左侧导航栏中,选择 Dashboards,进入监控大盘配置页面。
-
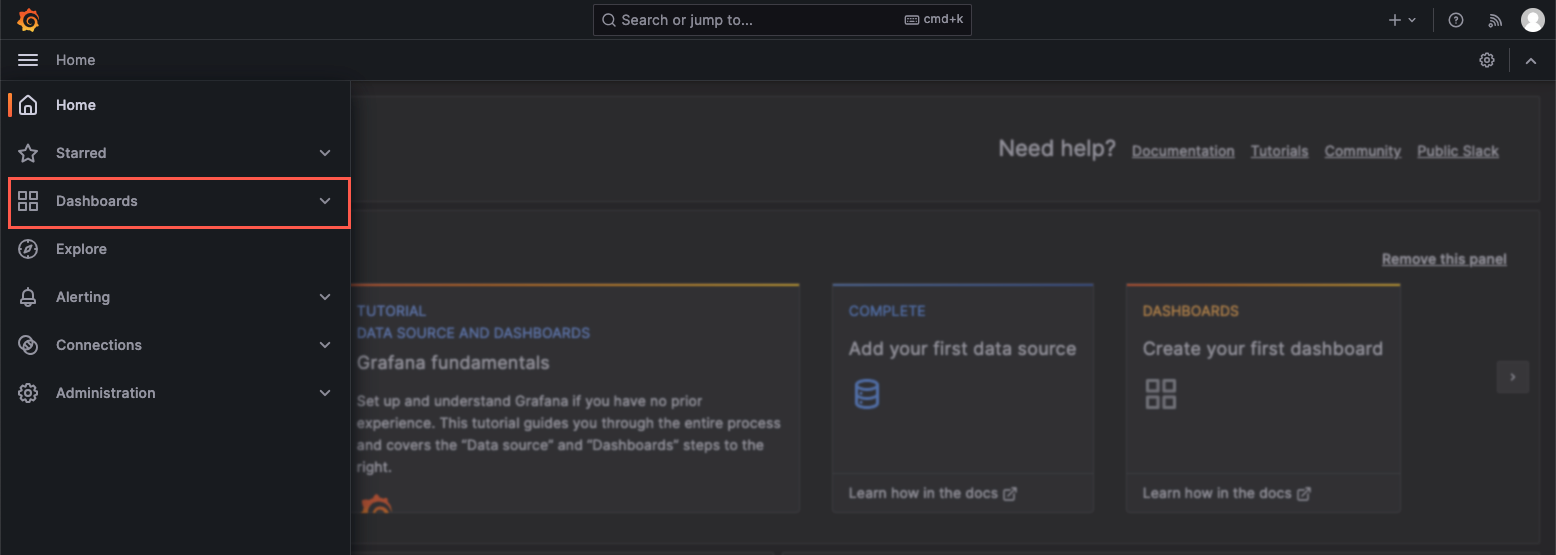
- 单击 New ,在下拉菜单中选择 import,进入导入大盘页面。
-
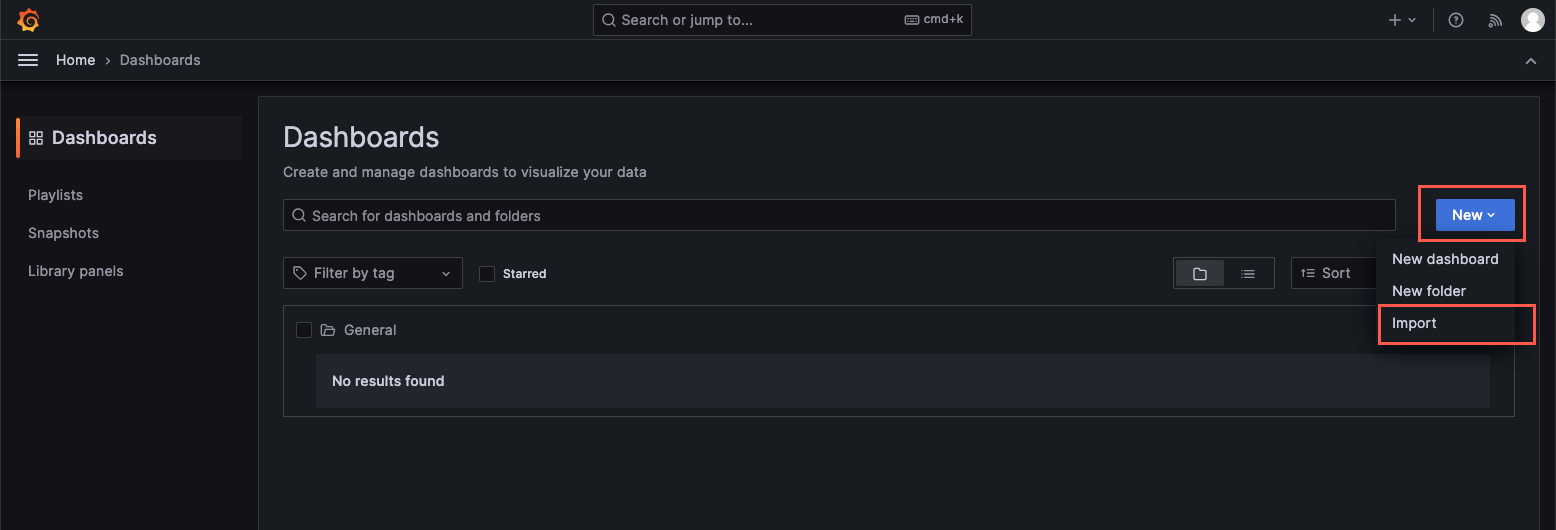
- 单击 Upload dashboard JSON file,并选择保存在本地的监控大盘 JSON 文件。
-

- 配置监控大盘的基本信息并选择数据源。
-
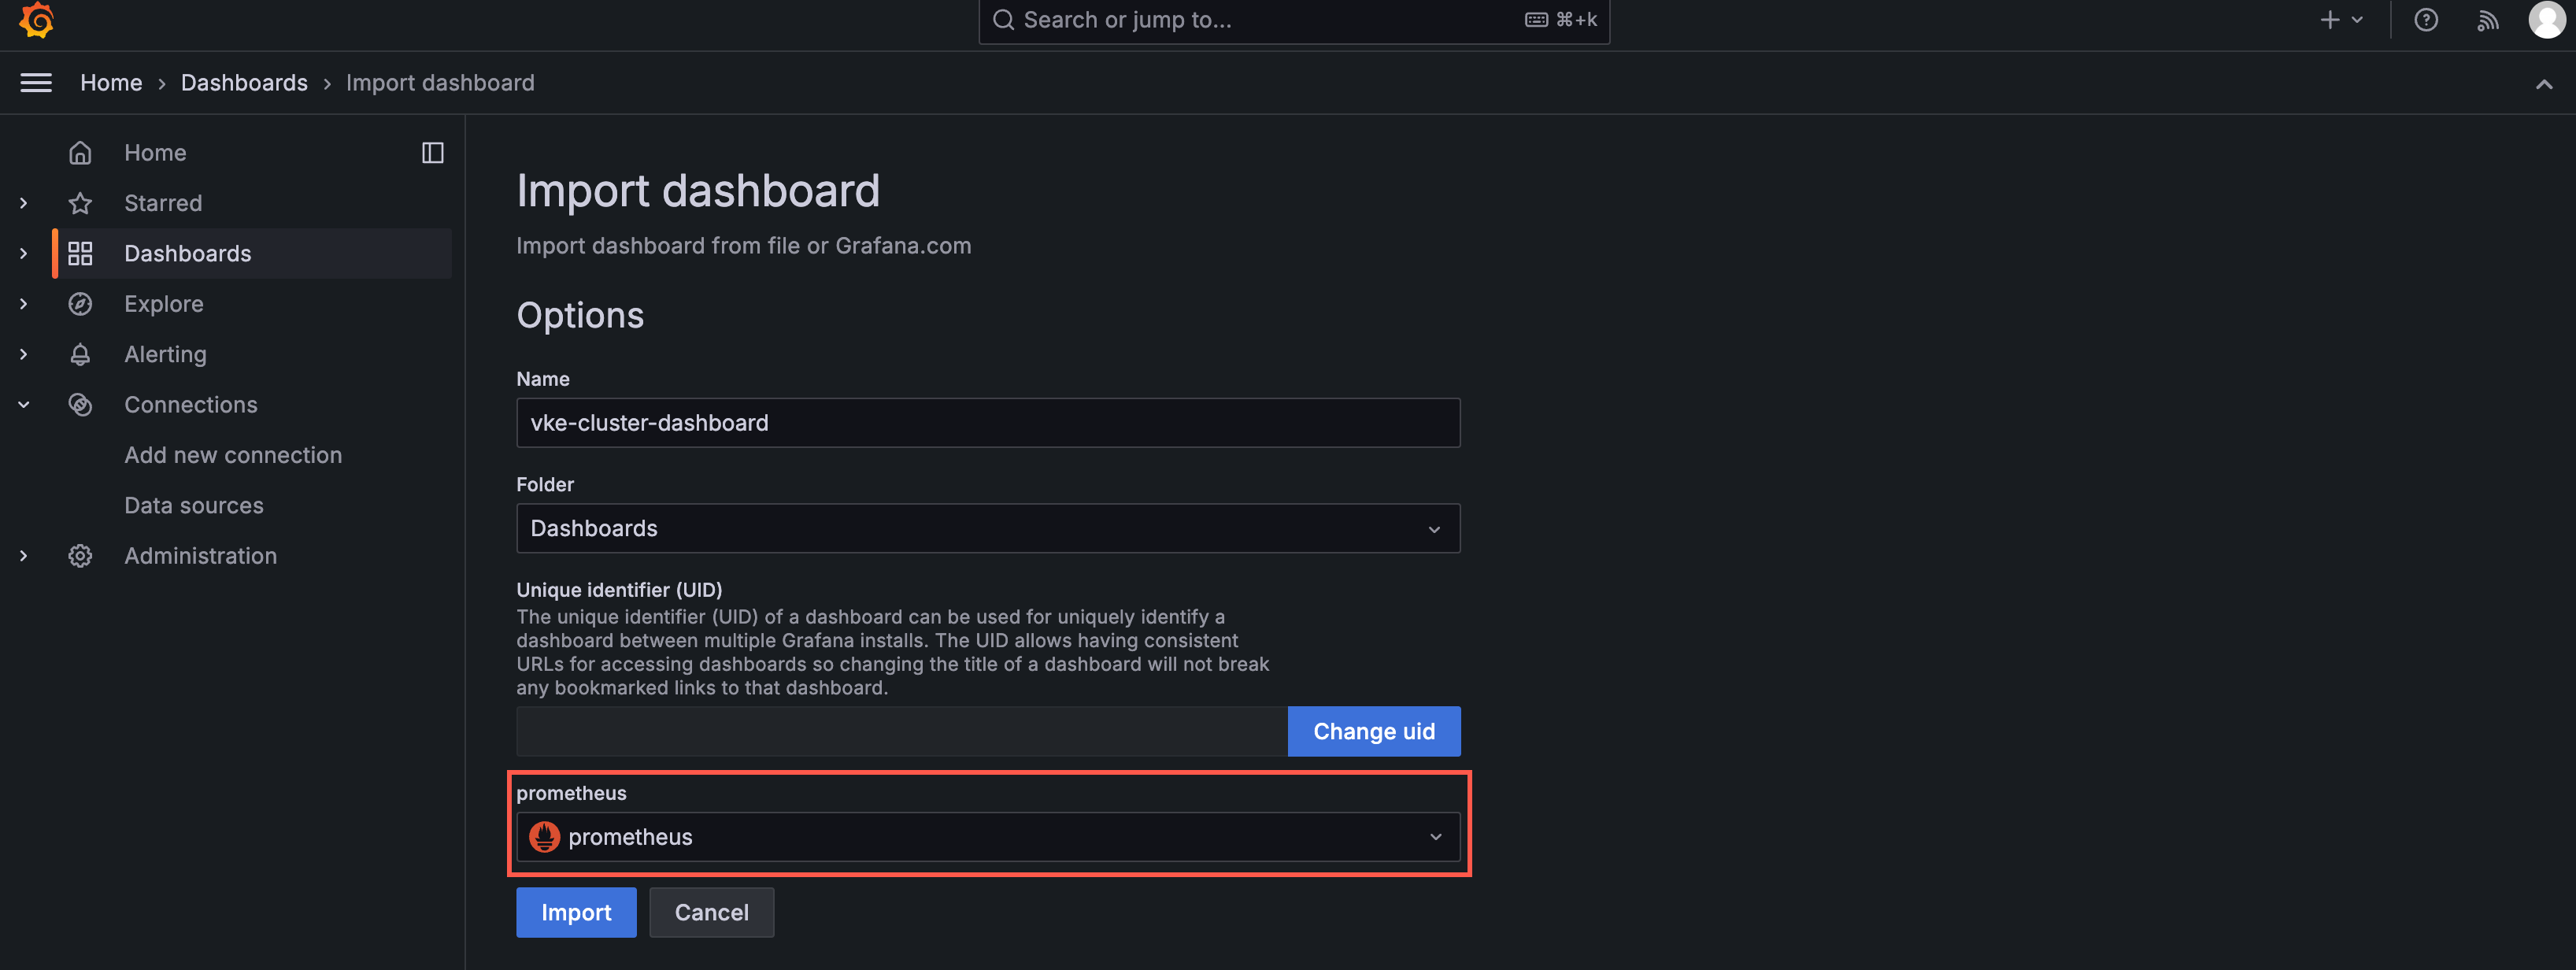
- 配置项说明Name(可选)根据需要修改监控大盘的名称。Folder(可选)选择大盘保存的文件夹。prometheus选择已配置好的数据源。
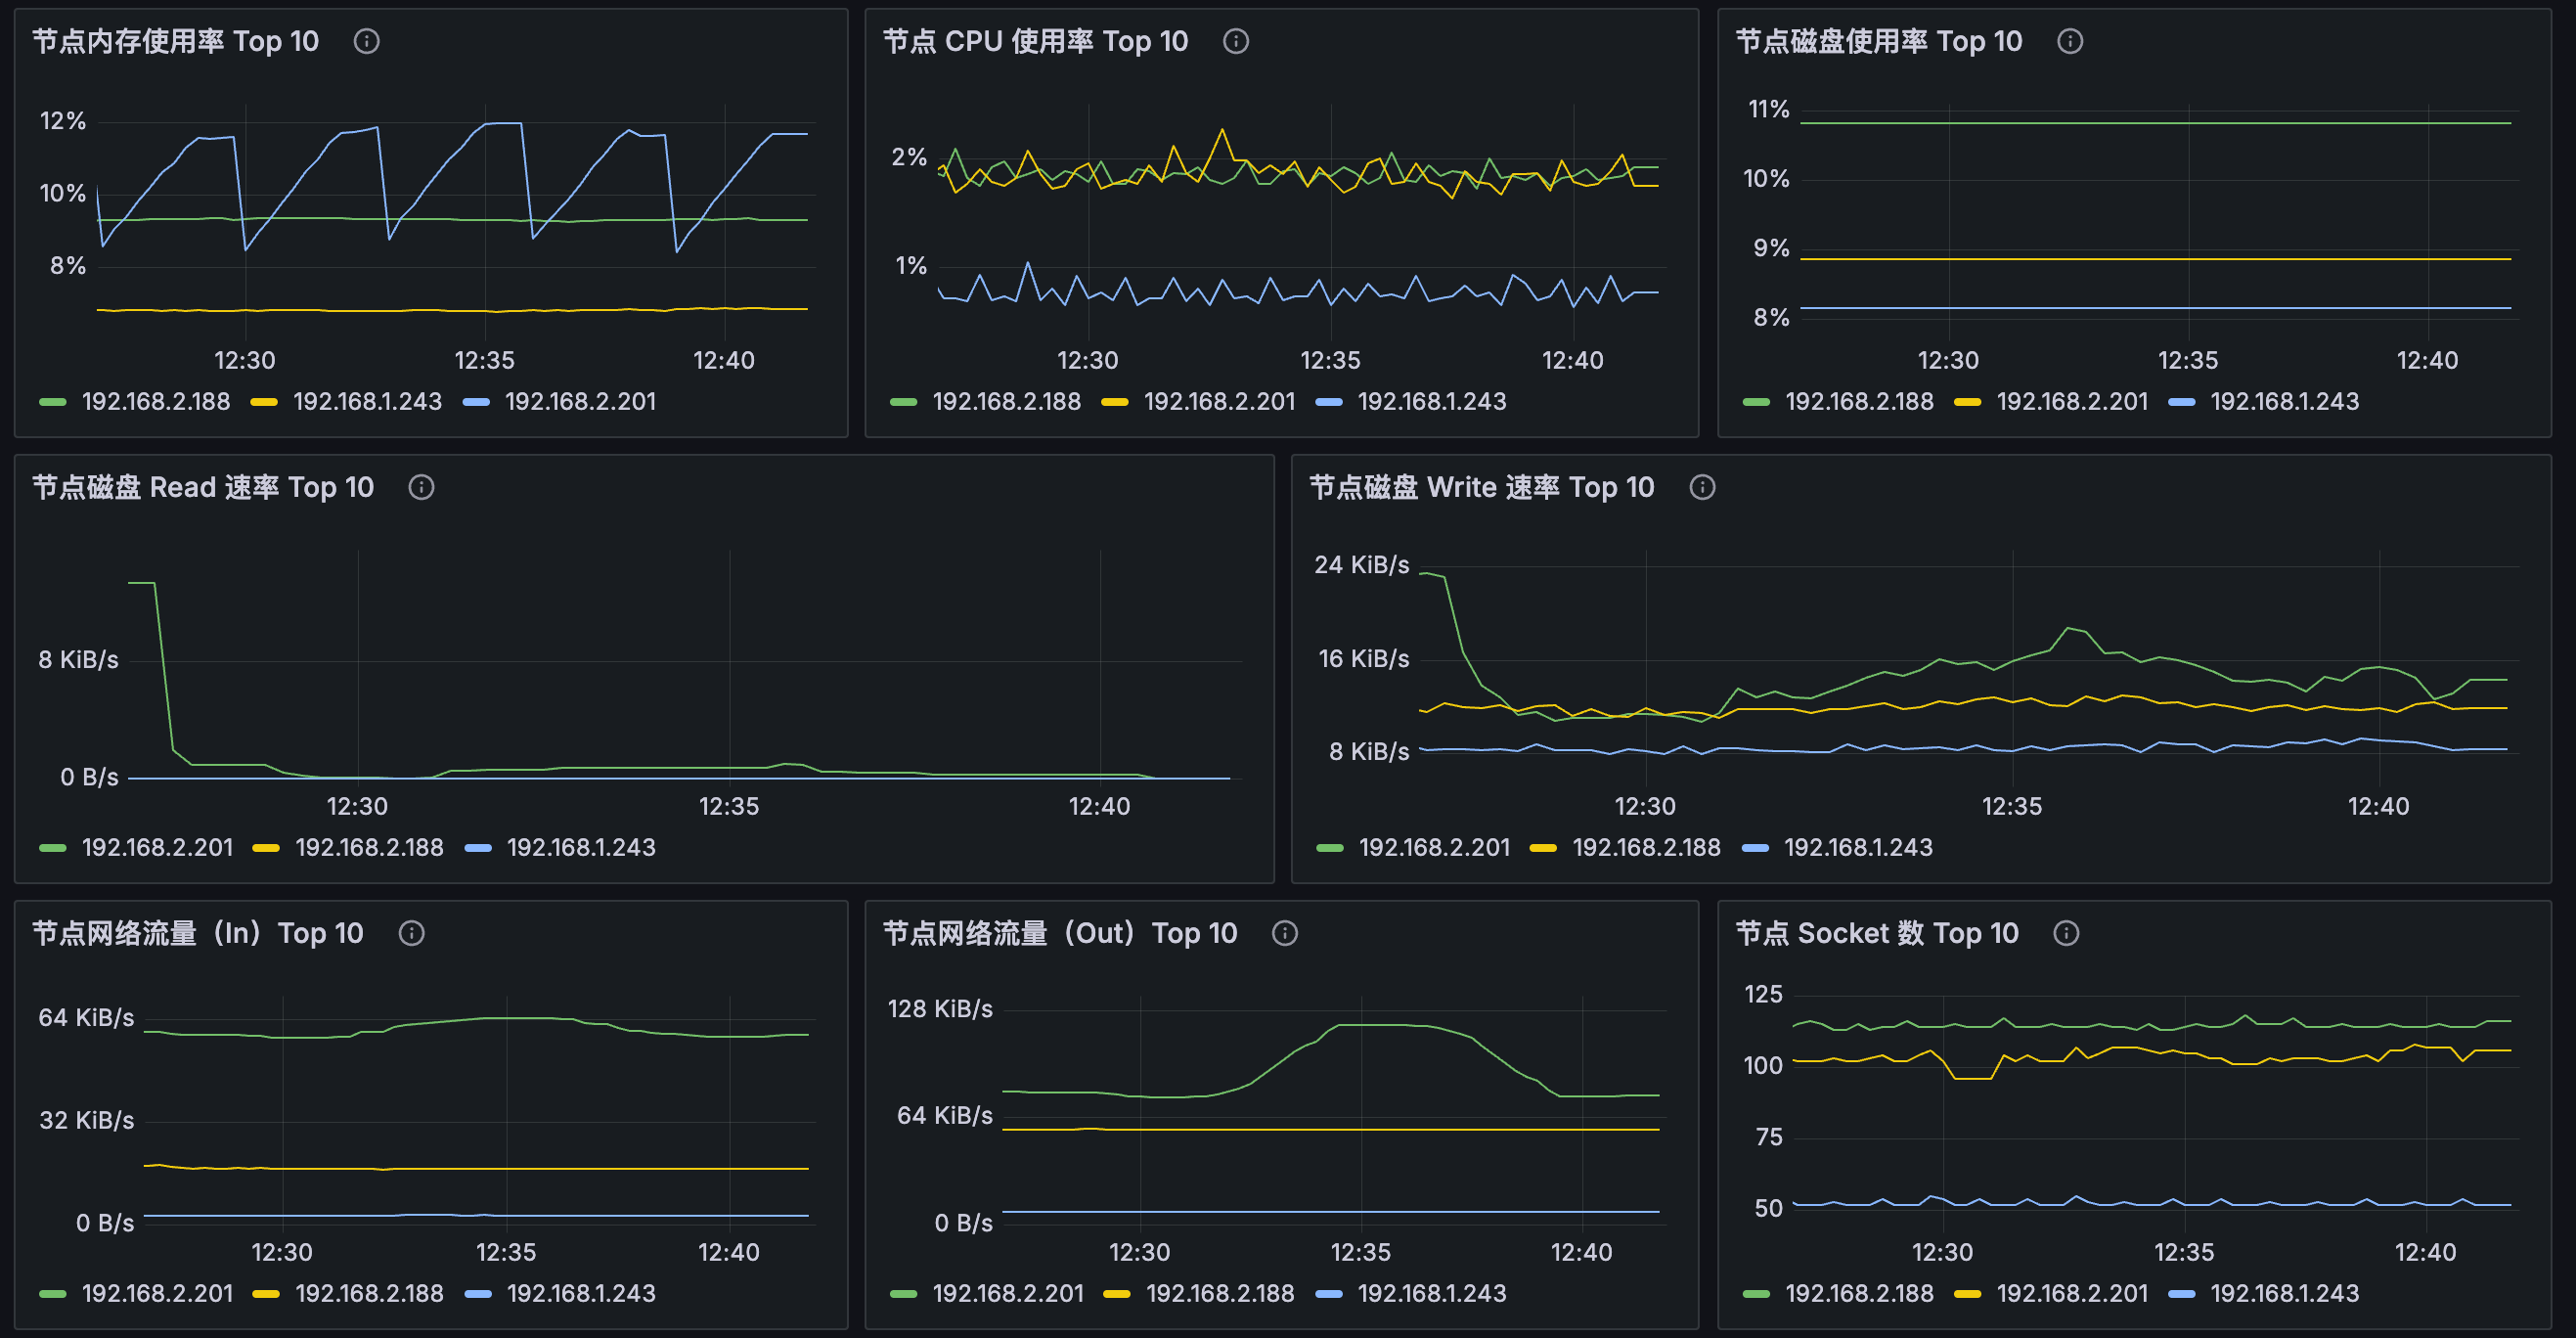
- 单击 import,完成导入,即可查看监控大盘。
-
最近更新时间:2026.07.13 15:09:38
这个页面对您有帮助吗?
有用
有用
无用
无用