容器服务
容器服务


文档指南

请输入


- 文档首页
 容器服务容器服务 VKE用户指南网络集群网络API Server 限流
 复制全文
 下载 pdf
API Server 限流
 文档反馈
 问问助手
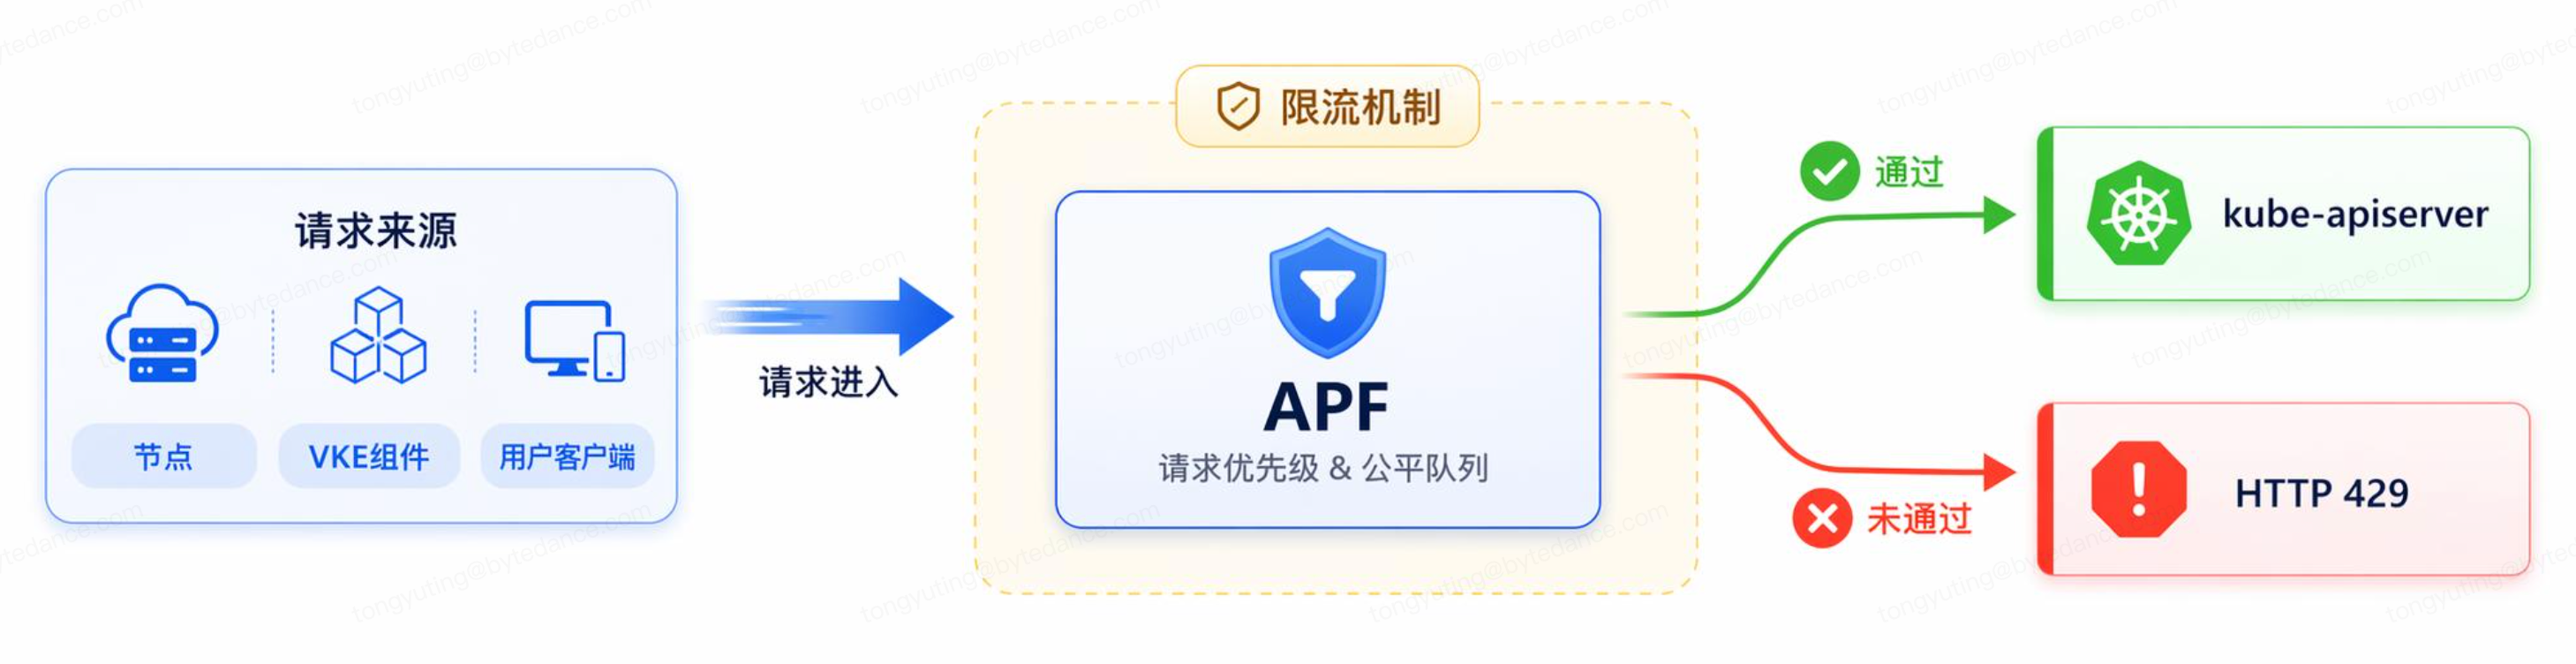
APF 是 Kubernetes 原生的请求流量治理机制,用于在 API Server 负载升高时保护控制面稳定性。本文介绍 APF 的基本原理,以及如何查看和缓解 APF 限流。
背景信息
API Server 限流
API Server 作为 Kubernetes 集群的唯一 API 入口,承载着来自节点、控制器、运维脚本和业务侧客户端发起的请求。为避免个别客户端的异常流量耗尽控制面资源、导致 API 服务整体不可用,Kubernetes 引入了请求限流机制:请求在进入 API Server 处理链路之前,先由限流组件进行准入判定,未通过限流的请求将被直接拒绝(HTTP 状态码 429)。在 VKE 集群中,API Server 的限流能力主要基于 APF(API Priority and Fairness,API 优先级与公平性)实现。
APF 简介
什么是 APF?
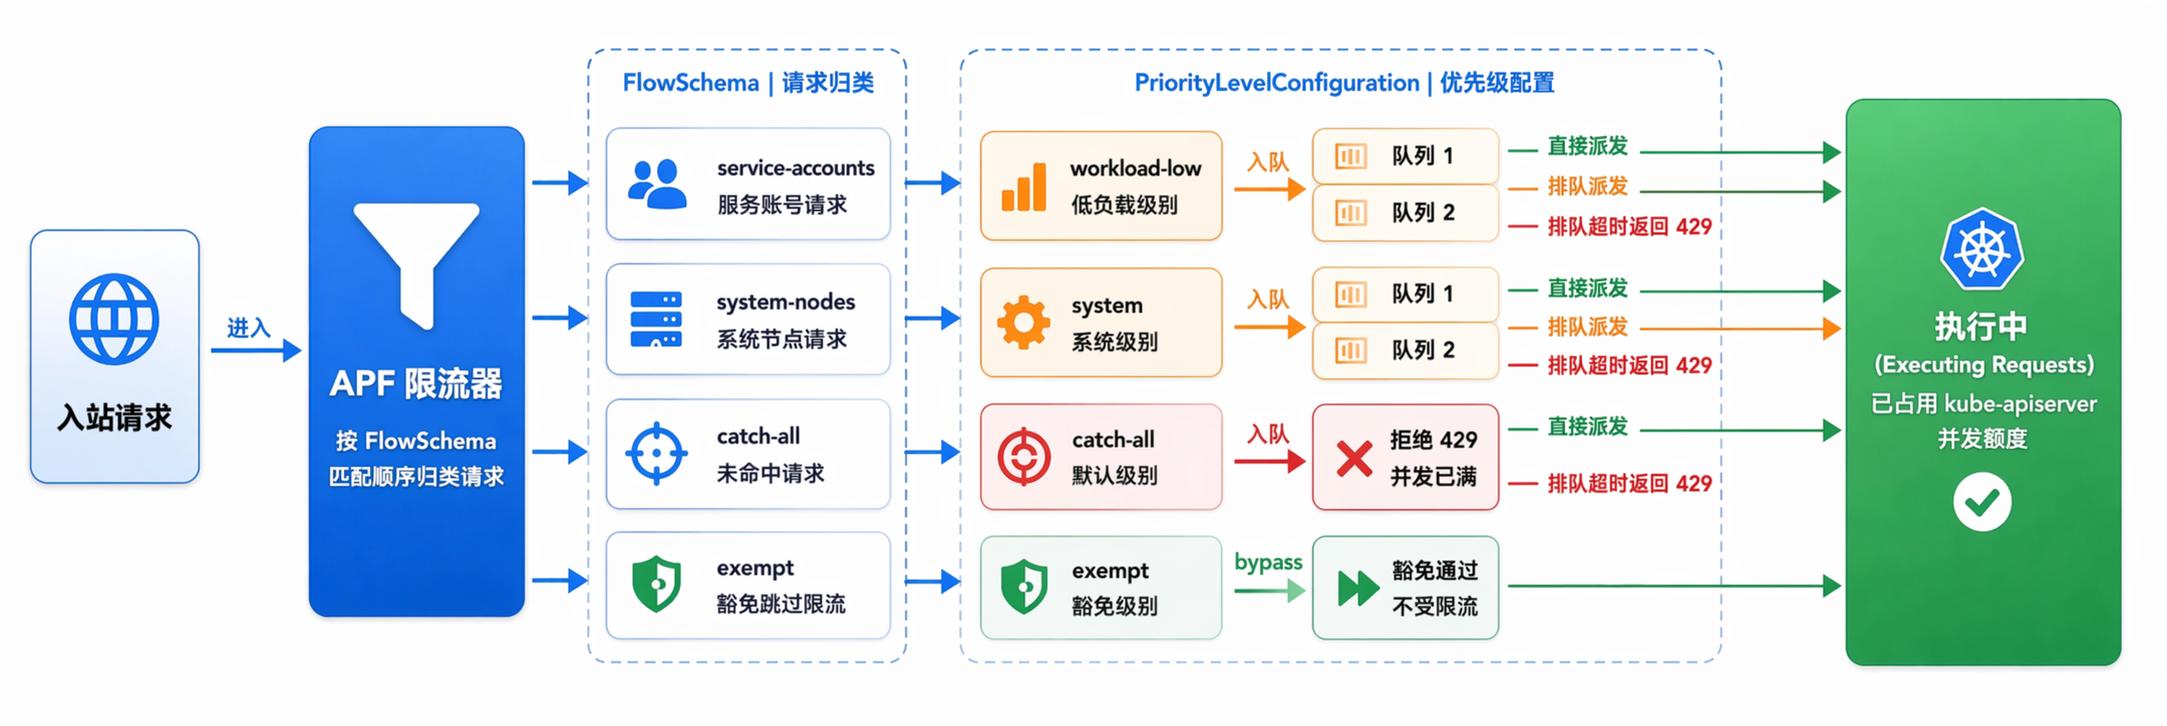
APF 是 Kubernetes 原生的请求流量治理机制,用于对 API Server 请求流量进行分类、分级、排队和拒绝处理。其基本处理思路如下:
- 请求分组:APF 会先根据请求来源、请求资源、请求动词等条件,把请求匹配到某个 FlowSchema。
- 分配处理席位:匹配完成后,请求会被映射到某个 PriorityLevelConfiguration,由这个优先级配置决定该类请求可以占用多少并发席位,以及在超出并发上限时是排队还是被拒绝。
APF 中的常见概念和说明,如下表所示:
APF 工作流程
当请求流量进入 API Server 后,APF 的工作流程如下:
- APF 先根据 FlowSchema 规则判断请求属于哪一类流量。
- APF 把该请求分配到对应的优先级队列(PriorityLevelConfiguration)。
- 如果该优先级队列还有可用的并发处理席位(seats),请求会直接执行。
- 如果该优先级队列没有可用的并发处理席位(seats),且允许排队,请求会进入队列等待。
- 如果并发处理席位(seats)已满,且队列也无法继续接收请求,请求会被拒绝,并返回429 Too Many Requests。
说明
APF 限流的重点不在于“保证平均”,而在于当控制面紧张时,尽量保证关键流量先被处理。例如:系统组件请求、节点心跳请求,通常不应该和普通批量查询请求抢占同一优先级。
VKE 默认配置
在 VKE 集群中,单个 API Server 的并发处理能力是有上限的,默认最多同时处理 600 个请求。VKE 控制平面采用高可用架构,至少部署两个 API Server 副本,因此集群整体的并发请求能力是单副本的 2 倍。如果控制平面进一步横向扩容(增加副本数),整体并发能力会同步线性增长。此外,VKE 控制平面支持根据实际负载动态升配。当配置升高时,单个 API Server 的并发上限会自动提升。
查看 APF 资源
如果您需要了解集群当前使用了哪些 APF 规则,可以查看集群中的 FlowSchema 和 PriorityLevelConfiguration 资源对象。
- 使用如下命令,查看集群的 FlowSchema 资源对象。
-
- 预期结果如下,展示了当前集群中存在的 FlowSchema 资源对象。
-
- 关键字段说明,如下所示。
- 字段说明NAMEFlowSchema 名称。PRIORITYLEVEL与当前 FlowSchema 绑定的优先级队列(PriorityLevelConfiguration)。MATCHINGPRECEDENCE匹配优先级,数字越低,优先级越高。DISTINGUISHERMETHOD队列细分方式,包括:
- ByUser:按用户隔离队列。
- ByNamespace:按命名空间隔离。
- <none>:不细分,即所有请求共用一条队列。
AGE该 FlowSchema 已存在的时长。MISSINGPL对应的 PriorityLevelConfiguration 是否缺失,包括:- False:关联的队列存在,属于正常状态。
- True:关联的队列不存在,属于异常状态。
- 使用如下命令,查看集群的 PriorityLevelConfiguration 资源对象。
-
- 预期结果如下,展示了当前集群中存在的 PriorityLevelConfiguration 资源对象。
-
- 关键字段说明,如下所示。
- 字段说明NAME优先级队列(PriorityLevelConfiguration)名称。TYPE资源类型,包括:
- Exempt:豁免限流直接放行。
- Limited:流量受限,需要进行队列调度。
NOMINALCONCURRENCYSHARES并发处理份额,决定该队列能分到多少并发席位。该值为相对权重,不是绝对值,表示此优先级在所有 Limited 类型优先级中的相对配额,数值越大,通常可分配到的并发席位越多,但它并不等同于固定的绝对并发上限。QUEUES队列数量,支持按 ByUser、ByNamespace 打散到多个子队列。HANDSIZE洗牌手数,请求进来时随机挑选 N 个子队列,选最短的那个入队。该值越大,负载均衡越精准。QUEUELENGTHLIMIT每个子队列的最大排队长度,超过则直接返回429 Too Many Requests。AGE该 PriorityLevelConfiguration 已存在的时长。
识别 APF 限流
当 API Server 的访问流量超过允许的并发处理席位时,就会触发限流,您可以通过以下方法识别集群是否出现了限流:
- 客户端频繁收到429 Too Many Requests,说明请求已经被服务端拒绝。这通常是最直接的限流信号。
- 使用 VKE 提供的云原生观测功能,直接查看 API Server 的 APF 相关指标和监控看板。详情请参见 控制面服务观测。
缓解 APF 限流
步骤一:优化客户端行为
步骤二:调整 APF 配置
如果您确定满足以下场景时,可以通过 APF 配置调整,缓解限流问题:
- 被限流的是长期稳定存在的关键业务流量。
- 确认客户端侧已经完成基础优化,例如避免高频 list/watch、为重试请求增加退避机制、减少不必要的全量查询等。如果完成这些优化后仍持续出现429 Too Many Requests,再考虑通过 APF 配置调整缓解限流问题。
- 当前默认 APF 规则仍然无法满足业务需要。
方式一:调整现有 PriorityLevelConfiguration
支持通过调整 PriorityLevelConfiguration 中的nominalConcurrencyShares参数,给指定请求分配更多并发席位。必要时,也可以一起评估队列数量和队列长度限制。
注意
- 请谨慎修改 FlowSchema 与 PriorityLevelConfiguration,配置不当可能会导致 API Server 请求丢失和业务严重中断。
- 如果需要修改默认生成的 APF 对象,还需要把apf.kubernetes.io/autoupdate-spec设置为false,避免后续配置被系统自动调谐回默认值。
配置示例如下。在本示例中,可以通过调整 PriorityLevelConfiguration 中的nominalConcurrencyShares参数,为该类请求分配更多并发处理份额。
关键字段说明,如下所示。
字段 | 说明 |
基础字段 | |
name | 优先级队列名称,FlowSchema 中通过此名称引用。 |
apf.kubernetes.io/autoupdate-spec | APF 自动调谐开关,配置为false后,系统会跳过对该资源的自动调谐。避免自定义配置被系统自动调谐回默认值。 |
spec 字段 | |
type | 资源类型,包括:
|
limited.nominalConcurrencyShares | 并发处理份额,决定该队列能分到多少并发席位。该值为相对权重,不是绝对值,表示此优先级队列在所有 Limited 类型优先级队列中的相对配额,数值越大,通常可分配到的并发席位越多,但它并不等同于固定的绝对并发上限。 说明
|
limited.lendablePercent | 席位可出借比例,表示该队列的并发席位中,有多少百分比的席位,可以在本队列空闲时借给其他队列。该配置为 APF 的弹性借用机制,让空闲队列的资源不被浪费。
|
limitResponse.type | 超出并发上限的请求的处理方式。包括:
|
queuing.queues | 子队列数量,本例中为 128。系统会按照 FlowSchema 中定义的DistinguisherMethod进行队列细分,防止某个用户或命名空间的大量请求阻塞整个队列。 |
queuing.handSize | 洗牌手数,本例中为 6。表示系统从所有子队列(本示例中为 128 个)中随机挑选 6 个,然后选择其中最短的那个入队。 |
queuing.queueLengthLimit | 单个子队列的最大排队长度,本例中为 50。表示当某个子队列中已有 50 个请求在等待时,新来的请求将直接被拒绝,即返回429 Too Many Requests,不再继续排队。 |
说明
方式二:新增自定义 FlowSchema
如果当前被限流的业务请求和其他普通请求混在一起,您也可以新增一个更精细的 FlowSchema,把关键请求单独匹配到新的优先级,避免它们长期归属与默认规则,导致与其他流量竞争。
配置示例如下,在本示例中,创建新的 FlowSchema 专门匹配 List 请求,并且分配 workload-high 这个拥有较高nominalConcurrencyShares的 PriorityLevelConfiguration。同时将matchingPrecedence配置为 9000。保证其匹配优先级高于本来匹配到的 FlowSchema,本例中为 global-default。
注意
创建自定义 FlowSchema 时,需特别注意配置matchingPrecedence参数。只有当新规则的优先级匹配顺序更靠前时,请求才会优先命中新规则。
关键字段说明,如下所示。
字段 | 说明 |
基础字段 | |
name | FlowSchema 资源名称,便于识别和管理。 |
spec 字段 | |
matchingPrecedence | 匹配优先级,数字越低,优先级越高。 |
distinguisherMethod.type | 队列细分方式,包括:
|
priorityLevelConfiguration.name | 绑定的优先级队列。在本例中,命中此 FlowSchema 的请求,会被放入workload-high这个优先级队列中处理。 |
rule 匹配规则 | |
subjects | 请求发起方,在本例中的取值含义:
|
resourceRules | 请求操作范围,在本例中的取值含义:
|
说明
结果验证
完成客户端优化或 APF 配置调整后,可以使用如下方式,确定 APF 限流是否已缓解。
- 查看客户端侧的429 Too Many Requests是否明显减少。
- 查看监控看板,确定apiserver_flowcontrol_rejected_requests_total指标的增长速度是否下降。详情请参见 控制面服务观测。
- 目标 PriorityLevelConfiguration 的并发处理席位占用是否回到可控范围。
- 关键业务请求的等待时间和成功率是否恢复正常。
最近更新时间:2026.06.16 15:15:09
这个页面对您有帮助吗?
有用
有用
无用
无用