容器服务
容器服务
容器服务


文档指南
请输入


容器服务 VKE
产品动态
Kubernetes 版本发布记录
组件发布记录
监控组件
DNS 组件
GPU 组件
Sandbox 组件
安全公告
产品公告
历史公告
用户指南
集群
节点池
授权
网络
容器网络
服务(Service)
路由(Ingress)
APIG Ingress
ALB Ingress
自定义转发规则配置示例
CLB Ingress
Nginx Ingress
Gateway API
工作负载
存储
数据管理中心(DMC)
对象存储(TOS)
FSX 访问方式
文件存储(NAS)
FSX 访问方式
弹性文件存储(EFS)
文件存储(vePFS)
FSX 访问方式
vePFS Client 访问方式
NFS 访问方式
大数据文件存储(CloudFS)
弹性伸缩
工作负载弹性伸缩
事件驱动伸缩(KEDA)
组件管理
网络组件
监控组件
DNS 组件
GPU 组件
Sandbox 组件
异构计算
调度管理
可观测性
基础观测
诊断与巡检
最佳实践
网络
可观测性
安全合规
API 参考
集群管理
节点池管理
组件管理
机型镜像管理
云原生观测
巡检诊断
弹性容器实例
附录
开发指南
常见问题
通用 FAQ
集群 FAQ
集群管理
集群升级
节点与节点池 FAQ
授权 FAQ
工作负载 FAQ
服务与路由 FAQ
存储 FAQ
弹性伸缩 FAQ
可观测性 FAQ
配额 FAQ
组件 FAQ
容器镜像 FAQ
AI 云原生
推理套件
Helm 模板 AI 应用
Deepseek 实践
Qwen 实践
最佳实践
MiniMax 模型部署
Qwen 模型部署
弹性容器实例 VCI
最新动态
用户指南
虚拟节点
VKE 集群使用虚拟节点
自建/跨云集群使用虚拟节点
创建 VCI 实例
VCI Agent Sandbox
安全合规
- 文档首页
 容器服务容器服务 VKE常见问题工作负载 FAQPod 异常排查Pod 处于 CrashLoopBackOff 状态
 复制全文
 下载 pdf
Pod 处于 CrashLoopBackOff 状态
 文档反馈
 问问助手
问题描述
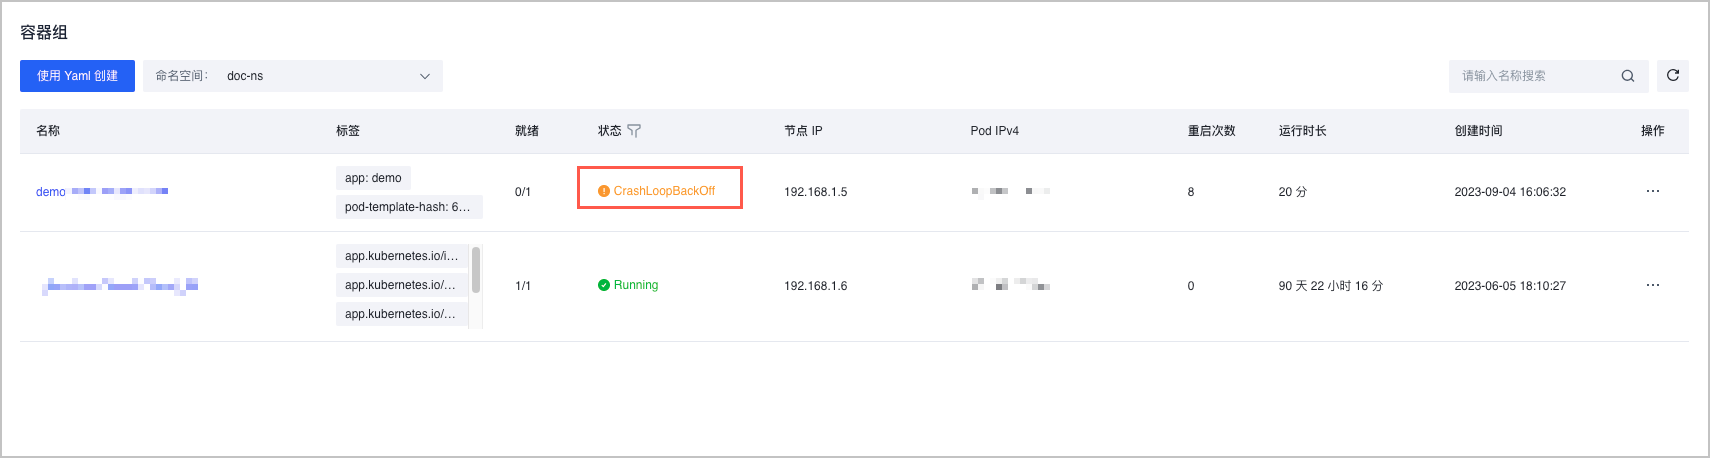
若 Pod(容器组) 长期停留在 CrashLoopBackOff 状态,表示容器在重新启动后反复崩溃。
原因分析
如果 Pod 处于 CrashLoopBackOff 状态,说明容器启动存在问题。可能的原因如下:
- 容器进程主动退出
- 系统 OOM
- cgroup OOM
- 健康检查失败
解决方法
容器主动退出
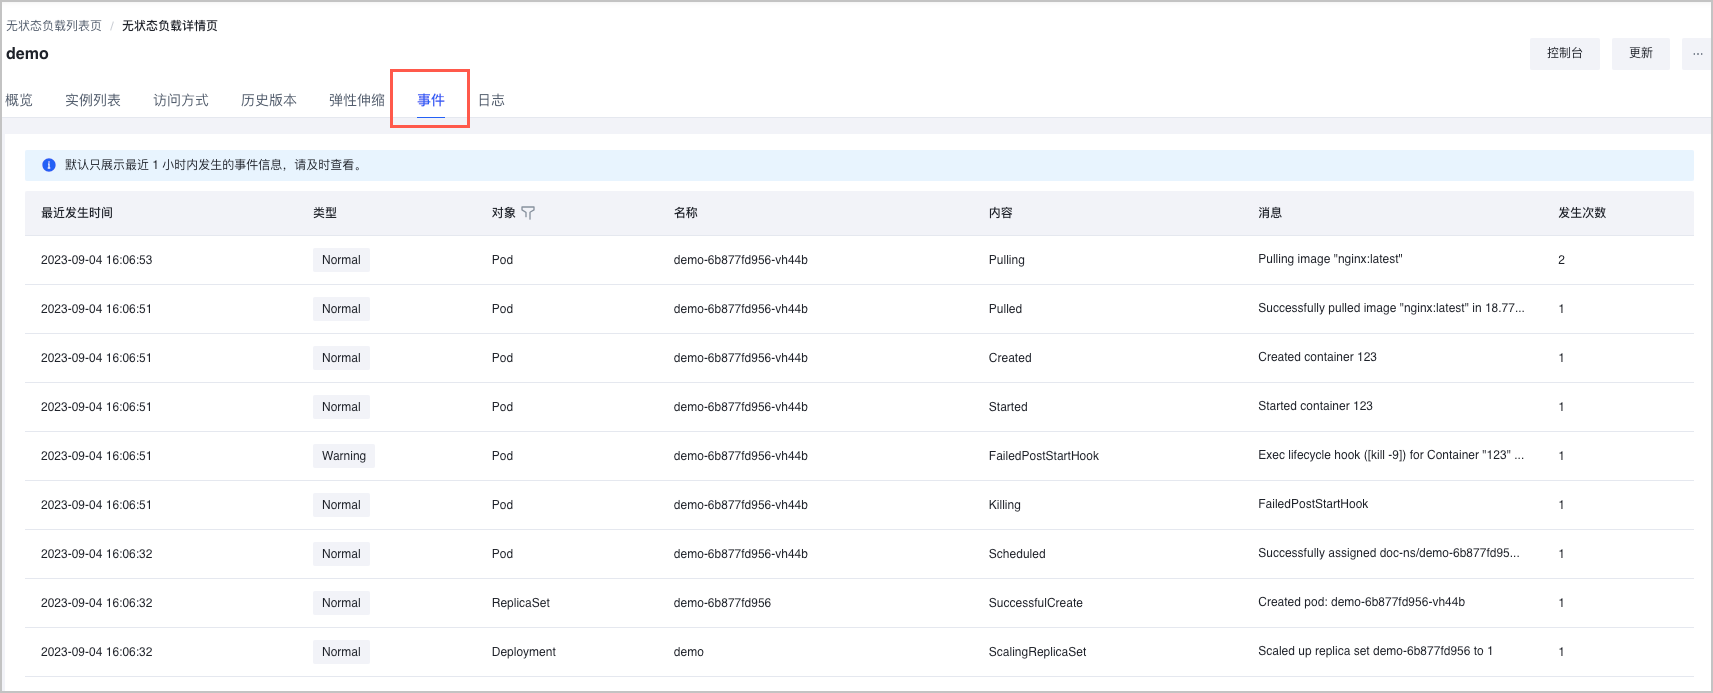
容器进程主动退出时,退出状态码一般为 0~128。根据规定,正常退出时状态码为 0,状态码为 1~127 则说明为程序发生异常导致其主动退出。导致异常的原因可能来自于业务 BUG,也可能是其他原因。您可以查看 Pod 事件信息,确定退出状态码。
- 登录 容器服务控制台。
- 单击左侧导航栏中的 集群。
- 在集群列表页面,单击目标集群。
- 在集群管理页面的左侧导航栏中,单击 工作负载 > 容器组。
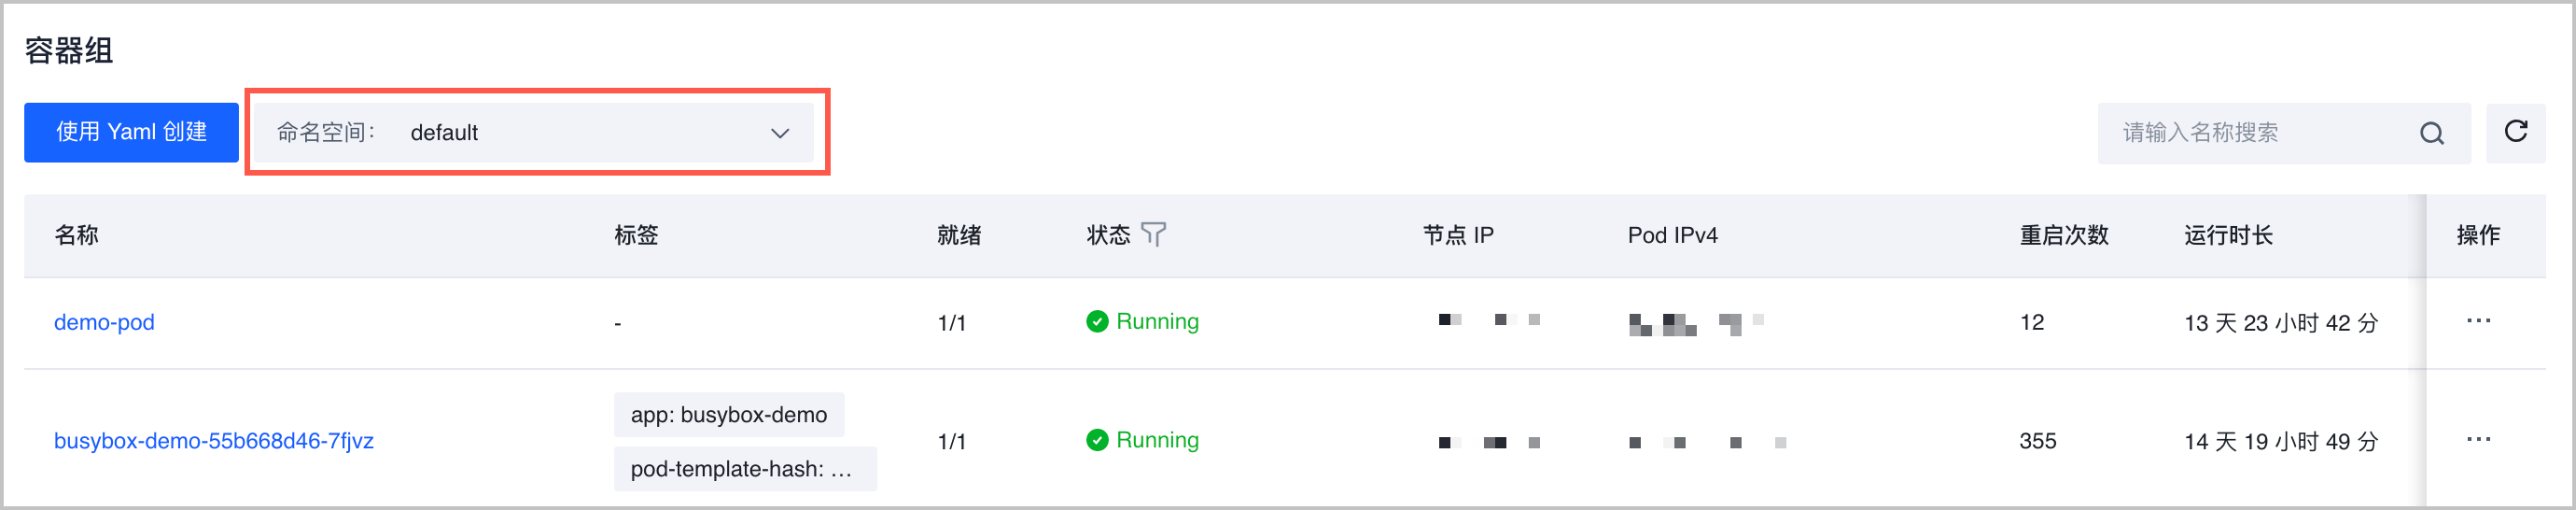
- 在 命名空间 下拉菜单中,选择 Pod 所在命名空间,单击目标 Pod 的名称,进入容器组详情页。
-
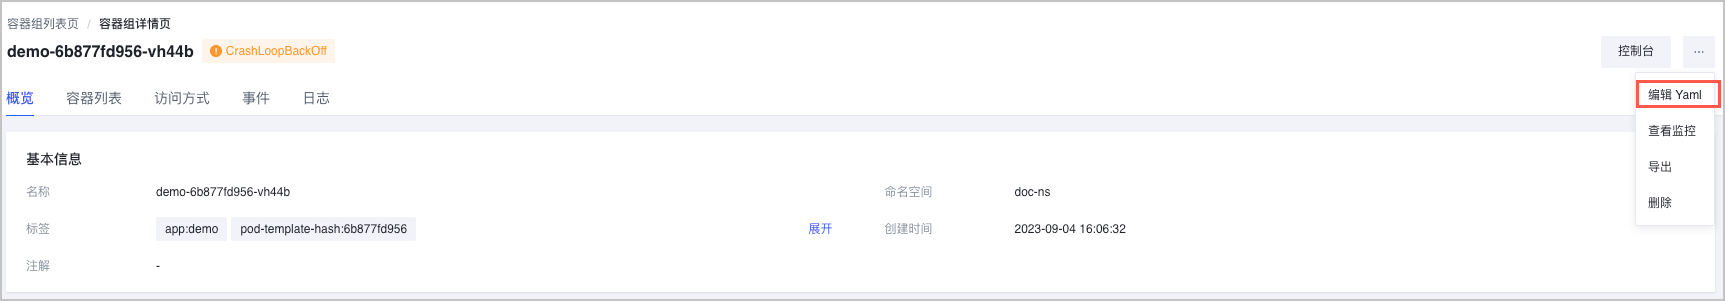
- 选择 概览 页签,在右上方选择 ... > 编辑 Yaml,确认容器启动命令及相关配置是否正确。
-
说明
您也可以通过 kubectl 命令查看容器配置信息,命令为kubectl get pod <pod-name> -n <pod-namespace> -o yaml。
- 选择 事件 页签,查看容器组的事件详情。
-
说明
您也可以通过 kubectl 命令查看 Pod 事件,命令为kubectl describe pod <pod-name> -n <pod-namespace>。
- 返回信息示例如下:
- Containers:demo:Container ID: containerd://83c6dd7f7930e***Image: nginx:latestImage ID: docker.io/library/nginx@sha256:104c7c***Port: <none>Host Port: <none>State: WaitingReason: CrashLoopBackOffLast State: TerminatedReason: CompletedExit Code: 127Started: Mon, 04 Sep 2023 16:28:17 +0800Finished: Mon, 04 Sep 2023 16:28:17 +0800Ready: FalseRestart Count: 9Environment: <none>
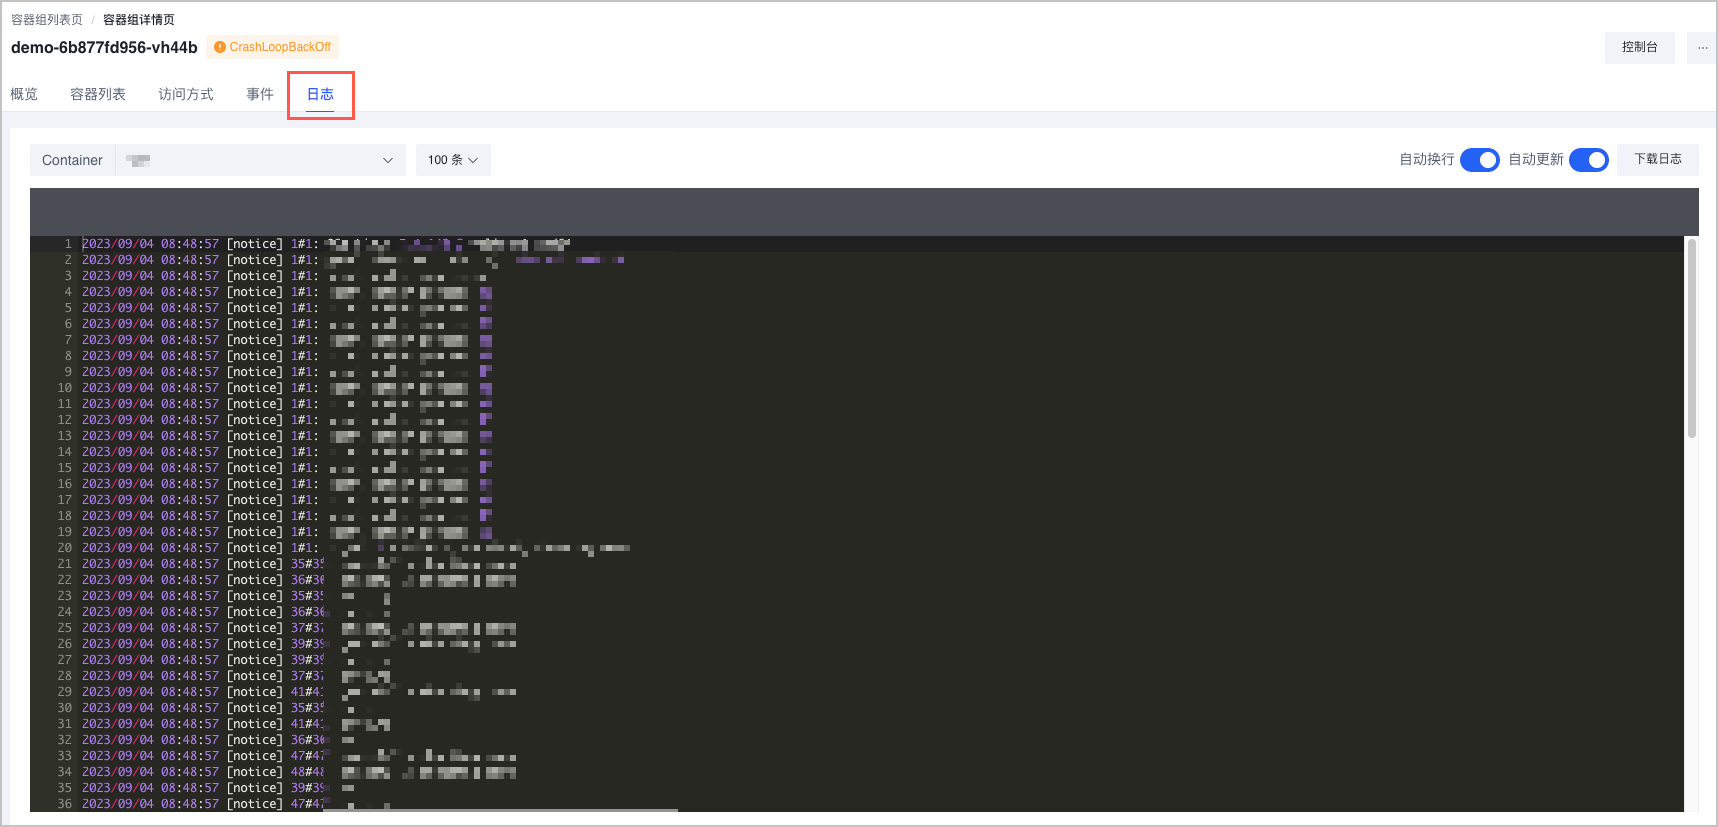
- 选择 日志 页签,查看容器组的日志详情,通过日志内容排查问题。
-
说明
您也可以通过 kubectl 命令查看容器日志信息,命令为kubectl logs <pod-name> -n <pod-namespace> [-c CONTAINER]。
系统 OOM
如果发生系统 OOM,Pod 中容器退出状态码为 137,表示其被 SIGKILL 信号停止,同时内核将会出现以下报错信息。
Out of memory: Kill process ...
该异常通常是由于节点上部署的其他非容器进程(例如 kubelet、kube-proxy 等)消耗了过多的内存,或者是由于 kubelet 的 --kube-reserved 和 --system-reserved 分配的内存太小,没有足够的空间运行其他非容器进程。
解决方法:请根据实际需求对预留空间进行合理的调整。
cgroup OOM
如果是因 cgroup OOM 而停止的进程,可看到 Pod 事件下Reason为OOMKilled,说明容器实际占用的内存已超过 limit,同时内核日志会报Memory cgroup out of memory错误信息。
解决方法:请根据需求调整容器内存的 limit。
健康检查失败
最近更新时间:2026.10.23 10:37:21
这个页面对您有帮助吗?
有用
有用
无用
无用