容器服务
容器服务
容器服务


文档指南
请输入


容器服务 VKE
产品动态
Kubernetes 版本发布记录
组件发布记录
监控组件
DNS 组件
GPU 组件
Sandbox 组件
安全公告
产品公告
历史公告
用户指南
集群
节点池
授权
网络
容器网络
服务(Service)
路由(Ingress)
APIG Ingress
ALB Ingress
自定义转发规则配置示例
CLB Ingress
Nginx Ingress
Gateway API
工作负载
存储
数据管理中心(DMC)
对象存储(TOS)
FSX 访问方式
文件存储(NAS)
FSX 访问方式
弹性文件存储(EFS)
文件存储(vePFS)
FSX 访问方式
vePFS Client 访问方式
NFS 访问方式
大数据文件存储(CloudFS)
弹性伸缩
工作负载弹性伸缩
事件驱动伸缩(KEDA)
组件管理
网络组件
监控组件
DNS 组件
GPU 组件
Sandbox 组件
异构计算
调度管理
可观测性
基础观测
诊断与巡检
最佳实践
网络
可观测性
安全合规
API 参考
集群管理
节点池管理
组件管理
机型镜像管理
云原生观测
巡检诊断
弹性容器实例
附录
开发指南
常见问题
通用 FAQ
集群 FAQ
集群管理
集群升级
节点与节点池 FAQ
授权 FAQ
工作负载 FAQ
服务与路由 FAQ
存储 FAQ
弹性伸缩 FAQ
可观测性 FAQ
配额 FAQ
组件 FAQ
容器镜像 FAQ
AI 云原生
推理套件
Helm 模板 AI 应用
Deepseek 实践
Qwen 实践
最佳实践
MiniMax 模型部署
Qwen 模型部署
弹性容器实例 VCI
最新动态
用户指南
虚拟节点
VKE 集群使用虚拟节点
自建/跨云集群使用虚拟节点
创建 VCI 实例
VCI Agent Sandbox
安全合规
- 文档首页
 容器服务AI 云原生推理套件推理套件概述
 复制全文
 下载 pdf
推理套件概述
 文档反馈
 问问助手
AI 云原生推理套件(ServingKit)依托字节跳动大规模 AI 实践,支持企业在大规模 GPU 集群上高效、稳定、高性价比地运行主流的推理模型。
套件介绍
ServingKit 融合字节跳动大规模 AI 实践与火山方舟海量业务经验,通过容器编排、AI 网关、推理全链路观测及分布式缓存四大核心能力,助力企业在大规模 GPU 集群上,以高性价比实现主流推理模型的高效、稳定运行,全面覆盖文生文、文生图、图生视频等多元推理场景。
套件优势
- 丰富推理框架兼容:深度适配 vLLM/SGLang/Dynamo 等主流推理引擎和框架,率先支持 PD(Prefill-Decode)分离架构,提升推理效率。突破用户自建 ComfyUI 的算力瓶颈,解决算力贵、利用率低的问题,以更优性价比更好地利用算力。
- 模型极速启动:基于 P2P 技术和模型加载工具,实现百台 GPU 分钟级部署 DeepSeek-R1-671B 完整模型,极大缩短了模型部署时间。
- 推理性能增强:针对主流推理引擎和 GPU 卡型进行算子优化等性能优化手段。在文本生成场景实现 DeepSeek-R1 模型推理吞吐提升 1~3 倍;在生视频场景下端到端耗时缩短 100 倍。
- 全链路推理观测:推理全链路透明埋点,全方位覆盖 AI 推理引擎观测指标,推理问题分钟级精准定位。
名词解释
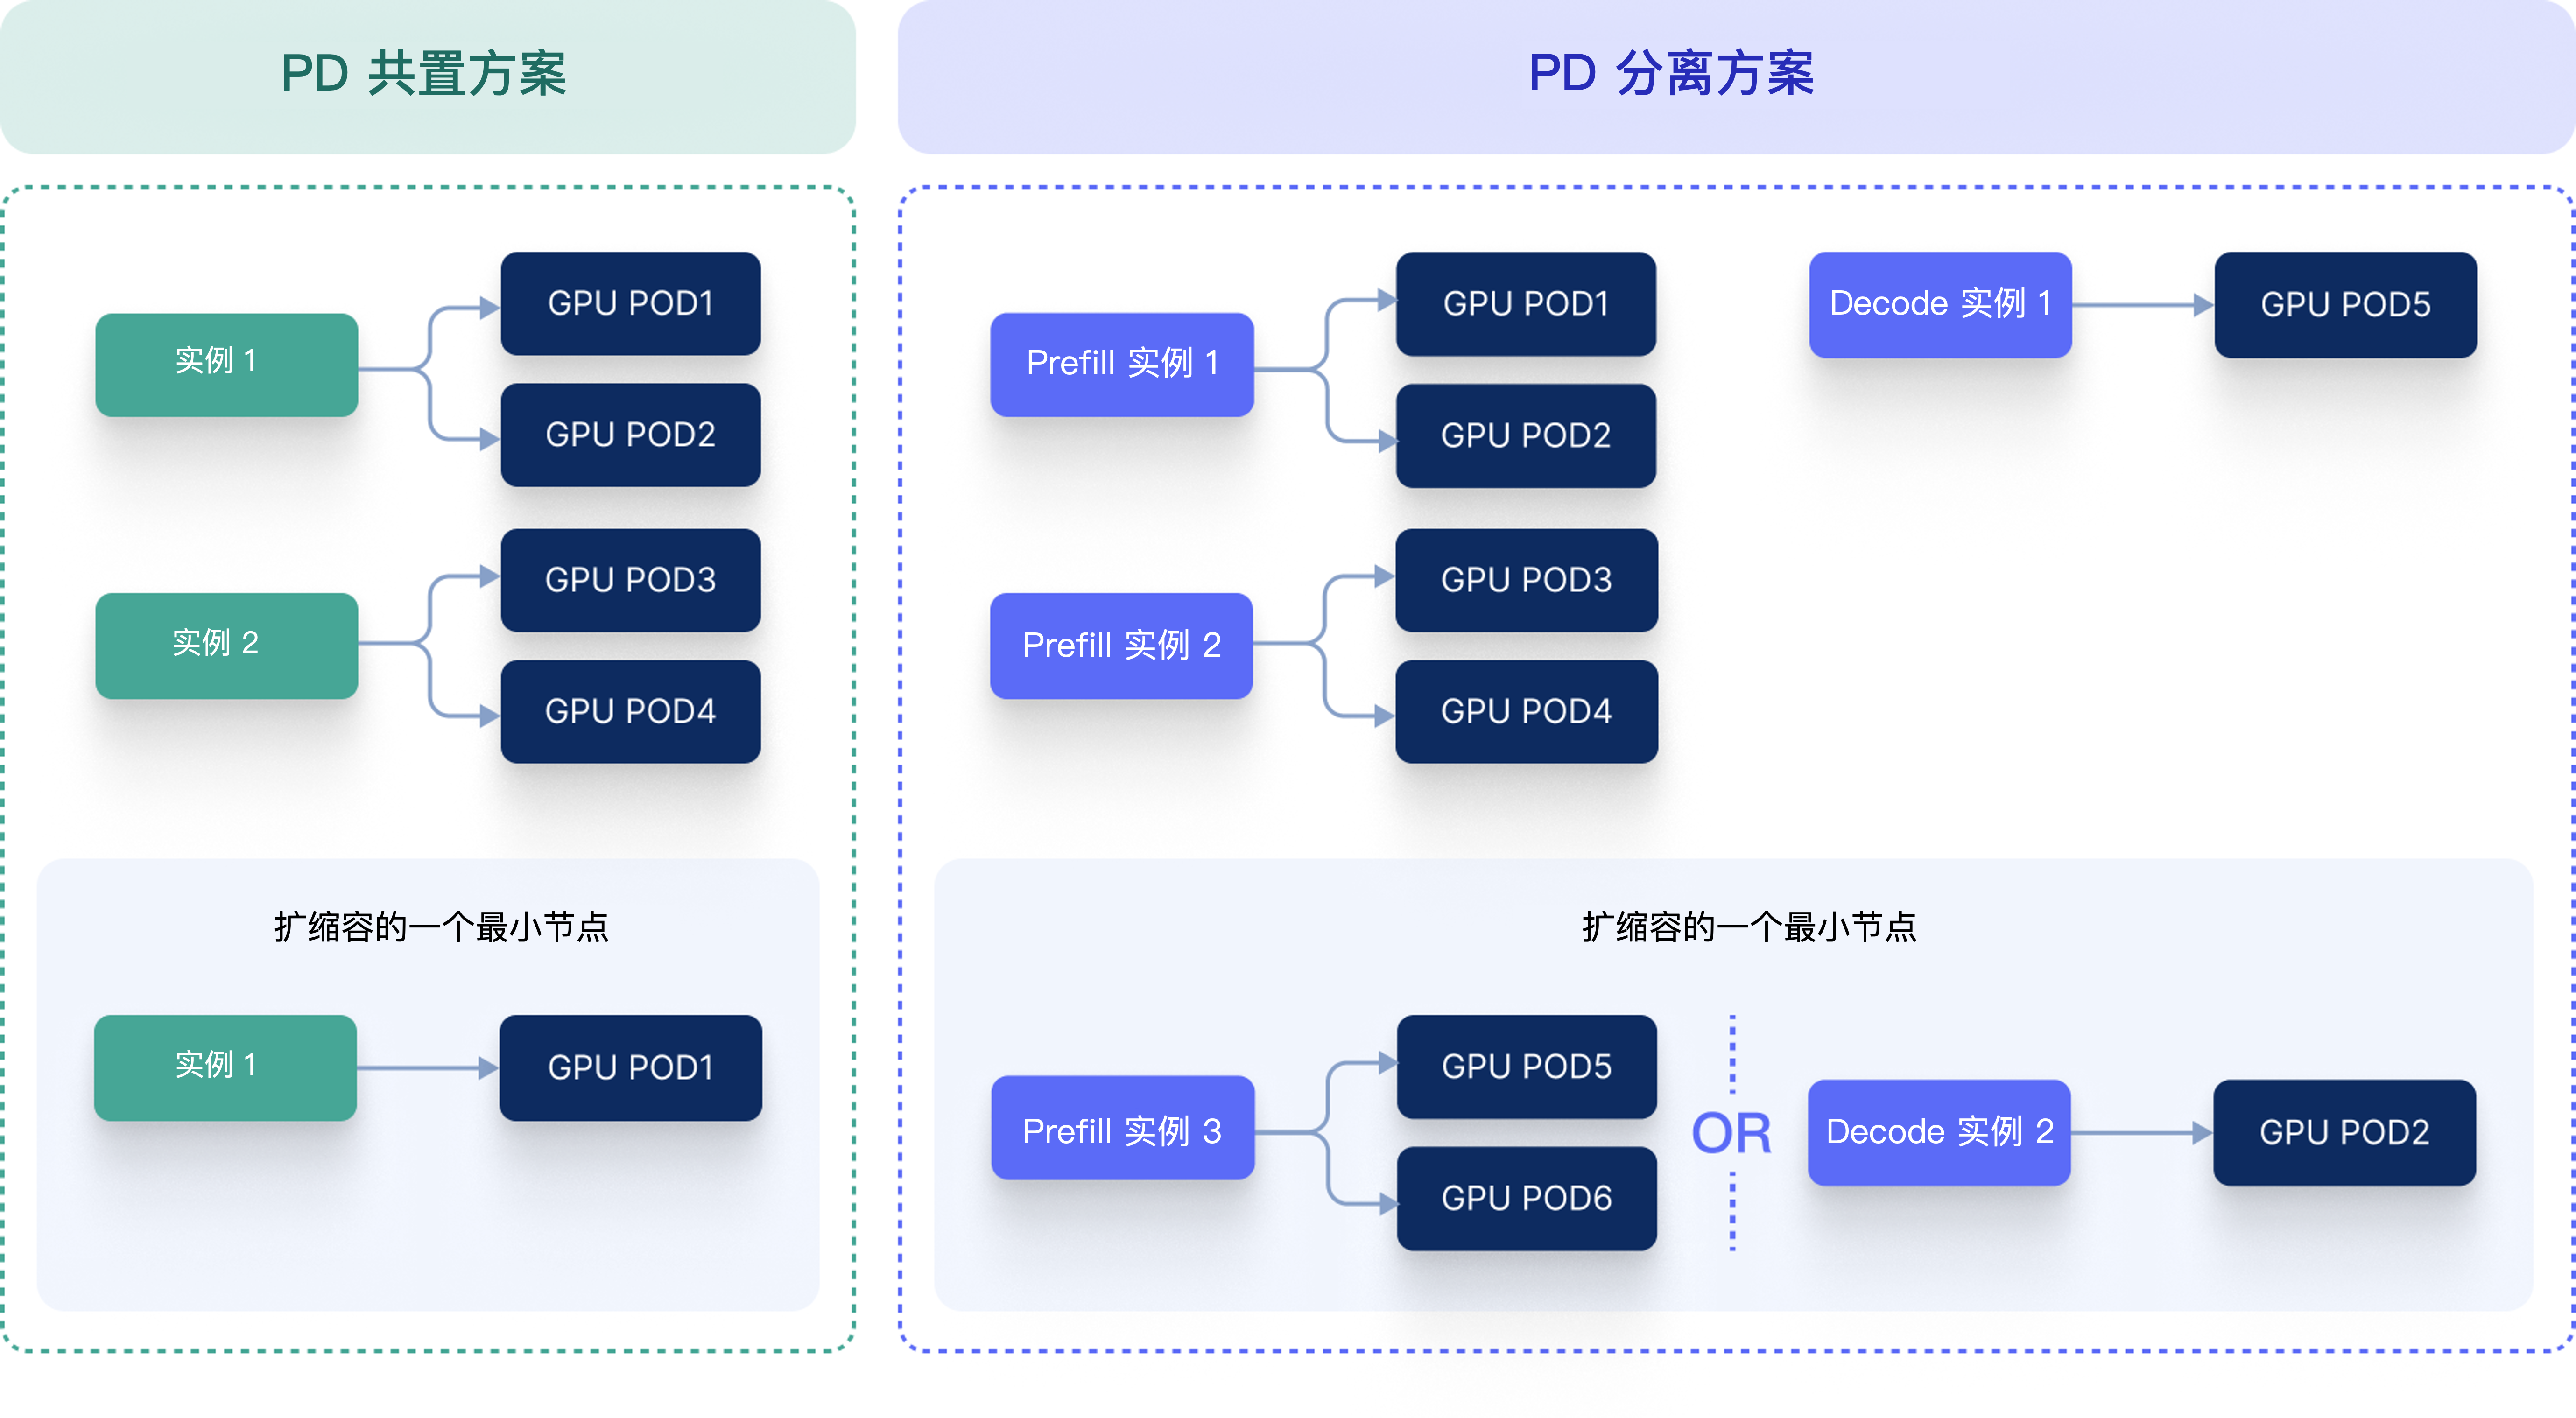
PD 分离与 PD 共置
- PD 分离:将推理过程分为两阶段,部署于不同硬件资源上,以提高资源利用率和推理性能。
- Prefill(预填充):计算密集型阶段。
- Decode(解码):显存密集型阶段。
- PD 共置:即非 PD 分离架构,是 Prefill 和 Decode 两个阶段在同一组 GPU 上混合部署,没有明确区分 Prefill 和 Decode 的服务集群。
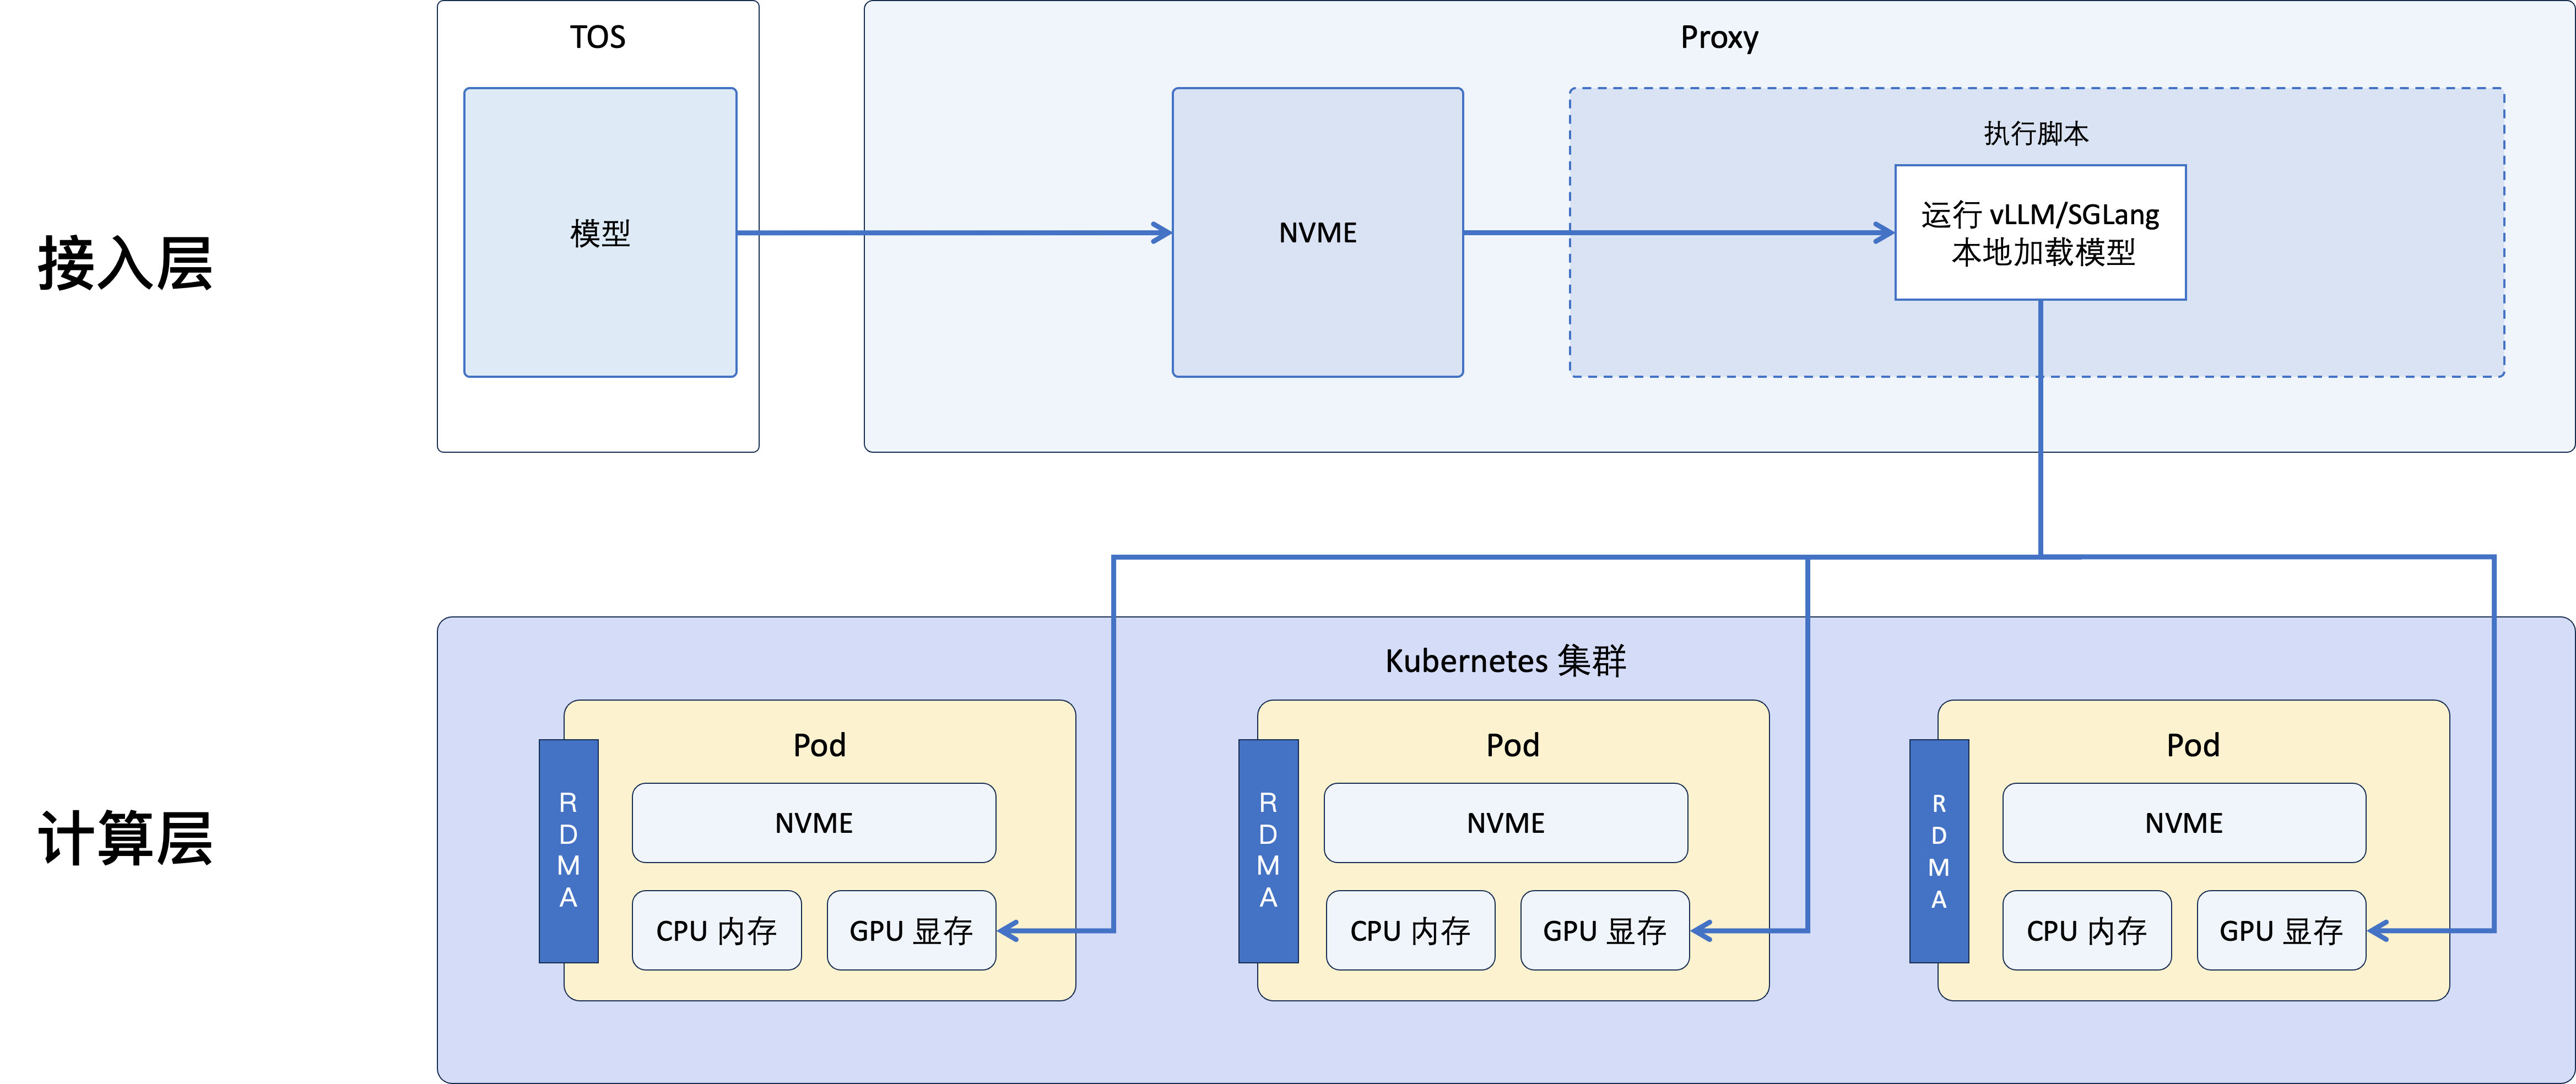
Oniond 模型加载加速
Oniond 是模型下载器,可以实现免 API 访问密钥(AKSK)进行模型快速分发。
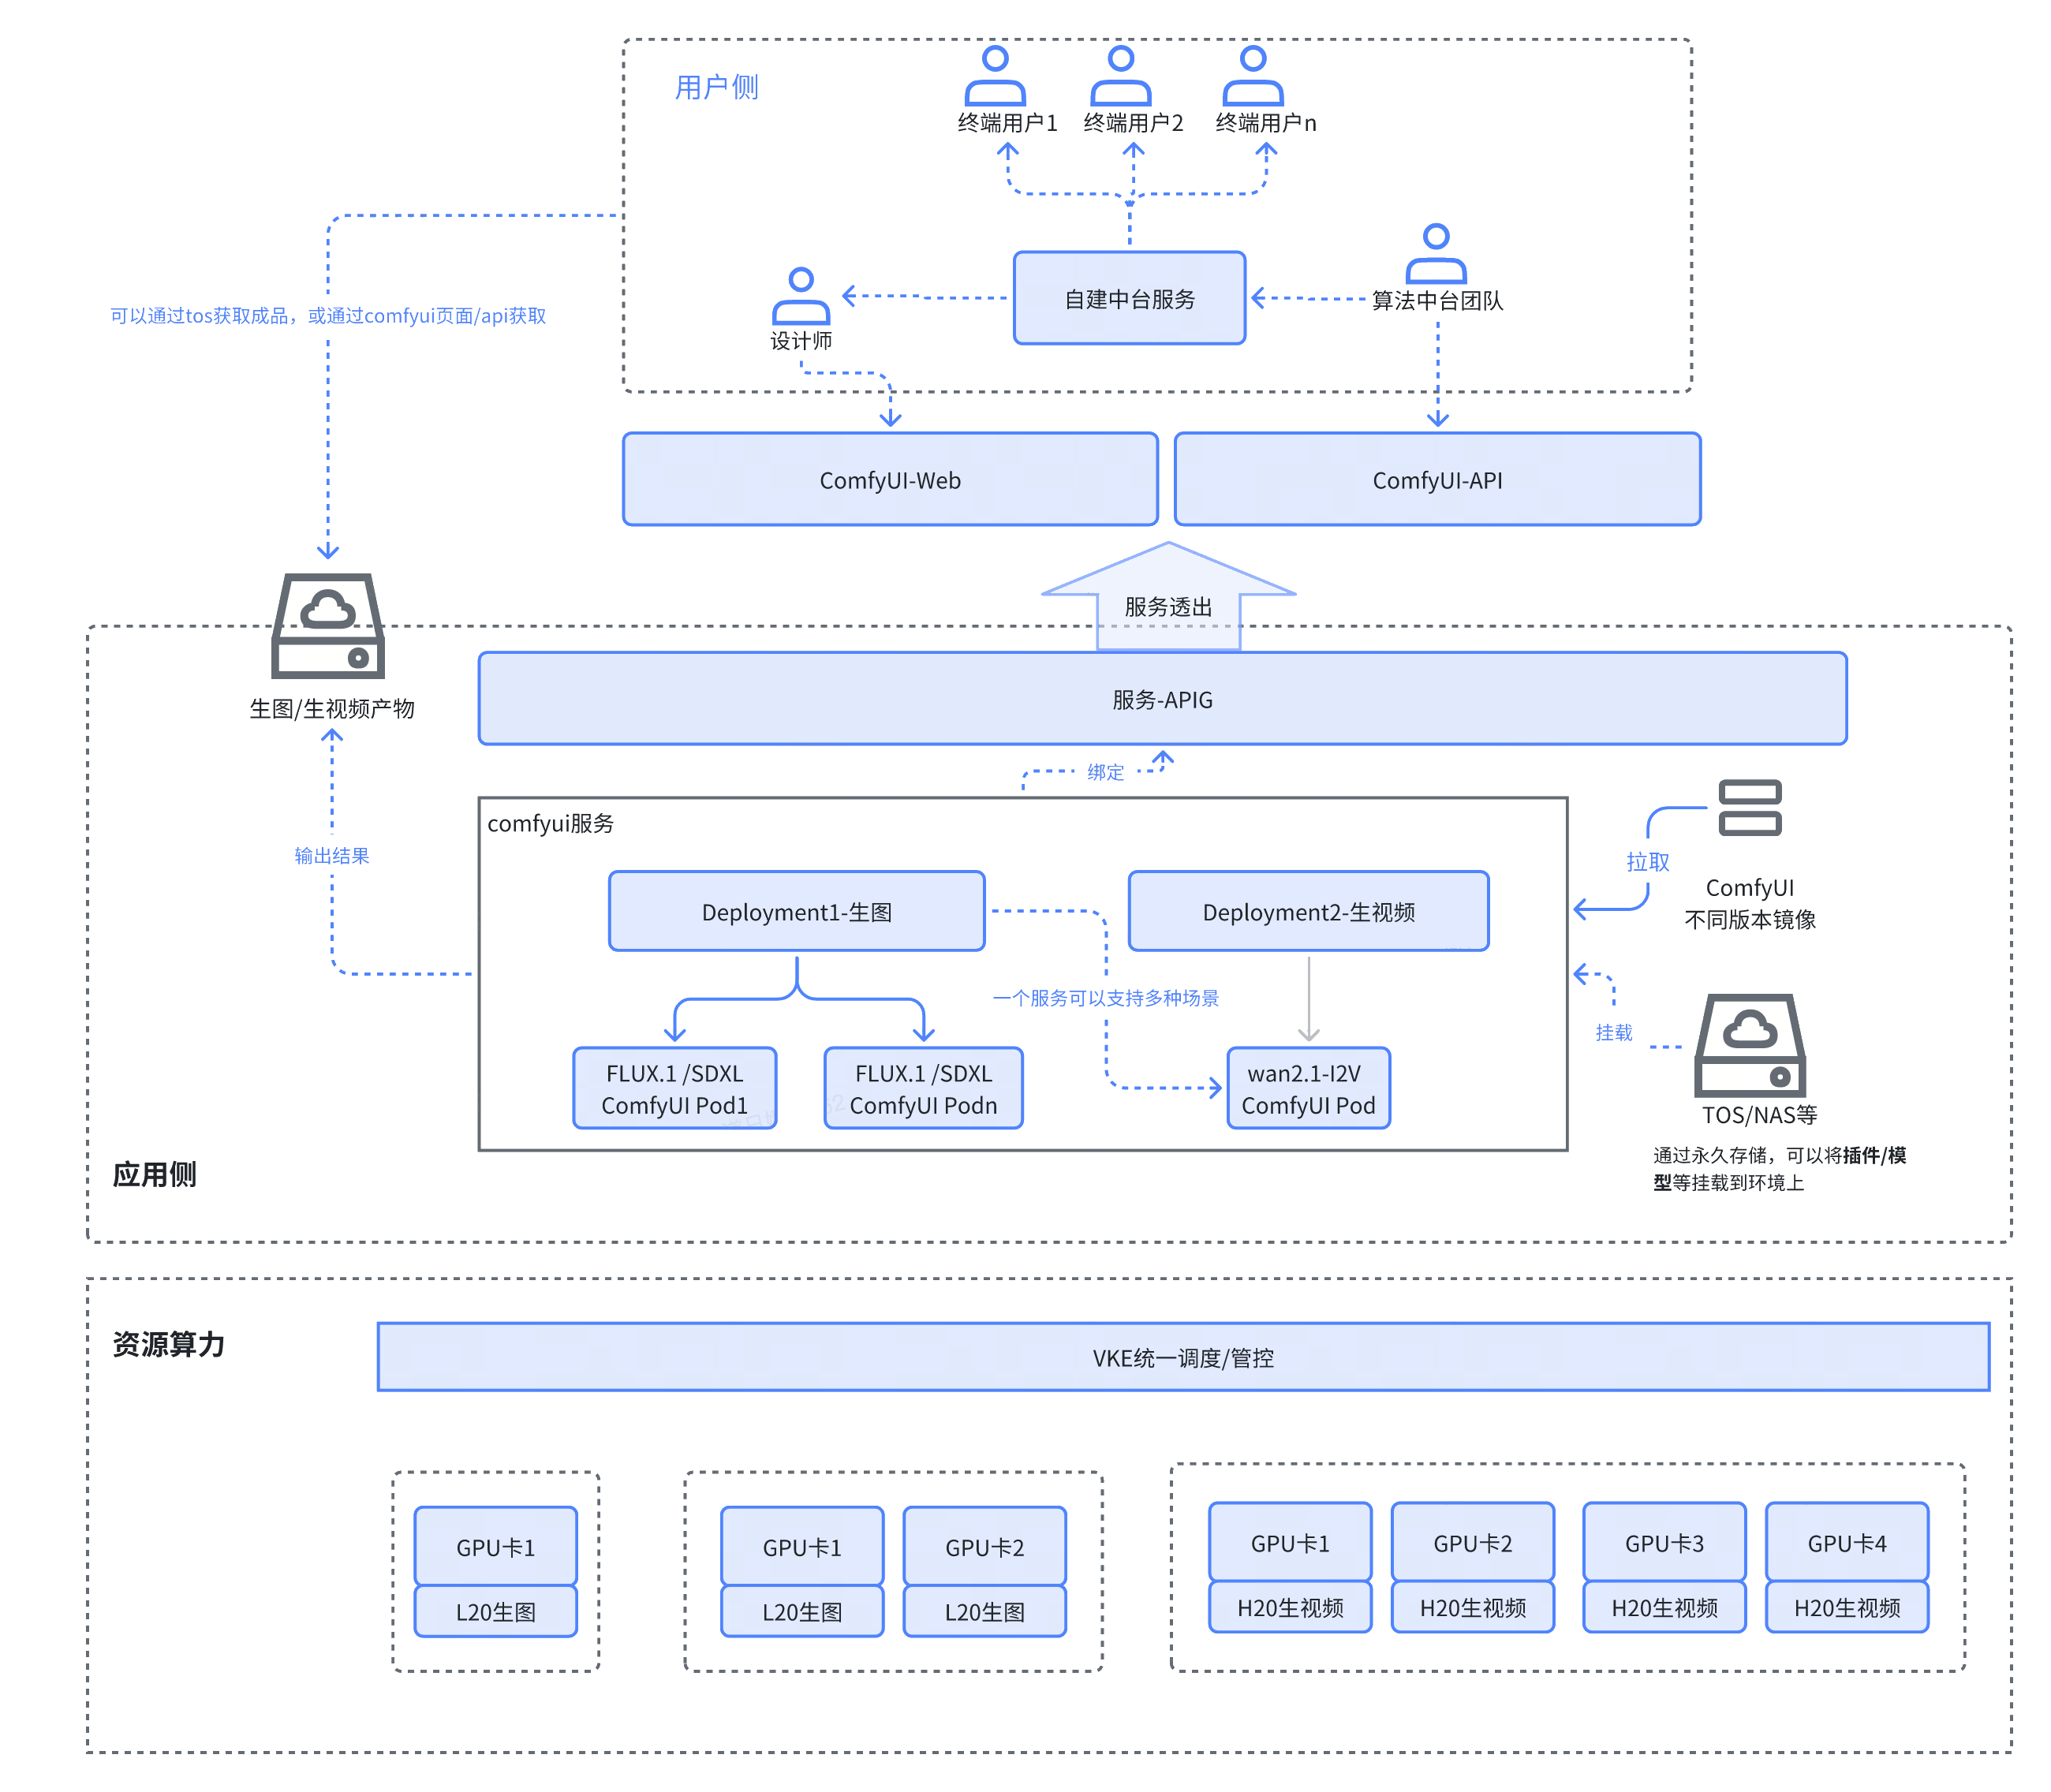
ComfyUI 插件火山引擎增强版
ComfyUI 作为 AIGC 领域主流开源工具,通过集成 ServingKit 插件,在不影响其原生使用的前提下,为 FLUX.1 、FLUX-kontext、Wan2.2 等主流模型提供并行推理、量化、Cache 等推理提速能力,可使图片生成时间缩短 2 倍以上,视频总生成时长时间缩短 100 倍。
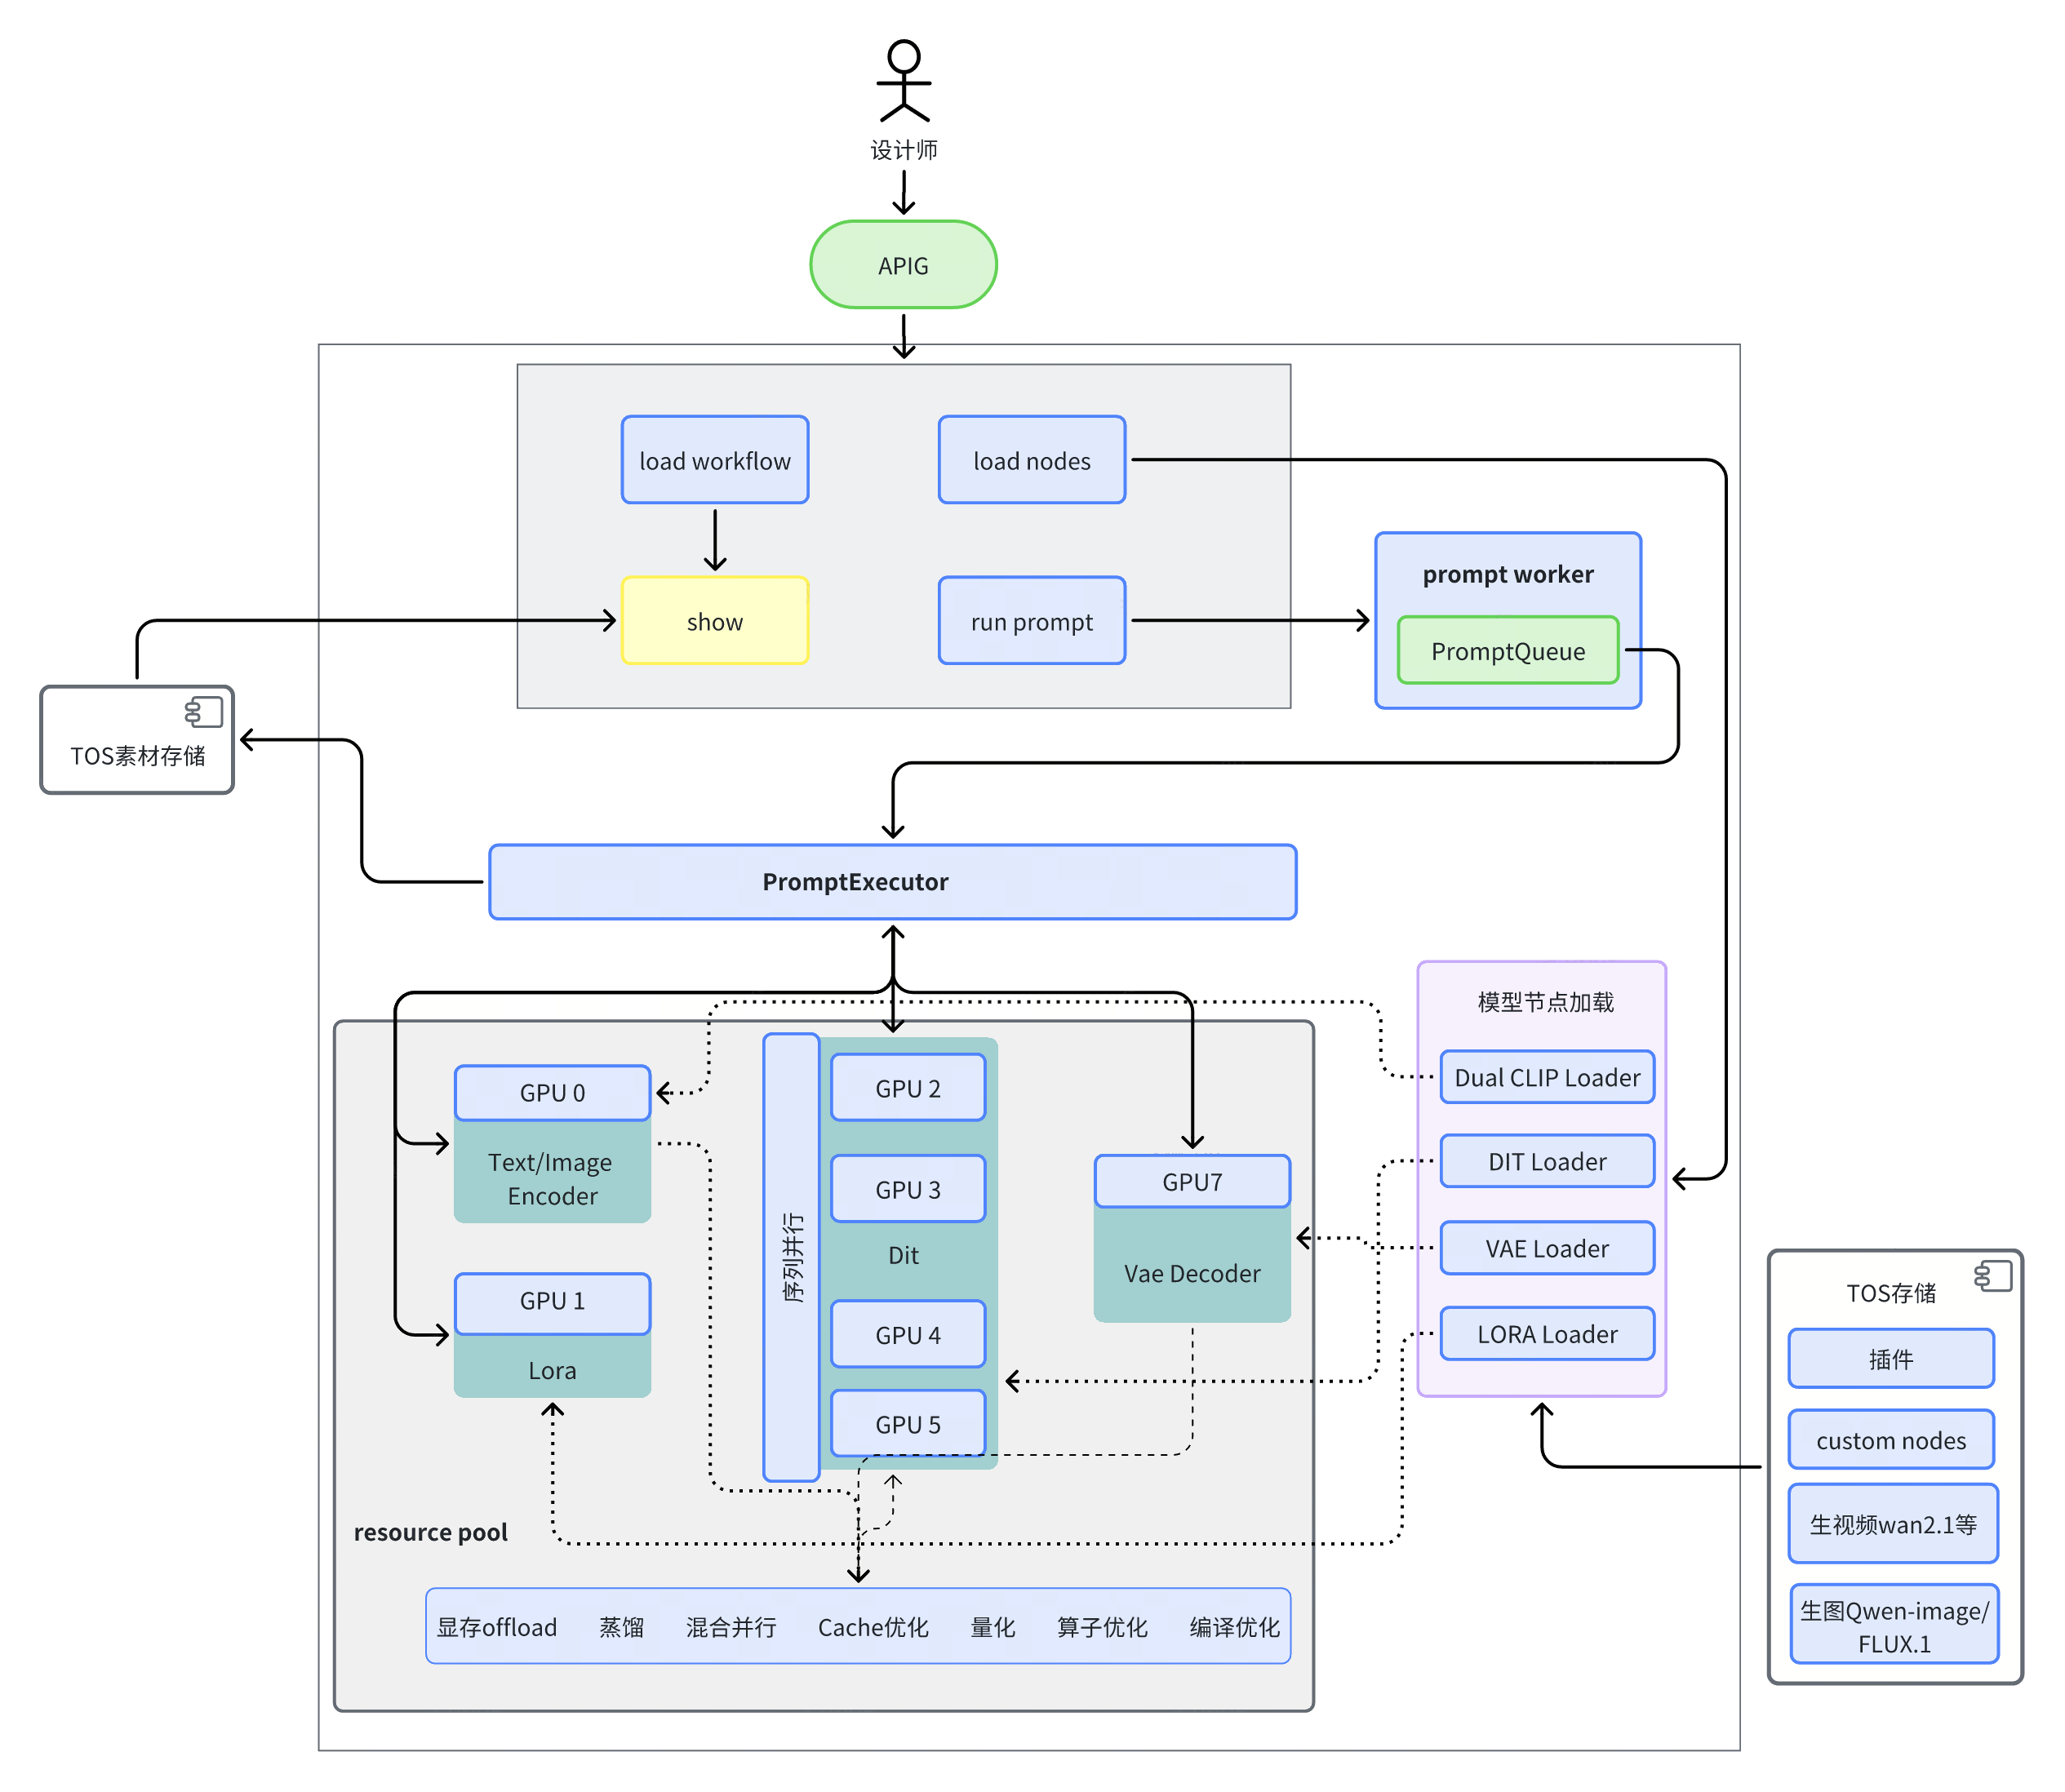
Openvefuser 插件
火山引擎自研 Openvefuser 插件,轻量化集成 ComfyUI 服务,优化范围覆盖编译、算子、Cache、量化、并行、Offload、蒸馏等各项大模型技术范围。
KV Cache
KV Cache 是大语言模型推理等场景一种用于存储和快速检索键值对数据的缓存机制。ServingKit 基于 弹性极速缓存(EIC)为 AI 推理应用提供高性能分布式 KV Cache 缓存服务。
最近更新时间:2026.10.19 11:29:10
这个页面对您有帮助吗?
有用
有用
无用
无用