容器服务
容器服务


文档指南

请输入


- 文档首页
 容器服务容器服务 VKE用户指南大规模集群管理大规模集群版本和配置
 复制全文
 下载 pdf
大规模集群版本和配置
 文档反馈
 问问助手
在构建大规模集群的生产环境时,请参考本文完成集群版本选择与组件配置。本文涵盖 Kubernetes 版本选型、控制面配置、数据面优化以及容器网络和 DNS 配置等关键内容。
版本选择
当集群中的节点数量超过 500 时,建议使用的集群 Kubernetes 版本和集群中重要组件的版本如下所示。
分类 | 名称 | 推荐版本 | 推荐理由 |
Kubernetes 版本 | Kubernetes 版本 | ≥ 1.34 | 缓存一致性读和流式 List 响应特性 GA,对于包含大量资源的 List 请求场景,可有效降低 kube-apiserver 内存占用并提升系统稳定性。更多说明,请参见 Kubernetes 版本发布记录。 |
重要组件版本 | vpc-cni | ≥ v1.9.3 |
|
| vpc-cni-controlplane | ≥ v1.4.5 |
|
| core-dns | ≥ 1.10.1-vke.200 | 优化了默认 CPU 和内存资源的请求和上限。 |
| csi-ebs | ≥ 1.3.1 | client-go 支持流式 List 响应。 |
| csi-nas | ≥ v1.3.2 | client-go 支持流式 List 响应。 |
| csi-tos | 建议使用 csi-fsx 替代 csi-tos | csi-tos 已经进入下线阶段,因此建议使用 csi-fsx 替代 csi-tos。 |
| csi-vepfs | ≥ v0.17.0 | client-go 支持流式 List 响应。 |
| fsx | csi-fsx ≥ v0.7.0 fsx-service ≥ v0.10.2 | client-go 支持流式 List 响应。 |
控制面配置
数据面配置
网络规划
分类 | 说明 | 配置建议 | 推荐值 |
容器网络模式 | 有两种容器网络模型:
| 容器网络模式一旦选择无法更改,为保证集群扩展性,请使用 VPC-CNI 的容器网络模式。 | 无 |
集群网段规划 | 在大规模 Kubernetes 集群中,容器网络的 IP 地址网段的大小直接决定集群可承载的节点数量和 Pod 数量上限。 |
| 无 |
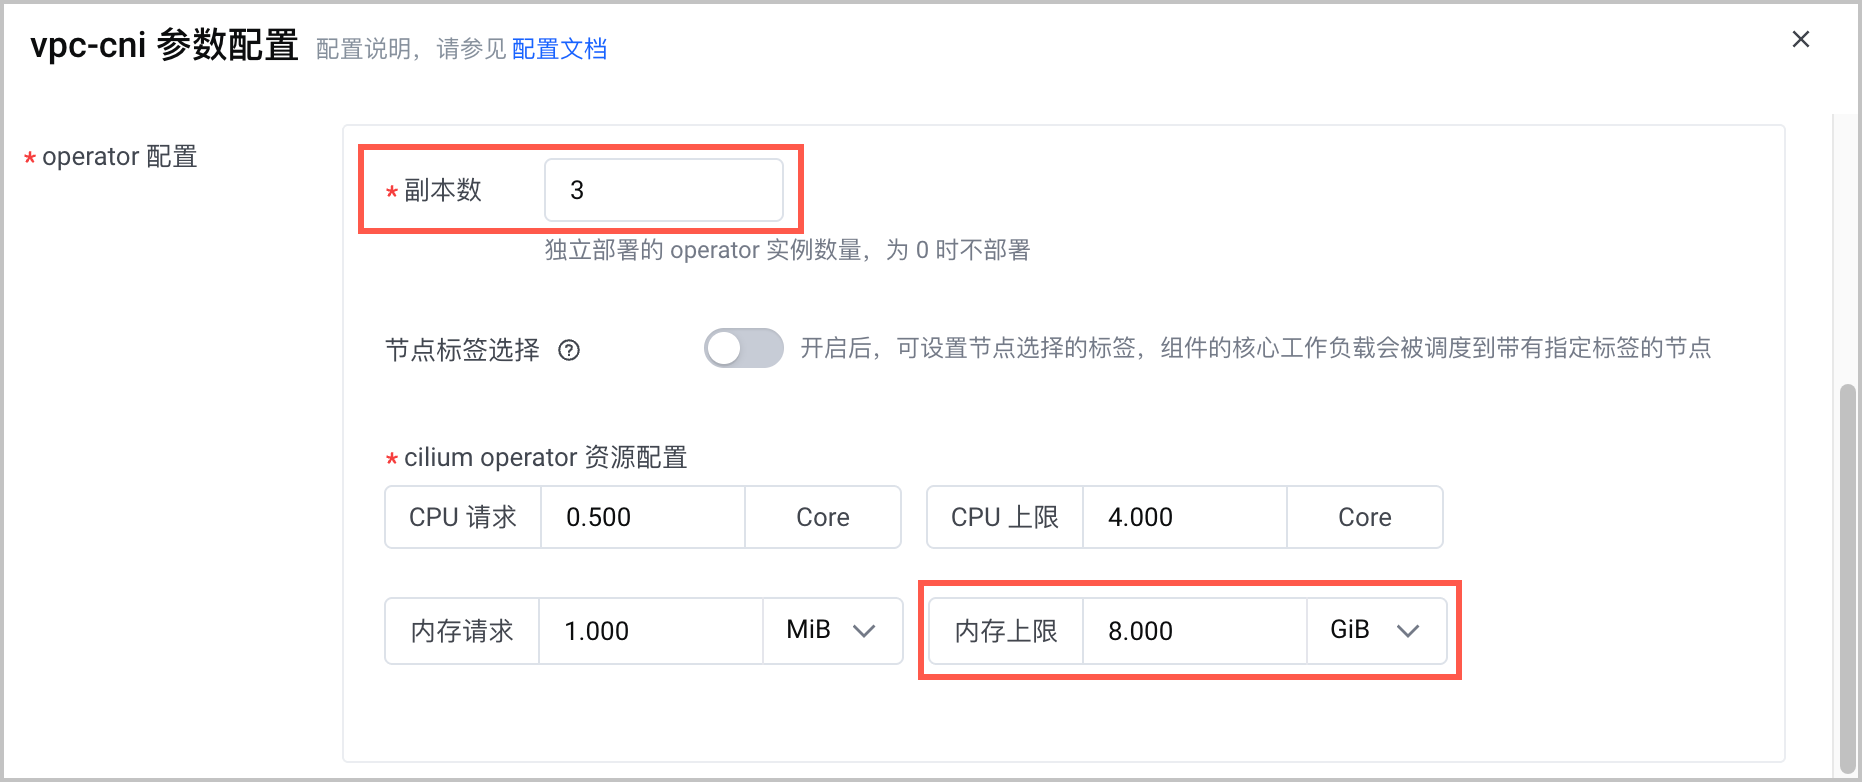
Cilium Operator 配置 | Cilium Operator 会周期性回收 CiliumIdentity,CiliumIdentity 最大上限为 65535。在未独立部署的情况下,Cilium Operator 集成在 Cello DaemonSet 中,每个节点一个副本。当节点数量增多时,所有副本通过 Lease 机制进行 Leader Election,会产生大量对 kube-apiserver 的访问。对于大规模集群,应当将 Cilium Operator 从 DaemonSet 中解耦,采用独立 Deployment 部署并配置合理的副本数。 |
|
 |
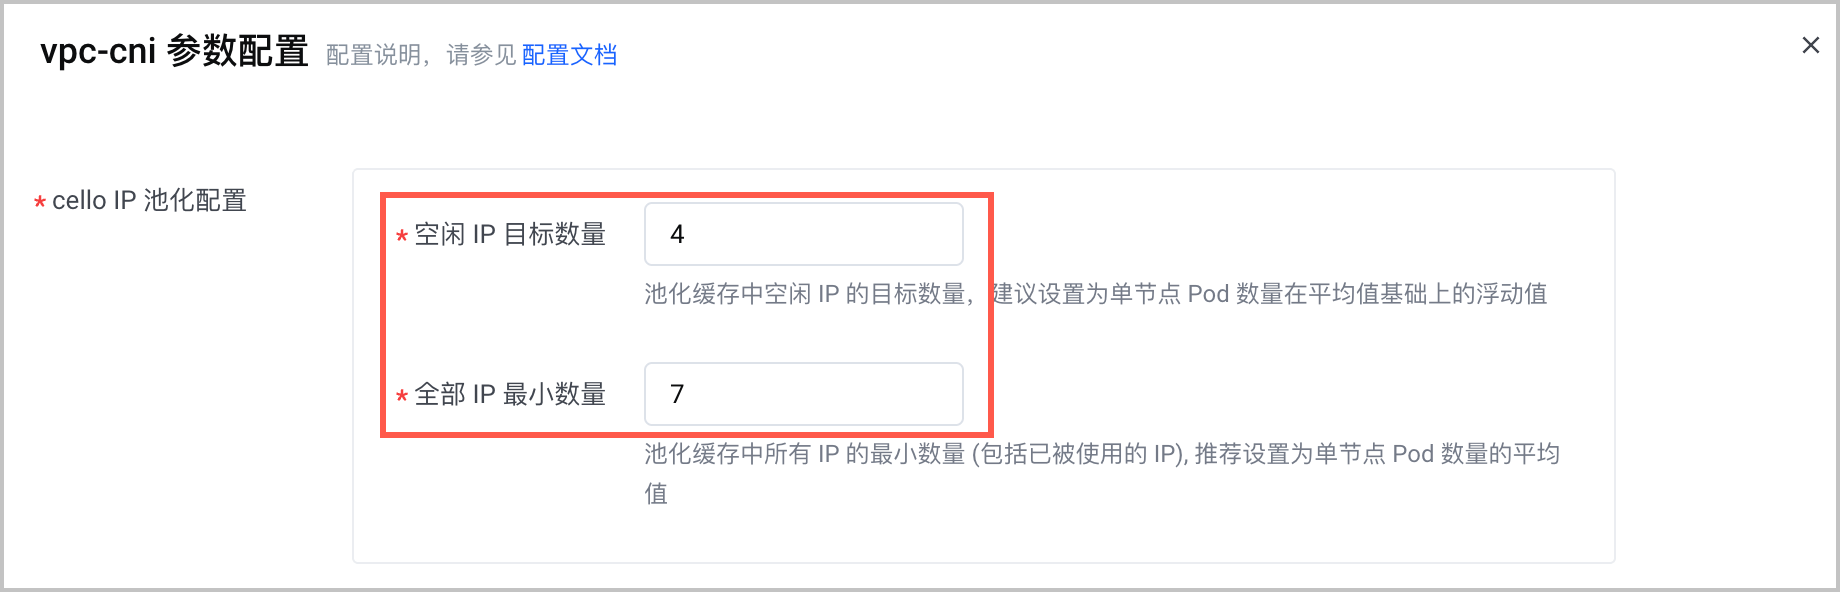
VPC-CNI IP 池化设置 | Cello 通过池化机制缓存 VPC ENI 和 IP 资源来提升 Pod 拉起速度。在默认池化参数下(如poolTarget=3),800 个节点的集群会缓存约 2400 个空闲 IP。对于大规模集群或子网容量有限的场景,需要根据实际需求评估,并适当调大或调小池化参数。 |
|  |
NetworkPolicy 限制 | 集群若启用了 NetworkPolicy 来控制 Pod 之间的访问,则每个节点上的 Cello 组件会 ListWatch 集群内所有的 CiliumEndpoints,在节点规模超过 1000 时,会给 APIServer 带来访问压力。 |
| 无 |
Service 和 NetworkPolicy 数量 | VPC-CNI 模型集群中,Service 和 NetworkPolicy 均基于 Cilium 的 BPF Map 机制实现,其数量与 BPF Map 大小有关。每个 Service 对应的 Pod 会在 Backend Map 中生成唯一条目;每个被 NetworkPolicy 选中的 Pod 对应一个 Policy Map,每条 NetworkPolicy 规则都会在该 Map 中生成一条记录。随着集群中 Service、Pod 规则和 NetworkPolicy 规则数量的增长,相关 BPF Map 可能触及容量上限,导致 Service 或 NetworkPolicy 规则无法生效,Service 状态异常、访问异常以及访问控制不符合预期。 |
| 无 |
集群 DNS 规划
最近更新时间:2026.05.15 17:34:21
这个页面对您有帮助吗?
有用
有用
无用
无用