容器服务
容器服务


文档指南

请输入


- 文档首页
 容器服务容器服务 VKE用户指南网络域名解析(DNS)CoreDNS 故障排查
 复制全文
 下载 pdf
CoreDNS 故障排查
 文档反馈
 问问助手
CoreDNS 是容器服务集群内提供 DNS 解析能力的核心组件,适用于 Pod 访问 Service、外部域名以及集群内服务发现等场景。本文介绍 CoreDNS 常见故障的判断方法与排查流程,包括 DNS 配置检查、组件状态检查、连通性验证、日志分析和网络抓包等内容。
背景信息
故障排查思路
CoreDNS 故障排查的难点通常不在于排查命令的使用,而在于未先对问题进行有效分类。如果一开始就把“解析失败”统一认为是 CoreDNS 故障,后续很容易在无关方向上反复排查,甚至直接进入扩容、重启等低效操作。
开始排查前,建议先确认如下几个问题:
- 当前问题属于“域名不存在”、“域名配置错误”、“请求没有成功到达 DNS 服务器”,还是“请求已发出但响应超时”。
- 受影响的是集群内域名、集群外域名,还是某一类特定域名。
- 故障是否能够稳定复现,还是只在业务高峰、应用发布、CoreDNS 重启、节点扩缩容等特定时段偶发。
实际定位时,建议按照链路逐层缩小范围,沿着“业务 Pod > NodeLocal DNS 或 kube-dns > CoreDNS > 上游 DNS”的路径逐层验证,确认故障产生的链路位置,再结合系统提供的 DNS 服务观测、节点诊断等功能,进一步判断问题是否已经超出 CoreDNS 本身,而是落在节点网络、上游 DNS、Service 转发或客户端配置等环节。
快速故障判断
故障现象 | 常见报错 | 可能原因 |
域名不存在 | NXDOMAIN、no such host、Name or service not known |
|
无法连到 DNS 服务器 | i/o timeout、no servers could be reached |
|
仅高峰期或偶发超时 | 延迟高、少量超时、发布期抖动 |
|
仅外部域名异常 | 集群内 Service 正常,公网/内网域名失败 |
|
仅集群内域名异常 | kubernetes.default等内部域名失败 | CoreDNS、Service/Endpoints、API 访问、Pod DNS 配置问题。 |
典型故障场景
容量与请求放大
如果问题仅在业务高峰期出现,建议优先排查是否因为客户端侧行为导致 DNS 请求被显著放大。典型场景和说明,如下表所示。
典型故障场景 | 场景说明 |
外部域名未使用完整域名,导致触发 search 拼接。 | Kubernetes 的 Pod 内部的/etc/resolv.conf中会配置多个 search 域(例如default.svc.cluster.local、svc.cluster.local、cluster.local 等)。如果业务代码中的域名未携带完整后缀(例如只写了login而非 login.example.com),系统会把该域名当作"集群内服务域名",依次拼上每个 search 域去尝试。 例如: 某业务 Pod 需要访问外部站点,但其代码里写的域名为login。因此系统会先查login.default.svc.cluster.local、login.svc.cluster.local等域名,全部失败后才进入下一步。在高并发下,单次域名解析可能演变为多次查询,请求量显著放大。 |
默认ndots:5导致大量无效查询。 | ndots的含义是:域名中"点"的数量小于该值时,优先按照“相对名 + search 域拼接”的方式查询,而不是直接查绝对域名。Kubernetes 中的ndots默认值为 5,意味着像www.example.com(只有 2 个点)这种外部域名,也会被先当成相对名处理,触发一串注定失败的拼接查询。 例如: 某业务 Pod 需要频繁请求www.example.com。在ndots:5规则下,会依次查询 www.example.com.default.svc.cluster.local、www.example.com.svc.cluster.local 等域名,全部返回NXDOMAIN,最后才查真正的www.example.com。本来 1 次查询,变成 4~5 次。 |
短连接过多,每次请求都触发解析。 | 如果业务未复用连接(没有连接池),并且应用内或运行时没有有效的 DNS 缓存,就会出现“每次请求都要重新做一次 DNS 解析”的模式。高并发下,业务 QPS 近似等于 DNS QPS,使 CoreDNS 的处理压力迅速上升,并可能达到容量上限。 例如: 某业务 Pod 每秒 5 万次请求访问payment.example.com,每次都新建连接且无缓存。结果每秒产生约 5 万次 DNS 查询,导致 CoreDNS 在高峰期承受较高处理压力。 |
某些基础镜像/Resolver 行为差异,额外放大 DNS 请求。 | 不同镜像使用的解析库(glibc、musl、语言运行时自带 resolver)在缓存策略、并发合并(singleflight)、IPv4/IPv6 查询顺序(A/AAAA)、超时重试等细节上存在差异。同样的业务代码,换了基础镜像或运行时版本,可能导致 DNS 查询量显著增加。 例如: 旧镜像的 resolver 会对同一时刻的大量并发解析做合并,新镜像不合并。这将导致 1 万个并发请求直接进行 1 万次 DNS 查询。或者 resolver 默认先查 AAAA 再查 A,而业务只用 IPv4,每次解析等于 2 次查询。 |
NodeLocal DNS 未启用,或启用了但业务没有真正指向本地缓存。 | NodeLocal DNS 的功能是在每个节点本地提供 DNS 缓存,允许 Pod 的查询优先命中本地,减少对 CoreDNS 的集中压力。但如果未在集群中正确部署 NodeLocal DNS,或正确部署了但 Pod 的 nameserver 仍指向 CoreDNS 的 ClusterIP,流量没有被正确重定向到本地地址。 例如: 在集群中部署了 NodeLocal DNS,但某些业务 Pod 的/etc/resolv.conf 配置中nameserver还是 CoreDNS Service IP。这将导致 DNS 请求无法命中本地缓存,对应的请求仍然发送给 CoreDNS,本地缓存机制无法发挥预期作用。 |
- core-dns/node-local-dns 请求量。
- 响应延迟和错误码。
- 缓存命中情况。
- 上游转发延迟和失败率。
注意
在高 QPS 或抖动明显的场景下,建议优先评估 NodeLocal DNS 的适用性与实现效果;若在此基础上 CoreDNS 仍表现出明确的容量瓶颈,再基于监控结果对 CoreDNS 进行扩容与参数优化。
IPVS + UDP 偶发超时
DNS 查询通常使用 UDP 协议。在 kube-proxy 使用 IPVS 模式时,Service 到后端 Pod 的转发依赖 IPVS 维护的“UDP 会话/调度状态”。因此,只要会话状态还在,后续一段时间内的同类报文就可能继续命中同一个后端,而不是每次都重新选择健康后端。
当 CoreDNS Pod 退出(CoreDNS 滚动升级、重启、缩容、节点扩缩容)时,Kubernetes 会更新 Endpoints,kube-proxy 也会刷新 IPVS 后端列表,但这个过程对所有节点、所有会话状态并非瞬时一致。在更新完成之前,之前已建立的 UDP 会话状态可能仍然指向刚刚退出的 CoreDNS Pod。导致在窗口期内,少量请求会被转发到不可达的后端,表现为 DNS 查询偶发超时。
针对该类问题,建议处理方式如下:
- 优先启用 NodeLocal DNS,将解析缓存和转发下沉到节点本地,减少业务 Pod 直接穿过 CoreDNS Service(IPVS 负载均衡点)的比例。业务 Pod 的请求先命中本机 NodeLocal 缓存,未命中时再由 NodeLocal 上行访问 CoreDNS。
- 评估调整 kube-proxy 的 IPVS UDP 会话保持超时时间。 适当缩短 UDP 会话超时,可以收窄“命中已退出后端”的窗口期。
CoreDNS 请求链路风险图
一次普通的集群内 DNS 查询,通常会从业务 Pod 发出 UDP / TCP 53 请求,经过客户端所在节点的策略、Service 转发和底层网络,再进入承载 CoreDNS Pod 的 ECS / VCI 实例,最终到达 CoreDNS 进程。排查 DNS 超时时,可以按下面链路从左到右定位请求丢在哪一层,并优先关注每一层下面标出的风险点。
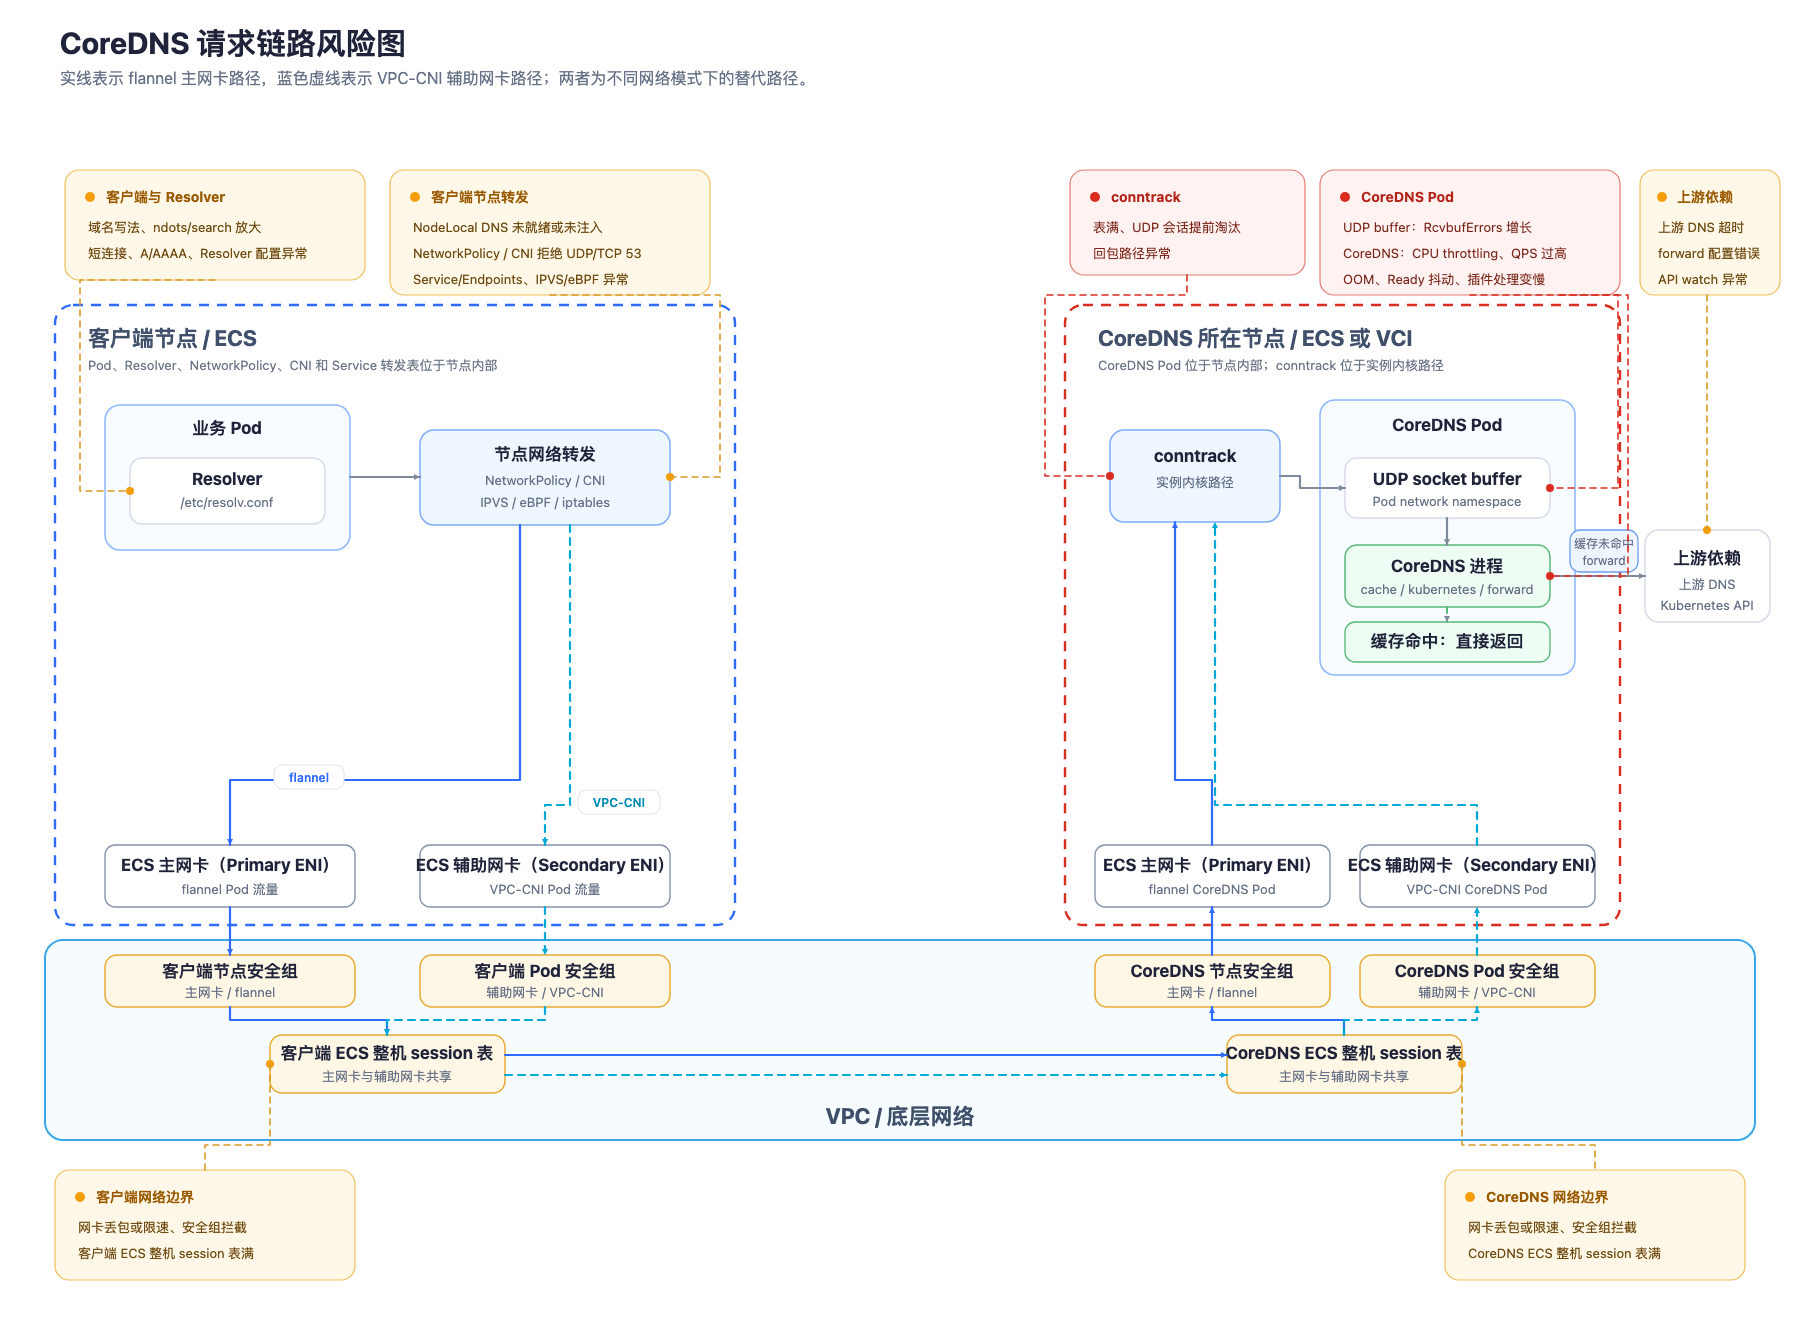
网卡与安全组路径需要结合集群网络模式判断:
- Flannel 集群的 Pod 流量通常经 ECS 主网卡转发,并受节点安全组约束。
- VPC-CNI 集群的 Pod 流量通常经 ECS 辅助网卡承载,并受 Pod 安全组约束。
因此排查安全组、session 表、网卡丢包或限速时,需要先确认异常 Pod 和 CoreDNS Pod 实际使用的是主网卡还是辅助网卡,以及对应生效的是节点安全组还是 Pod 安全组。
使用上述风险图时,建议同时结合双端抓包和监控判断问题位置:
- 客户端能看到请求发出,但 CoreDNS Pod 看不到报文,优先检查 NetworkPolicy、CNI、Service 转发、客户端节点安全组、CoreDNS 所在 ECS / VCI 实例安全组、整机 session 表和实例内 conntrack。
- CoreDNS Pod 能看到请求到达,但没有正常响应,优先检查 CoreDNS 负载、CPU throttling、UDP buffer、Corefile 配置和上游 DNS。
- CoreDNS 已返回响应但客户端收不到,优先检查回包路径、安全组、CoreDNS 所在 ECS / VCI 实例内 conntrack、IPVS / eBPF 转发表和节点网络。
故障排查流程
步骤一:确认影响范围
- 在业务 Pod 内执行以下命令,测试 Pod 是否能够正常解析集群内部域名和外部域名。
-
- 预期结果如下,正常情况下,Pod 能够正确解析集群内部域名和外部域名。
-
- 如果 Pod 无法正确解析域名,请在测试结果中记录以下信息:
- 异常域名。
- 异常开始时间。
- 是否只影响某个命名空间、某类节点或某个应用。
- 是否只在发布、扩缩容、节点波动期间出现。
- 典型错误日志。
- (可选)如果业务镜像里没有调试工具,可以执行以下命令,创建一个调试 Pod 用于调试。
-
步骤二:检查 DNS 配置
- 执行以下命令,查看业务 Pod 配置中的dnsPolicy和dnsConfig配置。其中${pod-name}为业务 Pod 名称,${namespace}为业务 Pod 所在命名空间。
-
- 预期结果如下。
-
- 需要重点确认以下内容:
- 常规 Pod 的默认 DNS 策略通常应该使用ClusterFirst模式,即dnsPolicy: ClusterFirst。
- 如果 Pod 中的参数hostNetwork配置为true ,表示 Pod 直接使用所在节点(Node)的网络命名空间,而不是使用独立的 Pod 网络。此时需要显式配置dnsPolicy: ClusterFirstWithHostNet,否则 Pod 会沿用节点的 DNS 配置,导致kubernetes.default.svc.cluster.local等集群域名无法正常解析。
- 如果集群中启用了 NodeLocal DNS,需要确认nameserver已实际指向节点本地缓存地址,而不仅只指向 CoreDNS。
- search和ndots是否被业务显式改写,导致额外查询放大。
- 执行以下命令,查看业务 Pod 的/etc/resolv.conf配置。其中${pod-name}为业务 Pod 名称,${namespace}为业务 Pod 所在命名空间。
-
- 预期结果如下,确认集群中 Pod 使用的 DNS 服务器与配置一致。
-
步骤三:确认异常域名类型
如果仅集群内域名异常,建议进行以下检查:
- kube-dns Service 是否存在、ClusterIP 是否正常。
- CoreDNS Pod 是否为Running或Ready状态。
- Service 对应的 Endpoints 是否完整。
- Headless Service/StatefulSet 的 Service 名称、子域名、命名空间是否匹配。
建议命令:
如果仅集群内域名异常,建议进行以下检查:
- CoreDNS 是否能正常转发到上游 DNS。
- 上游 DNS 是否可达、是否超时。
- 节点本身的 DNS 与出网链路是否异常。
- 是否只影响某些节点,提示节点网络或路由问题。
说明
这类问题常见于上游不可达、节点网络异常、VPC 路由、安全组、子网 ACL 限制或节点 DNS 本身异常。
如果仅 Headless Service/StatefulSet 域名异常,建议进行以下检查:
- Service 是否配置了clusterIP: None字段。
- 是否存在对应 Endpoints/EndpointSlice。
- StatefulSet 的serviceName与 Headless Service 是否一致。
- 客户端是否用了错误的命名空间或不完整域名。
步骤四:检查 CoreDNS 与 NodeLocal 组件状态
- 执行以下命令,检查集群中的 CoreDNS 与 NodeLocal DNS 组件状态。
-
- 预期结果如下,需要重点确认是否存在以下问题:
- Pod 是否频繁重启。
- 是否存在明显的 OOM、探针失败、配置错误。
- NodeLocal DNS 是否在问题节点上缺失或不健康。
-
- 执行以下命令,检查集群中的 CoreDNS 与 NodeLocal DNS 组件资源占用情况。
-
- 预期结果如下,需要重点确认 Pod 的 CPU/内存是否在异常时段持续偏高。
-
- 如果为偶发故障,可以执行以下命令,查看组件日志,确认是否与 CoreDNS 发布、缩容、节点扩缩容重合。其中${coredns-pod-name}为 CoreDNS 组件的 Pod 名称,${node-local-dns-pod-name}为 NodeLocal DNS 组件的 Pod 名称。
-
步骤五:开启 DNS 查询日志
如果仅靠 Pod 状态、基础日志和连通性测试还无法判断问题原因,可以临时开启 CoreDNS 的查询日志,观察请求是否真正到达 CoreDNS、查询的域名是什么、返回码是什么,以及延迟是否异常等。例如:
- 怀疑客户端实际查询的域名与预期不一致,例如被search/ndots 放大。
- 怀疑某一类域名返回NXDOMAIN、SERVFAIL,但业务日志不够完整。
- 怀疑请求已经到达 CoreDNS,但在转发上游或返回结果阶段出现问题。
- 需要判断偶发异常究竟是“请求没到 CoreDNS”,还是“到达后处理失败”。
说明
建议临时在 CoreDNS Corefile 中开启 log 插件,必要时配合 debug 级别观察,问题定位完成后再恢复,避免长期开启带来额外日志量和性能开销。
- 执行以下命令,编辑 CoreDNS 配置。
-
- 在 Corefile 配置中将日志级别修改为 log,必要时可以提高到 debug 级别。
-
- 配置变更后等待重新加载生效,执行以下命令,查看 CoreDNS 日志。其中${coredns-pod-name}为 CoreDNS 组件的 Pod 名称。
-
- 需要重点确认以下内容:
- 是否能看到问题请求对应的查询日志。
- 实际查询名是否符合预期,是否存在大量 search 拼接后的无效查询。
- 返回码是NOERROR、NXDOMAIN还是SERVFAIL。
- 是否存在明显的上游转发延迟、重试或错误集中在某一类域名。
- 常见故障和排障思路:
- 如果业务侧报错时,CoreDNS 完全看不到对应查询,优先怀疑请求没有到达 CoreDNS,重点查 Pod 到 kube-dns/NodeLocal DNS 的链路。
- 如果能看到大量意料之外的查询名,优先回到客户端域名写法、search 和ndots配置排查。
- 如果查询进入 CoreDNS 后主要失败在上游转发,优先排查上游 DNS 可达性和外部域名解析链路。
- 如果只在个别副本上看到异常慢查询或错误堆积,优先排查单 Pod 热点、UDP 丢包或节点侧网络问题。
步骤六:检查业务 Pod 到 DNS 组件的连通性
- 执行以下命令,获取 kube-dns Service IP 和 Pod IP。
-
- 在业务 Pod 或调试 Pod 中进行分层验证。
-
注意
如果启用了 NodeLocal DNS,也建议直接指定本地缓存地址测试一次。
- 预期结果如下。
-
- 验证过程中可能出现的问题和原因如下:
- Pod 访问 kube-dns 不通:优先怀疑 Service 转发、kube-proxy、网络策略或 CNI。
- Pod 能访问 CoreDNS Pod,但访问 kube-dns 不通:优先怀疑 Service / 转发表。
- 内部域名正常、外部域名超时:优先怀疑上游 DNS 或出网链路。
步骤七:使用观测和诊断
当故障排查已经缩小到节点或网络层时,建议使用如下系统功能:
- 开启 DNS 服务观测:查看 core-dns、node-local-dns 的请求、延迟、错误和缓存指标。
- 使用 节点诊断:确认节点 DNS 地址解析、节点负载、网络异常、CNI 状态。
- 组件管理:确认 core-dns、node-local-dns 是否已安装、版本是否符合预期。
如果最终证据指向节点网络、VPC-CNI、路由或安全组问题,后续排查重点就不应该再停留在 CoreDNS 本身。
步骤八:使用网络抓包
如果上述步骤中的组件状态、查询日志、连通性验证和观测诊断仍然无法确定导致问题的原因或故障链路。建议使用抓包功能确认 DNS 请求是否发出、是否到达 CoreDNS、是否有响应返回以及故障异常发生的位置。
- 登录 容器服务控制台。
- 在左侧导航栏中,选择 集群,单击目标集群名称,进入集群管理页面。
- 在左侧导航栏中,选择 监控中心 > 网络抓包,对客户端和服务端分别进行抓包。
- 客户端:出现 DNS 异常的业务 Pod。
- 服务端:对应的 CoreDNS Pod。
抓包时建议尽量收敛范围,只关注 DNS 解析报文,避免无关流量过多影响分析效率。重点应该关注:
- 客户端是否真正发出了 DNS 请求。
- CoreDNS Pod 是否收到了对应的 UDP/TCP 53 报文。
- CoreDNS 是否返回了解析响应。
- 请求和响应是否只单向出现,提示中途丢包、转发异常或回包失败。
判断方式:
- 客户端侧能看到请求发出,但 CoreDNS Pod 侧看不到报文:优先怀疑客户端到 CoreDNS 的链路问题。
- CoreDNS Pod 侧能看到请求到达,但没有正常响应:优先怀疑 CoreDNS 本身、上游转发或 Pod 内 UDP 收包链路。
- CoreDNS Pod 侧已经发出响应,但客户端侧收不到:优先怀疑回包路径、CoreDNS 所在 ECS / VCI 实例内 conntrack、节点网络或 Service 转发问题。
典型故障示例
示例 1:CoreDNS 所在实例 conntrack 表满,导致 DNS 解析失败和健康检查失败
故障现象
- 同一节点上的业务 Pod 同时出现 DNS 超时,报错多为i/o timeout、no servers could be reached。
- kube-dns Service 与 CoreDNS Pod IP 都可能访问不稳定。
- CoreDNS Pod 本身 CPU、内存不高,但会出现探针失败、重启,或 Ready 在短时间内反复抖动。
- 问题常发生在连接数陡增、短连接风暴、节点负载高或节点上业务集中爆发时。
可能的原因为:CoreDNS 所在 ECS / VCI 实例的 nf_conntrack 表被占满后,新的连接跟踪项无法建立,业务 Pod 发往 CoreDNS 的 UDP 请求会被丢弃;同时 kubelet 从节点侧访问 CoreDNS Pod 的健康检查请求也可能超时,进而把 CoreDNS 判为不健康。
排查方式
如果观察到类似nf_conntrack: table full, dropping packet的日志,并且异常时段与 DNS 超时及 CoreDNS 探针失败同时出现,基本可以将问题定位到 conntrack 表容量相关方向。
处理建议
- 先缓解节点连接压力,排查是否存在异常短连接或无效 DNS 放大。
- 评估启用 NodeLocal DNS,减少跨节点访问和 CoreDNS 所在实例的部分 conntrack 压力。
- 结合节点规格和连接规模,评估是否需要调整nf_conntrack_max。
- 如果只有少数热点节点异常,建议优先进行工作负载打散或节点扩容,而非仅增加 CoreDNS 副本数。
示例 2:ECS 或 VCI 实例整机 session 表满,导致 DNS 丢包
故障现象
- CoreDNS 自身 QPS、CPU、内存看起来没有达到明显瓶颈,但业务侧仍出现 DNS 超时或偶发解析失败。
- 异常集中在某些 ECS 或 VCI 实例,迁移或打散 CoreDNS 副本后现象缓解。
- 同一实例上承载了较多 CoreDNS 副本、NodeLocal DNS 代理,或同时存在大量短连接业务流量。
- 云平台观测中可以看到实例级 session 表使用率高、接近上限,或出现 session 建立失败、丢包相关信号。
这类问题发生在实例整机网络转发能力或 session 表容量层面,不一定能从 CoreDNS 进程指标中直接看出来。实例 session 表接近打满或已满时,新的 UDP 转发会话可能无法正常建立,已有会话也可能被提前淘汰,最终表现为业务 Pod 到 DNS 的请求丢包或超时。
排查方式
同时结合云平台或实例监控查看 ECS / VCI 实例规格、整机 session 表使用率、丢包和连接建立失败等指标。如果只有少数实例异常,且这些实例上 DNS 组件或高短连接业务明显集中,应优先按实例维度收敛,而不是只看 CoreDNS Deployment 的总副本数。
处理建议
- 结合 ECS 或 VCI 实例规格评估 session 表容量,避免使用规格过小的实例承载高 QPS DNS 流量。
- 避免将大量 CoreDNS 实例集中调度到同一个 ECS 或 VCI 实例上,应通过反亲和、拓扑分布或调度策略分散到不同实例。
- 如果启用了 NodeLocal DNS,也需要关注节点本地 DNS 代理所在实例的 session 表压力,避免将问题从 CoreDNS Service 链路转移到节点本地链路。
- 告警上应同时覆盖 CoreDNS 指标、CoreDNS 所在实例的 conntrack 指标,以及云平台提供的 ECS / VCI 实例 session 表相关指标。
示例 3:CoreDNS Pod UDP 接收缓冲不足,出现 buffer 溢出丢包
故障现象
- CoreDNS Pod 处于Running,CPU 使用率未必达到瓶颈,但业务侧仍可能出现明显的 DNS 超时。
- 超时主要出现在 UDP 查询,改用 TCP 查询或重试后成功率更高;
- 问题更容易出现在突发高 QPS、单 Pod 压力集中,或上游响应包较大、返回较快的场景;
- CoreDNS 日志不一定直接报出buffer overflow,而且这类丢包如果发生在 CoreDNS Pod 自己的网络命名空间或套接字缓冲内,节点全局 UDP 统计中未必能够直接反映该类异常。
这种场景下,瓶颈不一定在 CoreDNS 逻辑处理本身,而是在 CoreDNS Pod 内 DNS 套接字的 UDP 接收队列或其所在网络命名空间的收包链路,导致报文已经送到 Pod 侧,但来不及被应用及时取走,最终出现丢包和超时。
排查方式
需要重点关注和确认以下内容:
- packet receive errors、receive buffer errors持续增加。
- 某个 CoreDNS Pod 的异常表现可能更为突出,而同节点其他 Pod 或其他 CoreDNS 副本未必同步出现相同现象。
- 将查询改为 TCP 后成功率明显提升,说明问题更可能发生在 UDP 报文接收链路,而非域名本身不存在。
处理建议
- 优先扩容 CoreDNS 副本数,并通过反亲和或拓扑分布让副本分散到不同节点,降低单个 CoreDNS Pod 的 UDP QPS。
- 对高 QPS 或高抖动场景,建议安装并启用 NodeLocal DNS,尽量在节点侧缓存和截流 DNS 请求,减少直接打到 CoreDNS Service 的流量。
- 同时排查是否存在无效 DNS 查询、短连接放大、ndots/search 放大等问题,避免扩容后请求量继续被客户端放大。
- 如果扩容和 NodeLocal DNS 后 receive buffer errors 仍持续增长,再结合 UDP 缓冲区相关配置的含义判断是否存在环境默认值偏小的问题。
相关缓冲区配置和简单原理:
- net.core.rmem_default 影响 socket 默认接收缓冲区大小,应用没有显式设置接收缓冲区时会受它影响。
- net.core.rmem_max 是应用通过 SO_RCVBUF 申请接收缓冲区时的上限,默认值过小时会限制单个 UDP socket 可用的接收缓冲区。
- net.ipv4.udp_mem 控制系统整体 UDP 内存水位,达到 pressure 水位后,UDP socket 可分配的缓冲区会受到更强约束。
- net.ipv4.udp_rmem_min 是 UDP socket 接收缓冲区的最小保障值,在 UDP 内存承压时尤其相关。
- 当突发 DNS 请求进入 CoreDNS 的速度超过 CoreDNS 从 socket 读取和处理请求的速度时,接收队列可能被打满,内核会丢弃后续 UDP 报文,并在 netstat -su 中体现为 receive buffer errors 增长。
示例 4:仅集群外部域名解析异常
故障现象
- kubernetes.default.svc.cluster.local 等集群内域名解析正常。
- 只有公网域名、私网权威域名或其他集群外部域名解析失败。
- CoreDNS 查询日志里能够看到请求已经到达,但返回 SERVFAIL、超时,或上游转发耗时明显偏高。
这类问题通常说明 CoreDNS 自身的集群内服务发现能力还正常,问题更可能出在上游 DNS、出网链路,或外部域名本身的解析结果异常。
排查方式
如果 CoreDNS 尚未开启查询日志,先按“必要时开启 DNS 查询日志辅助排查”步骤临时开启 log 插件,再查看请求日志。
需要重点关注和确认以下内容:
- CoreDNS 是否收到了请求;
- 返回码是否为 NOERROR、NXDOMAIN、SERVFAIL;
- 上游 DNS 是否超时或结果异常;
- 是否只影响某一类外部域名,而非全部外部解析。
处理建议
- 如果上游 DNS 返回异常,优先排查外部域名本身配置或上游解析链路;
- 如果 CoreDNS 到上游 DNS 不通,优先排查节点出网、VPC 路由、安全组或子网 ACL;
- 如果只是少数外部域名异常,避免误判成 CoreDNS 整体故障。
示例 5:安全组或子网 ACL 配置错误,拦截 DNS 流量
故障现象
- 部分节点或全部节点上的业务 Pod 持续 DNS 解析失败;
- dig @<kube-dns-cluster-ip>、dig @<coredns-pod-ip> 都可能超时;
- CoreDNS Pod 自身可能健康,但客户端始终收不到响应;
- 往往发生在安全组、子网 ACL 或网络访问策略调整之后。
一个典型场景是:节点、Pod 或相关子网的访问控制策略拦截了 UDP 53 端口流量,导致业务 Pod 到 CoreDNS,或 CoreDNS 到上游 DNS 的报文被中途丢弃。
排查方式
需要重点关注和确认以下内容:
- 是否为“部分节点失败、部分节点正常”,这通常更像网络策略或子网级拦截;
- 最近是否变更过安全组、子网 ACL、网络策略或防火墙配置;
- UDP 53 是否被显式拒绝,必要时也检查 TCP 53。
处理建议
- 恢复或放通业务 Pod 到 CoreDNS、CoreDNS 到上游 DNS 所需的 UDP / TCP 53 通信;
- 若只在少数节点或子网出现,优先按节点 / 子网维度收敛。
示例 6:CoreDNS Pod 负载高,导致高峰期解析超时
故障现象
- 异常主要出现在业务高峰期;
- kubectl top pod 看到 CoreDNS 副本 CPU、内存接近资源限制,或个别副本明显高于其他副本;
- DNS 查询延迟升高,超时比例上升,但低峰时段会自行缓解。
这种情况通常不是配置错误,而是 CoreDNS 承载的请求量过高,或负载分布不均,导致个别副本先达到瓶颈。
排查方式
需要重点关注和确认以下内容:
- 是否所有副本都接近资源上限;
- 是否存在单 Pod 热点,提示负载不均;
- 异常是否与业务流量高峰、发布或缓存命中下降时段一致。
处理建议
- 优先排查请求放大问题,例如 search / ndots、短连接、无效外部查询;
- 在高 QPS 场景优先评估 NodeLocal DNS,降低直接打到 CoreDNS Service 的流量;
- 如果确认是容量瓶颈,再结合监控结果增加副本或调整资源规格。
示例 7:CoreDNS 出现 CPU throttling,导致解析延迟升高或成功率下降
故障现象
- CoreDNS Pod 的 CPU 使用量接近或达到 limit,同时出现明显的 CPU throttling;
- DNS 查询延迟升高、超时比例上升,业务侧表现为 i/o timeout、解析慢或偶发解析失败;
- CoreDNS 副本集中在少数节点上,和业务 Pod 或其他系统组件争抢 CPU;
- 扩容副本后,如果新副本仍被调度到热点节点,整体 DNS QPS 不一定明显提升。
CPU throttling 会限制 CoreDNS 进程实际可用的 CPU 时间片。即使节点仍有一定空闲资源,只要容器达到自身 CPU limit,CoreDNS 处理 DNS 请求、读取 UDP socket、访问 Kubernetes API 缓存或转发上游的速度都会下降,最终影响 DNS 请求延迟和成功率。
排查方式
如果已经接入容器 CPU throttling 指标或监控面板,建议同时查看 CoreDNS 容器的 throttling 比例,确认异常时间是否与 DNS 延迟、超时同步。可参考以下 PromQL。
处理建议
- 调大 CoreDNS 的 CPU limit,避免突发 DNS 流量被 CFS throttling 压住。
- 不要调小 CPU limit 和 memory limit,避免影响 CoreDNS 处理突发流量。
- 通过反亲和、拓扑分布或调度策略打散 CoreDNS Pod,避免集中在同一个节点上和业务 Pod 争抢 CPU。
- 一个 CoreDNS 实例能够稳定处理的请求量通常按约 3K QPS 估算,超过后建议通过增加副本提高集群整体 DNS QPS。
- 为了创建更多 CoreDNS 副本、提高集群 DNS 总吞吐,可以适当调小单个 CoreDNS 实例的 CPU request 和 memory request,但应以实际 CoreDNS 监控中的 CPU、内存使用量为参考。
- CPU request 不建议低于 0.3,memory request 不建议低于 256Mi,避免调度过度紧缩导致 CoreDNS 和其他工作负载争抢资源。
示例 8:A 记录和 AAAA 记录并发解析异常
常见现象
- 问题出现频次很低,但会反复出现少量超时;
- 同一域名偶发解析失败,重试后又恢复;
- 更容易出现在同时请求 A / AAAA 记录的客户端、特定基础镜像或旧内核环境下。
这类问题通常与客户端 Resolver 行为和内核 UDP / conntrack 处理细节有关,而不一定是 CoreDNS 本身不可用。典型场景是客户端并发发起 A 和 AAAA 查询,触发源端口冲突或丢包,最终表现为小概率 DNS 超时。
排查方式
需要重点关注和确认以下内容:
- 是否只在双栈查询或某些镜像下更容易复现;
- 是否与 Alpine / musl、旧内核或特殊 Resolver 实现相关;
- 改为单独查询 A 或 AAAA 后,是否明显更稳定。
处理建议
- 优先确认业务是否真的需要 AAAA 查询,避免无意义并发解析;
- 对 DNS 敏感业务,优先验证基础镜像和 Resolver 行为,必要时调整镜像或运行时;
- 若同时伴随 CoreDNS 所在实例 conntrack 压力或 UDP 丢包,再结合前述 conntrack、UDP buffer 方向一起排查。
常用命令清单
常用命令 | 使用说明 |
kubectl exec -it <pod-name> -n <namespace> -- cat /etc/resolv.conf | 查看 Pod 中的 DNS 配置。 |
kubectl -n kube-system get svc kube-dns kubectl -n kube-system get endpoints kube-dns | 查看 kube-dns 组件的 Service 和 Endpoints 信息。 |
kubectl -n kube-system get pods -o wide | egrep 'coredns|node-local-dns' kubectl -n kube-system top pod | egrep 'coredns|node-local-dns' | 查看 CoreDNS 或 NodeLocal DNS 组件状态。 |
kubectl -n kube-system logs --tail=200 ${coredns-pod-name} kubectl -n kube-system logs --tail=200 ${node-local-dns-pod-name} | 查看指定组件的日志。 |
dig kubernetes.default.svc.cluster.local ${kube-dns-cluster-ip} dig example.com ${kube-dns-cluster-ip} dig example.com ${node-local-dns-ip} | 在业务 Pod 或调试 Pod 中进行定向查询测试。 |
最近更新时间:2026.10.29 19:32:40
这个页面对您有帮助吗?
有用
有用
无用
无用