容器服务
容器服务
容器服务


文档指南
请输入


容器服务 VKE
产品动态
Kubernetes 版本发布记录
组件发布记录
监控组件
DNS 组件
GPU 组件
Sandbox 组件
安全公告
产品公告
历史公告
用户指南
集群
节点池
授权
网络
容器网络
服务(Service)
路由(Ingress)
APIG Ingress
ALB Ingress
自定义转发规则配置示例
CLB Ingress
Nginx Ingress
Gateway API
工作负载
存储
数据管理中心(DMC)
对象存储(TOS)
FSX 访问方式
文件存储(NAS)
FSX 访问方式
弹性文件存储(EFS)
文件存储(vePFS)
FSX 访问方式
vePFS Client 访问方式
NFS 访问方式
大数据文件存储(CloudFS)
弹性伸缩
工作负载弹性伸缩
事件驱动伸缩(KEDA)
组件管理
网络组件
监控组件
DNS 组件
GPU 组件
Sandbox 组件
异构计算
调度管理
可观测性
基础观测
诊断与巡检
最佳实践
网络
可观测性
安全合规
API 参考
集群管理
节点池管理
组件管理
机型镜像管理
云原生观测
巡检诊断
弹性容器实例
附录
开发指南
常见问题
通用 FAQ
集群 FAQ
集群管理
集群升级
节点与节点池 FAQ
授权 FAQ
工作负载 FAQ
服务与路由 FAQ
存储 FAQ
弹性伸缩 FAQ
可观测性 FAQ
配额 FAQ
组件 FAQ
容器镜像 FAQ
AI 云原生
推理套件
Helm 模板 AI 应用
Deepseek 实践
Qwen 实践
最佳实践
MiniMax 模型部署
Qwen 模型部署
弹性容器实例 VCI
最新动态
用户指南
虚拟节点
VKE 集群使用虚拟节点
自建/跨云集群使用虚拟节点
创建 VCI 实例
VCI Agent Sandbox
安全合规
- 文档首页
 容器服务容器服务 VKE用户指南调度管理QoS 感知调度内存压缩
 复制全文
 下载 pdf
内存压缩
 文档反馈
 问问助手
内存压缩基于 katalyst 组件实现,可在业务容器无感的情况下自动探测冷内存并进行压缩存放,从而提升内存资源的利用率。本文介绍如何在 VKE 集群中开启并使用内存压缩能力。
背景信息
应用申请的内存通常缺乏严格的使用规划,其真正被频繁访问的热内存(Working Set Size)往往低于总申请量的 80%,其余部分即为长期驻留但很少访问的冷内存。而内核只有在触发内存水位时才会主动回收,导致在长期运行和高密部署场景下,节点可能出现内存看似耗尽、实则大量冷内存闲置的现象,成为提升整机资源利用率的主要瓶颈。
VKE 基于 Katalyst 组件提供内存压缩能力,解决上述问题。
使用限制
使用该功能时,有如下限制和须知事项:
- 该功能依赖 v0.5.13-vke.17 及以上版本的 katalyst 组件。
- 仅支持以云服务器(ECS)方式部署的 Pod 使用该功能,以弹性容器实例(VCI)方式部署的 Pod 暂不支持。
- 节点内核版本需要满足以下任一条件:
- 使用 Cgroup v1,且节点镜像为 veLinux 1.0,内核版本为 5.10.200-5.6.ve1.x86_64(CentOS 兼容版)或 5.10.200-5-velinux1u6-amd64 及以上。
- 使用 Cgroup v2(如 veLinux 2、Ubuntu 22.04)。
前提条件
- 集群处于 运行中 状态,且集群中存在可用的 ECS 节点。
- 已安装 v0.5.13-vke.17 及以上版本的 katalyst 组件,且勾选开启了 内存压缩 能力。详细操作,请参见 katalyst。
使用方法
步骤一:配置使用内存压缩的节点
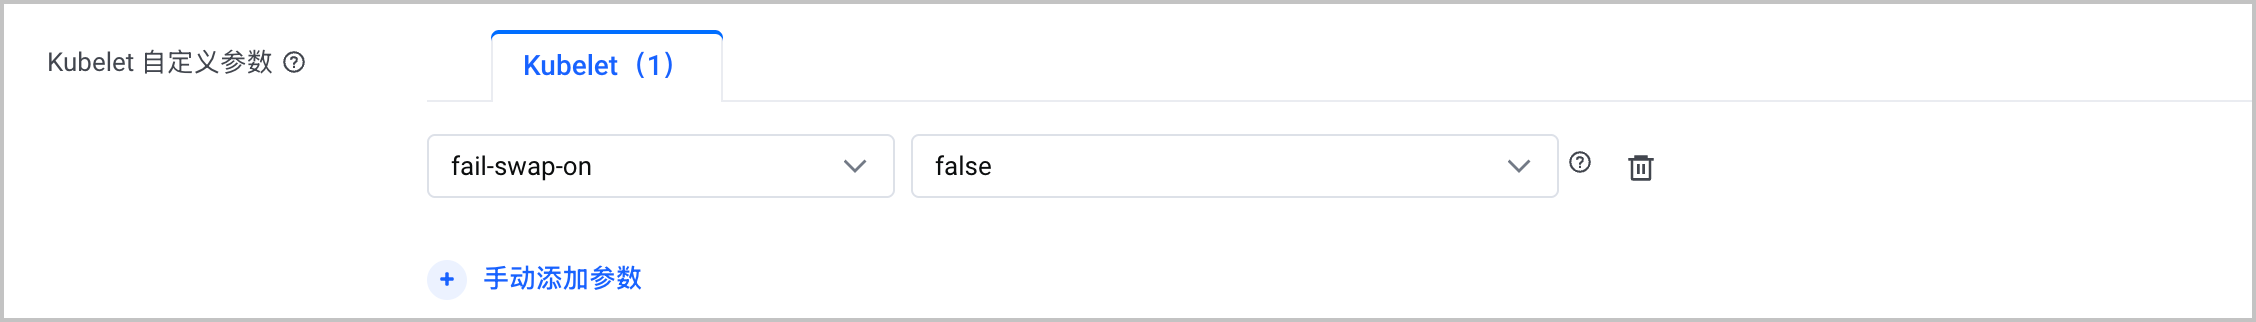
- 修改节点 kubelet 参数,将 kubelet 参数 fail-swap-on 修改为 false。存量节点和增量节点上的 kubelet 参数配置方法,请参见 配置节点池 Kubelet 参数。
-
- 配置节点标签(Label)。
- 登录 容器服务控制台。
- 在左侧导航栏选择 集群,单击目标集群名称。
- 在集群管理页面,按如下方式为节点添加 Label。
- 从节点池维度添加 Label从节点维度添加 Label
- 左侧导航栏选择 节点管理 > 节点池。
- 在 节点池 页面找到目标节点池,单击对应 操作 列下的 编辑。
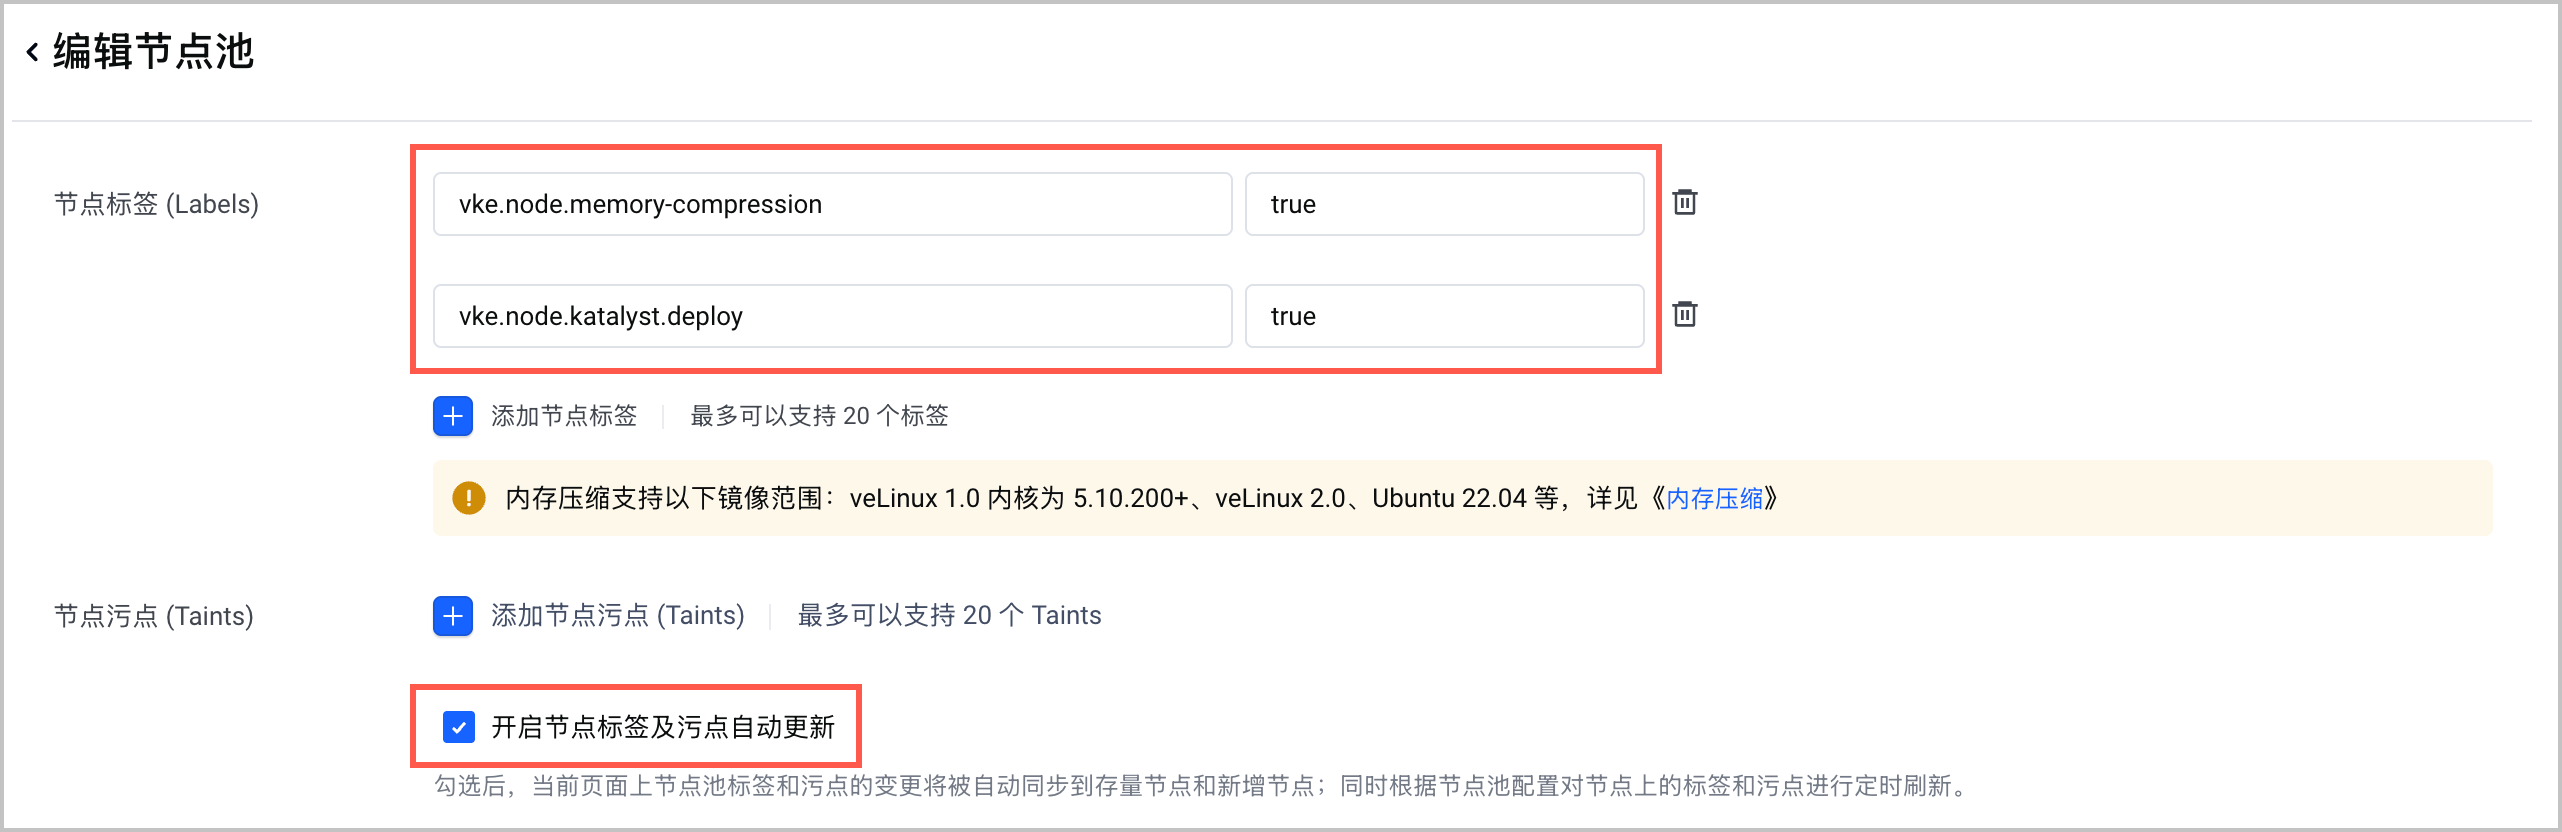
- 在 编辑节点池 页面的 ①节点池配置 步骤 高级配置 模块下配置 节点标签(Labels)并勾选 开启节点标签及污点自动更新,则该变更会对节点池内的存量节点和增量节点均生效。
- Label 1:vke.node.katalyst.deploy: "true",表示该节点需要安装并使用 katalyst 组件能力。
- Label 2:vke.node.memory-compression: "true",表示该节点需要开启内存压缩。
-
- 根据控制台向导,更新完成节点池配置。
- 左侧导航栏选择 节点管理 > 节点。
- 在 节点 页面,找到目标节点,单击对应 操作 列下的...按钮选择 标签管理。
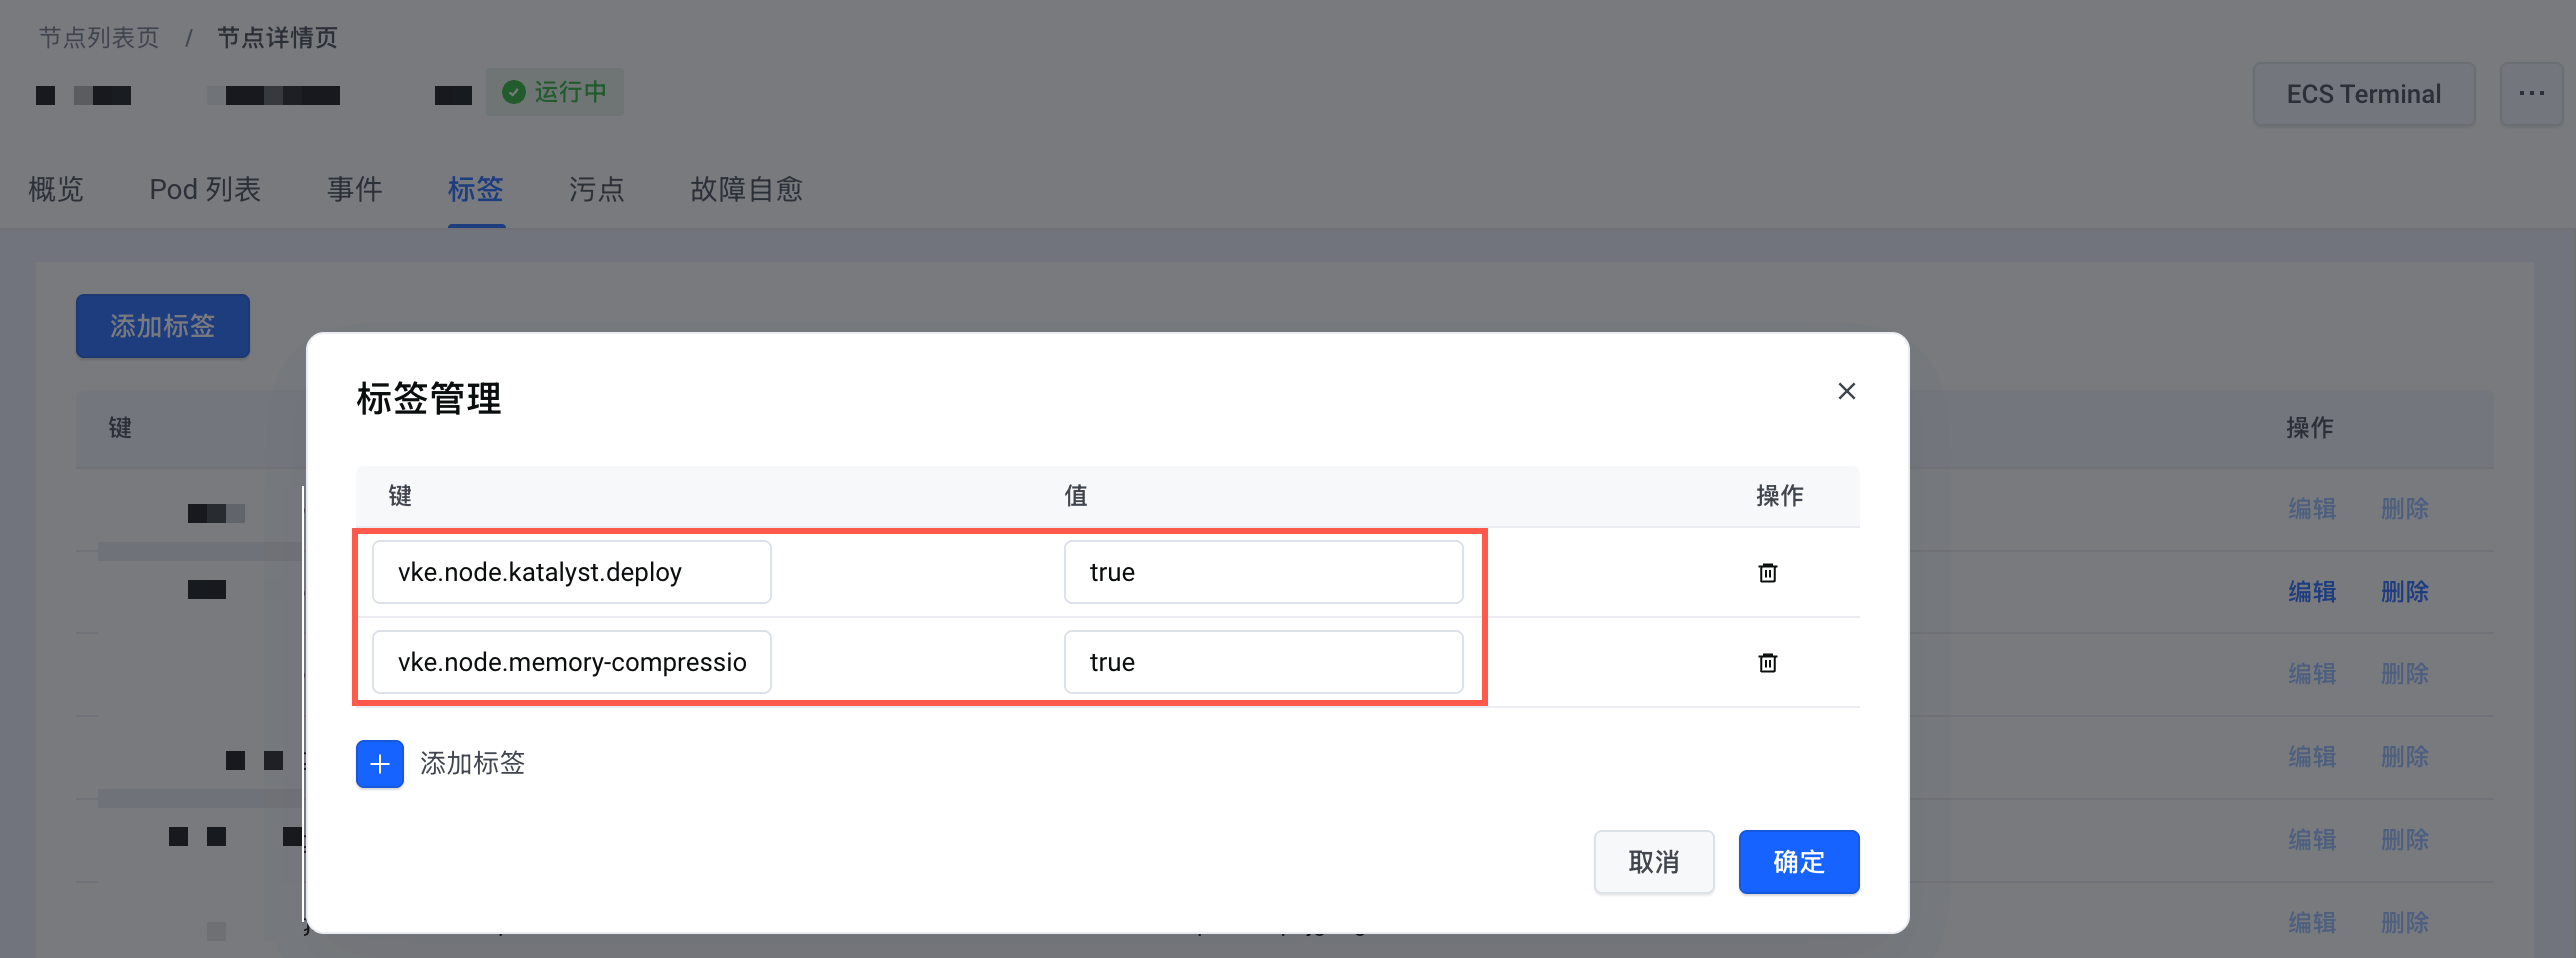
- 在 节点详情页 的 标签 页签下单击 添加标签,为节点添加如下标签后单击 确定。
- Label 1:vke.node.katalyst.deploy: "true",表示该节点需要安装并使用 katalyst 组件能力。
- Label 2:vke.node.memory-compression: "true",表示该节点需要开启内存压缩。
-
- 验证节点的内存压缩配置是否生效。
- 使用 ECS Terminal 方式登录节点。
- 执行以下两个命令,确认节点的 Linux 虚拟内存压缩功能(zram)已初始化。
- 确认 zram 设备本身已创建。
- zramctl#预期返回结果如下:NAME ALGORITHM DISKSIZE DATA COMPR TOTAL STREAMS MOUNTPOINT/dev/zram0 lzo-rle 61.6G 296M 239.4M 246.9M 32 [SWAP]
- 确认 zram 已被启用为 swap。
- swapon --show#预期返回结果如下:NAME TYPE SIZE USED PRIO/dev/zram0 partition 61.6G 392.8M 100
步骤二:创建工作负载
- 通过 kubectl 连接集群。详细操作,请参见 连接集群。
- 创建 Deployment 的 YAML 文件。示例文件stress-ng.yaml代码如下:
- apiVersion: apps/v1kind: Deploymentmetadata:name: stress-ng # Deployment 名称。namespace: default # Deployment 所属命名空间。labels:app: stress-ngspec:replicas: 1selector:matchLabels:app: stress-ngtemplate:metadata:labels:app: stress-ngvke.pod.memory-compression: "true" # 是否开启内存压缩。取值:true(开启)、false(关闭)。annotations:katalyst.kubewharf.io/qos_level: shared_cores # 选填,业务在离线标识。取值:shared_cores(默认值,在线业务),reclaimed_cores(离线业务)。spec:nodeSelector: # 节点选择器,此处配置保证 Deployment 被调度到已开启内存压缩的节点上,即上方步骤一中的配置的节点。vke.node.memory-compression: "true"containers:- name: stress-ngimage: doc-cn-beijing.cr.volces.com/vke/stress-ng:v1.0 # 容器镜像地址和 Tag,请替换为您自己的容器镜像。若使用公网镜像,请确保您的集群能够访问公网。imagePullPolicy: IfNotPresentresources:requests:cpu: "2"memory: 4Gilimits:cpu: "4"memory: 8Gicommand:- /usr/bin/stress-ng- --vm- "2"- --vm-bytes- 3G- --vm-keep- --vm-hang- "0"- --metrics-brief- --timeout- 3600s
- 执行以下命令创建 Deployment。
- kubectl apply -f stress-ng.yaml
步骤三:生效验证
- 执行以下命令,查看 Pod 被调度到的节点。
- kubectl get pod <pod-name> -o wide
- 使用 ECS Terminal 方式登录到 Pod 被调度的节点。
- 执行以下命令,确认 zram 被使用的情况。
- zramctl#返回结果示例如下:NAME ALGORITHM DISKSIZE DATA COMPR TOTAL STREAMS MOUNTPOINT/dev/zram0 61.6G 2.3G 1002.5M 1G 32 <swap>
- 执行以下命令,查看 Pod 通过内存压缩节省的内存量。
- memory.memsw.usage_in_bytes与memory.usage_in_bytes存在差值时,说明该 Pod 的冷内存已被成功压缩到 zram。
- echo $(( $(cat /sys/fs/cgroup/memory/kubepods/burstable/podxxxxxx/memory.memsw.usage_in_bytes) - $(cat /sys/fs/cgroup/memory/kubepods/burstable/podxxxxxx/memory.usage_in_bytes) ))#将 podxxxxxx 替换为目标 Pod 实际的 Cgroup 目录名 (基于 Pod UID)。#预期返回结果如下,单位为字节,换算后 2047434752 ÷ 1024 ÷ 1024 ≈ 1952 MiB ≈ 2 GiB:2047434752
附录
内存压缩配置说明
内存压缩相关配置存放在 TransparentMemoryOffloadingConfiguration(TMO)CRD 中。开启内存压缩功能时,系统会自动创建一份默认配置文件:katalyst-system/tmo-default。如需深入调整内存压缩功能,可编辑 TransparentMemoryOffloadingConfiguration 来实现。
说明
请根据 YAML 中的注释说明调整参数,未注释的部分建议保持默认值。
apiVersion: config.katalyst.kubewharf.io/v1alpha1
kind: TransparentMemoryOffloadingConfiguration
metadata:
labels:
vke.node.katalyst.deploy: "true"
name: tmo-default
namespace: katalyst-system
spec:
config:
podSelector: # 用于指定哪些 pod 应开启内存压缩。
labelSelector:
matchLabels:
vke.pod.memory-compression: "true"
# namespaceSelector: # 可以指定命名空间下的所有 Pod 都开启内存压缩,如需调整,请删除参数前的 # 标识。
# matchLabels:
# tmo.enabled: "true"
# matchExpressions:
# - key: environment
# operator: In
# values:
# - production
# - staging
qosLevelConfig: # 可以为每种 katalyst QoSLevel 独立配置内存压缩策略。
- configDetail:
enableSwap: true # 内存压缩能力开关,取值:true(开启),false(默认值,关闭)。在自定义编写 TMO CRD 时需要将该开关配置为 true。
enableTMO: true # 是否自定义编写内存压缩配置相关的 TMO CRD,取值:true(开启),false(默认值,关闭)。
swappiness: 160 # 内核控制内存回收(reclaim)时,对匿名页(anonymous pages)或文件页(file-backed pages)的倾向程度,取值范围:0~200。取值越接近 0 越倾向于回收文件页,反之倾向于回收匿名页。
# swapMaxOvercommitRatio: 0.3 # swap usage + memory usage 最多可以超过 memory limit 的比例。
# psiPolicy:
# maxProbe: 0.05 # 每轮最多可以 reclaim 的内存占比。
# psiAvg60Threshold: 0.1 # Pod PSI 越接近这个值, reclaim 力度越弱。
# refaultPolicy:
# maxProbe: 0.05 # 每轮最多可以 reclaim 的内存占比。
# reclaimAccuracyTarget: 0.99 # reclaim 准确率高于该值时继续扩大 reclaim。
# reclaimScanEfficiencyTarget: 0.6 # reclaim 效率高于该值时继续扩大 reclaim。
qosLevel: reclaimed_cores
- configDetail:
enableSwap: true
enableTMO: true
swappiness: 80
qosLevel: shared_cores
nodeLabelSelector: vke.node.memory-compression=true
priority: 10
内存压缩监控指标
说明
对象 | 指标名称 | 含义 |
对象 | 指标名称 | 含义 |
Pod / Container | katalyst_memory_offloading_target_bytes | TMO 策略计算出的目标回收量,表示本轮希望从目标对象中 offload 的内存字节数。 |
| katalyst_memory_handler_offloading_requested_bytes | TMO 执行侧实际接收到并提交给异步执行队列的回收请求量。 |
| katalyst_memory_handler_offloading_reclaimed_bytes | 执行memory.reclaim后观测到的内存使用量下降值,表示本轮实际回收效果。 |
| katalyst_memory_offloading_unavailable_total | 策略侧判定 TMO 暂不可用的次数,按reason区分指标缺失、节点压力过高、mapped file保护触发或策略异常等原因。 |
| katalyst_memory_handler_offloading_unavailable_total | 执行侧判定 TMO 暂不可用的次数,按reason区分memory.reclaim失败、swappiness不支持、swap limit设置失败、zram 未就绪或 Cgroup 路径异常等原因。 |
| katalyst_memory_cgroup_reclaim_direct | 目标对象直接回收内存事件的周期增量。 |
| katalyst_memory_cgroup_reclaim_kswapd_bytes | 目标对象后台kswapd回收的字节数周期增量。 |
| katalyst_memory_cgroup_oom | 目标对象 OOM 次数的周期增量。 |
Node | zram_orig_data_size_bytes | zram 中存放的原始数据大小。 |
| zram_compr_data_size_bytes | zram 中压缩后的数据大小,可与zram_orig_data_size_bytes结合计算压缩收益。 |
| zram_disksize_bytes | zram 设备暴露给 swap 的逻辑容量。 |
| zram_mem_used_bytes | zram 设备实际占用的内存大小。 |
| zram_mem_limit_bytes | zram 设备可使用的内存上限。 |
| zram_mem_used_max_bytes | zram 设备历史最高内存占用。 |
| zram_unavailable | zram 不可用状态,按reason标签区分初始化中、预检查失败、启动失败等原因。 |
| zram_same_pages | zram 中内容完全相同的页面数量,可辅助观察压缩与去重效果。 |
| zram_pages_compacted_total | zram 压缩整理过的页面累计数量。 |
| zram_huge_pages | zram 中无法高效压缩的大页数量,偏高时可能说明压缩收益下降。 |
| zram_failed_reads_total | zram 读取失败累计次数。 |
| zram_failed_writes_total | zram 写入失败累计次数。 |
| zram_invalid_io_total | zram 非法 IO 累计次数。 |
| zram_notify_free_total | zram 收到页面释放通知的累计次数。 |
| zram_comp_algorithm_info | 当前 zram 压缩算法信息,带algorithm标签。 |
| zram_bd_count_pages | zram backing device 占用页数。 |
| zram_bd_reads_total | zram backing device 读取累计次数。 |
| zram_bd_writes_total | zram backing device 写入累计次数。 |
最近更新时间:2026.09.04 16:23:33
这个页面对您有帮助吗?
有用
有用
无用
无用