容器服务
容器服务


文档指南

请输入


- 文档首页
 容器服务弹性容器实例 VCI最佳实践VCI 故障处理最佳实践
 复制全文
 下载 pdf
VCI 故障处理最佳实践
 文档反馈
 问问助手
本文面向在 VCI 上部署业务的技术与运维团队,系统性地梳理从故障定位、常见问题排查到监控告警与架构优化的实战最佳实践,帮助您在生产环境中更稳定地使用 VCI。
一、快速理解 VCI
- 误区一:VCI 不需要 Kubernetes 知识?
- 答:并非如此。VCI 虽然免去了节点运维,但其依然运行在 Kubernetes 的编排体系下。用户仍需熟悉 Kubernetes 的核心概念(如 Pod、Deployment、Service、Annotation 等),以更好地定义和管理应用。VCI 仅对数据面的节点管理进行了托管。
- 误区二:所有应用都适合 VCI?
- 答:不一定。VCI 是免节点运维(Nodeless)架构的产品,因此与 Node 相关的特性(如 DaemonSet、NodePort 等)无法在 VCI 中运行。
- 误区三:长期稳态场景不适合 VCI?
- 答:并非如此。部分用户误认为长期稳定运行、资源需求固定且利用率高的常驻应用使用传统 ECS 节点池更具成本效益,实际上 VCI 支持“预留实例券”功能,使用成本可对齐 ECS 节点池。VCI 不仅能提供极致弹性以应对波动需求,还能通过包年包月的成本方案解决稳态场景下的业务需求。
- 误区四:vci-profile 是强制调度策略?
- 答:这是软性调度,非强制。vci-profile 提供了一种便捷、无侵入的全局配置方式,用于影响 Pod 的调度倾向。最终调度结果仍受 Pod 自身的 Annotation、集群的资源优先级策略(Resource Policy)等多种因素共同影响。因此,Pod 仍有未被调度到 VCI 的可能性。
二、定位故障:分层与判定
排查 VCI 故障时,建立一个清晰的分层模型至关重要。这能帮助您快速缩小问题范围,避免在无关的层面浪费时间。推荐的排查顺序是“自上而下、由内而外”:从业务表现到应用自身,再到 VCI 实例,最后延伸至网络和外部依赖。
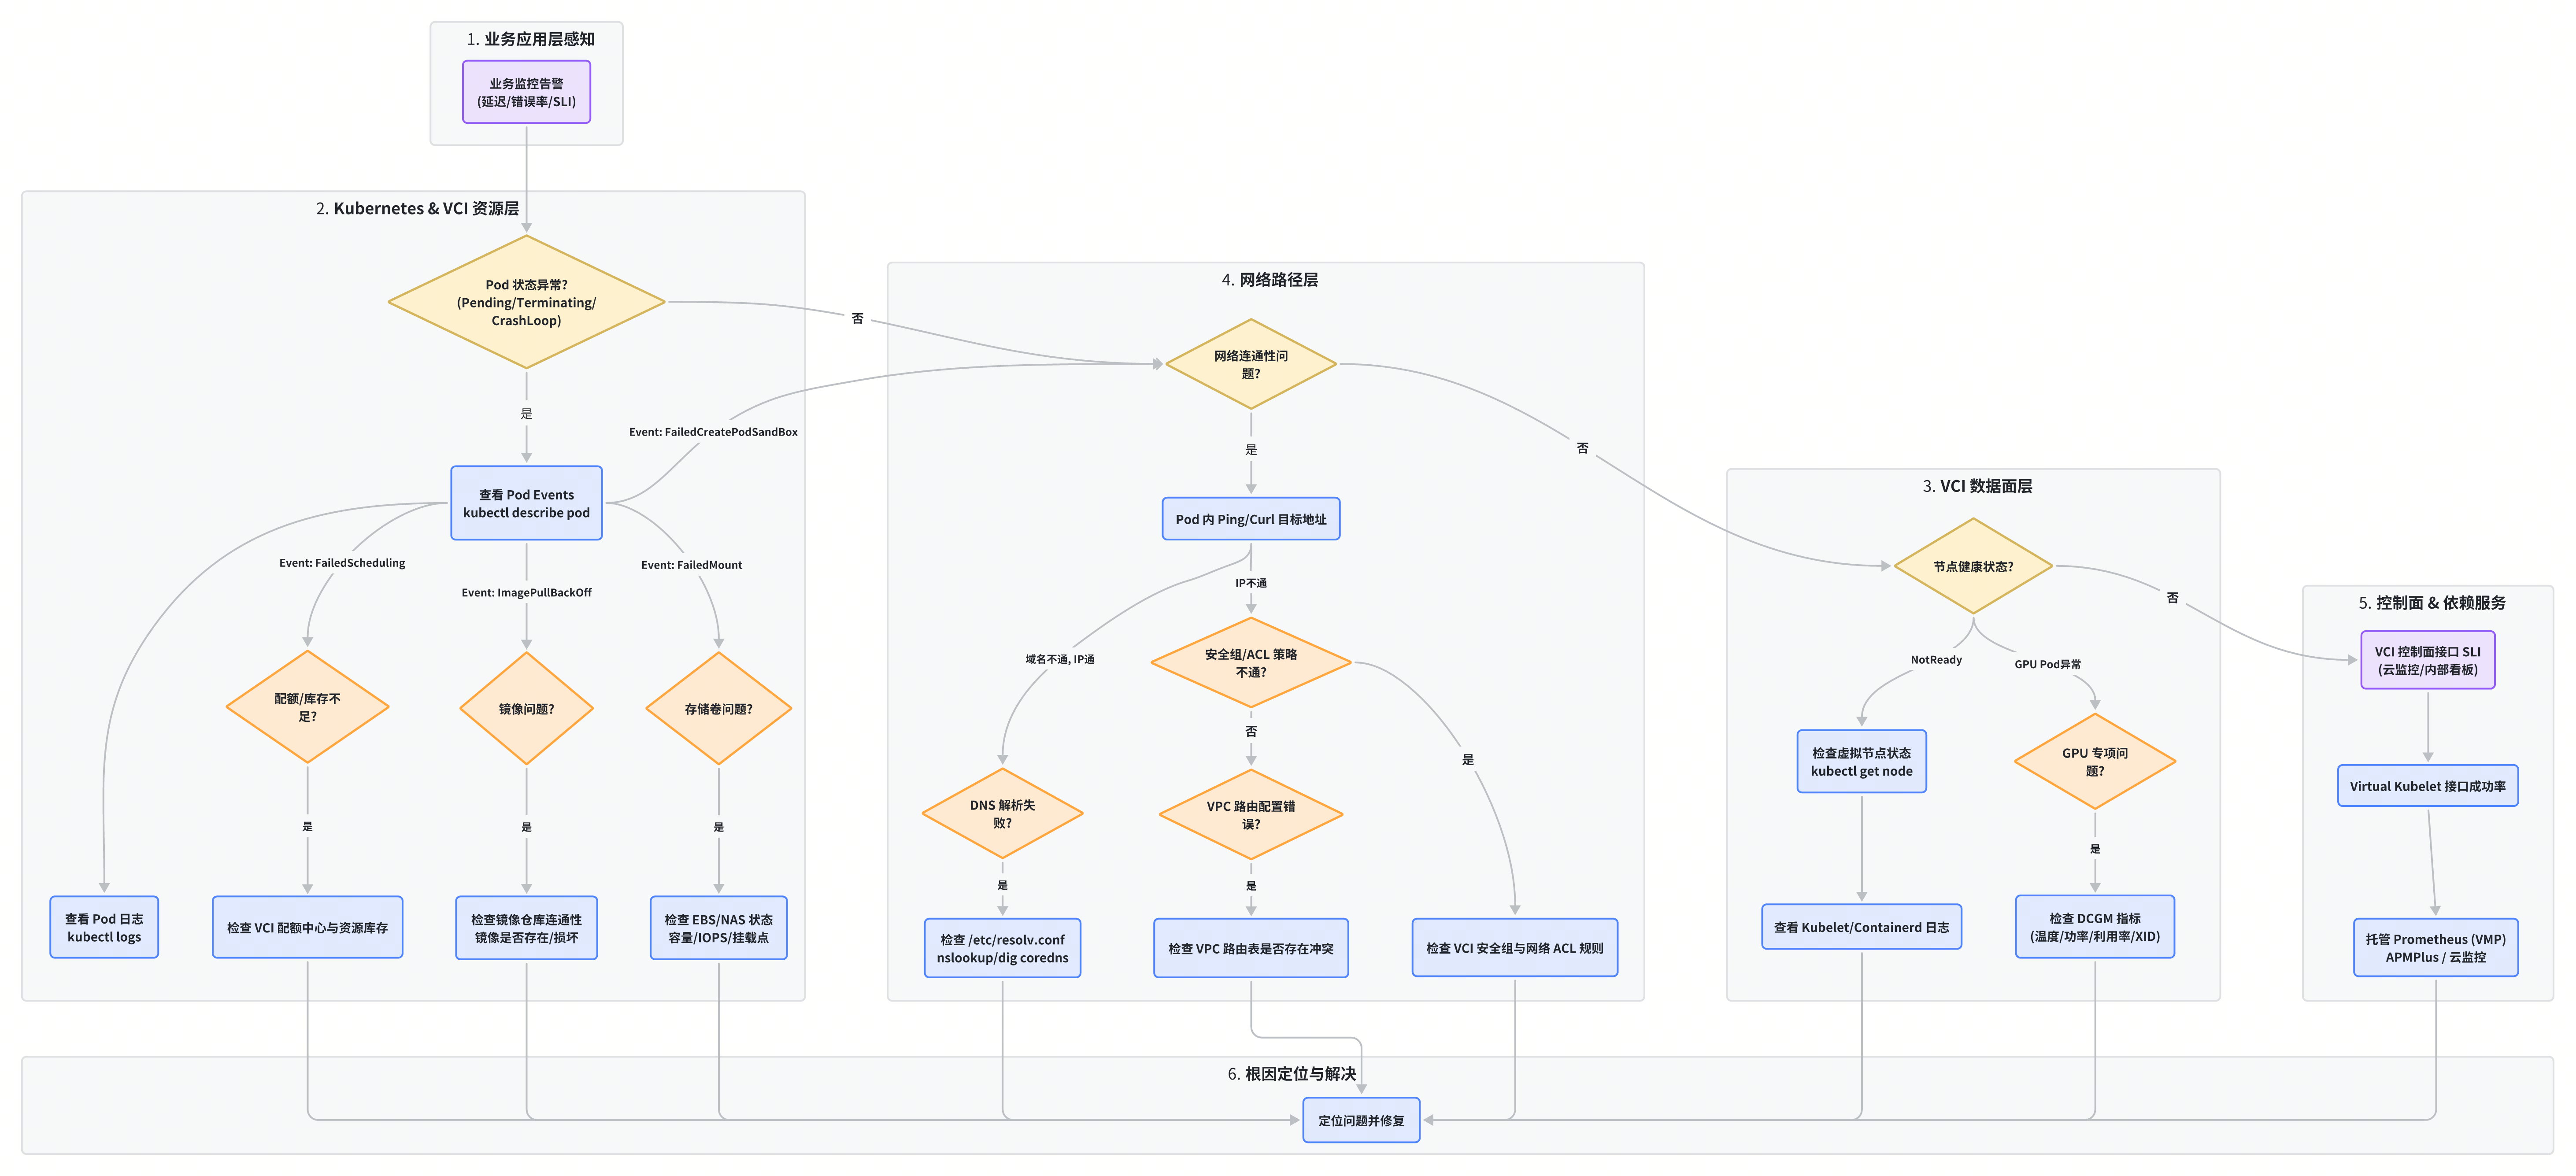
以下是各层级的核心关注点:
- 业务应用层
这是排查的起点,关注业务层面的可观测性指标。
- 核心问题:观测业务是否存在异常?应用日志是否有错误?
- 关键指标:应用 SLI/SLO(成功率/延迟)、错误码、业务自定义监控。
- 排查工具:APMPlus、业务日志平台、自定义监控大盘。
- Kubernetes & VCI 资源层
如果业务异常,立即下钻到 Kubernetes 资源层,检查 Pod 的生命周期和配置。
- 核心问题:Pod 是否正常运行?配置是否正确?
- 关键信号:kubectl describe pod 中的 Events、kubectl logs 中的容器日志、Pod Annotations。
- 常见状态:Pending、Terminating、CrashLoopBackOff、ImagePullBackOff、FailedCreate。
- VCI 数据面层
Pod 运行在 VCI 实例上,实例自身的健康状况直接影响 Pod。
- 核心问题:VCI 实例所在虚拟节点是否健康?资源是否充足?
- 关键指标:虚拟节点状态、Kubelet/Containerd 健康状况、GPU 相关指标 (DCGM)。
- 排查工具:kubectl get node、云监控。
- 网络路径层
网络是分布式系统的生命线,VCI 也不例外。
- 核心问题:网络是否通畅?DNS 解析是否正常?安全策略是否放通?
- 关键组件:VPC 路由、安全组、网络 ACL、CoreDNS。
- 排查工具:ping、curl、nslookup、tcpdump、VPC/CLB 控制台。
- 控制面 & 依赖服务层
当大量 VCI 实例出现共性问题时,可能指向了上游的控制面或依赖服务。
- 核心问题:VCI 控制面是否稳定?依赖的监控、存储服务是否正常?
- 关键指标:VCI 核心 API 成功率、Virtual Kubelet 接口成功率。
- 排查工具:云监控、托管 Prometheus (VMP)、告警平台。
- 资源与配额层
创建失败或 Pending 问题,很多时候与资源供给有关。
- 核心问题:账号配额是否足够?目标可用区库存是否充足?
- 关键信号:FailedScheduling 事件、配额中心告警;quota 类异常通常提示账号配额不足,sold out 类异常意味着资源库存不足。
- 排查工具:配额中心控制台、工单咨询。
三、处理高频故障:实战 SOP
本小节内容汇集了真实案例中的高频故障,并以“现象→可能原因→如何定位→建议修复”的标准化操作程序 (SOP) 格式呈现。
排查核心:遇到问题时,请先冷静。kubectl describe pod <pod-name>是您的第一大神器,90% 的问题线索都藏在 Events 部分。
3.1 Pod 状态异常
3.2 镜像与存储问题
3.3 网络与服务发现问题
四、配置监控与告警:防患于未然
被动排障不如主动预防。建立一套完善的监控与告警体系,是保障 VCI 服务稳定性的关键。本章节将提供一份可落地的监控告警清单和实践建议。
4.1 监控与告警订阅建议
本小节表格整合了火山引擎云监控、VMP、APMPlus 及自建告警平台的关键指标和事件,为您构建 VCI 的全景监控视图提供参考。
告警配置核心:告警宁缺毋滥。优先配置能直接反映用户体验受损或预示重大风险的告警(如 SLI 下降、Pod 大量 Pending),并为此类告警设置明确的 SOP。对于“噪音”较多的指标(如瞬时 CPU 高负载),可以设置更高的触发阈值或更长的持续时间,避免告警疲劳。
分类 | 指标 / 事件名称 | 建议阈值 / 条件 | 归属平台 | 说明与适用场景 |
VCI 实例与 Pod 基础 | pod_cpu_usage_seconds_total (Counter) container_cpu_usage_seconds_total (Counter) | rate(...) > 85%,且持续 5 分钟 | VMP | VCI 实例(Pod 维度)或单个容器的 CPU 使用率。持续高位可能意味着资源瓶颈或应用逻辑问题。 |
| pod_memory_working_set_bytes (Gauge) container_memory_working_set_bytes (Gauge) | Pod/Container Limit > 90% | VMP | 物理内存使用量。接近 Limit 时 Pod 面临被 OOMKilled 风险。 |
| container_network_receive_bytes_total (Counter) container_network_transmit_bytes_total (Counter) | rate(...)出现异常突增或骤降 | VMP | 网络吞吐量。监控流量的剧烈变化,预示可能发生攻击、业务异常或网络问题。 |
Kubernetes 核心事件 | 事件:Pod Pending | 同命名空间下 Pending Pod 数量 > 5,且持续 3 分钟 | 自建告警平台 / 云监控 | 大量 Pod 无法被调度,通常指向资源不足或调度器问题,是严重故障的前兆。 |
| 事件:Pod Terminating | 同命名空间下 Terminating Pod 数量 > 3,且持续 10 分钟 | 自建告警平台 / 云监控 | Pod 无法正常退出,影响发布和伸缩。 |
| 事件:Node NotReady | 虚拟节点状态变为 NotReady | 自建告警平台 / 云监控 | 表示 VCI 数据面或 Virtual Kubelet 与控制面的通信出现严重问题。 |
GPU 监控 | DCGM_FI_DEV_GPU_TEMP (Gauge) | > 85(摄氏度) | VMP (DCGM Exporter) | GPU 温度过高会触发降频,甚至硬件损坏。 |
| DCGM_FI_DEV_POWER_USAGE (Gauge) | rate(...)持续低于预期值 | VMP (DCGM Exporter) | 训练任务中 GPU 功率持续过低,表示任务可能未正确利用 GPU。 |
| DCGM_FI_DEV_GPU_UTIL (Gauge) DCGM_FI_DEV_MEM_COPY_UTIL (Gauge) | avg_over_time(...) < 10%,且持续 10 分钟 | VMP (DCGM Exporter) | GPU 利用率或显存带宽利用率长期过低,说明 GPU 资源闲置,需排查应用配置。 |
| DCGM_FI_DEV_XID_ERRORS (Gauge) | > 0 | VMP (DCGM Exporter) | NVIDIA XID 错误是 GPU 硬件或驱动严重错误的信号,需立即关注。 |
存储与磁盘 | kubelet_volume_stats_used_byteskubelet_volume_stats_capacity_bytes | 磁盘使用率 > 90% | VMP | 数据盘或系统盘容量即将耗尽,会导致数据无法写入、应用崩溃。 |
| kubelet_volume_stats_inodes_usedkubelet_volume_stats_inodes | Inode 使用率 > 90% | VMP | Inode 耗尽会导致无法创建新文件。适用于存储大量小文件的场景。 |
| EBS IO 指标(如 DiskReadBandwidth、DiskWriteBandwidth) | 达到云盘规格上限的 95% | 云监控 | 存储 IO 达到瓶颈,会导致应用读写延迟飙高。 |
控制面与依赖 | VCI 核心 API SLI(如 CreateContainerInstance) | 成功率 < 99% 持续 5 分钟 | 自建告警平台 | VCI 控制面核心接口出现异常,会大面积影响 Pod 的创建和管理。 |
| 配额中心相关事件 | Quota utilization exceeds 80% | 配额中心 / 云监控 | VCI 资源配额即将用尽,需提前申请扩容,避免影响业务弹性。 |
亚健康与故障机 | pod Condition / pod Label 中筛选出故障关键字 InstanceReady | kubectl get po -A-l vci.vke.volcengine.com/instance-fault=NodeNotReady | 自建告警平台 | 宕机节点,发生了物理机故障,实例已经不能正常运行。 |
| pod Condition / pod Label 中筛选出故障关键字 VciOps | kubectl get po -A-l vci.vke.volcengine.com/VciOps=PreVciNodeOffline | 自建告警平台 | 亚健康节点,预下线,VCI 后续会进行的运维运营动作,会影响 VCI 实例的运行。 |
4.2 告警订阅与管理实践建议
- 利用预置模板:
- VMP:利用 VMP 为容器服务提供的告警模板,可快速创建针对 VCI 实例的监控告警规则。
- 告警降噪与聚合:
- 毛刺过滤:配置“N 分钟内触发 M 次后发送”的策略,过滤无效告警。
- 发送降频:开启“发送降频”功能,避免被告警轰炸。
- 告警聚合:设置合理的批次聚合间隔,让告警信息更清晰。
- 分级与通知:
- 告警分级:明确定义告警级别(如 P0 / Fatal, P1 / Warning, P2 / Notice),提升告警处理效率。
- 告警即工单与 SOP:
- 自动化:搭建告警到工单的自动化流程,确保每个重要告警均有闭环跟进。
- 关联 SOP:在告警信息中附上对应故障场景的排查手册,帮助响应人员快速定位和解决问题。
五、预防与优化设计:优雅地使用 VCI
优秀的系统设计能从源头上规避大量故障。以下是在使用 VCI 时,产品和研发同学应该在设计阶段就考虑的最佳实践。
镜像:轻量化与预热
- 保持镜像轻量:镜像是 Pod 启动速度的关键影响因素之一。遵循 VCI 验证规的最佳实践,构建多阶段 Dockerfile,只将必要的运行时和二进制文件打包到最终镜像中,避免包含编译工具、源码、文档等非运行必须的内容。
- 利用镜像缓存:对于需要大规模、快速拉起的应用,务必使用“自动镜像缓存”或“手动镜像缓存”功能。通过 Annotation 开启后,VCI 会提前将镜像数据缓存到目标可用区的云盘上。详情请参见 VCI 镜像缓存。
- 预热镜像缓存:新镜像或长期未使用的镜像,其缓存在首次使用时可能拉取较慢或已过期无法拉取。因此建议在大规模使用前,先创建少量 Pod 来触发和预热镜像缓存,待缓存状态变为 Ready.Ok 后再进行大规模部署。
容量:合理估算与配置
- 系统盘容量估算:VCI 默认系统盘为 40 GiB。对于使用大镜像、镜像缓存或在容器内写入大量临时文件的场景,系统盘用量可能不够。请务必使用vci.vke.volcengine.com/desired-system-storage Annotation(邀测功能)为 Pod 指定一个合理的、更大的系统盘容量,避免因 FailedCreateSystemDisk 而创建失败。更多信息,请参见 VCI 镜像缓存。
- vci-profile 统一配置:强烈建议使用 vci-profile 来统一管理命名空间或集群级别的 VCI 配置,而不是在每个工作负载的 YAML 中单独指定。vci-profile 能确保配置的一致性(如子网、日志采集、安全上下文),降低因个体配置遗漏或错误导致的故障。详情请参见 通过配置 vci-profile 使用 VCI。
GPU:驱动版本匹配
- 驱动与 CUDA 匹配:创建 GPU 类型的 VCI 实例时,可以通过vci.vke.volcengine.com/gpu-driver-version Annotation 指定 NVIDIA 驱动版本。请务必确保您应用镜像中使用的 CUDA Toolkit 版本与所选的驱动版本兼容。版本不匹配可能导致 GPU 无法正常工作或性能下降。具体匹配关系,请参见 支持的 GPU 驱动版本。
- 默认即最优:如果您不确定如何选择,通常不设置该 Annotation,VCI 会自动为您选择与 GPU 型号最匹配的默认驱动版本。默认驱动版本,请参见 支持的 GPU 驱动版本。
网络:规划先行,治理同步
- 清晰的网络规划:在业务设计阶段就应有清晰的网络拓扑规划。避免在生产环境中使用重叠或冲突的网段,特别是在使用 CEN 打通多 VPC 时,避免自定义路由与火山引擎公共服务网段(如 100.XX.XX.XX/11)的冲突。容器网端配置说明,请参见 网络概述。
- DNS 治理:对于高并发或对 DNS 解析延迟敏感的应用,建议在集群中启用 NodeLocal DNSCache,有效降低对 CoreDNS 的集中请求压力,提升服务发现的稳定性和性能。更多信息,请参见 使用 NodeLocal DNSCache 缓存代理。
六、执行落地检查 (Checklist)
在您的产品/项目上线前,或进行故障排查后,可以对照以下清单进行检查,确保关键实践已落地:
最近更新时间:2026.10.30 15:20:47
这个页面对您有帮助吗?
有用
有用
无用
无用