容器服务
容器服务


文档指南

请输入


- 文档首页
 容器服务容器服务 VKE用户指南诊断与巡检检查自愈检查自愈概述
 复制全文
 下载 pdf
检查自愈概述
 文档反馈
 问问助手
检查自愈功能用于检测节点常见故障并执行相应的止血与自愈操作,帮助您快速感知节点异常、缩小故障影响并提升集群稳定性。本文介绍检查自愈的工作流程、故障类型、事件与指标说明。
说明
本功能仅对企业用户开放,如果您无法查看对应的控制台页面,请确认已完成账号的企业认证。
检查自愈流程
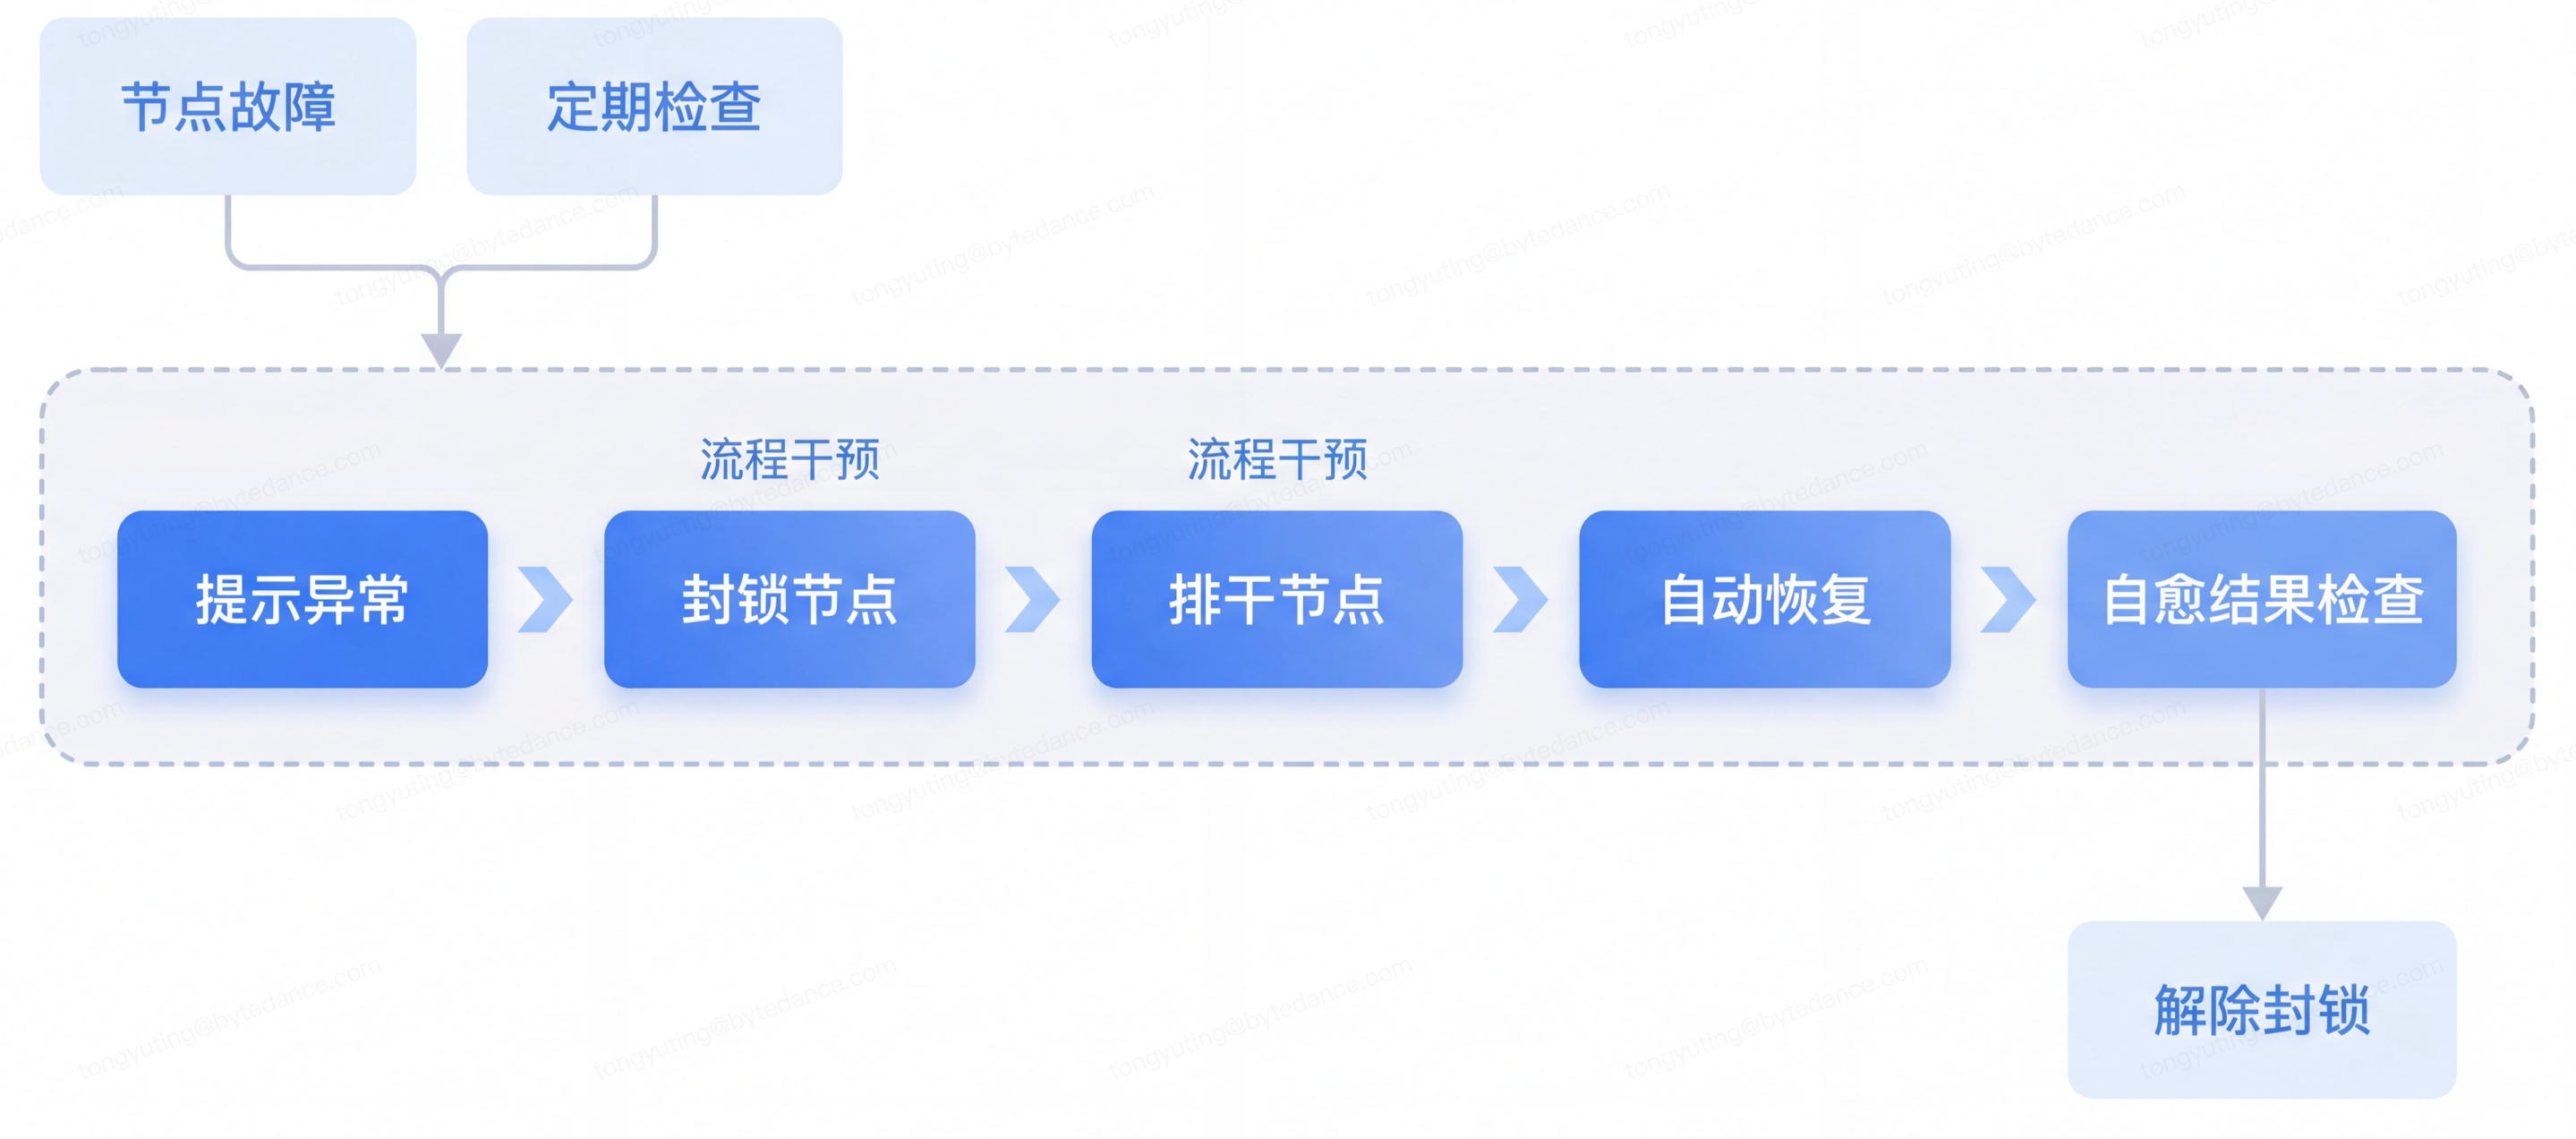
容器服务支持节点检查自愈功能,系统会按照规则配置,定期进行节点检查。当节点故障时,会记录 Node Event 事件,并执行自愈动作。
- 故障检测:系统通过主动探测节点故障和监听 ECS 运维事件来感知节点故障的产生,支持基于节点状态生成 Kubernetes 日志,并向监控系统上报故障,方便用户第一时间了解故障信息。
- 止血流程:系统会进行业务止血操作,包括:封锁节点 和 排干节点,缩小故障影响面,并支持在完成对应操作后进行流程干预,为故障节点添加指定标签,方便用户对故障节点进行查找和处理。
- 自愈流程:系统会重启故障进程或故障节点,尝试解决故障。完成后进行自愈结果检查。如果故障已恢复,则解除节点封锁,恢复节点的正常调度。
节点检查自愈的工作流程,如下图所示。
说明
节点检查自愈功能为您提供了不同的故障处理流程,您可以根据实际需求进行选择。包括:
- 提示异常:仅包含 提示异常 流程。
- 封锁节点:包含 提示异常、(可选)流程干预 和 封锁节点 流程。
- 排干节点:包含 提示异常、(可选)流程干预、封锁节点 和 排干节点 流程。
- 自动修复:包含 提示异常、(可选)流程干预、封锁节点、排干节点、自动恢复 和 (可选)解除封锁 流程。
故障类型
GPU 故障
GPU 故障场景支持 提示异常、封锁节点、排干节点 和 自动修复 故障处理策略,不同检查项对应的 Event、监控指标和自动修复策略,如下表所示。
注意
GPU 检查项中关于 XID 的监控功能正在下线中,详情请参见【产品变更】检查自愈功能新增“XID 异常”检查项。VKE 已新增专门的 XID 异常 检查项,用于识别和处理由 XID 异常引起的 GPU 故障。下线过程中的兼容逻辑如下:
- XID 监控正式下线前,GPU 故障 和 XID 异常 检查项中,均包含 XID 相关检查项。如果您同时配置了对应的检查自愈规则,则系统会以 XID 异常 故障类型的检查自愈规则为准。
- XID 监控正式下线后,GPU 故障 检查项中,不再包含 XID 相关检查项。如您已在使用节点检查自愈功能,建议您及时检查现有规则配置,并根据业务需要完成相应调整。
XID 异常
注意
XID 异常场景支持常见的 NVIDIA XID,并支持 排干节点 和 自动修复 故障处理策略。不同检查项对应的 Node Condition、Kubernetes Event 和自动修复策略,如下表所示。
说明
- 检查项和 Event 中,NvidiaXID[Code]Error 中的 [Code] 表示具体的错误码,例如 NvidiaXID48Error。
- 即使未配置 XID 异常检查项,当 GPU 节点发生相关异常时,系统仍会生成对应的 Kubernetes Event。
节点故障
节点故障场景支持 提示异常、封锁节点、排干节点 和 自动修复 故障处理策略,不同检查项对应的 Event 和自动修复策略,如下表所示。
“ECS 故障”检查项的事件说明,如下表所示。您可以根据需求,选择所有事件或指定事件进行监听。
事件类型 | 事件名称 | 事件说明与影响 |
SystemMaintenance_Redeploy | 因系统维护实例重新部署 | 检测到 ECS 实例宿主机(物理机)、专有宿主机处于 CPU 过热、电源故障、风扇故障等亚健康状态,存在宕机风险。 |
InfrastructureUpgrade_Redeploy | 因基础设施升级实例重新部署 | 随着业务发展和 ECS 实例宿主机(物理机)的健康状态变化,将对部分老旧、性能不佳的基础设施进行升级和改造。 |
SystemFailure_Redeploy | 因系统故障实例重新部署 | 检测到 ECS 实例宿主机(物理机)、专有宿主机出现故障导致宕机,需要将实例重新部署至新的宿主机恢复运行,否则实例及其中的业务将停止运行。 |
DiskErrorDetected | 硬盘异常 | 检测到本地盘实例的硬盘出现故障,无法正常进行读写操作,需要您授权将实例重新部署至新宿主机或更换新硬盘,否则实例将停止运行。 |
SystemMaintenance_StopAndRepair | 实例停止,系统维修 | 检测到 ECS 实例宿主机(物理机)处于 CPU 过热、电源故障、风扇故障等亚健康状态,存在宕机风险,需要停机原地修复。 说明 【邀测·申请试用】:该功能目前为 ECS 产品的邀测功能。若要监听该事件,请联系客户经理申请试用,并开启事件发送。 |
说明
系统与组件故障
系统与组件故障场景支持 提示异常 和 自动修复 故障处理策略,不同检查项对应的 Event 和自动修复策略,如下表所示。
检查项 | Kubernetes Event | 描述 | 自动修复策略 |
Kubelet 故障 | KubeletUnhealthy | Kubelet 运行状态异常导致节点不可用。 | 重启 Kubelet 服务 |
Runtime 故障 | RuntimeUnhealthy | Containerd/Docker 运行状态异常导致节点不可用。 | 重启 Containerd 服务 |
时间同步服务异常 | NTPProblem | 时钟同步服务(Chrony)异常。 | 重启 Chrony 服务 |
节点文件系统只读 | ReadonlyFilesystem | 节点文件系统变为只读,导致节点上业务运行异常。 | 重启节点 |
节点内核故障 | KernelOops | 节点存在内核错误,影响节点上的容器服务正常运行。 | 重启节点 |
节点内核死锁 | KernelHasDeadlock | 节点内核存在死锁。 | 重启节点 |
GPU 设备插件上报异常 | AcceleratorDevicePluginUnhealthy | GPU(NPU)设备插件与 kubelet 间长链接异常断开,导致节点 GPU 资源容量上报为 0,新建 GPU 业务无法调度到该节点。 | 重启组件 Pod |
RDMA 设备插件上报异常 | RDMADevicePluginUnhealthy | RDMA 设备插件与 kubelet 间长链接异常断开,导致节点 RDMA 资源容量上报为 0,新建 RDMA 业务无法调度到该节点。 | 重启组件 Pod |
说明
在执行 Kubelet 故障 与 Runtime 故障 修复时,会同时判断 Kubelet 与 Containerd 服务是否正常,如果存在服务异常则会一起修复。
自定义故障
检查自愈事件
节点池绑定检查自愈规则后,系统会按照规则配置,定期进行节点检查。当节点故障时,会记录 Node Event 事件。您可以在 事件中心 查看对应的事件。检查项和事件的对应关系,如下表所示。
节点故障指标
指标说明
节点故障指标说明,如下表所示。
节点故障指标中,不同故障对应不同的取值,详情如下表所示。
故障 Event | 故障时的值 | 故障码(二进制) | 故障码(十进制) |
GpuCardFallen | 1 | 10000000000000000000 | 524288 |
GpuMemoryErrorRecoverable | 1 | 01000000000000000000 | 262144 |
GpuMemoryErrorUnrecoverable | 1 | 00100000000000000000 | 131072 |
GpuLinkError | 1 | 00010000000000000000 | 65536 |
GpuLinkUnhealthy | 1 | 00001000000000000000 | 32768 |
GpuDriverError | 1 | 00000100000000000000 | 16384 |
GpuDriverWarning | 1 | 00000010000000000000 | 8192 |
GpuRuntimeWarning | 1 | 00000001000000000000 | 4096 |
GpuRuntimeError | 1 | 00000000100000000000 | 2048 |
GpuUnknownError | 1 | 00000000010000000000 | 1024 |
KubeletUnhealthy | 1 | 00000000001000000000 | 512 |
RuntimeUnhealthy | 1 | 00000000000100000000 | 256 |
NTPProblem | 1 | 00000000000010000000 | 128 |
FilesystemError | 1 1 | 00000000000001000000 | 64 |
KernelOops | 1 | 00000000000000100000 | 32 |
NodeResourceLeak | 1 | 00000000000000010000 | 16 |
NodeFailure | 1 | 00000000000000001000 | 8 |
NodeNotReady | 1 | 00000000000000000100 | 4 |
ReadonlyFilesystem | 1 | 00000000000000000010 | 2 |
KernelHasDeadlock | 1 | 00000000000000000001 | 1 |
无故障 | - | 00000000000000000000 | 0 |
说明
如果节点同时存在多种故障,则故障码进行组合处理。例如:当节点同时存在 GpuCardFallen 和 KernelHasDeadlock 故障时,故障码为10000000000000000001,即十进制为524289。
指标使用
当您收到基于指标的节点故障告警后,可以查看 Node Event 事件,进一步了解故障详情。
- 登录 容器服务控制台。
- 在左侧导航栏中单击 集群。
- 单击目标集群名称,在集群管理页面的左侧导航栏中选择 节点管理 > 节点 。
- 在节点列表中选择目标节点,单击节点名称,进入节点详情页面。选择 事件 页签,即可查看节点的事件信息。
-

注意
容器服务集群中的节点事件默认只会保存 1 小时,如需长期保留节点故障详情,可以通过安装 event-collector 组件,将集群的事件转存到日志服务(TLS)中,方便后续查询和检索。详情请参见 配置和查看持久化事件。
查询节点的事件信息时,可以通过reason = AIOpsResourceStatus事件类型进行过滤。其中,Message中存储了故障的详细信息。如果节点处于多种故障场景下,则会推送多个事件。
Message是一个 JSON 字符串,其结构如下所示:

最近更新时间:2026.10.23 10:37:21
这个页面对您有帮助吗?
有用
有用
无用
无用