容器服务
容器服务
容器服务


文档指南
请输入


容器服务 VKE
产品动态
Kubernetes 版本发布记录
组件发布记录
监控组件
DNS 组件
GPU 组件
Sandbox 组件
安全公告
产品公告
历史公告
用户指南
集群
节点池
授权
网络
容器网络
服务(Service)
路由(Ingress)
APIG Ingress
ALB Ingress
自定义转发规则配置示例
CLB Ingress
Nginx Ingress
Gateway API
工作负载
存储
数据管理中心(DMC)
对象存储(TOS)
FSX 访问方式
文件存储(NAS)
FSX 访问方式
弹性文件存储(EFS)
文件存储(vePFS)
FSX 访问方式
vePFS Client 访问方式
大数据文件存储(CloudFS)
弹性伸缩
工作负载弹性伸缩
事件驱动伸缩(KEDA)
组件管理
网络组件
监控组件
DNS 组件
GPU 组件
Sandbox 组件
异构计算
调度管理
可观测性
基础观测
诊断与巡检
最佳实践
网络
可观测性
安全合规
API 参考
集群管理
节点池管理
组件管理
机型镜像管理
云原生观测
巡检诊断
弹性容器实例
附录
开发指南
常见问题
通用 FAQ
集群 FAQ
集群管理
集群升级
节点与节点池 FAQ
授权 FAQ
工作负载 FAQ
服务与路由 FAQ
存储 FAQ
弹性伸缩 FAQ
可观测性 FAQ
配额 FAQ
组件 FAQ
容器镜像 FAQ
AI 云原生
推理套件
Helm 模板 AI 应用
Deepseek 实践
Qwen 实践
最佳实践
MiniMax 模型部署
Qwen 模型部署
弹性容器实例 VCI
最新动态
用户指南
虚拟节点
VKE 集群使用虚拟节点
自建/跨云集群使用虚拟节点
创建 VCI 实例
VCI Agent Sandbox
安全合规
- 文档首页
 容器服务AI 云原生训练套件veCCL 高性能通信实践
 复制全文
 下载 pdf
veCCL 高性能通信实践
 文档反馈
 问问助手
简介
veCCL(Volcano Engine Collective Communication Library)是火山引擎基于 NCCL(Nvidia Collective Communication Library)自研开发的高性能集合通信库,支持安装在单节点或多节点的多张 GPU 卡上,结合火山引擎自身的网络特点及丰富的大模型任务通信调优经验,实现多 GPU 之间的高性能通信。
veCCL 提供了一系列高度优化的通信原语,能够在特定拓扑或集合操作中显著优化通信效率,帮助并行计算任务在多个 GPU 间高效地同步和交换数据。作为 NCCL 的增强版,veCCL 对用户完全透明,只需正确加载动态库,无需更改应用程序调用 NCCL 集合操作的方式即可使用。相比 NCCL 的默认实现,veCCL 能自动加载并运行为特定拓扑和通信场景优化的算法,显著减少通信延迟并提高数据吞吐量。而在不支持的场景中,veCCL 会智能回退至 NCCL 的默认实现。
增强特性介绍
- 高性能:在给定机型、拓扑结构和通信模式下,提供最优算法和实现。
- 快速定位故障:能够在分布式集群协作任务中,快速识别和界定故障点。
- 稳定性:能够应对简单和较为复杂的异常情况,如提供 Softbond 能力在网卡故障时实现自动切换,保持业务稳定运行不中断。关于 Softbond 能力的使用介绍,请参考 使用 NCCL Softbond Plugin 保障单网卡故障下训练流量恢复。
使用说明
- 本实践涉及较多组件,相互间有依赖,配置复杂,为了获得符合预期的结果,请务必根据本文指引操作
- 为了获得符合预期的结果,同时符合容器服务的 使用限制,请按照本文方案(或在本文推荐的资源上)操作。如需替换方案,您可以联系对应的火山引擎客户经理咨询
- 完整的部署流程,依赖部分火山引擎邀测能力,请联系火山引擎客户经理申请如下功能的邀测试用。
邀测功能/资源 | 涉及产品 | 说明 |
邀测功能/资源 | 涉及产品 | 说明 |
高性能计算GPU型 hpcpni3ln 实例 | ECS | 高性能实例需申请邀测。 |
前置条件
创建高性能计算集群
注意
高性能集群所在的可用区需要与 VKE 节点的可用区一致。
创建 VKE 集群
配置项 | 说明 |
配置项 | 说明 |
集群配置 | |
Kubernetes 版本 | 选择 v1.28 及以上版本。 |
容器网络模型 | 选择 VPC-CNI。 |
节点池配置 | |
托管节点池 | 开启 托管节点池。 |
可用区 | 与 高性能计算集群 所在的可用区相同。 |
计算规格 | 由于veCCL优化的是特定规格实例的网络拓扑,因此选择 ecs.hpcpni3ln 。 |
高性能计算集群 | 选择之前创建的高性能计算集群。 |
节点数量 | 1个。 |
组件配置:除了标记为 系统必装 的组件之外,可以根据需要,选择安装以下组件。
领域 | 组件名称 | 是否安装 | 组件说明 |
领域 | 组件名称 | 是否安装 | 组件说明 |
GPU | nvidia-device-plugin | 必装 | nvidia 设备驱动,支持在容器里使用 GPU 显卡设备的管理组件。 |
监控 | prometheus-agent | 必装 | 托管 Prometheus 监控组件,采集 Kubernetes 集群监控指标数据到火山引擎托管 Prometheus 服务(Volcengine Managed Service for Prometheus,VMP) |
存储 | csi-ebs | 必装 | 支持容器集群使用存储服务的标准 CSI 接口实现 |
创建无状态负载
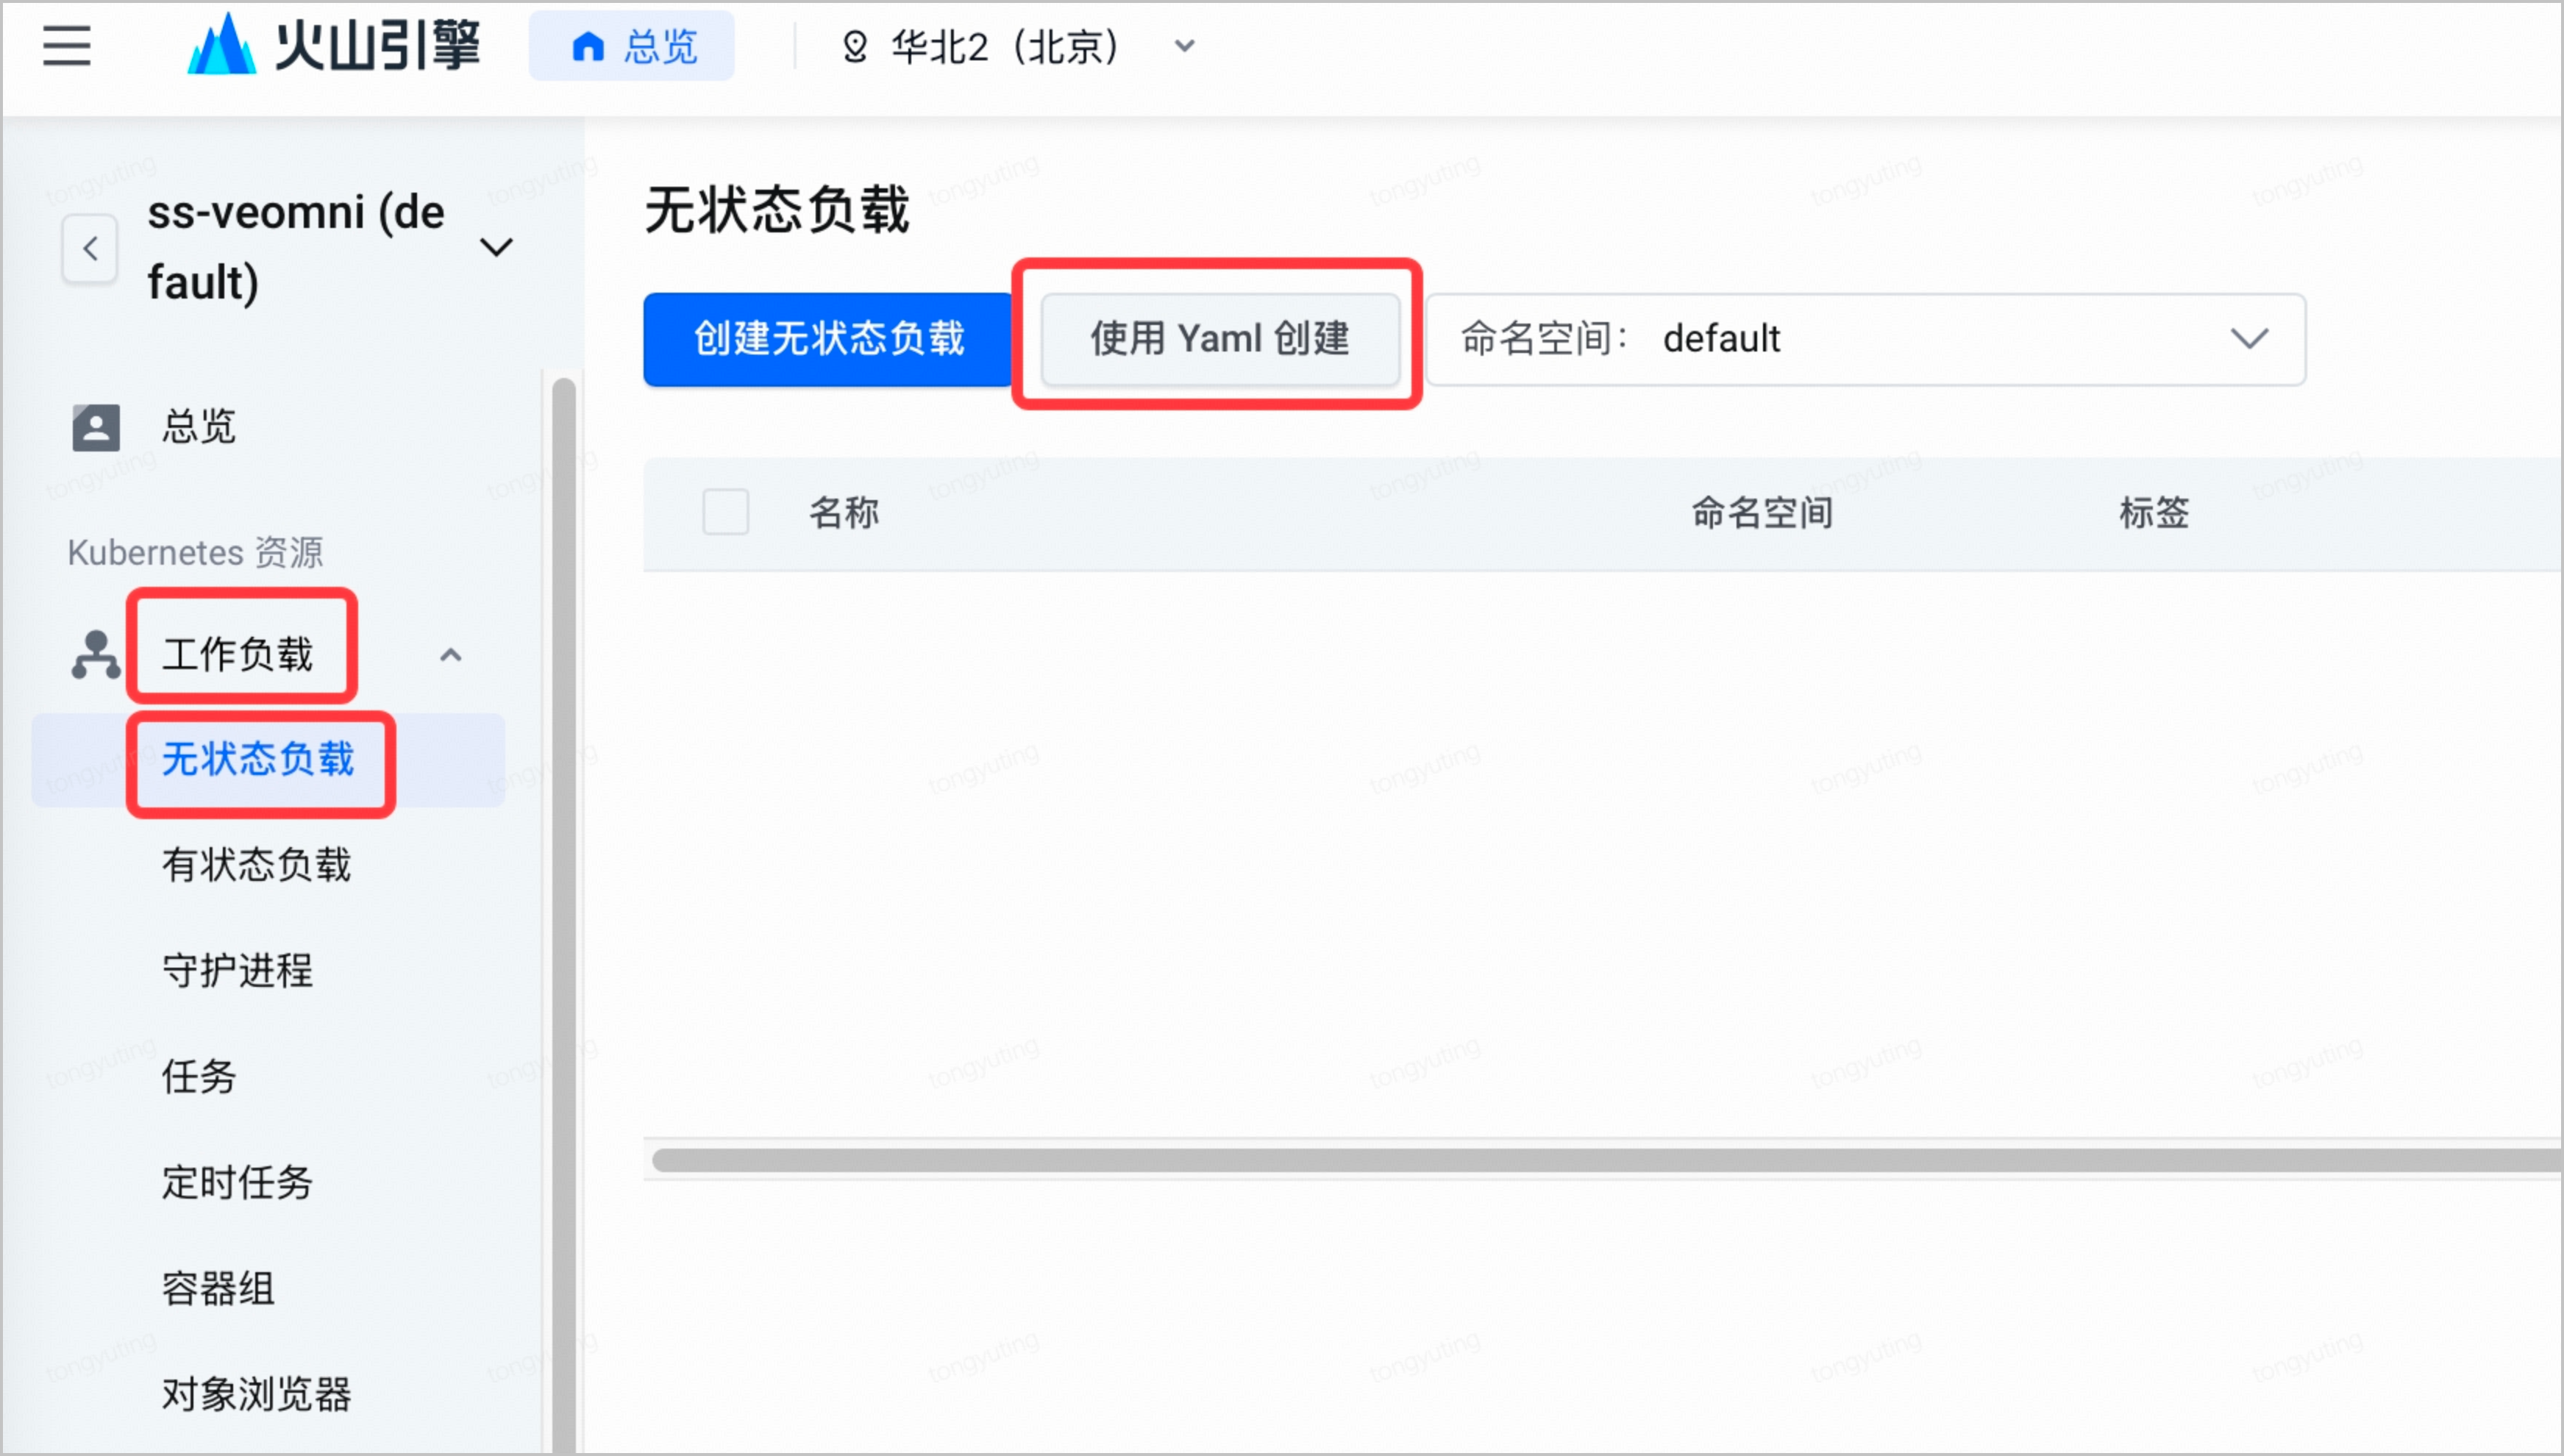
- 创建无状态负载。在集群管理页面的左侧导航栏中,选择 工作负载 > 无状态负载,单击 使用 Yaml 创建。
- containers.image修改为用户训练任务使用的镜像。本文档中的镜像仅为示例。
apiVersion: apps/v1
kind: Deployment
metadata:
name: example-wan21
namespace: default
spec:
replicas: 1
selector:
matchLabels:
app: example-wan21
strategy:
rollingUpdate:
maxSurge: 100%
maxUnavailable: 100%
type: RollingUpdate
template:
metadata:
creationTimestamp: null
labels:
app: example-wan21
spec:
containers:
- args:
- -c
- tail -f /etc/hosts
command:
- sh
image: iaas-gpu-cn-beijing.cr.volces.com/serving/sglang:v0.4.7.byted_ep.0.0.4.202506201849
imagePullPolicy: Always
name: main
resources:
limits:
nvidia.com/gpu: "8"
volumeMounts:
- mountPath: /data00/models
name: models
- mountPath: /dev/shm # 挂载共享内存卷
name: dshm
dnsPolicy: ClusterFirst
restartPolicy: Always
schedulerName: default-scheduler
securityContext: {}
terminationGracePeriodSeconds: 5
volumes:
- hostPath:
path: /data01
type: Directory
name: models
- name: dshm # 添加emptyDir类型的共享内存卷
emptyDir:
medium: Memory
sizeLimit: 100Gi # 设置共享内存大小为100GB
本文档使用的镜像已安装 nccl。若用户镜像未安装 nccl,打开创建的无状态负载的控制台,执行以下命令,安装 nccl。
git clone -b v2.21.5-1 https://github.com/NVIDIA/nccl
cd nccl
make -j src.build
make install
操作步骤
步骤一:安装 mpi
- 执行以下命令,安装 mpi。
apt update
apt install openmpi-bin openmpi-common libopenmpi-dev
步骤二:安装 nccl test
- 执行以下命令,查看 CUDA_HOME,MPI_HOME,NCCL_HOME。
#查看NCCL_HOME
find / -name "nccl.h" 2>/dev/null
#查看CUDA_HOME
echo $CUDA_HOME
#查看MPI_HOME
find / -name "libmpi.so*" 2>/dev/null
which mpicc # 查找mpicc的位置# 输出示例:/usr/local/openmpi/bin/mpicc# 则MPI_HOME为:/usr/local/openmpi
- 执行以下命令,安装 nccl test。
git clone https://github.com/NVIDIA/nccl-tests.git
cd nccl-tests
make MPI=1 MPI_HOME=/usr/local/mpi/ CUDA_HOME=/usr/local/cuda/ NCCL_HOME=/usr/local/lib/python3.10/dist-packages/nvidia/nccl/
步骤三:安装 veCCL
- 执行以下命令,安装 veCCL。
pip install veccl -i https://private.ivolces.com/pypi/simple
- 执行以下命令,检查安装是否成功。
ls `python3 -c "import veccl; print(veccl.ld_library_path())"`
预期显示结果如下图所示,则表示已成功安装veCCL。

步骤四:配置 veCCL 通信环境
在 veCCL 安装成功后,需要配置 veCCL 通信环境,确保运行前 LD_PRELOAD 包含 veCCL 库。
说明
本文提供 Shell Script 与 Python Script 两种配置方式。
Shell Script
- 执行以下脚本,配置 veCCL 通信环境。
# 预加载veCCL库,确保veCCL的通信优化优先生效。
export LD_PRELOAD=$(python3 -c "import veccl; print(veccl.lib_paths())"):${LD_PRELOAD}
# 指定使用Softbond插件,提升网络可靠性。
export NCCL_NET_PLUGIN=none
export NCCL_IB_TIMEOUT=23
# 将veCCL库的依赖路径添加到动态链接库搜索路径中。
export LD_LIBRARY_PATH=$(python3 -c "import veccl; print(veccl.ld_library_path())"):$LD_LIBRARY_PATH
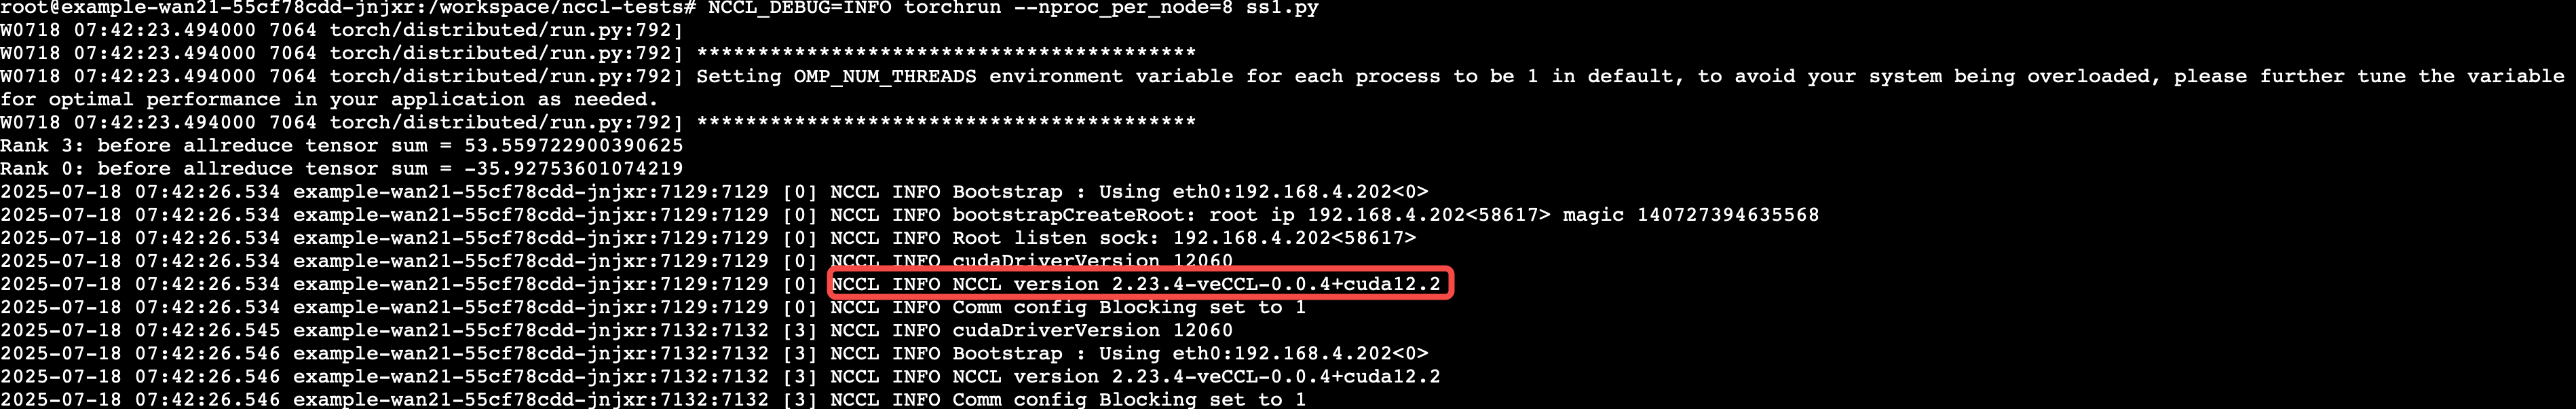
- 同时设置NCCL_DEBUG=INFO,可以根据红框部分日志信息确定 veCCL 的使能情况。NCCL version 2.23.4-veCCL-x.x.x+cuda12.2表示成功使能 veCCL。
Python Script
- 执行以下脚本,配置 veCCL 通信环境。
import veccl
import os
import subprocess
# 设置关键环境变量并启用veCCL高性能通信优化。
veccl.enable() # 配置LD_PRELOAD, NCCL_NET_PLUGIN与LD_LIBRARY_PATH。
os.environ['NCCL_DEBUG'] = 'INFO'
os.environ['NCCL_IB_TIMEOUT'] = '23'
- 脚本运行成功后,veccl.enable()会下打印如下信息,表示关键环境变量配置成功。

步骤五:验证 veCCL 运行效果
以下示例提供了一个脚本 test.py,用于展示在单机 8 卡的实例中,基于 PyTorch 分布式训练框架采用 allreduce 通信算法进行加速的效果。
import os
import torch
import torch.distributed as dist
def main():
# 环境变量解析
rank = int(os.environ["RANK"])
local_rank = int(os.environ["LOCAL_RANK"])
world_size = int(os.environ["WORLD_SIZE"])
# 设备与通信初始化
torch.cuda.set_device(local_rank)
dist.init_process_group(backend="nccl")
# 在每个GPU上生成随机张量,并进行all_reduce操作
tensor = torch.randn(1024, device=f"cuda:{local_rank}")
print(f"Rank {rank}: before allreduce tensor sum = {tensor.sum().item()}")
dist.all_reduce(tensor, op=dist.ReduceOp.SUM)
# all_reduce结果验证与资源释放
print(f"Rank {rank}: after allreduce tensor sum = {tensor.sum().item()}")
dist.destroy_process_group()
if __name__ == "__main__":
main()
- 执行python3 -c "import torch; print(torch.__version__)"命令查看 PyTorch 版本。若未安装,请参见 安装Pytorch。
- 执行如下脚本运行 test.py。
Shell
NCCL_DEBUG=INFO torchrun --nproc_per_node=8 test.py
Python
# 执行test.py脚本启动单机8卡分布式训练任务。
torchrun_command = ["torchrun","--nproc_per_node=8","test.py"] # 注意:如果提示找不到torchrun,请填写绝对路径
try:
subprocess.run(torchrun_command, check=True) # 注意:修改LD_PRELOAD仅对子进程生效,因此需要subprocess.run
# 捕获并打印torchrun命令执行失败的信息。
except subprocess.CalledProcessError as e:
print(f"torchrun failed with error: {e}")
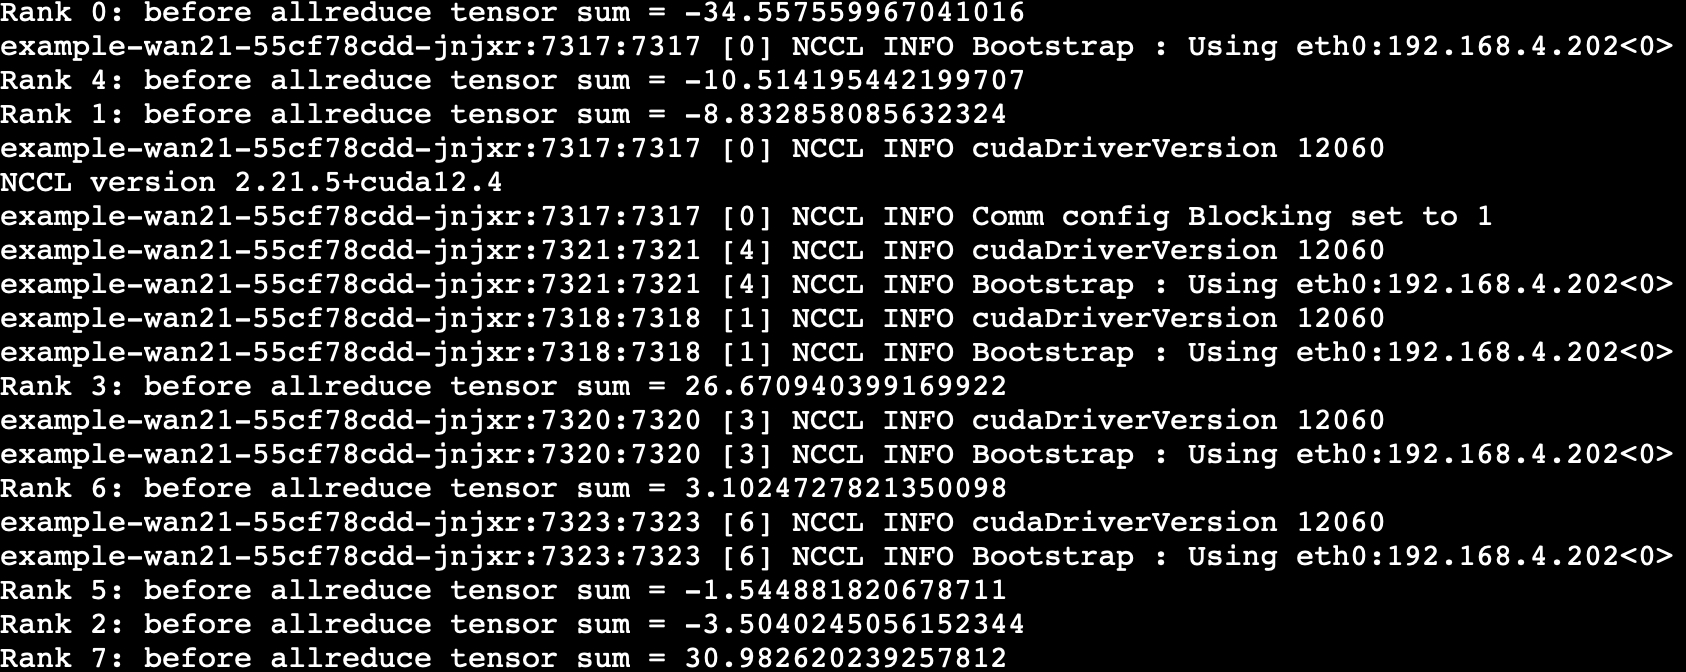
- 查看基于veCCL通信库的allreduce运算结果。

关键环境变量
环境变量 | 描述 |
环境变量 | 描述 |
NCCL_SOCKET_IFNAME | NCCL 在初始化的时候需要选择 socket 通信使用的网卡,不同规格的实例使用的网卡可能不同。未配置或配置错误可能会导致 NCCL 建连失败。在本文的实例中使用的网卡是 eth0。 |
NCCL_IB_GID_INDEX | 该变量为多机运行时有效。 设置 RDMA 使用的 GID,未配置或配置错误可能会导致 NCCL 运行报错。 |
NCCL_IB_TIMEOUT | 该变量为多机运行时有效。 在使用 Softbond 时推荐值为18,不使用 Softbond 时推荐值为 23。 该环境变量决定了 RDMA 数据发送的超时时间,配置为18意味着数据发送后约1.07s会触发RDMA网卡丢包重传;在使能了Softbond时,该变量还决定了判定链路不可用切流的时间阈值。 |
NCCL_NET_PLUGIN | 推荐配置为soft-bonding,以使能veCCL的Softbond稳定性增强能力。 如果不希望使用Softbond,则推荐设置为none,以防止误加载其他非预期的插件。 |
NCCL_DEBUG | 通常将日志级别设置为INFO,这样可以获得更多NCCL相关的日志输出,有助于在出现问题时进行解决。INFO级别的日志,在未进行其他日志设置的情况下仅在初始化时打印日志,不会影响通信性能。 |
性能测试
All Reduce
#veccl
mpirun --report-bindings --map-by slot --bind-to none --mca btl ^openib --mca pml ob1 --allow-run-as-root -np 8 -x NCCL_DEBUG=INFO -x LD_LIBRARY_PATH=/usr/local/lib/python3.10/dist-packages/veccl/lib /sgl-workspace/nccl-tests/build/all_reduce_perf -b 128 -e 2GB -f 2 -g 1 -c 1 -n 10 -w 5
#nccl
mpirun --report-bindings --map-by slot --bind-to none --mca btl ^openib --mca pml ob1 --allow-run-as-root -np 8 -x NCCL_BCCL_ENABLE=0 -x LD_LIBRARY_PATH=/usr/local/lib/python3.10/dist-packages/veccl/lib /sgl-workspace/nccl-tests/build/all_reduce_perf -b 128 -e 2GB -f 2 -g 1 -c 1 -n 10 -w 5
| NCCL 2.23 | | | veCCL | | | | |
| NCCL 2.23 | | | veCCL | | | | |
size (B) | time (us) | algbw (GB/s) | busbw (GB/s) | time (us) | algbw (GB/s) | busbw (GB/s) | speedup | algorithm |
128 | 15.67 | 0.01 | 0.01 | 9.75 | 0.01 | 0.02 | 1.61 | allreduce_1step--gpus_8-instances_4.xml |
256 | 15.64 | 0.02 | 0.03 | 9.97 | 0.03 | 0.04 | 1.57 | allreduce_1step--gpus_8-instances_4.xml |
512 | 15.93 | 0.03 | 0.06 | 9.82 | 0.05 | 0.09 | 1.62 | allreduce_1step--gpus_8-instances_4.xml |
1024 | 16.13 | 0.06 | 0.11 | 9.86 | 0.1 | 0.18 | 1.64 | allreduce_1step--gpus_8-instances_4.xml |
2048 | 16.09 | 0.13 | 0.22 | 9.77 | 0.21 | 0.37 | 1.65 | allreduce_1step--gpus_8-instances_4.xml |
4096 | 16.75 | 0.24 | 0.43 | 9.90 | 0.41 | 0.72 | 1.69 | allreduce_1step--gpus_8-instances_4.xml |
8192 | 16.57 | 0.49 | 0.87 | 9.95 | 0.82 | 1.44 | 1.67 | allreduce_1step--gpus_8-instances_4.xml |
16384 | 17 | 0.96 | 1.69 | 10.35 | 15.8 | 2.77 | 1.64 | allreduce_1step--gpus_8-instances_4.xml |
32768 | 18.2 | 1.8 | 3.15 | 11.26 | 2.91 | 5.09 | 1.62 | allreduce_1step--gpus_8-instances_4.xml |
65536 | 18.5 | 3.54 | 6.2 | 12.36 | 5.3 | 9.28 | 1.50 | allreduce_a100_allpairs--gpus_8-instances_4.xml |
131072 | 18.79 | 6.97 | 12.21 | 13.09 | 10.01 | 17.53 | 1.44 | allreduce_a100_allpairs--gpus_8-instances_4.xml |
262144 | 19.12 | 13.71 | 24 | 14.69 | 17.84 | 31.22 | 1.30 | allreduce_a100_allpairs--gpus_8-instances_4.xml |
524288 | 19.38 | 270.6 | 47.35 | 18.27 | 28.7 | 50.22 | 1.06 | allreduce_a100_allpairs--gpus_8-instances_4.xml |
1048576 | 24.55 | 42.7 | 74.73 | 24.94 | 42.04 | 73.57 | 0.98 | ndv5_r48ll.xml |
2097152 | 41.15 | 50.96 | 89.18 | 41.12 | 51 | 89.24 | 1.00 | ndv5_r48ll.xml |
4194304 | 53.54 | 78.33 | 137.08 | 53.51 | 78.38 | 137.17 | 1.00 | ndv5_r48ll128.xml |
8388608 | 81.11 | 103.42 | 180.98 | 81.15 | 103.38 | 180.91 | 1.00 | allreduce_a100_ring--gpus_8-channels_8-instances_4.xml |
16777216 | 120.9 | 138.73 | 242.78 | 122.30 | 137.18 | 240.06 | 0.99 | NCCL |
33554432 | 197.2 | 170.12 | 297.71 | 196.20 | 171.01 | 299.26 | 1.01 | NCCL |
67108864 | 320.1 | 209.68 | 366.94 | 319.40 | 210.12 | 367.71 | 1.00 | NCCL |
134217728 | 570.1 | 235.42 | 411.99 | 571.20 | 234.96 | 411.18 | 1.00 | NCCL |
268435456 | 1091 | 246.04 | 430.56 | 1087.00 | 246.95 | 432.16 | 1.00 | NCCL |
536870912 | 2122.7 | 252.91 | 442.6 | 2120.30 | 253.2 | 443.1 | 1.00 | NCCL |
1073741824 | 4011 | 267.7 | 468.48 | 4011.30 | 267.68 | 468.44 | 1.00 | NCCL |
2147483648 | 7918 | 271.21 | 474.63 | 7906.30 | 271.62 | 475.33 | 1.00 | NCCL |
All Gather
#veccl
mpirun --report-bindings --map-by slot --bind-to none --mca btl ^openib --mca pml ob1 --allow-run-as-root -np 8 -x NCCL_DEBUG=INFO -x LD_LIBRARY_PATH=/usr/local/lib/python3.10/dist-packages/veccl/lib /sgl-workspace/nccl-tests/build/all_gather_perf -b 128 -e 2GB -f 2 -g 1 -c 1 -n 10 -w 5
#nccl
mpirun --report-bindings --map-by slot --bind-to none --mca btl ^openib --mca pml ob1 --allow-run-as-root -np 8 -x NCCL_BCCL_ENABLE=0 -x LD_LIBRARY_PATH=/usr/local/lib/python3.10/dist-packages/veccl/lib /sgl-workspace/nccl-tests/build/all_gather_perf -b 128 -e 2GB -f 2 -g 1 -c 1 -n 10 -w 5
| NCCL 2.23 | | | veCCL | | | | |
| NCCL 2.23 | | | veCCL | | | | |
size (B) | time (us) | algbw (GB/s) | busbw (GB/s) | time (us) | algbw (GB/s) | busbw (GB/s) | speedup | algorithm |
128 | 10.52 | 0.01 | 0.01 | 7.67 | 0.02 | 0.01 | 1.37 | allreduce_1step--gpus_8-instances_4.xml |
256 | 10.74 | 0.02 | 0.02 | 7.67 | 0.03 | 0.03 | 1.40 | allreduce_1step--gpus_8-instances_4.xml |
512 | 10.56 | 0.05 | 0.04 | 7.64 | 0.07 | 0.06 | 1.38 | allreduce_1step--gpus_8-instances_4.xml |
1024 | 10.57 | 0.1 | 0.08 | 7.67 | 0.13 | 0.12 | 1.38 | allreduce_1step--gpus_8-instances_4.xml |
2048 | 10.94 | 0.19 | 0.16 | 7.41 | 0.28 | 0.24 | 1.48 | allreduce_1step--gpus_8-instances_4.xml |
4096 | 10.99 | 0.37 | 0.33 | 7.56 | 0.54 | 0.47 | 1.45 | allreduce_1step--gpus_8-instances_4.xml |
8192 | 11.17 | 0.73 | 0.64 | 7.62 | 1.08 | 0.94 | 1.47 | allreduce_1step--gpus_8-instances_4.xml |
16384 | 11.5 | 1.43 | 1.25 | 7.66 | 2.14 | 1.87 | 1.50 | allreduce_1step--gpus_8-instances_4.xml |
32768 | 13.6 | 2.41 | 2.11 | 8.43 | 3.89 | 3.4 | 1.61 | allreduce_1step--gpus_8-instances_4.xml |
65536 | 13.65 | 4.8 | 4.2 | 7.82 | 8.38 | 7.33 | 1.75 | allreduce_a100_allpairs--gpus_8-instances_4.xml |
131072 | 14 | 9.36 | 8.19 | 8.45 | 15.51 | 13.57 | 1.66 | allreduce_a100_allpairs--gpus_8-instances_4.xml |
262144 | 14.16 | 18.51 | 16.2 | 9.14 | 28.67 | 25.08 | 1.55 | allreduce_a100_allpairs--gpus_8-instances_4.xml |
524288 | 14.25 | 36.8 | 32.2 | 10.95 | 47.87 | 41.89 | 1.30 | allreduce_a100_allpairs--gpus_8-instances_4.xml |
1048576 | 17.43 | 60.16 | 52.64 | 14.09 | 74.43 | 65.13 | 1.24 | ndv5_r48ll.xml |
2097152 | 23.52 | 89.16 | 78.02 | 17.14 | 122.33 | 107.04 | 1.37 | ndv5_r48ll.xml |
4194304 | 34.76 | 120.68 | 105.59 | 24.02 | 174.65 | 152.82 | 1.45 | ndv5_r48ll128.xml |
8388608 | 43.75 | 191.73 | 167.77 | 43.79 | 191.57 | 167.63 | 1.00 | allreduce_a100_ring--gpus_8-channels_8-instances_4.xml |
16777216 | 64.04 | 261.97 | 229.23 | 64.02 | 262.05 | 229.29 | 1.00 | NCCL |
33554432 | 113.7 | 295.04 | 258.16 | 113.50 | 295.5 | 258.57 | 1.00 | NCCL |
67108864 | 200.7 | 334.33 | 292.54 | 199.30 | 336.8 | 294.7 | 1.01 | NCCL |
134217728 | 378.1 | 354.98 | 310.61 | 381.50 | 351.81 | 307.83 | 0.99 | NCCL |
268435456 | 735.6 | 364.93 | 319.32 | 736.60 | 364.41 | 318.86 | 1.00 | NCCL |
536870912 | 1400.1 | 383.46 | 335.53 | 1414.40 | 379.58 | 332.13 | 0.99 | NCCL |
1073741824 | 2710.1 | 396.21 | 346.68 | 2740.80 | 391.76 | 342.79 | 0.99 | NCCL |
2147483648 | 5362 | 400.5 | 350.44 | 5368.00 | 400.05 | 350.05 | 1.00 | NCCL |
Reduce Scatter
#veccl
mpirun --report-bindings --map-by slot --bind-to none --mca btl ^openib --mca pml ob1 --allow-run-as-root -np 8 -x NCCL_DEBUG=INFO -x LD_LIBRARY_PATH=/usr/local/lib/python3.10/dist-packages/veccl/lib /sgl-workspace/nccl-tests/build/reduce_scatter_perf -b 128 -e 2GB -f 2 -g 1 -c 1 -n 10 -w 5
#nccl
mpirun --report-bindings --map-by slot --bind-to none --mca btl ^openib --mca pml ob1 --allow-run-as-root -np 8 -x NCCL_BCCL_ENABLE=0 -x LD_LIBRARY_PATH=/usr/local/lib/python3.10/dist-packages/veccl/lib /sgl-workspace/nccl-tests/build/reduce_scatter_perf -b 128 -e 2GB -f 2 -g 1 -c 1 -n 10 -w 5
| NCCL 2.23 | | | veCCL | | | | |
| NCCL 2.23 | | | veCCL | | | | |
size (B) | time (us) | algbw (GB/s) | busbw (GB/s) | time (us) | algbw (GB/s) | busbw (GB/s) | speedup | algorithm |
128 | 10.99 | 0.01 | 0.01 | 10.62 | 0.01 | 0.01 | 1.03 | allreduce_1step--gpus_8-instances_4.xml |
256 | 11.04 | 0.02 | 0.02 | 10.67 | 0.02 | 0.02 | 1.03 | allreduce_1step--gpus_8-instances_4.xml |
512 | 11.34 | 0.05 | 0.04 | 10.70 | 0.05 | 0.04 | 1.06 | allreduce_1step--gpus_8-instances_4.xml |
1024 | 11.46 | 0.09 | 0.08 | 10.61 | 0.1 | 0.08 | 1.08 | allreduce_1step--gpus_8-instances_4.xml |
2048 | 12 | 0.17 | 0.15 | 10.60 | 0.19 | 0.17 | 1.13 | allreduce_1step--gpus_8-instances_4.xml |
4096 | 11.53 | 0.36 | 0.31 | 10.62 | 0.39 | 0.34 | 1.09 | allreduce_1step--gpus_8-instances_4.xml |
8192 | 11.43 | 0.72 | 0.63 | 10.65 | 0.77 | 0.67 | 1.07 | allreduce_1step--gpus_8-instances_4.xml |
16384 | 12.03 | 1.36 | 1.19 | 10.77 | 1.52 | 1.33 | 1.12 | allreduce_1step--gpus_8-instances_4.xml |
32768 | 12.57 | 2.61 | 2.28 | 11.81 | 2.78 | 2.43 | 1.06 | allreduce_1step--gpus_8-instances_4.xml |
65536 | 12.63 | 5.19 | 4.54 | 12.52 | 5.24 | 4.58 | 1.01 | allreduce_a100_allpairs--gpus_8-instances_4.xml |
131072 | 12.85 | 10.2 | 8.92 | 12.65 | 10.36 | 9.06 | 1.02 | allreduce_a100_allpairs--gpus_8-instances_4.xml |
262144 | 13.79 | 19.01 | 16.64 | 13.00 | 20.17 | 17.65 | 1.06 | allreduce_a100_allpairs--gpus_8-instances_4.xml |
524288 | 13.26 | 39.53 | 34.59 | 15.56 | 33.69 | 29.48 | 0.85 | allreduce_a100_allpairs--gpus_8-instances_4.xml |
1048576 | 17.36 | 60.39 | 52.84 | 17.61 | 59.53 | 52.09 | 0.99 | ndv5_r48ll.xml |
2097152 | 22.83 | 91.85 | 80.37 | 22.94 | 91.41 | 79.99 | 1.00 | ndv5_r48ll.xml |
4194304 | 39.51 | 106.15 | 92.88 | 39.72 | 105.61 | 92.41 | 0.99 | ndv5_r48ll128.xml |
8388608 | 46.61 | 179.96 | 157.46 | 46.86 | 179.01 | 156.63 | 0.99 | allreduce_a100_ring--gpus_8-channels_8-instances_4.xml |
16777216 | 67.5 | 248.57 | 217.5 | 69.09 | 242.85 | 212.49 | 0.98 | NCCL |
33554432 | 112.2 | 299.02 | 261.64 | 113.10 | 296.77 | 259.67 | 0.99 | NCCL |
67108864 | 198.7 | 337.67 | 295.46 | 200.20 | 335.16 | 293.27 | 0.99 | NCCL |
134217728 | 375.9 | 357.03 | 312.4 | 375.20 | 357.7 | 312.99 | 1.00 | NCCL |
268435456 | 717.9 | 373.92 | 327.18 | 715.20 | 375.35 | 328.43 | 1.00 | NCCL |
536870912 | 1388.8 | 386.58 | 338.25 | 1383.10 | 388.16 | 339.64 | 1.00 | NCCL |
1073741824 | 2692.3 | 398.82 | 348.97 | 2689.90 | 399.17 | 349.28 | 1.00 | NCCL |
2147483648 | 5318.2 | 403.8 | 353.32 | 5320.10 | 403.66 | 353.2 | 1.00 | NCCL |
最近更新时间:2025.09.10 16:47:11
这个页面对您有帮助吗?
有用
有用
无用
无用